

Срещнах интересен материал за изкуствения интелект в игрите. С обяснение на базовите неща за ИИ с прости примери, а още вътре има много полезни инструменти и методи за неговото удобно разработване и проектиране. Как, къде и кога да ги използваме — също е споменато.
Повечето примери са написани в псевдокод, затова дълбоки познания по програмиране не са необходими. Под катa има 35 листа текст с картинки и гифове, така че се подгответе.
UPD. Извинявам се, но вече направих свой собствен превод на тази статия в Хабра. . Можете да прочетете неговата версия тук. , но по някаква причина статията ми е убягнала (ползвах търсене, но нещо не сработи). А тъй като пиша в блог, посветен на геймдев, реших да оставя своя вариант на превода за абонатите (някои моменти при мен са оформени по различен начин, а някои — умишлено пропуснати по съвет на разработчиците).
Какво е ИИ?
Игровият ИИ е съсредоточен върху това, какви действия трябва да изпълни обектът, в зависимост от условията, в които се намира. Обикновено това се нарича управление на "интелигентни агенти", където агентът е игров персонаж, превозно средство, бот, а понякога и нещо по-абстрактно: цяла група същности или дори цивилизация. Във всеки случай това е нещо, което трябва да вижда своето окружение, да взема решения на базата на него и да действа в съответствие с тях. Това се нарича цикълът Sense/Think/Act (Усещане/Мислене/Действие):
- Усещане: агентът намира или получава информация за неща в своята среда, които могат да повлияят на поведението му (заплахи в близост, предмети за събиране, интересни места за изследване).
- Мислене: агентът решава как да реагира (обмисля, достатъчно ли е безопасно да събира предметите или първо трябва да се бори/скрива).
- Действие: агентът извършва действия за реализиране на предишното решение (започва движение към противника или предмета).
- …теперь ситуацията се е променила заради действията на персонажите, затова цикълът се повтаря с нови данни.
Изкуственият интелект обикновено се концентрира върху частта Sense от цикъла. Например, автономните автомобили заснемат пътя, съчетават го с данни от радара и лидар и го интерпретират. Обикновено това се извършва от машинното обучение, което обработва входящите данни и им придава смисъл, извличайки семантична информация, като например „има още един автомобил на 20 ярда пред вас“. Това са така наречените classification problems.
Игралните приложения не изискват сложна система за извличане на информация, тъй като голяма част от данните вече са неотменима част от тях. Няма нужда да се стартират алгоритми за разпознаване на изображения, за да се определи дали врагът е пред вас — играта вече знае и предава информацията в процеса на вземане на решения. Затова частта от цикъла Sense често е много по-проста от Think и Act.
Ограничения на игровия ИИ
ИИ има редица ограничения, които трябва да се спазват:
- ИИ не трябва да бъде предварително обучаван, така сякаш е алгоритъм на машинно обучение. Безсмислено е да се разработва невронна мрежа по време на разработката, за да се наблюдават десетки хиляди играчи и да се изучава най-добрият начин за игра срещу тях. Защо? Защото играта не е пусната на пазара, а играчите липсват.
- Играта трябва да развлекателна и предизвикателна, затова агентите не трябва да откриват най-добрия подход срещу хора.
- Агентите трябва да изглеждат реалистични, за да могат играчите да се чувстват, сякаш играят срещу истински хора. Програмата AlphaGo надмине човека, но избраните ходове са далеч от традиционното разбиране на играта. Ако играта имитира противник-човек, такова усещане не трябва да съществува. Алгоритмът трябва да бъде променен, за да взема правдоподобни решения, а не идеални.
- ИИ трябва да работи в реално време. Това означава, че алгоритъмът не може да монополизира процесора за дълго време при вземането на решения. Дори 10 милисекунди за това е твърде дълго, тъй като на повечето игри им трябват между 16 и 33 милисекунди, за да извършат цялата обработка и да преминат към следващия кадър на графиката.
- Идеално е, ако поне част от системата се управлява от данни, за да могат „некодерите“ да правят промени, и корекциите да се извършват по-бързо.
Нека разгледаме подходите на ИИ, които обхващат целия цикъл Sense/Think/Act.
Принятие на основни решения
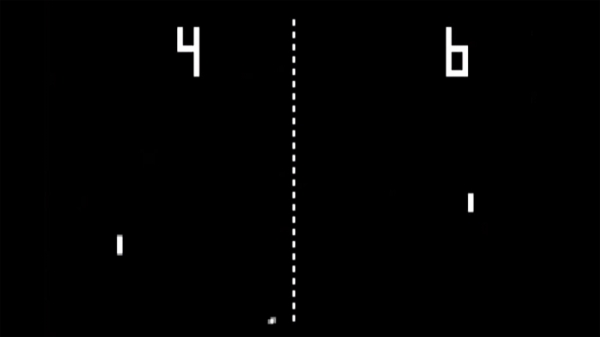
Нека започнем с най-простата игра – Pong. Целта е да преместите платформата (paddle), така че топката да се отблъсне от нея, а не да премине. Това е като тенис, в който губите, ако не отблъснете топката. Тук ИИ има относително лесна задача – да реши в коя посока да премества платформата.
Условни оператори
За ИИ в Pong има най-очевидното решение – винаги да се опитва да постави платформата под топката.
Прост алгоритъм за това, написан в псевдокод:
за всеки кадър/актуализация, докато играта тече:
ако топката е вляво от платформата:
премести платформата наляво
иначе ако топката е вдясно от платформата:
премести платформата надясно
Ако платформата се движи със същата скорост като топката, то това е идеалният алгоритъм за ИИ в Pong. Няма нужда от усложнения, ако данните и възможните действия за агента не са много.
Този подход е толкова прост, че целият цикъл Sense/Think/Act едва ли е забележим. Но той съществува:
- Частта Sense е в двата оператора if. Играта знае къде е топката и къде е платформата, така че ИИ се обръща към нея за тази информация.
- Частта Think също е в два оператора if. Те представляват две решения, които в този случай са взаимноизключващи. В резултат се избира едно от трите действия – премести платформата наляво, премести надясно, или не прави нищо, ако тя вече е добре позиционирана.
- Частта Act е в операторите Move Paddle Left и Move Paddle Right. В зависимост от дизайна на играта, те могат да преместят платформата незабавно или с определена скорост.
Тези подходи се наричат реагиращи – има прост набор от правила (в този случай оператори if в кода), които реагират на текущото състояние на света и действат.
Дърво на решения
Примерът с играта Pong всъщност е равен на формалната концепция на ИИ, наречена дърво на решения. Алгоритъмът преминава през него, за да достигне „листа“ – решение за това какво действие да предприеме.
Нека направим блок-схема на дървото на решения за алгоритъма на нашата платформа:
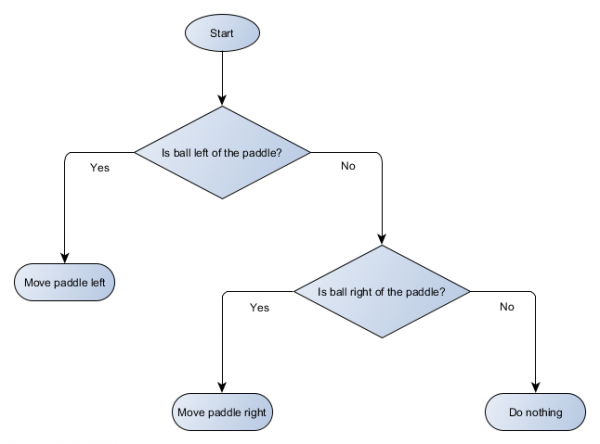
Всяка част на дървото се нарича node (възел) – ИИ използва теорията на графите, за да опише подобни структури. Има два вида възли:
- Възли за вземане на решения: избор между две алтернативи, основан на проверка на определено условие, където всяка алтернатива е представена във вид на отделен възел.
- Крайни възли: действие за изпълнение, представляващо окончателно решение.
Алгоритъмът започва от първия възел („корен“ на дървото). Той или взима решение за това към който дочерен възел да премине, или изпълнява действие, съхранено в възела, и приключва.
Какво е предимството, ако дървото на решенията върши същата работа, като if операторите в предишния раздел? Тук има обща система, в която всяко решение има само едно условие и два възможни резултата. Това позволява на разработчика да създаде ИИ от данни, представляващи решенията в дървото, избягвайки хардкодирането им. Нека да го представим под формата на таблица:
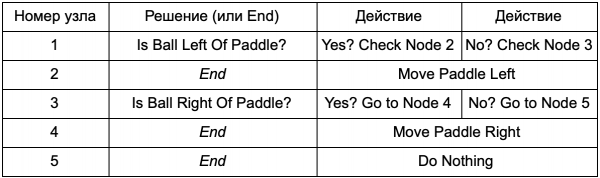
От страна на кода ще получите система за четене на редове. Създайте възел за всеки от тях, свържете логиката за вземане на решения въз основа на втория стълб и дочерните възли, въз основа на третия и четвъртия стълб. Все още ще трябва да програмирате условията и действията, но сега структурата на играта ще бъде по-сложна. В нея добавяте допълнителни решения и действия, а след това настройвате целия ИИ, просто редактиране на текстов файл с дефиницията на дървото. След това предавайте файла на геймдизайнера, който ще може да промени поведението без необходимост от преподкомпилиране на играта и месене на кода.
Дърветата на решенията са изключително полезни, когато се изграждат автоматично на база голям набор от примери (например, използвайки алгоритъма ID3). Това ги прави ефективен и високо производителен инструмент за класификация на ситуации на базата на получените данни. Въпреки това, ние излизаме извън простата система за избор на действия от агентите.
Сценарии
Разгледахме системата на дървото на решенията, което използва предварително зададени условия и действия. Човекът, проектиращ ИИ, може да организира дървото, както иска, но все още трябва да разчита на програмиста, който е програмирал всичко това. Какво ако можем да предоставим на дизайнера инструменти за създаване на собствени условия или действия?
За да не се налага на програмиста да пише код за условията Is Ball Left Of Paddle и Is Ball Right Of Paddle, той може да направи система, в която дизайнерът да записва условия за проверка на тези стойности. Тогава данните на дървото на решенията ще изглеждат така:
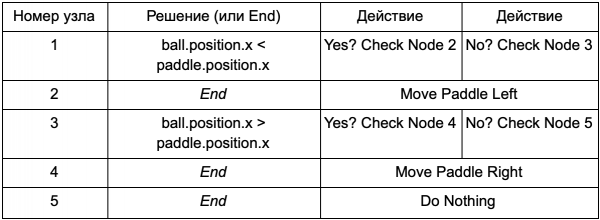
Всъщност това е същото като в първата таблица, но решенията в него имат собствен код, който е малко подобен на условната част на if-оператора. От страна на кода, това ще бъде прочетено втората колона за възлите за вземане на решения, но вместо да търси конкретно условие за изпълнение (Is Ball Left Of Paddle), то оценява условното изразяване и връща true или false съответно. Това се прави с помощта на скриптов език като Lua или Angelscript. С тях разработчикът може да приема обекти в играта си (ball и paddle) и да създава променливи, които ще бъдат достъпни в сценария (ball.position). Освен това, езикът на скриптовете е по-прост от C++. Той не изисква пълен етап на компилация, което го прави идеален за бързо коригиране на игровата логика и позволява на "некодерите" сами да създават нужните функции.
В приведения пример езикът на скриптовете се използва само за оценка на условното изразяване, но той може да се ползва и за действия. Например, данните Move Paddle Right, могат да станат оператор на сценария (ball.position.x += 10). Така, че действието също да се определя в скрипта, без необходимост от програмиране на Move Paddle Right.
Може да се стигне още по-далеч и напълно да се напише дърво от решения на езика на скриптовете. Това ще е код във вид на твърдо програмирани (hardcoded) условни оператори, но те ще бъдат в външни файлове на скрипта, т.е. могат да се променят без да се компилира повторно цялата програма. Често може да се променя файлът на сценария директно по време на игра, за да се тества бързо различни реакции на AI.
Реагиране на събития
Примерите по-горе са идеални за Pong. Те непрекъснато стартират цикъла Sense/Think/Act и действат на базата на последното състояние на света. Но в по-сложни игри е нужно да се реагира на отделни събития, а не да се оценяват всички наведнъж. Pong в този случай вече не е удачен пример. Нека изберем друг.
Представете си стрелба, където враговете са неподвижни, докато не открият играча, след което действат в зависимост от своята "специализация": някой ще побегне "раш", а друг ще атакува отдалеч. Това все още е основна реагираща система — "ако играчът е забелязан, направи нещо", — но може логически да се раздели на събитие Player Seen (играч забелязан) и реакция (изберете отговор и го изпълнете).
Това ни връща към цикъла Sense/Think/Act. Можем да напишем частта Sense, която на всеки кадър ще проверява - вижда ли ИИ играча. Ако не, нищо не се случва, но ако го вижда, се създава събитие Player Seen. Кодът ще има отделен раздел, в който се казва: "когато се случи събитието Player Seen, направи ", където - е отговорът, който ви е нужен, за да се свържете с частите Think и Act. По този начин ще настроите реакциите на събитието Player Seen: за "преследващ" герой - ChargeAndAttack, а за снайперист - HideAndSnipe. Тези връзки могат да бъдат създадени в данни файл за лесно редактиране без нужда от повторна компилация. И тук също може да се използва скриптов език.
Вземане на сложни решения
Въпреки че простите системи за реакции са много ефективни, има много ситуации, когато те не са достатъчни. Понякога е необходимо да се вземат различни решения, основани на това, което агентът прави в момента, но представянето им като условие е трудно. Понякога има твърде много условия, за да бъдат ефективно представени в дърво на решения или скрипт. Понякога е нужно предварително да се оцени, как ще се промени ситуацията, преди да се вземе решение за следваща стъпка. За справяне с тези проблеми са необходими по-сложни подходи.
Конечен автомат
Конечен автомат или FSM (Finite State Machine) е начин да кажем, че нашият агент в момента се намира в едно от няколко възможни състояния и че може да преминава от едно състояние в друго. Броят на тези състояния е ограничен - откъдето и името. Най-добрият пример от живота е светофарът. На различни места различни последователности от светлини, но принципът е същият - всяко състояние представлява нещо (стои, минава и т.н.). Светофарът е в само едно състояние по всяко време и преминава от едно в друго на базата на прости правила.
С NPC в игрите историята е подобна. За пример, нека вземем стража с такива състояния:
- Патрулиращ (Patrolling).
- Атакуващ (Attacking).
- Убегващ (Fleeing).
И с такива условия за промяна на неговото състояние:
- Ако стражът види противник, той атакува.
- Ако стражът атакува, но вече не вижда противника, той се връща към патрулирането.
- Ако стражът атакува, но е сериозно ранен, той убягва.
Можете да напишете if-оператори с променлива-състояние на стража и различни проверки: има ли враг наблизо, какво е нивото на здраве на NPC и т.н. Добавяме още няколко състояния:
- Бездействие (Idling) — между патрулированията.
- Търсене (Searching) — когато видимият враг е изчезнал.
- Молба за помощ (Finding Help) — когато врагът е забелязан, но е твърде силен, за да се бори сам.
Изборът за всеки от тях е ограничен — например, стражът няма да отиде да търси изчезнал враг, ако има ниско здраве.
В крайна сметка огромен списък с "ако" <x и y, но не z>, то <p>", може да стане твърде обременителен, затова е необходимо да формализираме метод, който да ни позволи да запомним състоянията и преходите между тях. За да направим това, ще вземем предвид всички състояния и под всяко състояние ще запишем в списък всички преходи към други състояния, заедно с необходимите условия за тях.
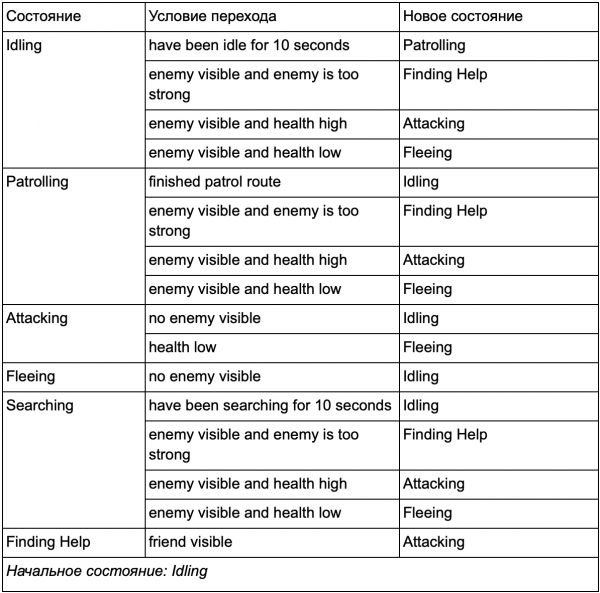
Това е таблица на преходите между състоянията — комплексен начин за представяне на FSM. Нека начертаем диаграма и получим цялостен преглед на това как се променя поведението на NPC.
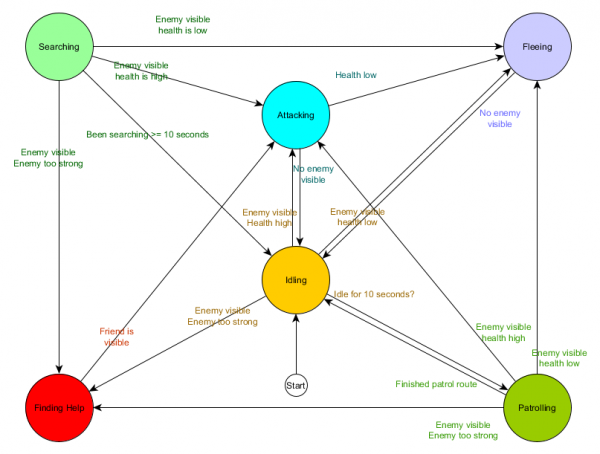
Диаграмата отразява същността на вземането на решения от този агент въз основа на текущата ситуация. Всяка стрелка показва преход между състоянията, ако условието до нея е истина.
При всяко обновление проверяваме текущото състояние на агента, преглеждаме списъка с преходи и ако условията за прехода са изпълнени, той приема ново състояние. Например, на всеки кадър проверяваме дали е изтекъл 10-секундният таймер, и ако е така, от състоянието Idling стражът преминава в Patrolling. По същия начин, състоянието Attacking проверява здравето на агента — ако е ниско, той преминава в състояние Fleeing.
Това е обработка на преходите между състоянията, но какво ще кажете за поведението, свързано със самите състояния? Що се отнася до реализацията на фактическото поведение за конкретно състояние, обикновено съществуват два типа „кука“, където присвояваме действия на FSM:
- Действия, които периодично изпълняваме за текущото състояние.
- Действия, които предприемаме при преход от едно състояние в друго.
Примери за първия тип. Състоянието Patrolling на всеки кадър ще мести агента по патрулния маршрут. Състоянието Attacking на всеки кадър ще се опитва да започне атака или да премине в състояние, когато е възможно.
За втория тип да разгледаме прехода „ако врагът е видим и врагът е твърде силен, то премини в състоянието Finding Help. Агентът трябва да избере къде да отиде за помощ и да запази информацията, така че състоянието Finding Help да знае на къде да се обърне. След като помощта бъде намерена, агентът се връща обратно в състоянието Attacking. В този момент той би искал да информира съюзника за заплахата, така че може да възникне действие NotifyFriendOfThreat.
Отново можем да разгледаме тази система през призмата на цикъла Sense/Think/Act. Sense се реализира в данните, използвани от логиката на прехода. Think — в преходите, достъпни в всяко състояние. А Act се извършва чрез действия, осъществявани периодично в рамките на състоянието или при преходите между състояния.
Понякога непрекъснатото проверка на условията за преход може да бъде костоводно. Например, ако всеки агент извършва сложни изчисления на всеки кадър, за да определи дали вижда врагове и да разбере дали може да премине от състоянието Patrolling към Attacking — това ще отнеме много време на процесора.
Важно е да разгледаме значителни промени в състоянието на света като събития, които ще се обработват при появата им. Вместо FSM да проверява условието за преход „може ли моят агент да види играча?“ на всеки кадър, можем да настроим отделна система да извършва проверки по-рядко (например, 5 пъти в секунда). Резултатът ще бъде Player Seen, когато проверката завърши успешно.
Това се предава на FSM, който сега трябва да премине в условието Player Seen event received и да реагира съответно. Крайната реакция остава същата, с изключение на почти незабележима закъснение преди отговора. Обаче производителността се е подобрила в резултат на разделянето на част от Sense в отделна част от програмата.
Йерархична крайна автоматна машина
Въпреки това, работата с големи FSM не е винаги удобна. Ако искаме да разширим състоянието на атаката, заменяйки го с отделни MeleeAttacking (близък бой) и RangedAttacking (далечен бой), ще трябва да променим преходите от всички останали състояния, които водят до състоянието Attacking (текущи и бъдещи).
Сигурно сте забелязали, че в нашия пример има много дублирани преходи. Повечето преходи в състояние Idling са идентични на преходите в състояние Patrolling. Би било добре да не се повтаряме, особено ако добавим повече сходни състояния. Има смисъл да групираме Idling и Patrolling под общия етикет "небойни", където има един общ набор от преходи към бойни състояния. Ако представим този етикет като състояние, то Idling и Patrolling ще бъдат подсъстояния. Пример за използване на отделна таблица за преходи за ново небойно подсъстояние:
Основни състояния:
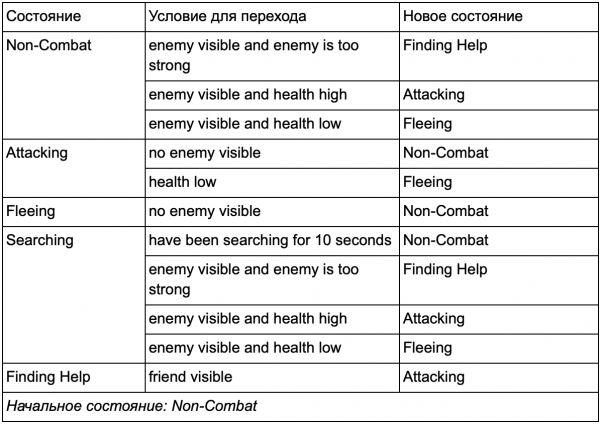
Състояние извън бой:
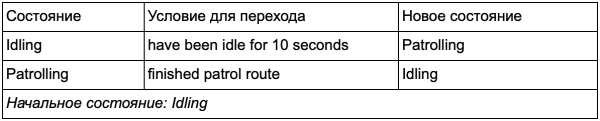
И под формата на диаграма:
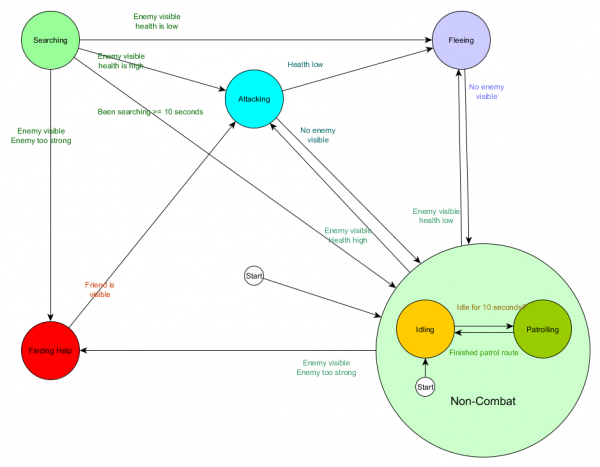
Това е същата система, но с ново небойно състояние, което включва Idling и Patrolling. С всяко състояние, съдържащо FSM с подсъстояния (а тези подсъстояния, от своя страна, съдържат собствени FSM — и така нататък, колкото ви е нужно), получаваме Hierarchical Finite State Machine или HFSM (иерархична крайна автоматизация). Групирайки небойното състояние, ние отрязваме куп излишни преходи. Същото можем да направим и за всякакви нови състояния с общи преходи. Например, ако в бъдеще разширим състоянието Attacking до състояния MeleeAttacking и MissileAttacking, те ще бъдат подсъстояния, преместващи се помежду си в зависимост от разстоянието до врага и наличието на боеприпаси. В крайна сметка сложни модели на поведение и подмодели на поведение могат да бъдат представени с минимум дублирани преходи.
Дърво на поведението
С HFSM се създават сложни комбинации на поведение по прост начин. Въпреки това, има малко затруднение, тъй като вземането на решения под формата на правила за преходи е тясно свързано с текущото състояние. И в много игри, това е точно това, което е необходимо. Внимателното използване на иерархията на състоянията може да намали количеството на повторения при преходите. Но понякога са необходими правила, които работят независимо от това в какво състояние се намирате, или които се прилагат почти във всяко състояние. Например, ако здравето на агента падне до 25%, бихте искали той да избяга, независимо дали е бил в бой, бездействал или разговарял — ще трябва да добавяте това условие в всяко състояние. А ако вашият дизайнер по-късно реши да промени границата за ниско здраве от 25% на 10%, ще се наложи отново да се заеме с това.
В идеалния случай за тази ситуация е необходима система, в която решенията "в какво състояние да бъдат" са извън самите състояния, за да могат промените да се извършват само на едно място и да не се засягат условията за преход. Тук се появяват дърветата на поведение.
Съществуват няколко начина за тяхната реализация, но същността за всички е приблизително еднаква и прилича на дърво за решения: алгоритъмът започва с "кореново" ниво, а в дървото се намират нива, представящи или решения, или действия. Въпреки това, има няколко ключови различия:
- Сега нивата връщат едно от трите стойности: Succeeded (ако задачата е изпълнена), Failed (ако не може да бъде стартирана) или Running (ако все още е в изпълнение и няма окончателен резултат).
- Вече няма нива на решения за избор между две алтернативи. Вместо тях има нива Decorator, които имат един дочерен ниво. Ако те Succeed, изпълняват единственото си дъщерно ниво.
- Нивата, изпълняващи действия, връщат стойност Running, за да представят изпълняваните действия.
Този малък набор от нива може да се комбинира, за да се създадат множество сложни модели на поведение. Да си представим HFSM на стража от предишния пример като дърво на поведение:
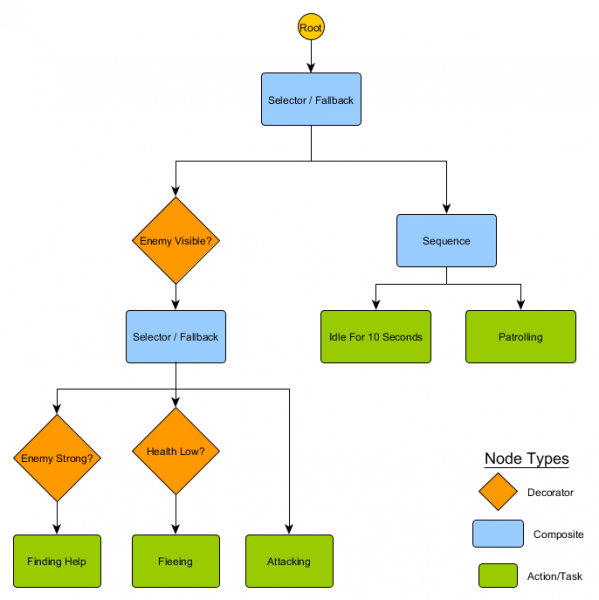
С тази структура не трябва да има явен преход от състояния Idling/Patrolling към състояние Attacking или каквото и да е друго. Ако врагът е видим, а здравето на героя е ниско, изпълнението ще спре на ниво Fleeing, независимо от това какво ниво е извършвало преди — Patrolling, Idling, Attacking или каквото и да е друго.
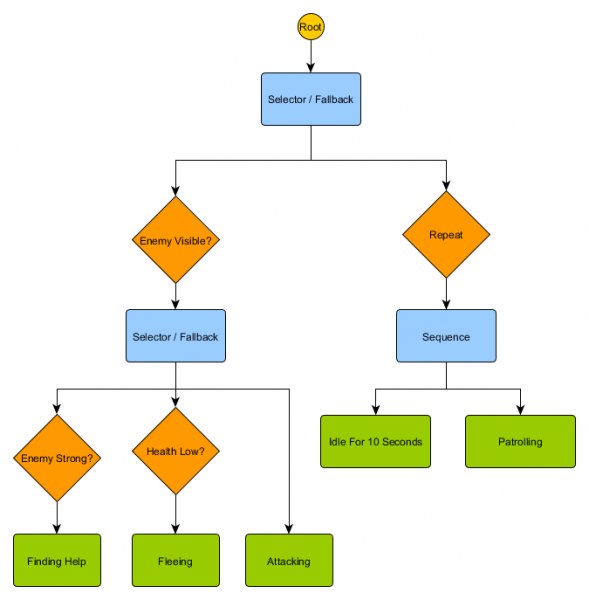
Дърветата на поведение са сложни — има много начини да бъдат съставени, а намирането на правилната комбинация от декоратори и съставни нива може да бъде проблематично. Има и въпроси относно това как често да се проверява дървото — искаме ли да преминаваме през всяка част или само когато едно от условията се е променило? Как да съхраняваме състоянието, свързано с нивата — как да разберем, когато сме били в състояние Idling през 10 секунди или как да разберем какви нива са били изпълнявани последния път, за да обработим последователността правилно?
Точно затова съществуват множество реализации. Например, в някои системи, нивата на декораторите заменят вградени декоратори. Те преоценяват дървото при промяна на условията на декоратора, помагат за свързването на нивата и осигуряват периодични актуализации.
Система, основана на полезност
Някои игри имат множество различни механики. Желателно е да се извлекат всички предимства на простите и общи правила за преход, но не е задължително да имат пълно дърво на поведението. Вместо да имате ясно зададен набор от избори или дърво на възможните действия, е по-лесно да изучите всички действия и да изберете най-подходящото в момента.
Системата, основана на полезността, точно в това помага. Това е система, в която агентът има множество действия и сам избира кое да извърши, основавайки се на относителната полезност на всяко. Полезността е произволна мярка за това колко важно или желателно е извършването на това действие за агента.
Изчислената полезност на действието на базата на текущото състояние и средата, агентът може да провери и да избере най-подходящото друго състояние по всяко време. Това е подобно на FSM, с изключение на това, че промените се определят от оценката за всяко потенциално състояние, включително текущото. Обърнете внимание, че избираме най-полезното действие за преход (или оставаме, ако вече сме го изпълнили). За повече разнообразие, това може да бъде тежестен, но случаен избор от малък списък.
Системата задава произволен диапазон от стойности на полезността — например, от 0 (съвсем нежелателно) до 100 (напълно желателно). Всяко действие има набор от параметри, които влияят на изчислението на тази стойност. Връщайки се на примера ни със стража:
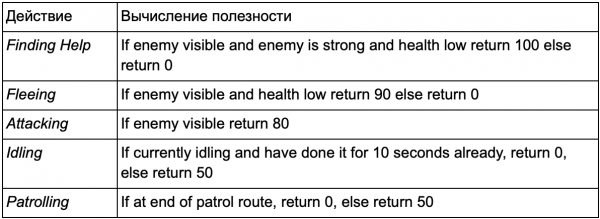
Преходите между действията не са еднозначни — всяко състояние може да последва всяко друго. Приоритетите на действията са в връщаните стойности на полезността. Ако врагът е видим и този враг е силен, а здравето на персонажа е ниско, и Fleeing, и FindingHelp ще върнат високи ненулеви стойности. При това FindingHelp винаги ще бъде по-високо. По аналогичен начин, небойните действия никога не връщат повече от 50, така че винаги ще бъдат по-ниски от бойните. Трябва да се отчита при създаването на действия и изчисляването на тяхната полезност.
В нашия пример действията възвръщат или фиксирано постоянно значение, или едно от две фиксирани стойности. По-реалистичната система предвижда възвръщането на оценка от непрекъснат диапазон от стойности. Например, действието Fleeing връща по-високи стойности на полезността, ако здравето на агента е ниско, а действието Attacking връща по-ниски, ако врагът е твърде силен. Поради това действието Fleeing има приоритет пред Attacking в ситуации, в които агентът чувства, че няма достатъчно здраве, за да победи противника. Това позволява да се променят приоритетите на действията на базата на множество критерии, което прави подхода по-гъвкав и разнообразен от поведенческо дърво или FSM.
Всяко действие има много условия за изчисление на програмата. Те могат да бъдат написани на скриптов език или в серия математически формули. В The Sims, който моделира дневния ред на персонажа, се добавя допълнително ниво на изчисления — агентът получава набор от "мотивации", които влияят на оценките на полезността. Ако персонажът е гладен, с времето той ще става още по-гладен, и резултатът от действието EatFood ще расте, докато персонажът не го изпълни, намалявайки нивото на глада и връщайки стойността на EatFood към нула.
Идеята за избор на действия на базата на система от оценки е доста проста, затова системата, основана на полезността, може да се използва като част от процесите на вземане на решения на ИИ, а не като тяхна пълна замяна. Дървото на решенията може да поиска оценка на полезността на два дочерни модула и да избере по-високата. Подобно на това, поведенческото дърво може да има комбиниран възел Utility за оценка на полезността на действията, за да реши кой дочерен елемент да изпълни.
Движение и навигация
В предишните примери имахме платформа, която премествахме наляво или надясно, и страж, който патрулираше или атакуваше. Но как точно обработваме движението на агента през определен период от време? Как определяме скоростта, как избягваме препятствия и как планираме маршрута, ако достигането до целта е по-сложно от просто движение по права линия? Нека разгледаме това.
Управление
В началния етап ще приемем, че всеки агент има скорост, която включва в себе си как бързо се движи и в каква посока. Тя може да бъде измерена в метри в секунда, километри в час, пиксели в секунда и др. Спомняйки си цикъла Sense/Think/Act, можем да си представим, че частта Think избира скоростта, а частта Act прилага тази скорост към агента. Обикновено в игрите има физическа система, която извършва тази задача вместо вас, проучвайки стойността на скоростта на всеки обект и регулирайки я. Затова можем да оставим ИИ с една задача — да реши каква скорост трябва да има агентът. Ако знаем къде трябва да бъде агентът, то трябва да го преместим в правилната посока с установена скорост. Много тривиално уравнение:
desired_travel = destination_position – agent_position
Представете си 2D свят. Агентът се намира в точка (-2,-2), а целта е някъде на североизток в точка (30, 20), а необходимият път за агента, за да стигне там, е (32, 22). Да предположим, че тези позиции се измерват в метри — ако приемем скоростта на агента за 5 метра в секунда, ще мащабираме нашия вектор на движение и получим скорост около (4.12, 2.83). С тези параметри агентът би пристигнал в целта почти след 8 секунди.
Стойностите могат да бъдат преразгледани по всяко време. Ако агентът е на половината път към целта, движението ще бъде половината дължина, но тъй като максималната скорост на агента е 5 м/с (както решихме по-горе), скоростта ще бъде една и съща. Това също работи за движещи се цели, позволявайки на агента да прави малки корекции, докато те се движат.
Но ние искаме повече променливост — например, бавно да увеличим скоростта, за да симулираме персонаж, който преминава от стоящо състояние до бяг. Същото може да се направи и в края преди спиране. Тези функции са известни като steering behaviours, всяка от които има конкретни наименования: Seek (търсене), Flee (бягство), Arrival (прибытие) и др. Идеята е, че силите на ускорение могат да бъдат приложени към скоростта на агента, на базата на сравнение между местоположението на агента и текущата скорост със целта, за да се използват различни способи за движение към целта.
Всяко поведение има малко различна цел. Seek и Arrival са методи за придвижване на агента до точка на местоназначение. Obstacle Avoidance (избягване на препятствия) и Separation (разделяне) коригират движението на агента, за да заобиколят препятствията по пътя към целта. Alignment (съгласуване) и Cohesion (свързаност) поддържат агентите при придвижването им заедно. Съществува множество различни steering behaviours, които могат да се сумират, за да получим един вектор на движение, като се вземат предвид всички фактори. Агент, използващ поведението Arrival, Separation и Obstacle Avoidance, за да се държи на разстояние от стени и други агенти. Този подход работи добре в открити местности без излишни детайли.
В по-трудни условия, съчетаването на различни поведения работи по-зле - например, агент може да остане затворен в стена поради конфликта между Arrival и Obstacle Avoidance. Затова трябва да разгледаме опции, които са по-сложни от простото сумиране на всички стойности. Един подход е: вместо да се сумират резултатите от всяко поведение, можем да разгледаме движението в различни посоки и да изберем най-добрия вариант.
Обаче в сложна среда с задънени улици и избор за посока, в която да се движим, ще ни трябва нещо още по-напреднало.
Поиск на пътя
Steering behaviours са отлични за просто движение на открито (футболно поле или арена), където достигането от А до Б е прав маршрут с малки отклонения от препятствията. За сложни маршрути ни трябва pathfinding (търсене на път), който е метод за изучаване на света и вземане на решение за маршрута през него.
Най-простият начин е да наложите мрежа на все квадрати около агента и да оцените в кои от тях е разрешено движение. Ако някой от тях е целевата точка, следвайте маршрут от всеки квадрат към предишния, докато не стигнете до началото. Това е маршрутът. В противен случай повторете процеса с най-близките квадрати, докато не намерите целта или не свършат квадратите (това означава, че няма възможен маршрут). Това е известно под формалното наименование Breadth-First Search или BFS (алгоритъм за търсене в ширина). На всяка стъпка той разглежда всички посоки (затова се нарича breadth, „ширина“). Пространството за търсене прилича на вълнов фронт, който се движи, докато не достигне желаното място — обхватът на търсене се разширява на всяка стъпка, докато не включи крайната точка, след което може да се проследи пътят до началото.
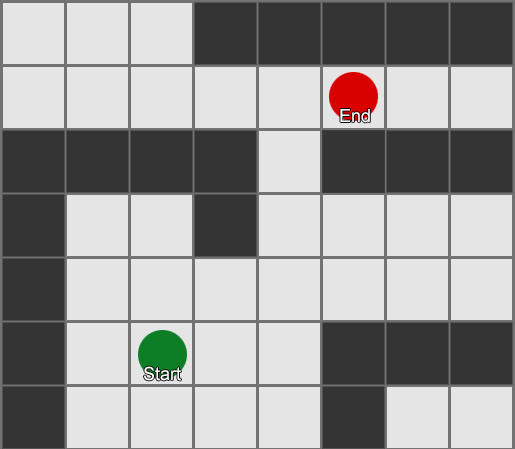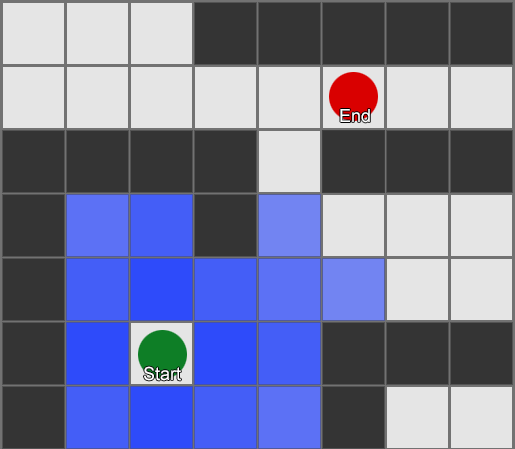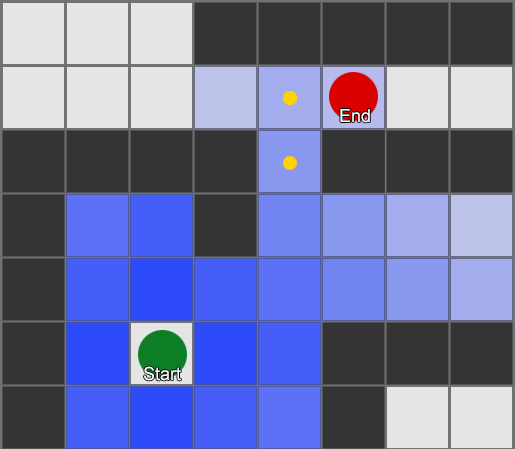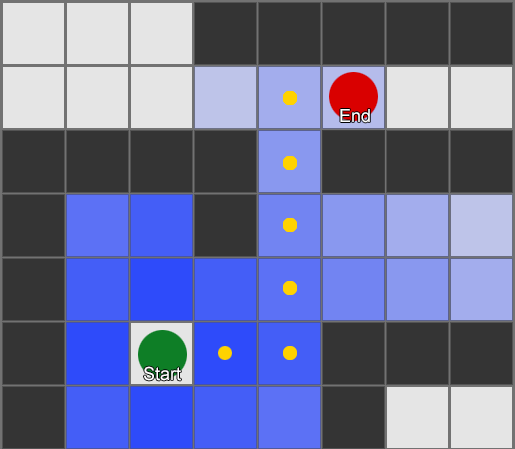
В резултат на това ще получите списък с квадратите, по които е съставен необходимият маршрут. Това е пътят (оттук, pathfinding) — списък с места, които агентът ще посети, следвайки към целта.
Имам предвид, че знаем местоположението на всеки квадрат в света, можем да използваме steering behaviours, за да се движим по пътя — от възел 1 към възел 2, след това от възел 2 към възел 3 и така нататък. Най-простият вариант е да се насочите към центъра на следващия квадрат, но още по-добре е да се спре в средата на ръба между текущия квадрат и следващия. Това позволява на агента да остри ъглите при остри завои.
Алгоритъмът BFS има и недостатъци — той изследва същото количество квадрати в „неправилната“ посока, колкото и в „правилната“. Тук се появява по-сложен алгоритъм, наречен A* (A star). Той работи по същия начин, но вместо сляпо да изследва съседните квадрати (след това съседите на съседите, след това съседите на съседите на съседите и така нататък), той събира възли в списък и ги сортира така, че следващият изследван възел винаги да бъде този, който ще доведе до най-краткия маршрут. Възлите се сортират на база хевристика, която взема под внимание две неща — „цената“ на хипотетичния маршрут до нужния квадрат (включително всякакви разходи за движение) и оценка колко далеч е този квадрат от целта (насочвайки търсенето в правилната посока).
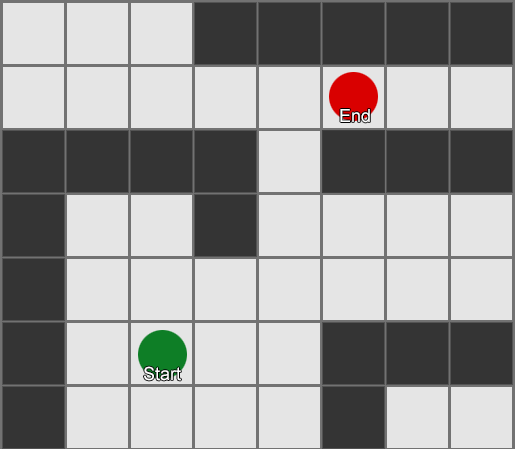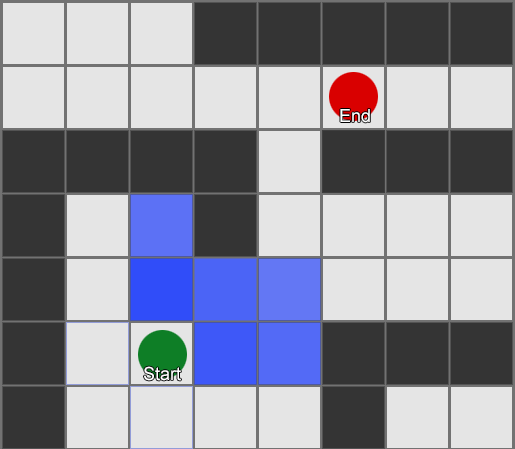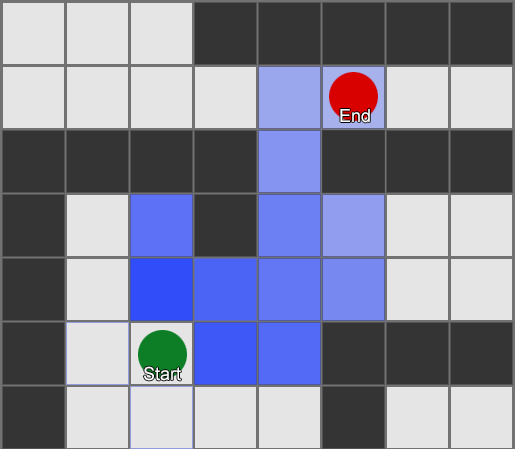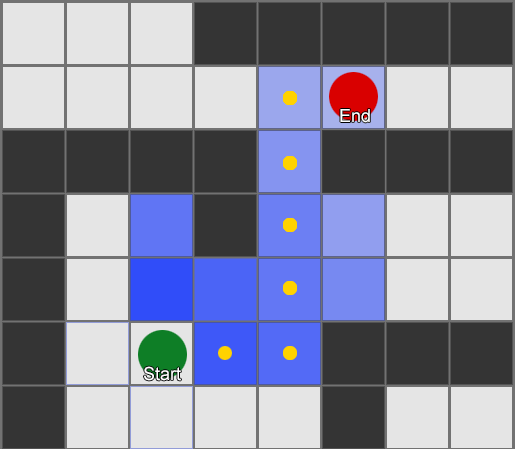
В този пример се показва, че агентът изследва по един квадрат наведнъж, всеки път избирайки съседен, който е най-перспективен. Полученият път е същият като при BFS, но в процеса са разгледани по-малко квадрати - а това е от голямо значение за производителността на играта.
Движение без мрежа
Но повечето игри не са направени на мрежа и често е невъзможно да се направи това без да се навреди на реализъм. Нужни са компромиси. Какви размери трябва да имат квадратите? Прекалено големи - и те няма да могат да представят правилно малки коридори или завои, прекалено малки - ще има твърде много квадрати, за да се търси, което в крайна сметка ще отнеме много време.
Първото, което трябва да разберем - мрежата ни дава график на свързани възли. Алгоритмите A* и BFS всъщност работят с графики и изобщо не се интересуват от нашата мрежа. Можехме да поставим възли на произволни места в игровия свят: при наличие на свързаност между всякакви две свързани възли, а също така между началната и крайната точка и поне един от възлите - алгоритъмът ще работи толкова добре, колкото и преди. Често това се нарича система от пътни точки (waypoint), тъй като всеки възел представлява значима позиция в света, която може да бъде част от всякакво количество хипотетични пътища.
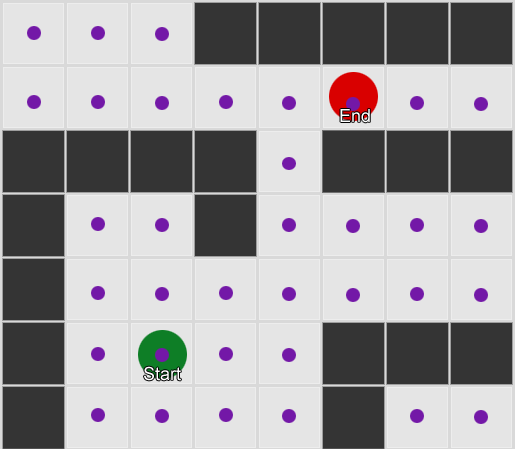
Пример 1: възел във всеки квадрат. Търсенето започва от възела, в който се намира агентът, и завършва в възела на нужния квадрат.
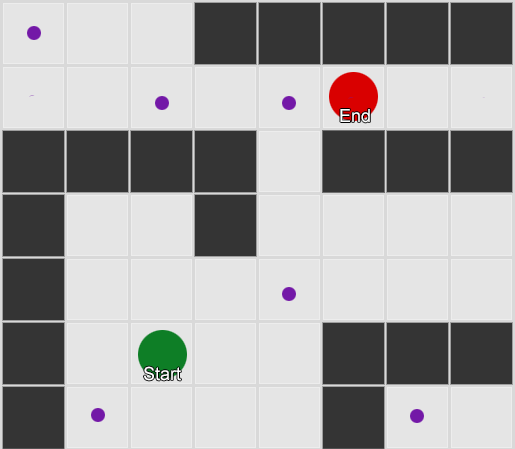
Пример 2: по-малък набор от възли (пътни точки). Търсенето започва в квадрата с агента, преминава през необходимото количество възли и след това продължава до целта.
Това е доста гъвкава и мощна система. Но е нужна известна предпазливост в решенията, къде и как да се поставят пътни точки, иначе агентите просто не могат да видят най-близката точка и не могат да започнат пътя. Щеше да е по-лесно, ако можехме автоматично да поставяме пътни точки на базата на геометрията на света.
Тук влиза навигационната мрежа или navmesh (навигационна мрежа). Това обикновено е 2D мрежа от триъгълници, която се налага върху геометрията на света - навсякъде, където на агента е разрешено да ходи. Всеки от триъгълниците в мрежата става възел в графа и има до три съседни триъгълника, които стават съседни възли в графа.
Тази картина е пример от движението на Unity — той анализира геометрията в света и създава navmesh (на екранната снимка е в светлосин цвят). Всеки полигон в navmesh е област, на която агентът може да стои или да се премества от един полигон в друг. В този пример polygon-ите са по-малки от етажите, на които се намират — направено е, за да се вземат предвид размерите на агента, който ще излиза извън номиналното си положение.
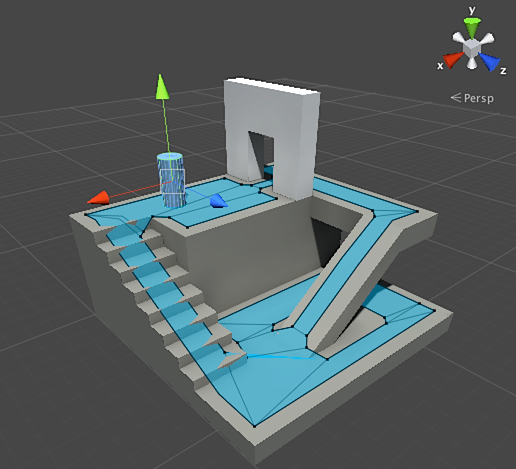
Можем да търсим маршрут през тази мрежа, отново използвайки алгоритъма A*. Това ще ни даде практически идеален маршрут в света, който отчита цялата геометрия и в същото време не изисква излишни възли и създаване на пътни точки.
Pathfinding — твърде обширна тема, за която е недостатъчен един раздел от статия. Ако искате да я изучите по-подробно, в това ще помогне .
Планиране
Убедихме се с pathfinding, че понякога не е достатъчно просто да изберем посока и да се движим — трябва да изберем маршрут и да направим няколко завоя, за да достигнем до желаната дестинация. Можем да обобщим тази идея: постигането на цел не е просто следваща стъпка, а цяла последователност, където понякога е необходимо да погледнем напред на няколко стъпки, за да разберем каква трябва да бъде първата. Това се нарича планиране. Pathfinding може да се разглежда като едно от няколкото допълнения към планирането. От гледна точка на нашия цикъл Sense/Think/Act, това е там, където част от Think планира няколко части от Act в бъдеще.
Нека разгледаме примера на настолната игра Magic: The Gathering. Ние ходим първи с такъв набор от карти в ръцете:
- Swamp — дава 1 черна мана (карта земя).
- Forest — дава 1 зелена мана (карта земя).
- Fugitive Wizard — изисква 1 синя мана за призоваване.
- Elvish Mystic — изисква 1 зелена мана за призоваване.
Игнорираме останалите три карти, за да е по-лесно. Според правилата на играча е позволено да играе 1 карта земя на ход, той може да „тапне“ тази карта, за да извлече от нея мана, а след това да използва заклинания (включително призоваване на същества) на базата на количеството мана. В тази ситуация, играчът-човек знае, че трябва да играе Forest, „тапне“ 1 зелена мана, а след това да призове Elvish Mystic. Но как да го разбере игровият ИИ?
Просто планиране
Тривиален подход — да опитаме всяко действие поред, докато не останат подходящи. Гледайки на картите, ИИ вижда, че може да изиграе Swamp. И го играе. Останали ли са други действия този ход? Той не може да призове нито Elvish Mystic, нито Fugitive Wizard, тъй като за това са му нужни съответно зелена и синя мана, а Swamp дава само черна мана. И вече не може да изиграе Forest, защото вече е изиграл Swamp. Така ИИ е следвал правилата, но е направил това лошо. Има възможност за подобрение.
Планирането може да открие списък с действия, които водят играта в желаното състояние. Както всяка квадратна клетка по пътя имаше съседи (в pathfinding), всяко действие в плана също има съседи или наследници. Можем да търсим тези действия и последващите действия, докато достигнем желаното състояние.
В нашия пример желан резултат е 'да призовем същество, ако е възможно'. В началото на хода виждаме само две възможни действия, разрешени от правилата на играта:
1. Да изиграем Swamp (резултат: Swamp в играта)
2. Да изиграем Forest (резултат: Forest в играта)
Всяко предприето действие може да доведе до последващи действия и да блокира други, отново в зависимост от правилата на играта. Предположим, че сме изиграли Swamp — това ще премахне Swamp като следваща стъпка (вече сме го изиграли), също така ще премахне и Forest (понеже по правилата може да се изиграе само една карта земя на ход). След това ИИ добавя следваща стъпка — получаване на 1 черна мана, тъй като няма други опции. Ако продължи напред и избере Tap the Swamp, ще получи 1 единица черна мана и няма какво да направи с нея.
1. Да изиграем Swamp (резултат: Swamp в играта)
1.1 'Да тапнем' Swamp (резултат: Swamp 'тапната', +1 единица черна мана)
Няма налични действия – КРАЙ
2. Да изиграем Forest (резултат: Forest в играта)
Списъкът с действия е кратък, попаднахме в задънена улица. Повтаряме процеса за следващото действие. Изиграваме Forest, отваряме действие 'да получим 1 зелена мана', което от своя страна ще отвори трето действие — призив на Elvish Mystic.
1. Да изиграем Swamp (резултат: Swamp в играта)
1.1 'Да тапнем' Swamp (резултат: Swamp 'тапната', +1 единица черна мана)
Няма налични действия – КРАЙ
2. Да изиграем Forest (резултат: Forest в играта)
2.1 'Да тапнем' Forest (резултат: Forest 'тапната', +1 единица зелена мана)
2.1.1 Призив на Elvish Mystic (резултат: Elvish Mystic в играта, -1 единица зелена мана)
Няма налични действия – КРАЙ
Накрая изучихме всички възможни действия и намерихме план, призоваващ същество.
Това е много опростен пример. Препоръчително е да изберете най-добрия възможен план, а не просто някой, който отговаря на определени критерии. Обикновено може да оцените потенциалните планове въз основа на крайния резултат или общата полза от тяхното изпълнение. Може да си начислите 1 точка за игра на карта земя и 3 точки за повикване на същество. Да изиграете Swamp би било план, който дава 1 точка. А да изиграете Forest → Tap the Forest → повикване на Elvish Mystic — веднага ще ви даде 4 точки.
Така работи планирането в Magic: The Gathering, но по логиката на това, същата методология може да се приложи и в други ситуации. Например, да преместите пешка, за да освободите място за хода на слона в шахматите. Или да се скриете зад стена, за да може безопасно да стреляте в XCOM по такъв начин. В общи линии, разбирате същността.
Подобреното планиране
Понякога има твърде много потенциални действия, за да се разгледа всеки възможен вариант. Връщайки се към примера с Magic: The Gathering: предположим, че в играта имате няколко карти земя и същества в ръка — броят на възможните комбинации на ходове може да се изчислява на десетки. Съществуват няколко решения на проблема.
Първият начин е обратното свързване (backwards chaining). Вместо да преглеждате всички комбинации, по-добре е да започнете от крайния резултат и да опитате да намерите директен маршрут. Вместо път от корена на дървото към определен лист, ние се движим в обратна посока — от листа към корена. Този метод е по-прост и бърз.
Ако противникът има 1 единица здраве, можете да намерите план „да нанесете 1 или повече единици щета“. За да постигнете това, трябва да изпълните редица условия:
1. Щета може да нанесе заклинание — то трябва да бъде в ръката.
2. За да изиграете заклинание — нужна е мана.
3. За да получите мана — трябва да изиграете карта земя.
4. За да изиграете карта земя — трябва да я имате в ръката си.
Другият начин е наилучше първо търсене (best-first search). Вместо да преглеждаме всички пътища, ние избираме най-подходящия. Най-често този метод дава оптимален план без излишни разходи за търсене. A* е форма на наилучше първо търсене — изследвайки най-перспективните маршрути от самото начало, той вече може да намери най-добрия път без необходимост от проверка на другите варианти.
Интересен и все по-популярности вариант на база best-first search, известный като Monte Carlo Tree Search. Вместо да предполагае, кои планове са по-добри от другите при избора на всяка следваща стъпка, алгоритъмът избира случайни наследници на всяка стъпка, докато не достигне края (когато планът води до победа или загуба). След това крайният резултат се използва за увеличаване или намаляване на оценката на "теглото" на предходните варианти. Повтаряйки този процес няколко пъти, алгоритъмът дава добра оценка на това, коя следваща стъпка е по-добра, дори ако ситуацията се променя (ако противникът предприеме действия, за да възпрепятства играча).
В разказа за планирането в игрите не може да се мине без Goal-Oriented Action Planning или GOAP (целенасочено планиране на действия). Това е широко използван и обсъждан метод, но освен няколко отличителни детайла, той по същността си е метод на backwards chaining, за който говорихме по-рано. Ако задачата е била „унищожи играча“, а играчът е зад прикритие, планът може да бъде: унищожи с граната → вземи я → хвърли.
Обикновено има няколко цели, всяка с приоритет. Ако целта с най-висок приоритет не може да бъде изпълнена (нито комбинация от действия не създава план "унищожи играча", защото играчът не е видим), ИИ ще се върне към целите с по-нисък приоритет.
Обучение и адаптация
Вече говорихме, че игровият ИИ обикновено не използва машинно обучение, тъй като това не подхожда за управление на агенти в реално време. Но това не значи, че не може да се вземе нещо назаем от тази област. Искаме противник в шутера, от когото можем да научим нещо. Например, да разберем за най-добрите позиции на картата. Или противник във файтинг игра, който да блокира често използвани от играча комбо-приемки, подтиквайки го да използва други. Така че машинното обучение в такива ситуации може да бъде доста полезно.
Статистика и вероятности
Преди да преминем към сложни примери, нека разгледаме как далеч можем да стигнем, като вземем няколко прости измервания и ги използваме за вземане на решения. Например, стратегия в реално време — как да определим дали играчът може да започне атака в първите няколко минути на играта и каква защита да подготвим срещу това? Можем да проучим предишния опит на играча, за да разберем каква може да бъде бъдещата реакция. Нека започнем с това, че нямаме такива изходни данни, но можем да ги съберем — всеки път, когато ИИ играе срещу човек, той може да записва времето на първата атака. След няколко сесии ще получим средна стойност на времето, след което играчът ще атакува в бъдеще.
Средните стойности имат и свойството: ако играчът 20 пъти атакува бързо, а 20 пъти играе бавно, нужните стойности ще бъдат някъде в средата, а това няма да ни е от особена полза. Едно от решенията е да ограничим входните данни — можем да вземем предвид последните 20 случаи.
Подобен подход се използва при оценка на вероятността за определени действия, предполагаща, че миналите предпочитания на играча ще останат същите в бъдеще. Ако играчът ни атакува пет пъти с фаербол, два пъти с мълния и един път на близко разстояние, очевидно е, че предпочита фаербола. Екстраполираме и виждаме вероятността за използване на различно оръжие: фаербол=62,5%, мълния=25% и близък бой=12,5%. Нашият игрови ИИ трябва да се подготви за защита от огън.
Още един интересен метод — използването на Наивен Байесов Класификатор за анализ на големи обеми входни данни и класифициране на ситуацията, така че ИИ да реагира по подходящ начин. Байесовите класификатори са най-известни с употребата си в спам филтри за електронна поща. Там те изследват думите, сравняват ги с това, къде са се появявали тези думи преди (в спам или не) и правят заключения за входящите писма. Можем да направим същото дори с по-малко входни данни. На базата на цялата полезна информация, която ИИ вижда (например, кои вражески единици са създадени, или какви заклинания използват, или какви технологии изследват), и крайния резултат (война или мир, „раш„ или защита и т.н.) — ще изберем нужното поведение на ИИ.
Всички тези методи на обучение са достатъчни, но е желателно да се използват въз основа на данни от тестване. ИИ ще се научи да се адаптира към различните стратегии, използвани от вашите плейтестери. ИИ, който се адаптира към играча след пускането, може да стане твърде предсказуем или, обратно, твърде труден за победа.
Адаптация на базата на стойности
Въз основа на съдържанието на нашия игрови свят и правилата, можем да променим набора от стойности, които влияят на вземането на решения, а не просто да използваме входни данни. Правим така:
- Нека ИИ събира данни за състоянието на света и ключовите събития по време на играта (както е посочено по-горе).
- Ще променим няколко важни стойности (value) на базата на тези данни.
- Ще реализираме своите решения, основани на обработката или оценката на тези стойности.
Например, агентът има няколко стаи за избор на картата на шутер от първо лице. Всяка стая има своя стойност, която определя колко желана е за посещение. ИИ случайно избира в коя стая да отиде, основавайки се на стойността. След това агентът запомня в коя стая е убит и намалява нейната стойност (вероятността да се върне там). Аналогично за обратната ситуация — ако агентът унищожава много противници, стойността на стаята се увеличава.
Марковски модел
Какво ще стане, ако използваме събраните данни за прогнозиране? Ако запомняме всяка стая, в която виждаме играча за определен период от време, можем да предугадаем в коя стая играча може да премине. Проследявайки и записвайки движенията на играча между стаите (стойности), можем да ги прогнозираме.
Да вземем три стаи: червена, зелена и синя. И наблюденията, които сме записали при наблюдение на игровата сесия:
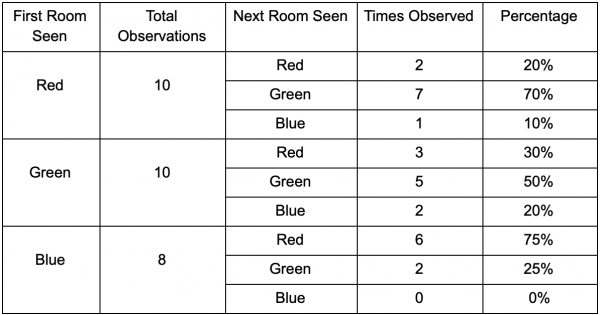
Броят на наблюденията за всяка стая е почти равен — къде да направим добро място за засада, все още не знаем. Събирането на статистика също се усложнява от повторното появяване на играчите, които се появяват равномерно по цялата карта. Но данните за следващата стая, в която влизат след появата си на картата, вече са полезни.
Видно, че зелената стая удовлетворява играчите - повечето хора от червената стая преминават в нея, 50% от които остават там и след това. Синята стая, обратно, не е популярна, почти никой не влиза в нея, а ако все пак влязат, не се задържат.
Но данните ни казват нещо по-важно - когато играчът е в синята стая, следващата стая, в която най-вероятно ще го видим, ще бъде червената, а не зелената. Въпреки че зелената стая е по-популярна от червената, ситуацията се променя, ако играчът е в синята. Следващото състояние (тоест стаята, в която играчът ще премине) зависи от предишното състояние (тоест стаята, в която играчът се намира в момента). Поради изследването на зависимостите ще правим прогнози по-точно, отколкото ако просто преброим наблюденията независимо едно от друго.
Прогнозирането на бъдещото състояние въз основа на данните от миналото състояние се нарича марковска модел (Markov model), а такива примери (с стаи) се наричат марковски вериги. Тъй като моделите представляват вероятността от промени между последователни състояния, визуално те се изобразяват под формата на FSM с вероятност около всяко преминаване. По-рано използвахме FSM, за да представим поведенческото състояние, в което се намира агентът, но тази концепция се разширява за всяко състояние, независимо дали е свързано с агента или не. В този случай състоянията представляват стаята, която заема агентът:
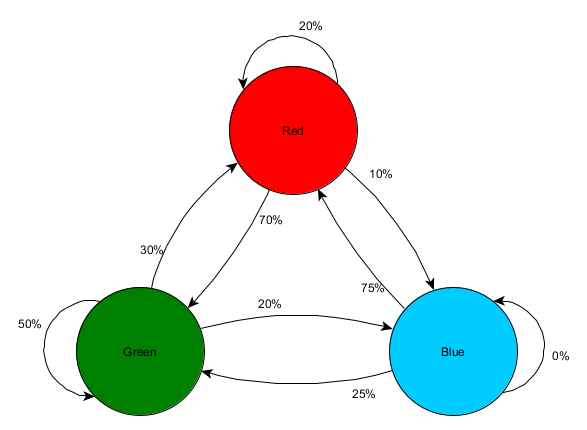
Това е прост вариант за представяне на относителната вероятност от промени в състоянията, даващ на ИИ възможност да предсказва следващото състояние. Може да се предсказват няколко стъпки напред.
Ако играчът е в зелената стая, има 50% шанс той да остане там при следващото наблюдение. Но каква е вероятността, че все още ще бъде там и след това? Има не само шанс играчът да остане в зелената стая след две наблюдения, но и шанс, че е напуснал и се е върнал. Ето новата таблица с новите данни:
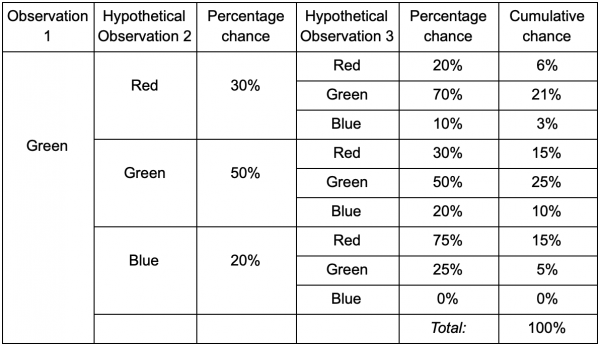
От нея се вижда, че шансът да видим играча в зелената стая след две наблюдения ще бъде 51% - 21%, че ще дойде от червената стая, 5% от тях, че играчът ще посети синята стая между тях и 25%, че играчът изобщо няма да напусне зелената стая.
Таблицата е просто визуален инструмент — процедура изисква само умножаване на вероятностите на всяка стъпка. Това означава, че можете да погледнете далеч в бъдещето с едно уточнение: предполагаме, че шансът да влезете в стаята напълно зависи от текущата стая. Това се нарича марковско свойство (Markov Property) — бъдещото състояние зависи само от настоящето. Но това не е сто процента точно. Играчите могат да променят решенията си в зависимост от други фактори: ниво на здраве или количество боеприпаси. Тъй като не фиксираме тези стойности, нашите прогнози ще бъдат по-малко точни.
N-грамове
А какво ще кажете за примера с бойната игра и предсказването на комбо-ударите на играча? Същото е! Но вместо едно състояние или събитие ще изследваме цели последователности, от които се състои комбо-ударът.
Един от начините да направим това е да запомним всеки вход (например, Kick, Punch или Block) в буфера и да запишем целия буфер като събитие. Така играчът многократно натиска Kick, Kick, Punch, за да използва атаката SuperDeathFist, а системата на ИИ запазва всички входове в буфера и запомня последните три, използвани на всяка стъпка.
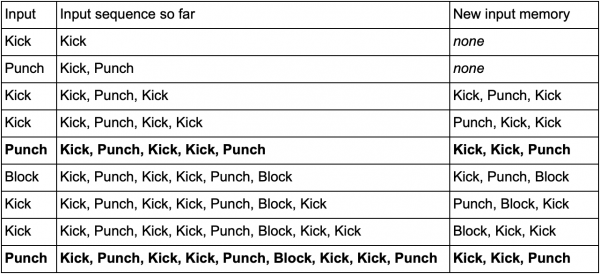
(С удебелен шрифт са подчертаните редове, когато играчът задейства атаката SuperDeathFist.)
ИИ ще види всички варианти, когато играчът е избрал Kick, следван от друг Kick, и след това ще забележи, че следващият вход винаги е Punch. Това ще позволи на агента да прогнозира комбо-атаката SuperDeathFist и да я блокира, ако е възможно.
Тези последователности от събития се наричат N-грамове (N-grams), където N е броят на запазените елементи. В предишния пример това беше 3-грам (триграм), което означава: първите две записи се използват за предсказване на третата. Съответно в 5-грам първите четири записа предсказват петата и така нататък.
Разработчикът трябва внимателно да избере размера на N-грамовете. По-малко число N изисква по-малко памет, но съхранява и по-малка история. Например, 2-грам (биграм) ще записва Kick, Kick или Kick, Punch, но няма да може да запомни Kick, Kick, Punch, затова ИИ няма да реагира на комбо SuperDeathFist.
От друга страна, големите числа изискват повече памет и ИИ ще бъде по-трудно да се обучи, тъй като ще има много повече възможни вариации. Ако имате три възможни входа Kick, Punch или Block, а използваме 10-грам, ще получим около 60 хиляди различни варианта.
Моделите на биграмите са проста маркова верига - всяка двойка "предишно състояние/текущо състояние" е биграма и можете да предскажете второто състояние на базата на първото. 3-грамите и по-големите N-грамите също могат да се считат за маркови вериги, където всички елементи (освен последния в N-грамата) заедно образуват първото състояние, а последният елемент - второто. Пример с бой предава вероятността за преминаване от състояние Kick и Kick към състояние Kick и Punch. Когато разглеждаме няколко записа от входната история като единица, в същност преобразуваме входната последователност в част от цяло състояние. Това ни дава марковото свойство, което позволява използването на маркови вериги за прогнозиране на следващия вход и да отгатнем кой комбо-ход ще бъде следващият.
Заключение
Говорихме за най-разпространените инструменти и подходи в разработката на изкуствен интелект. Също така разгледахме ситуациите, в които те трябва да се прилагат и къде са особено полезни.
Това трябва да бъде достатъчно за разбиране на основните неща в игровия ИИ. Но, разбира се, това не е всичко; по-малко популярни, но не по-малко ефективни са:
- алгоритми за оптимизация, включително изкачване по хълмове, градиентно спускане и генетични алгоритми
- състезателни алгоритми за търсене/планиране (minimax и alpha-beta pruning)
- методи за класификация (перцептрони, невронни мрежи и машини с опорни вектори)
- системи за обработка на възприятие и памет на агентите
- архитектурни подходи към ИИ (хибридни системи, подмножество архитектури и други начини на наслагване на системи за ИИ)
- инструменти за анимация (планиране и синхронизация на движения)
- фактори за производителност (ниво на детайлизация, алгоритми anytime и timeslicing)
Интернет ресурси по темата:
1. На GameDev.net има , както и .
2. включва множество презентации и статии по широк обхват от теми, свързани с разработката на игрови ИИ.
3. включва теми от саммита GDC AI, много от които са достъпни безплатно.
4. Полезни материали също могат да се намерят на сайта .
5. Томми Томпсън, изследовател на ИИ и разработчик на игри, прави видеа в YouTube канала си с обяснения и изучаване на ИИ в комерсиалните игри.
Книги по темата:
1. Серия книги Game AI Pro се състои от сборници с кратки статии, обясняващи как да реализирате конкретни функции или как да решавате специфични проблеми.
2. Серията AI Game Programming Wisdom — предшественик на серията Game AI Pro. В нея се намират по-стари методи, но почти всички са актуални и днес.
3. — е един от основополагающите текстове за всички, които искат да се запознаят с общата област на изкуствения интелект. Тази книга не е за разработка на игри — тя учи на основите на ИИ.
Източник: habr.com
