

Пуснато е изданието 0.9.0 на библиотеката за езика C++ (стандарт C++20) libunicode. Проектът се разработва от екип разработчици на терминален емулатор Contour и интерфейса Endo (в активна разработка) и се разпространява под лицензия Apache 2.0.
- поддръжка на стандарти Unicode 17.0:
- API за получаване на свойства на Unicode;
- SIMD оптимизация на някои функции (с използване на std::simd или std::experimental::simd при наличност);
- оптимизирано конвертиране UTF-8 UTF-16/UTF-32;
- еквивалент на функцията wcwidth (int unicode::width(char32_t));
- сегментиране на текст по графеми, символи, емоджита и писмености;
- преобразуване на регистъра и сравнение на низове;
- високоуровнево API за сегментиране на текст, подходящо за реализация шейпинг на текст.
- покритие с тестове на повечето функции на библиотеката (ширина на символите и сегментация).
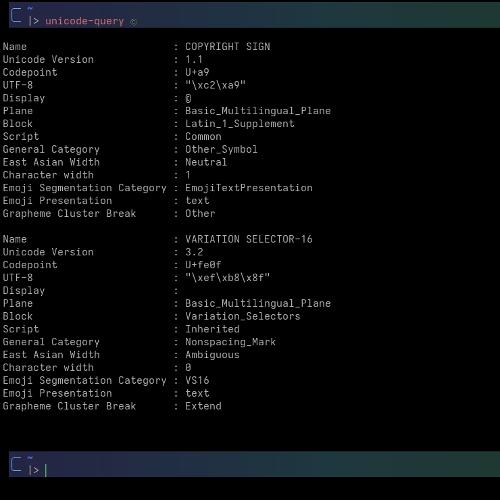
В пакета също така е включен конзолен инструмент unicode-query за получаване на подробна информация за низове.
Промени:
- добавено API grapheme_cluster_width;
- подобрения в работата с версии на Юникод (''Възраст'');
- пълна поддръжка UAX #15 Формати за нормализация на Юникод с поддръжка на потокова обработка:
normalizer norm(Normalization_Form::NFC); // Захранване на разложен e + комбиниращ акут, след това нов стартер за задействане на емисия auto result = norm.feed(U’e’); CHECK(result.empty()); // все още буфериране result = norm.feed(U’u0301′); CHECK(result.empty()); // все още буфериране (комбиниращ знак) result = norm.feed(U’x’); // стартерът задейства емисията на предишния сегмент REQUIRE_FALSE(result.empty()); CHECK(result == U"u00E9"); // e + акут се събира в e-акут result = norm.flush(); CHECK(result == U"x"); // финален сегмент
- функцията script_extensions вече връща std::optional<std::span>;
- реализирано е правилото GB9c за разделяне на групи графеми за комбинации от символи в езиците от групата Indic;
- в grapheme_segmenter са коригирани правилата за GB11 и GB4/GB5; остарялото API е премахнато;
- реализирано е SIMD-оптимизирано конвертиране от UTF-8 в UTF-16/UTF-32;
- ширината на свързващите символи Hangul V/T вече е равна на нула;
- реализирано е сегментиране по граници на думи;
- корекции в C API;
- рефакториран е системата за компилиране и помощния генератор на таблици C++;
- добавени са комплексни тестове за преобразуване на UTF-16/UTF-32;
- в CI е добавена статична компилация на утилита unicode-query.
Източник: linux.org.ru
