

Наскоро излезе , която показва тенденцията в машинното обучение през последните години. В краткост: броят на стартъпите в областта на машинното обучение значително спадна през последните две години.
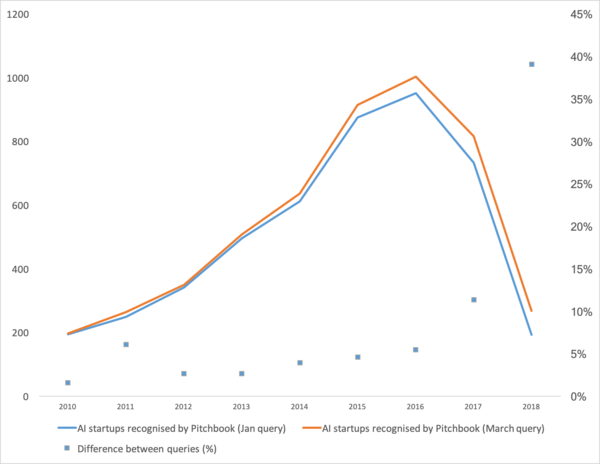
Какво да кажем. Нека разгледаме "спука ли се балонът", "как да живеем по-нататък" и ще поговорим откъде изобщо произлиза тази загогулина.
Първо, нека поговорим какво беше бустер на тази крива. Откъде се появи. Вероятно всеки ще си спомни в машинното обучение през 2012 година на конкурса ImageNet. Все пак, това е събитието с глобално значение! Но всъщност не е така. И нарастването на кривата започва малко по-рано. Аз бих го разделил на няколко момента.
- 2008 година е появата на термина "големи данни". Реалните продукти започнаха от 2010 година. Големите данни са пряко свързани с машинното обучение. Без големи данни, стабилната работа на алгоритмите, които са съществували тогава, е невъзможна. И това не са невронни мрежи. До 2012 година невронните мрежи са дело на маргиналното малцинство. Но тогава започнаха да работят съвсем различни алгоритми, които вече съществуваха години, а понякога и десетилетия: (1963, 1993 години), (1995), (2003),... Стартъпите от онези години първо са свързани с автоматичната обработка на структурирани данни: каси, потребители, реклама, много друго.
Производната на тази първа вълна е набор от фреймворкове, като XGBoost, CatBoost, LightGBM и т.н.
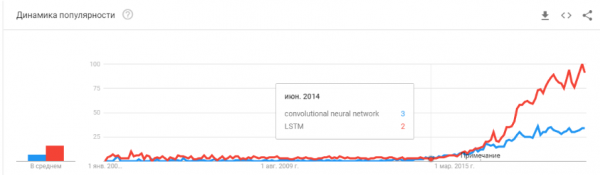
- През 2011-2012 година спечелиха редица конкурси за разпознаване на изображения. Реалното им използване се забави. Бих казал, че масово съзнателните стартъпи и решения започнаха да се появяват от 2014 година. Нужни бяха две години, за да се разбере, че невронките наистина работят, да се създадат удобни фреймворкове, които да могат да бъдат инсталирани и пуснати за разумно време, да се разработят методи, които да стабилизират и ускорят времето за сходство.
Конволюционните мрежи позволиха решаването на задачи в машинното зрение: класификация на изображения и обекти на изображения, откритие на обекти, разпознаване на обекти и хора, подобряване на изображения и т.н.
- 2015-2017 години. Бум на алгоритми и проекти, свързани с рекурентни мрежи или техни аналози (LSTM, GRU, TransformerNet и др.). Появиха се работещи алгоритми за "говор-в-текст", системи за машинен превод. Частично те са на основата на свързващи мрежи за извличане на базисни характеристики. Частично се основават на умението да събират наистина големи и качествени набори от данни.
"Балонът счупи ли се? Хайпът прегря ли? Те умряха като блокчейн?"
О, да! Утре във вашия телефон Сири ще спре да работи, а в други ден Тесла няма да разпознае завой от кенгуру.
Невронните мрежи вече работят. Те са в десетки устройства. Наистина позволяват печалба, променят пазара и околния свят. Хайпът изглежда малко по-различно:
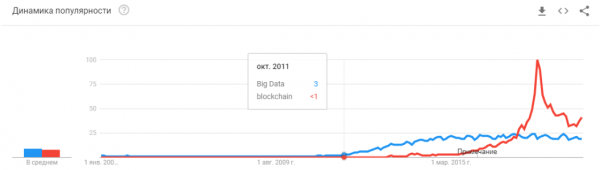
Просто невронните мрежи спряха да бъдат нещо ново. Да, много хора имат завишени очаквания. Но голям брой компании научиха как да прилагат невронки и да създават продукти на тяхна основа. Невронките предоставят нови функционалности, позволяват намаляване на работни места, снижават цената на услугите:
- Производствени компании интегрират алгоритми за анализ на дефекти на конвейера.
- Животновъдни стопанства купуват системи за контрол на крави.
- Автоматизирани комбайни.
- Автоматизирани кол центрове.
- Филтри в SnapChat. (поне нещо смислено!)
Но най-важното, и не съвсем очевидно: "Нови идеи няма, или те няма да донесат мигновен капитал". Невронните мрежи решиха десетки проблеми. И ще решат още повече. Всички очевидни идеи, които съществуваха — породиха множество стартапи. Но всичко, което беше на повърхността — вече се събра. През последните две години не съм срещал нито една нова идея за прилагане на невронни мрежи. Нито един нов подход (добре, по отношение на GAN-ите има някакви проблеми).
А всеки следващ стартап става все по-сложен. Той вече изисква не двама души, които обучават невронка на отворени данни. Изисква програмисти, сървъри, екип от анотатори, сложна поддръжка и т.н.
В резултат — стартапите стават по-малко. А производството нараства. Трябва да добавите разпознаване на автомобилни номера? На пазара има стотици специалисти с релевантен опит. Можете да наемете и след няколко месеца ваш служител ще направи система. Или да купите готова. Но да създадете нов стартап?.. Лудост!
Трябва да се създаде система за проследяване на посетителите — защо да плащате за куп лицензии, когато можете за 3-4 месеца да направите своя, настроена за вашия бизнес.
В момента невронните мрежи преминават през същия път, който изминаха десетки други технологии.
Спомняте ли си как се променяше от 1995 година понятието "разработчик на сайтове"? Докато пазарът не е наводнен от специалисти. Професионалистите са много малко. Но мога да споря, че след 5-10 години няма да има особена разлика между Java програмист и разработчик на невронни мрежи. И двете специалисти ще бъдат достатъчни на пазара.
Просто ще има клас задачи, за които са предназначени невронките. Изникнала е задача — наемате специалист.
„А какво следва? Къде е обещаният изкуствен интелект?“
А ето тук има малка, но интересна неяснота:)
Този стек технологии, който имаме днес, явно няма да ни доведе до изкуствен интелект. Идеите, тяхната новост — в значителна степен са се изчерпали. Нека поговорим за това, което задържа настоящото ниво на развитие.
Ограничения
Нека започнем с автомобилите без шофьор. Изглежда ясно, че изцяло автономните автомобили с днешните технологии са възможни. Но след колко години ще се случи това — не е ясно. Tesla счита, че това ще се случи след няколко години —
Има много други , които оценяват това на 5-10 години.
Скоро, според мен, след 15 години инфраструктурата на градовете сама ще се промени така, че появата на автономни автомобили да стане неизбежна, ще бъде продължение на нея. Но това не може да се счита за интелект. Съвременната Tesla е много сложен конвейер за филтриране на данни, тяхното търсене и пренасочване. Това са правила-правила-правила, събиране на данни и филтри върху тях (вот аз малко по-подробно за това написах, или погледнете с бележка).
Проблем номер едно
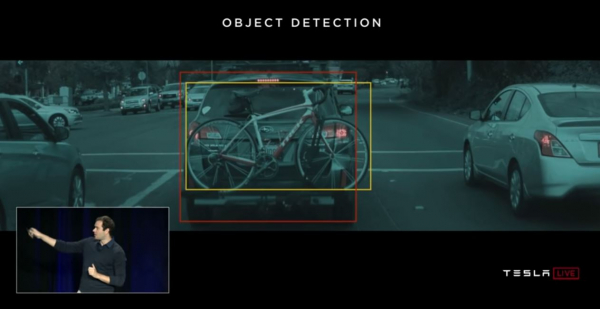
И именно тук виждаме първия основен проблем. Големи данни. Именно те породиха текущата вълна от невронни мрежи и машинно обучение. Сега, за да направите нещо сложно и автоматизирано, е необходимо много данни. Не просто много, а наистина много. Необходими са автоматизирани алгоритми за тяхното събиране, разметка и използване. Искаме да направим така, че машината да вижда камиони на фона на слънцето – първо трябва да съберем достатъчно от тях. Искаме машината да не полудява от велосипеда, прикрепен към багажника – повече семпли.
Но един пример не е достатъчен. Стотици? Хиляди?
Втората проблема
Втората проблема – визуализацията на това, което нашата невронна мрежа е разбрала. Това е много нетривиална задача. Все още малко хора разбират как да я визуализират. Тези статии са доста свежи, ето само няколко примера, дори и отдалечени:
зациклянето на текстури. Добре показва на какво невронната мрежа е склонна да се зацикля + какво възприема като отправна информация.
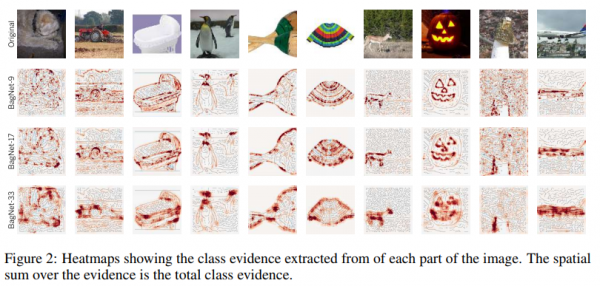
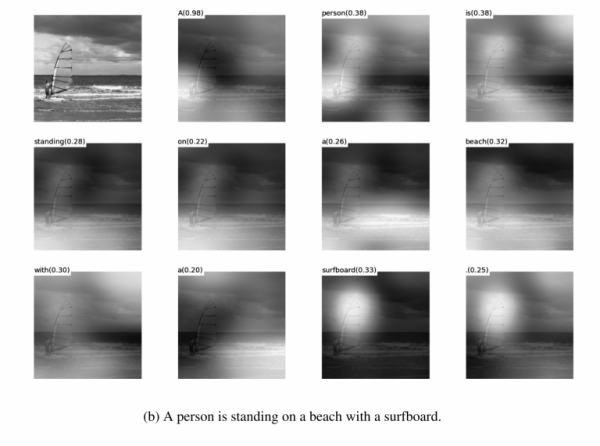
атеншън при . Наистина атеншън често може да се използва именно за да се покаже какво е предизвикало такава реакция от мрежата. Срещал съм такива неща както за дебъг, така и за продуктови решения. За тази тема има много статии. Но колкото по-сложни са данните, толкова по-трудно е да се разбере как да се постигне стабилна визуализация.
Е, и да, старият добър набор от „виж какво има вътре в “. Тези картинки бяха популярни преди 3-4 години, но всички бързо осъзнаха, че картинките са красиви, но не носят много смисъл.
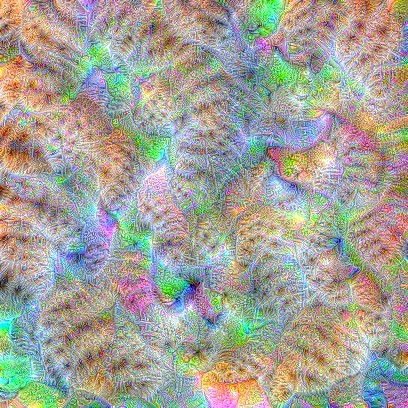
Не споменах десетки други трикове, методи, хакове и изследвания относно това как да се изобразят вътрешностите на мрежата. Работят ли тези инструменти? Помагат ли бързо да се разбере какъв е проблемът и да се дебъгва мрежата?.. Да се извадят последните проценти? Ами, горе-долу така:
Можете да разгледате всяко състезание в Kaggle. И описанията на това как хората правят окончателните решения. Ние натрупахме 100-500-800 милиона модели и то проработи!
Разбира се, преувеличавам. Но тези подходи не дават бързи и ясни отговори.
С достатъчен опит, опитвайки различни варианти, можете да издадете присъда за това защо вашата система е взела такова решение. Но да коригирате поведението на системата ще бъде трудно. Да сложите временен фикс, да преместите прага, да добавите датасет, да вземете друга бекенд мрежа.
Третата пробема
Третата фундаментална пробема — мрежите учат не логика, а статистика. Статистически това :
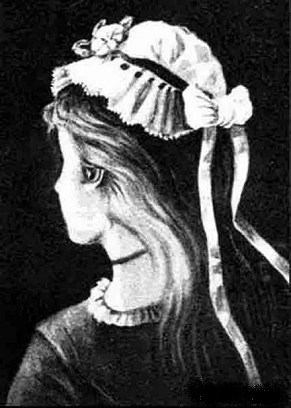
Логически — не изглежда много приложимо. Невронните мрежи не учат нещо сложно, освен ако не им се нареди. Те винаги учат максимално прости признаци. Има ли очи, нос, глава? Значи това е лице! Или дай пример, където очите не ще означават лице. И отново — милиони примери.
Има много място в дъното
Бих казал, че именно тези три глобални проблема в момента ограничават развитието на невронните мрежи и машинното обучение. А там, където тези проблеми не ограничават — вече активно се използва.
Това ли е краят? Невронните мрежи спряха?
Не е ясно. Но, разбира се, всички се надяват, че не.
Има много подходи и направления за решаване на тези основни проблеми, които споменах по-горе. Но засега нито един от тези подходи не е позволил да се направи нещо фундаментално ново, да се реши нещо, което досега не е било решавано. В момента всички основни проекти са на базата на стабилни подходи (Tesla) или остават тестови проекти на институти или корпорации (Google Brain, OpenAI).
Говорейки грубо, основното направление е създаването на високо ниво представяне на входните данни. В известен смисъл “памет”. Най-простият пример за памет са различни “Embedding” — представяне на изображения. Например, всички системи за разпознаване на лица. Мрежата се учи да получи от лицето стабилно представяне, което не зависи от ъгъла, осветлението, разрешението. По същество мрежата минимизира метриката “различни лица — далеч” и “еднакви — близо”.
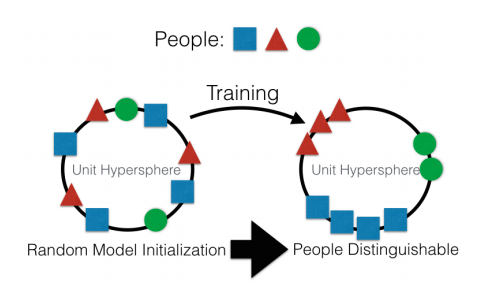
За такова обучение са нужни десетки и стотици хиляди примери. Затова резултатът носи известни наченки на “One-shot Learning”. Сега не ни трябват стотици лица, за да запомним човек. Само едно лице, и всичко — ние !
Само че идва проблем… Мрежата може да научи само достатъчно прости обекти. При опити да различаваме не лица, а например “хора по дрехите” (задача ) — качеството се проваля с много порядъци. И мрежата вече не може да научи достатъчно очевидни смени на ъгли.
И обучението на милиони примери — също както и да е развлечение.
Има работи по значително намаляване на избора. Например, веднага можем да споменем една от първите работи по OneShot Learning :
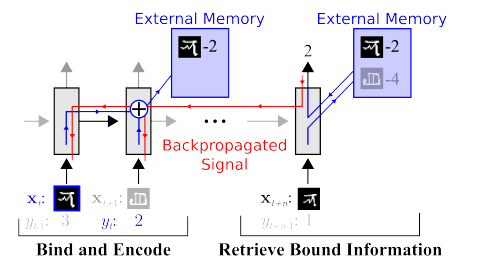
Има много такива работи, например или или .
Недостатъкът е, че обучението обикновено работи добре само с някои прости, "MNIST" примери. А при преминаване към сложни задачи е необходима голяма база, модел на обектите или нещо като магия.
Всъщност работата по One-Shot обучението е много интересна тема. Откриват се много идеи. Но в повечето случаи двете проблеми, които изброих (предобучение върху огромен датасет / нестабилност при сложни данни), сериозно пречат на обучението.
От друга страна, GAN — генеративно-състезателни мрежи, също подхождат към темата за Embedding. Сигурно сте чели на Хабра много статии по тази тема. (, ,)
Особеност на GAN е формирането на някакво вътрешно пространство на състояния (по същество същото Embedding), което позволява да се създаде изображение. Това може да бъдат , могат да бъдат .
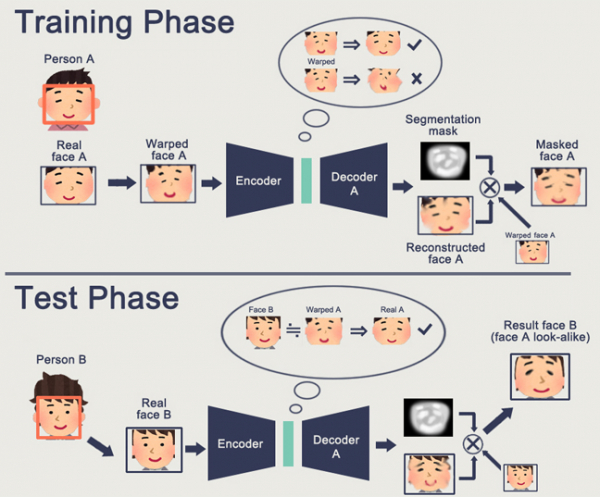
Проблемът с GAN е, че колкото по-сложен е генерираният обект, толкова по-трудно е да се опише логиката "генератор-дискриминатор". В резултат на това, от реалните приложения на GAN, които са известни, остава само DeepFake, който отново манипулира представянията на лица (за които съществува огромна база).
Други полезни приложения съм срещал много малко. Обикновено става дума за някакви нововъведения с добавяне на елементи в изображения.
И пак. Никой няма разбиране как това ще ни помогне да напреднем към светло бъдеще. Представянето на логиката / пространството в невронна мрежа е добре. Но е необходим огромен брой примери, не разбираме как невронната мрежа представя това, не разбираме как да накараме невронната мрежа да запомни някакво наистина сложно представяне.
Обучение с подсилване е подход от съвсем друга страна. Сигурно помните как Google победи всички в Go. Н recentите победи в Starcraft и Dota. Но тук всичко е далеч не толкова розово и перспективно. Най-добре за RL и трудностите му разказва .
Ако обобщим написаното от автора:
- Моделите от кутията не подхождат / работят в повечето случаи слабо.
- Практическите задачи е по-лесно да се решат с други методи. Boston Dynamics не използва RL заради неговата сложност / непредвидимост / сложността на изчисленията.
- За да заработи RL — необходима е сложна функция. Често е трудно да се създаде / напише.
- Трудно е да се обучават модели. Налага се да се отделя много време, за да се раздвижат и изведат от локалните оптимуми.
- Следствие от това е, че моделът е трудно повторим, а моделът е нестабилен при минимални промени.
- Често се оверфитва на произволни закономерности, чак до генератор на случайни числа.
Ключов момент е, че RL все още не работи в продукция. Google има някакви експерименти ( , ). Но не съм виждал нито една производствена система.
Памет. Минусът на всичко гореописано е неструктурирането. Един от начините, по които се опитват да се справят с това, е да предоставят на невронната мрежа достъп до отделна памет. Така тя може да записва и презаписва резултатите от своите стъпки. Тогава невронната мрежа може да се определя спрямо текущото състояние на паметта. Това много прилича на класическите процесори и компютри.
Най-известната и популярна — от DeepMind:
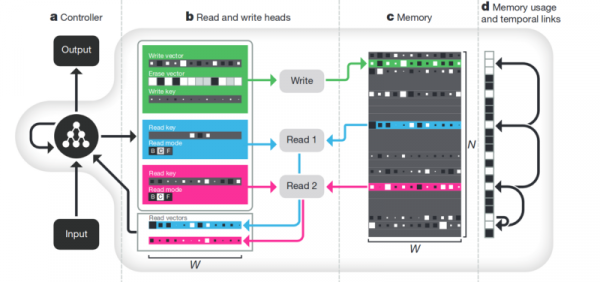
Изглежда, че ето го, ключът към разбирането на интелекта? Но по-скоро не. Системата все пак изисква огромен обем данни за обучение. А работи основно със структурирани таблични данни. В същото време, когато Facebook подобен проблем, те поеха по пътя "начи, забравяме паметта, просто ще направим невронката по-сложна, да има повече примери — и тя сама ще се обучи".
Разделяне. Друг начин да се създаде значима памет е да вземем същите embeddings, но при обучението да въведем допълнителни критерии, които да позволят да се изолират "смислите" в тях. Например, искаме да обучим невронната мрежа да различава поведението на човек в магазина. Ако следвахме стандартния път — трябваше да направим десетки мрежи. Едната търси човека, другата определя какво прави, третата — възрастта му, четвъртата — пола. Отделна логика разглежда частта от магазина, където той е, обучава се по това. Третата определя неговата траектория и т.н.
Или, ако имаше безкрайно много данни, можеше да се обучи една мрежа на всевъзможни изходи (очевидно е, че такъв обем данни не може да се събере).
Дизайн подходът говори, че нека обучим мрежата така, че сама да може да различава понятия. За да може по видеото да създаде ембединг, където една област определя действие, една — положение на пода във времето, една — ръста на човека, а друга — неговия пол. При това, при обучението, искаме почти да не насочваме мрежата към ключовите понятия, а тя сама да идентифицира и групира областите. Такова съдържание е сравнително малко (некоите от тях , , ) и като цяло е доста теоретично.
Но това направление, поне теоретично, трябва да решава посочените в началото проблеми.
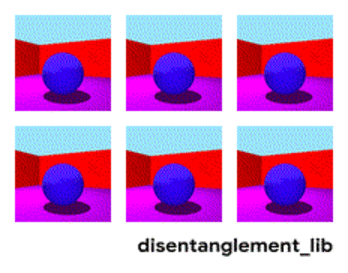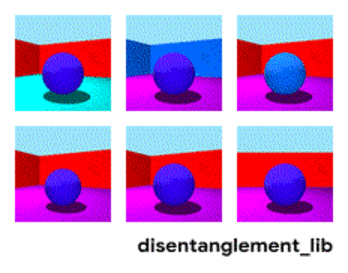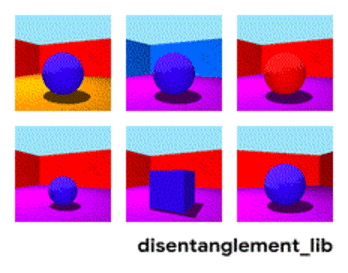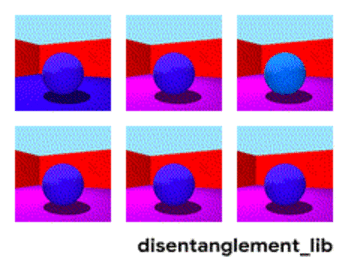
Разделяне на изображението по параметри "цвет на стените/цвет на пода/форма на обекта/цвет на обекта/и т.н."
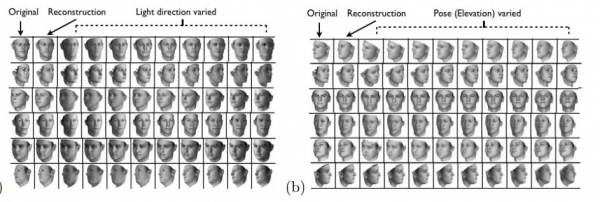
Разделяне на лицето по параметри "размер, вежди, ориентация, цвят на кожата, и т.н."
Други
Има много други не толкова глобални направления, които позволяват по някакъв начин да се намалят базите, да се работи с по-хетерогенни данни, и т.н.
Attention. Вероятно няма смисъл да се отделя като метод. Просто подход, който усилва другите методи. На него са посветени много статии (,,). Същността на Attention е да засили реакцията на мрежата именно на важните обекти при обучението. Често с някакво външно целево указание или с малка външна мрежа.
3D симулация. Ако направим добър 3D движещ се механизъм, то с него можем да покрием често 90% от обучителните данни (даже съм виждал пример, където почти 99% от данните се покриваха с добър механизъм). Има много идеи и хака как да накараме мрежа, обучена на 3D механизъм, да работи с реални данни (Fine tuning, style transfer, и т.н.). Но често е на няколко порядъка по-трудно да се направи добър механизъм, отколкото да се съберат данни. Примери, когато бяха направени механизми:
Обучение на роботи (, )
Обучение на стоки в магазина (но в двата проекта, които направихме — спокойно се справихме без това).
Обучение в Tesla (отново същото видео, което беше по-горе).
Изводи
Цялата статия е в известен смисъл изводи. Вероятно основното послание, което исках да предам, е — "безплатният обяд свърши, невронките вече не предоставят лесни решения". Сега трябва да се трудиш, изграждайки сложни решения. Или да се трудиш, правейки сложни научни изследвания.
А всъщност темата е спорна. Може би читателите имат по-интересни примери?
Източник: habr.com
