

Съвременните информационни системи са доста сложни. Сложността им е до голяма степен обусловена от разнообразието на данните, които се обработват. Сложността на данните често се изразява не само в техния обем („volume“), но и в тяхното разнообразие („variety“).
Ако в момента не намирате недостатъци в разсъжденията, четете нататък.
Съдържание
Polyglot persistence
Гореказаното води до това, че понякога в рамките на дори една система е необходимо да се използват различни СУБД за съхранение на данни и решаване на различни задачи по обработка, всяка от които поддържа своя собствена модел на данни. С лека ръка на М. Фаулър, на редица известни книги и един от Agile Manifesto, тази ситуация е наречена многовариантно съхранение („polyglot persistence“).
На Фаулър принадлежи и следният пример за организация на съхранение на данни в пълнофункционално и високо натоварено приложение в областта на електронната търговия.
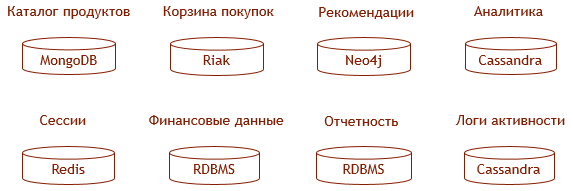
Този пример, разбира се, е малко преувеличен, но някои съображения в полза на избора на съответната СУБД за дадена цел могат да се намерят например .
Разбираемо е, че да бъдеш служител в такъв зоопарк не е лесно.
- Обемът на кода, който извършва съхранение на данни, нараства пропорционално на броя на използваните СУБД; обемът на кода, който синхронизира данните, – добре е ако не е пропорционален на квадрата на това число.
- Разходите за осигуряване на enterprise характеристики (мащабируемост, отказоустойчивост, висока наличност) на всяка от използваните СУБД нарастват кратно на броя на използваните СУБД.
- Невъзможно е да се осигурят enterprise характеристики на подсистемата за съхранение като цяло – особено транзакционността.
От гледна точка на директора на зоопарка, всичко изглежда така:
- Увеличението на разходите за лицензи и техническа поддръжка от производителя на СУБД.
- Увлечение на щата и удължаване на сроковете.
- Директни финансови загуби или санкции поради несъответствие на данните.
Налице е значително повишаване на общата стойност на притежание на системата (TCO). Има ли изход от ситуацията с "многовариантно съхранение"?
Мултимоделност
Терминът "многовариантно съхранение" навлезе в употреба през 2011 година. Осъзнаването на проблемите на подхода и търсенето на решение отне няколко години, и към 2015 година анализаторите от Gartner формулираха отговора:
- От "»:
Бъдещето на СУБД, техните архитектури и начини на използване е мультимоделността.
- От "»:
Водещите оперативни СУБД ще предлагат няколко модела — релационен и нерелационни — в рамките на единна платформа.
Изглежда, че този път анализаторите от Gartner не сгрешиха с прогнозата. Ако влезете на страницата с СУБД на DB-Engines, можете да видите, чепо-голямата част от техните лидери се позиционират именно като мультимоделни СУБД. Същото може да видите и на страницата с какъвто и да е частен рейтинг.
В таблицата по-долу са представени СУБД — лидери в всеки от частните рейтинги, които заявяват за своята мультимоделност. За всяка СУБД е посочен първоначалният поддържан модел (в някакъв момент бил единствен) и заедно с него моделите, които в момента се поддържат. Също така са посочени СУБД, които се позиционират като "първоначално мультимоделни", без да имат по заявлението на създателите си каквато и да е първоначална унаследена модел.
| СУБД | Първоначален модел | Допълнителни модели |
|---|---|---|
| Oracle | Релационен | Графов, документен |
| MS SQL | Релационен | Графов, документен |
| PostgreSQL | Релационен | Графов*, документен |
| MarkLogic | Документен | Графов, релационен |
| MongoDB | Документен | Ключ-стойност, графов* |
| DataStax | Широк колона | Документен, графов |
| Redis | Ключ-стойност | Документен, графов* |
| ArangoDB | — | Графов, документен |
| OrientDB | — | Графов, документен, релационен |
| Azure CosmosDB | — | Графов, документен, релационен |
Забележки към таблицата
С звездички в таблицата са отбелязани твърдения, които изискват уточнения:
- СУБД PostgreSQL не поддържа графов модел на данни, но такъв продукт го поддържа , като например AgensGraph.
- По отношение на MongoDB, по-правилно е да се говори по-скоро за наличие на графови оператори в езика за запитвания (, ), свързани с поддръжката на графовата моделна система, въпреки че, разбира се, тяхното внедряване изискваше определени оптимизации на физическото съхранение в посока на поддръжка на графовата моделна система.
- В контекста на Redis това означава разширение на .
След това за всеки от класовете ще покажем как се реализира поддръжката на няколко модела в СУБД от този клас. Най-важни ще считаме релационния, документния и графовия модели и на примери от конкретни СУБД ще демонстрираме как се реализират "липсващите".
Мултимоделни СУБД на базата на релационен модел
Водещите СУБД в момента са релационни, прогноза на Gartner не би могла да се счита за изпълнена, ако РСУБД не демонстрират движения към мултимодалност. И те демонстрират. Сега разсъжденията, че мултимодалната СУБД е подобна на швейцарския нож, с когото не може да се направи нищо добре, могат веднага да бъдат адресирани към Лари Елисън.
Авторът обаче предпочита реализирането на мултимодалност в Microsoft SQL Server, на примера на който ще бъде описана поддръжката на РСУБД за документния и графовия модели.
Документен модел в MS SQL Server
Относно това как в MS SQL Server е реализирана поддръжката на документния модел, вече бяха публикувани две отлични статии в Хабра, ще се огранича до кратко резюме и коментар:
Начинът на поддръжка на документния модел в MS SQL Server е достатъчно типичен за релационните СУБД: JSON-документите се предлагат за съхранение в обикновени текстови полета. Поддръжката на документния модел се състои в предоставянето на специални оператори за разбиране на този JSON:
- за извличане на скалярни стойности на атрибутите,
- за извличане на под-документи.
Вторият аргумент и на двата оператора е израз в синтаксис, подобен на JSONPath.
Абстрактно може да се каже, че съхраняваните по този начин документи не са "първокласни" същности в релационната СУБД, за разлика от кортежите. Конкретно в MS SQL Server в момента липсват индекси по полетата на JSON-документите, което затруднява операциите на свързване на таблици по стойностите на тези полета и дори извлечението на документи по тези стойности. Въпреки това, е възможно да се създаде изчисляем стълб и индекс по него.
Допълнително, MS SQL Server предоставя възможност удобно да се конструира JSON-документ от съдържанието на таблиците с помощта на оператора — възможност, в известен смисъл противоположна на предишната, обичайно съхранение. Ясно е, че колкото и бърза да е РСУБД, такъв подход противоречи на идеологията на документните СУБД, които по същество съхраняват готови отговори на популярни запитвания и могат да решават само проблеми с удобството на разработката, но не и с бързодействието.
Накрая, MS SQL Server позволява да се реши задачата, обратна на конструирането на документа: можем да разпределим JSON по таблици с помощта на . Ако документът не е напълно плосък, ще е необходимо да се използва CROSS APPLY.
Графов модел в MS SQL Server
Поддръжката на графова (LPG) модел е реализирана в Microsoft SQL Server също напълно : предлага се използването на специални таблици за съхранение на възли и за съхранение на ръбовете на графа. Такива таблици се създават с помощта на изрази CREATE TABLE AS NODE и CREATE TABLE AS EDGE съответно.
Таблиците от първия вид наподобяват обичайни таблици за съхранение на записи с единственото външно отличие, че в таблицата присъства системно поле $node_id — уникален в рамките на базата данни идентификатор на възел в графа.
По аналогия, таблиците от втория вид имат системни полета $from_id и $to_id, записите в такива таблици разбираемо задават връзки между възлите. За съхранение на връзките от всеки вид се използва отделна таблица.
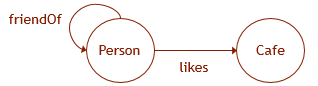 Илюстрираме казаното с пример. Нека графовите данни имат схема както на представената рисунка. Тогава за създаване на съответстващата структура в базата данни трябва да се изпълнят следните DDL запитвания:
CREATE TABLE Person (
  ID INTEGER NOT NULL,
  name VARCHAR(100)
) AS NODE;

CREATE TABLE Cafe (
  ID INTEGER NOT NULL,
  name VARCHAR(100),
) AS NODE;

CREATE TABLE likes (
  rating INTEGER
) AS EDGE;

CREATE TABLE friendOf
  AS EDGE;

ALTER TABLE likes
  ADD CONSTRAINT EC_LIKES CONNECTION (Person TO Cafe);
Основната специфика на такива таблици е, че в запитванията към тях е възможно да се използват графови шаблони с Cypher-подобен синтаксис (въпреки че „*“ и пр. засега не се поддържат). На база измервания на производителността може също да се предположи, че начинът на съхранение на данни в тези таблици е различен от механизма на съхранение на данни в обикновените таблици и е оптимизиран за изпълнение на подобни графови запитвания.
SELECT Cafe.name
  FROM Person, likes, Cafe
  WHERE MATCH (Person-(friendOf)-(likes)->Cafe)
  AND Person.name = 'John';
Освен това, доста трудно е при работа с подобни таблици да не се използват тези графови шаблони, тъй като в обикновените SQL заявки за решаване на подобни задачи ще е необходимо да се полагат допълнителни усилия за получаване на системни „графови“ идентификатори на възлите ($node_id, $from_id, $to_id; по същата причина заявките за вмъкване на данни не са включени тук, тъй като са излишно обемисти).
В заключение на описанието на реализациите на документната и графовата модели в MS SQL Server, бих отбелязал, че подобни реализации на една модел върху друга не изглеждат успешни най-вече от гледна точка на езиковия дизайн. Нужно е един език да се разширява с друг, езиците не са напълно „ортогонални“, правилата за съвместимост могат да бъдат доста странни.
Мултимоделни СУБД на базата на документен модел
В тази статия искам да илюстрирам реализиране на мултимодалност в документни СУБД чрез примера на не най-популярната от тях MongoDB (както беше споменато, в нея има само условно графови оператори $lookup и $graphLookup, които не работят на шардрени колекции), а чрез примера на по-зряла и „ендпрайз“ СУБД .
И така, нека колекцията съдържа набор от XML-документи от следния вид (съхранението на JSON-документи также е позволено от MarkLogic):
John
  Smith
Релационен модел в MarkLogic
Релационното представяне на колекцията от документи може да бъде създадено с помощта на (съдържанието на елементите value в примера по-долу може да бъде произволен XPath):
/Person


      Person


          SSN
          @SSN
          string


          name
          name


          surname
          surname
К създаденото представяне може да се направи SQL заявка (например, чрез ODBC):
SELECT name, surname FROM Person WHERE name="John"За съжаление, създаденото с помощта на шаблон за преобразуване релационно представяне е само за четене. При обработката на заявката MarkLogic ще се опита да използва . По-рано в MarkLogic е имало и ограничени релационни представяния, които са напълно и достъпни за запис, но в момента те се считат за остарели.
Графов модел в MarkLogic
С поддръжка на графовата (RDF) модел всичко стои приблизително по същия начин. Отново с помощта на може да се създаде RDF представяне на колекцията от документи от примера по-горе:
/Person
PREFIX
"http://example.org/example#"
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || surname )
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || name )
К полученото RDF графо може да се адресира SPARQL заявка:
PREFIX :
SELECT ?name ?surname {
  :631803299804 :name ?name ; :surname ?surname .
}
В отличие от релационната, графовата модел MarkLogic поддържа още два други начина:
- СУБД може да бъде напълно отделно хранилище на RDF данни (триплетите в него ще се наричат в противоположност на описаните по-горе ).
- RDF в специална сериализация може просто да бъде вмъкнат в XML или JSON документи (и триплетите тогава ще се наричат ). Вероятно, това е една алтернатива на механизмите
idrefи пр.
Добро представяне на това, как "наистина" всичко е устроено в MarkLogic, дава , в този смисъл то е нискоуровнево, въпреки че назначението му е по-скоро обратното — да се опита да абстрахира от използваната модел на данни, да осигури последователна работа с данни в различни модели, транзакционност и пр.
Мултимоделни СУБД "без основен модел"
На пазара също така са представени СУБД, позициониращи се като изначално мультимоделни, които нямат никаква наследена основна модел. Към техния брой спадат , (от 2018 година компанията разработчик принадлежи на SAP) и (услуга в състава на облачната платформа Microsoft Azure).
Наистина "основни" модели в ArangoDB и OrientDB съществуват. Това в двата случая са собствени модели данни, които представляват обобщения на документната. Обобщенията се изразяват основно в улесняването на възможността за изпълнение на заявки с графов и релационен характер.
Тези модели са единствено налични за използване в посочените СУБД, за работа с тях са предназначени собствени езици за запитвания. Безспорно, такива модели и СУБД са перспективни, но отсъствието на съвместимост със стандартните модели и езици прави невъзможно използването на тези СУБД в наследените системи — замяната им в вече използваните там СУБД.
За ArangoDB и OrientDB вече имаше страхотна статия в Хабра: .
ArangoDB
ArangoDB заявява подкрепа за графовия модел на данни.
Възлите на графа в ArangoDB са обикновени документи, а ръбовете — документи със специален вид, които имат наред с обикновените системни полета (_key, _id, _rev) системни полета _from и _to. Документите в документните СУБД традиционно се обединяват в колекции. Колекции от документи, представляващи ръбове, в ArangoDB се наричат edge-колекции. Между другото, документите на edge-колекциите също са документи, така че ръбовете в ArangoDB могат да служат и като възли.
Изходни данни
Нека имаме колекция persons, документите на която изглеждат така:
[
  {
    "_id"  : "people\/alice" ,
    "_key" : "alice" ,
    "name" : "Алиса"
  },
  {
    "_id"  : "people\/bob" ,
    "_key" : "bob" ,
    "name" : "Боб"
  }
]
Нека също има колекция cafes:
[
  {
    "_id" : "cafes\/jd" ,
    "_key" : "jd" ,
    "name" : "Джон Донн"
  },
  {
    "_id" : "cafes\/jj" ,
    "_key" : "jj" ,
    "name" : "Жан-Жак"
  }
]
Тогава колекцията likes може да изглежда по следния начин:
[
  {
    "_id" : "likes\/1" ,
    "_key" : "1" ,
    "_from" : "persons\/alice" ,
    "_to" : "cafes\/jd",
    "since" : 2010
  },
  {
    "_id" : "likes\/2" ,
    "_key" : "2" ,
    "_from" : "persons\/alice" ,
    "_to" : "cafes\/jj",
    "since" : 2011
  } ,
  {
    "_id" : "likes\/3" ,
    "_key" : "3" ,
    "_from" : "persons\/bob" ,
    "_to" : "cafes\/jd",
    "since" : 2012
  }
]
Запитвания и резултати
Запитването в графов стил на използвания в ArangoDB език AQL, връщащ в четим вид данни за това, на кого кое кафе харесва, изглежда така:
FOR p IN persons
  FOR c IN OUTBOUND p likes
  RETURN { person : p.name , likes : c.name }
В релационен стил, когато по-скоро „изчисляваме“ връзките, а не ги съхраняваме, това запитване може да бъде записано по следния начин (между другото, без колекция likes можеше да се мине без нея):
FOR p IN persons
  FOR l IN likes
  FILTER p._key == l._from
    FOR c IN cafes
    FILTER l._to == c._key
    RETURN { person : p.name , likes : c.name }
Резултатът и в двата случая ще бъде един и същ:
[
  { "person" : "Алиса" , likes : "Жан-Жак" } ,
  { "person" : "Алиса" , likes : "Джон Донн" } ,
  { "person" : "Боб" , likes : "Джон Донн" }
]
Още запитвания и резултати
Ако форматът на резултата изглежда по-характерен за релационна СУБД, отколкото за документна, можете да опитате следния заявка (или можете да използвате ):
ЗА p В persons
  ВРЪЩАШ {
    човек : p.name,
    харесвания : (
      ЗА c В OUTBOUND p likes
      ВРЪЩАШ c.name
    )
}
Резултатът ще изглежда по следния начин:
[
  { "човек" : "Алиса" , харесвания : ["Жан-Жак" , "Джон Донн"]  } ,
  { "човек" : "Боб" , харесвания : ["Джон Донн"] }
]
OrientDB
В основата на реализирането на графова модел върху документна в OrientDB лежи полетата на документите да имат освен стандартни скаларни стойности и стойности от типове като LINK, LINKLIST, LINKSET, LINKMAP и LINKBAG. Стойностите на тези типове — са връзки или колекции от връзки към документи.
Присвоеният от системата идентификатор на документа има "физически смисъл", указващ позицията на записа в базата, и изглежда горе-долу така: @rid : #3:16. По този начин стойностите на връзковите свойства — наистина по-скоро са указатели (както в графовата модел), а не условия за филтриране (както в релационната).
Както и в ArangoDB, в OrientDB ръбовете се представят като отделни документи (макар че, ако ръбът няма свои собствени свойства, може да стане , и той няма да съответства на отделен документ).
Изходни данни
В формат, близък до базата OrientDB, данните от предишния пример за ArangoDB ще изглеждат горе-долу така:
[
     {
      "@type": "document",
      "@rid": "#11:0",
      "@class": "Person",
      "name": "Алиса",
      "out_likes": [
        "#30:1",
        "#30:2"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#12:0",
      "@class": "Person",
      "name": "Боб",
      "out_likes": [
        "#30:3"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#21:0",
      "@class": "Cafe",
      "name": "Жан-Жак",
      "in_likes": [
        "#30:2",
        "#30:3"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#22:0",
      "@class": "Cafe",
      "name": "Джон Донн",
      "in_likes": [
        "#30:1"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#30:1",
      "@class": "likes",
      "in": "#22:0",
      "out": "#11:0",
      "since": 1262286000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:2",
      "@class": "likes",
      "in": "#21:0",
      "out": "#11:0",
      "since": 1293822000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:3",
      "@class": "likes",
      "in": "#21:0",
      "out": "#12:0",
      "since": 1325354400000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    }
  ]
Както виждаме, върховете също съхраняват информация за входящи и изходящи ръбове. При API за документа за целостност на връзките трябва да се следи ръчно, докато Graph API поема тази задача. Нека да видим как изглежда заявката към OrientDB на "чисти", неинтегрирани в програмни езици езици за заявки.
Запитвания и резултати
Заявката, аналогична на тази в примера за ArangoDB, в OrientDB изглежда така:
SELECT name AS person_name, OUT('likes').name AS cafe_name
   FROM Person
   UNWIND cafe_name
Резултатът ще бъде получен в следния вид:
[
  { "person_name": "Алиса", "cafe_name": "Джон Донн" },
  { "person_name": "Алиса", "cafe_name": "Жан-Жак" },
  { "person_name": "Боб",  "cafe_name": "Жан-Жак" }
]
Ако форматът на резултата отново изглежда прекалено "релационен", трябва да се премахне редът с :
[
  { "person_name": "Алиса", "cafe_name": [ "Джон Донн", "Жан-Жак" ] },
  { "person_name": "Боб",  "cafe_name": [ "Жан-Жак" }]
]
Езикът за заявки на OrientDB може да се опише като SQL с вставки, подобни на Gremlin. В версия 2.2 се появи форма на заявка, подобна на Cypher, :
MATCH {CLASS: Person, AS: person}-likes->{CLASS: Cafe, AS: cafe}
RETURN person.name AS person_name, LIST(cafe.name) AS cafe_name
GROUP BY person_name
Форматът на резултата ще бъде същият като в предишната заявка. Помислете какво трябва да се премахне, за да стане по-"релационен", както в първата заявка.
Azure CosmosDB
В по-малка степен казаното по-горе за ArangoDB и OrientDB се отнася за Azure CosmosDB. CosmosDB предлага следните API за достъп до данни: SQL, MongoDB, Gremlin и Cassandra.
SQL API и MongoDB API се използват за достъп до данни в документната модел. Gremlin API и Cassandra API — за достъп до данни съответно в графовия и колонковия модел. Данните във всички модели се съхраняват в формата на вътрешния модел на CosmosDB: ("atom-record-sequence"), който също е близък до документния.
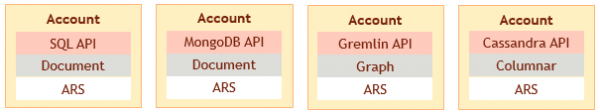
Но избраната от потребителя модел на данни и използваният API се фиксират в момента на създаване на акаунта в услугата. Невъзможно е да се получи достъп до данни, заредени в една модел, в формата на друг модел, което би илюстрирало приблизително следната схема:
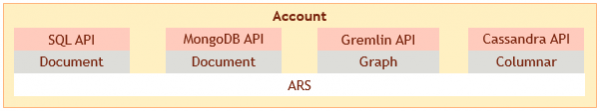
По този начин мултимодалността в Azure CosmosDB за момента представлява само възможността да се използват няколко бази данни, поддържащи различни модели, от един производител, което не решава всички проблеми на многовариантното съхранение.
Мултимоделни СУБД на базата на графов модел?
Забележително е, че на пазара все още няма мултимодални СУБД с основа графовата модел (освен ако не броим мултимодалността, поддържащи едновременно два графови модела: RDF и LPG; вижте за това в ). Най-големи затруднения предизвиква реализирането над графовата модел на документна, а не релационна.
Въпросът как да се реализира над графовата модел релационна, се разглеждаше още в началото на последната. Как , например, :
Няма нищо присъщо в графовия подход, което да предотвратява създаването на слой (например чрез подходящо индексиране) върху графова база данни, който позволява релационен изглед с (1) възстановяване на кортежи от обичайните двойки ключ-стойност и (2) групиране на кортежи по тип на връзката.
При реализирането на документната модел върху графовата трябва да се има предвид, например, следното:
- Елементите на JSON масива се считат за подредени, излизащи от върха на реброто на графа — не;
- Данните в документната модел обикновено са денормализирани, не е желателно да се съхраняват няколко копия на един и същи вложен документ, а идентификаторите на поддокументите обикновено липсват;
- От друга страна, идеологията на документните СУБД е, че документите са завършени „агрегати“, които не трябва да се изграждат наново всеки път. Необходимо е да се осигури в графовата модел възможност да се получи бързо подграф, съответстващ на готов документ.
Малко реклама
Авторът на статията е свързан с разработката на СУБД NitrosBase, чиято вътрешна модел е графова, а външните модели — релационни и документни — са нейни представления. Всички модели са равноправни: практически всякакви данни са достъпни в която и да е от тях, използвайки естествения за нея език за запитвания. Още повече, в която и да е представление данните могат да бъдат променяни. Промените ще се отразят във вътрешната модел и, съответно, в другите представления.
Как изглежда съответствието на моделите в NitrosBase — ще опиша, надявам се, в една от следващите статии.
Заключение
Надявам се, че общите контури на това, което наричат мультимоделност, станаха по-или-малко ясни за читателя. Мультимоделни се наричат достатъчно различни СУБД, а „подкрепата на множество модели“ може да изглежда по различен начин. За разбирането на това, което наричат „мультимоделност“ в конкретния случай, е полезно да се отговори на следните въпроси:
- Става ли въпрос за подкрепата на традиционни модели или за някаква една „гибридна“ модел?
- „Равноправни“ ли са моделите, или една от тях е подчинена на другите?
- Моделите взаимно ли се влияят? Могат ли данни, записани в една модел, да бъдат прочетени в друга или дори презаписани?
Мисля, че на въпроса за значението на многомоделните СУБД вече може да се даде положителен отговор, но интересен е въпросът какви точно разновидности ще бъдат по-търсени в близко бъдеще. Изглежда, че по-популярни ще бъдат многомоделните СУБД, които поддържат традиционни модели, предимно релационни; популярността на многомоделните СУБД, предлагащи нови модели, които комбинират предимствата на различни традиционни, е въпрос за по-отдалечено бъдеще.
Само регистрирани потребители могат да участват в анкетата. , моля.
Използвате ли многомоделни СУБД?
Не използваме, съхраняваме всичко в една СУБД и в един модел
Използваме многомоделните възможности на традиционни СУБД
Практикуваме многовариантно съхранение (polyglot persistence)
Използваме нови многомоделни СУБД (Arango, Orient, CosmosDB)
19 потребители гласуваха. 4 потребители се въздържаха.
Източник: habr.com
