

За обсъждане в списъка на разработчиците на ядрото на Linux са публикувани пачове с реализирана файловата система BeamFS, която използва кодиране на Рийд-Соумън за идентифициране и възстановяване на повредени данни на място в конфигурации с един носител. Основните области на приложение на BeamFS включват бордови компютри на спътници, оборудване в кабинети за лъчева терапия и други системи, работещи при повишена радиация, за които възстановяването на изкривени данни е по-критично от невъзможността да се прочете информацията.
По подразбиране BeamFS може да възстанови до 8 загубени байта във всеки 255-байтов блок при разходи от 7% (288 байта кодове за възстановяване на всеки 4096 байта съхранявани данни). Кодове за корекция на грешки се прилагат не само за данни, но и за служебна информация в суперблока, inode, индекси на директории и битови карти. Контрол на целостта и опити за възстановяване на липсващи данни се извършват при всяка операция по четене. Ако не може да се гарантира коректността на информацията, операцията завършва с грешка „-EIO“, което изключва скритото връщане на повредени данни.
Проведените експерименти показват, че при облъчване на платката i.MX 8M Plus с Linux и файловата система ext4 с протони с енергия от 20 до 58 мево, 90% от всички неизправности възниквали на ниво файловата система и драйвери на устройства за съхранение. Също така е направена симулация на единични изкривявания на битове при четене от носителя: BeamFS и Btrfs успешно разпознават повреждането на данните и винаги връщат грешка, докато ext4 и ext3 мълчаливо връщат изкривени данни.
BeamFS осигурява целостта и възстановяването само на етапа от четенето от физическия носител до предаването в страничния кеш в оперативната памет. Целостта на съхранението в оперативната памет може да се поддържа с помощта на чипове памет с корекция на грешки.
От ограниченията на BeamFS се отбелязва липсата на поддръжка на журнализиране и режим Copy-on-Write (CoW) — метаданните на носителя се записват неупорядъчено, затова в случай на некоректно приключване на работата е необходима пълна проверка с fsck.
Освен BeamFS наскоро за ядрото на Linux са предложени още две файлови системи:
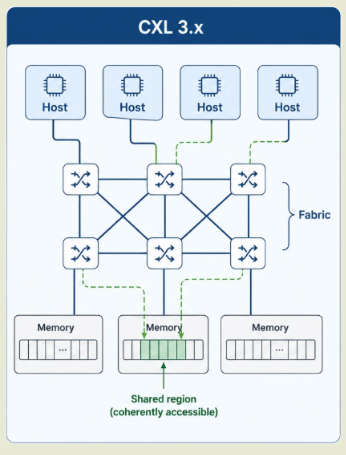
- На конференцията Linux Plumbers Conference 2026, която се проведе преди няколко дни, инженер от компания Huawei представи (видео, слайдове) файловата система XMFS (cross-node eXpress Memory File System) за ядрото на Linux, проектирана за работа в клъстери с обща споделена оперативна памет (подобно на tmpfs, но за паметта на всички възли). XMFS позволява използването на стандартния POSIX интерфейс на файловите системи за работа с външна памет, адресирана директно чрез технологии като CXL 3.0 (Compute Express Link) и Huawei United Bus. Проектът е в етап на експериментален прототип, който преминава вътрешни тестове и все още не е готов за включване в ядрото.

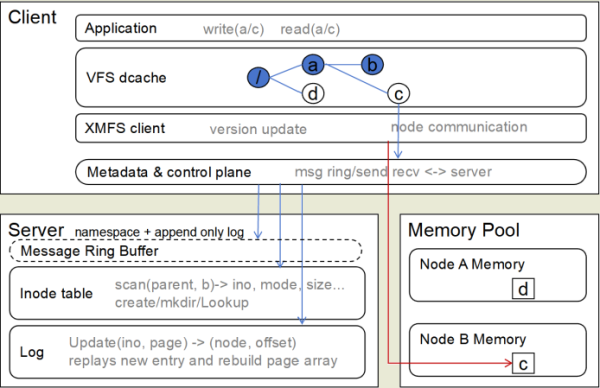
Файловата система има класическа архитектура за разпределени файлови системи с отделяне сървър, отговарящо за журнализацията, поддържането на таблиците inode и съпоставянето на съдържанието и метаданните с паметта на отделните възли.

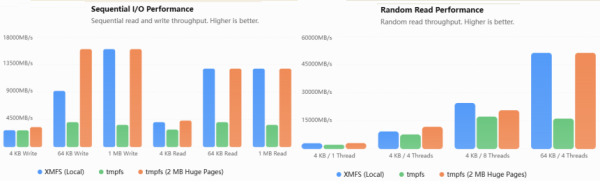
При тестването на XMFS за задачи като споделен достъп до контейнерни образи от различни възли, реализацията показа производителност, близка до tmpfs, с включена голяма памет (2 MB huge pages).


- С помощта на AI е разработена файловата система MeshXFS, представляваща форк на XFS, адаптиран за съвместна употреба на няколко възли в клъстер. MeshXFS позволява монтиране на общо блочно устройство в режим на четене-запис на различни възли, поддържайки целостта и управлявайки заключванията при едновременен достъп до данни. Проектът започна като експеримент за проверка на възможността за създаване с помощта на AI модели на Linux драйвер с файловата система, която поддържа разпределени заключвания, паралелен достъп и възстановяване след повреди. Основната работа бе извършена с Claude Opus, но за решаване на особено сложни проблеми бяха привлечени модели Claude Fable, GPT, Gemini и Astra. Експериментът бе признат за успешен и вече са публикувани няколко работни версии на MeshXFS.
От допълнителните функции, внедрени върху XFS, се отличават два режима на управление на разпределени блокировки (синхронизация по мрежата и съхранение на състоянието на отделен общ диск), осигуряване на несъответствие на кеша на различни възли, водене на дневник за възстановяване и адаптиране на дисковия формат и инструменти за специфичност на кластерната файловата система. Поддържа се работа с общо хранилище, свързано чрез iSCSI (тестирано на 16 възли), или при репликация на блочно устройство с помощта на DRBD. Координацията на блокировките, функциите за откриване на възли, проверка на достъпността и определянето на неизправни възли са реализирани в един общ модул на ядрото. Работата е проверена в Proxmox VE 9, RHEL 9, Ubuntu 24.04/26.04 и Debian 12/13.
Източник: opennet.ru
