

В един от чатове ми зададоха въпрос:
— Има ли нещо, което да прочета за правилното опаковане на сървъри в стойки?
Разбрах, че такъв текст не знам, затова написах своя.
Първо, този текст е за физически сървъри в физически дата центрове (ДЦ). На второ място, приемаме, че има много сървъри: стотици-тысячи, за по-малко количество този текст няма смисъл. На трето място, приемаме, че имаме три ограничения: физическо място в стойките, електрическо захранване на стойка и нека стойките да са подредени в редици, така че да можем да използваме един ToR суич за свързване на сървъри в съседни стойки.
Отговорът на въпроса зависи значително от това, кой параметър оптимизираме и какво можем да вариираме, за да постигнем най-добър резултат. Например, може да искаме да заемем минимум пространство, за да оставим повече за бъдещ растеж. Или може би имаме свобода в избирането на височината на стойките, мощността на стойка, броя на контакти в PDU, броя на стойките в групата на суичовете (един суич на 1, 2 или 3 стойки), дължината на кабелите и работата по разположението им (това е критично в края на редиците: при 10 стойки в редица и 3 стойки на суич ще трябва да се търкулнат кабелите в друга редица или да не се използват портовете в суича), etc., etc. Отделни истории: избора на сървъри и избора на ДЦ, приемаме, че те вече са избрани.
Би било добре да разбираме някои нюанси и подробности, по-специално средното/максималното потребление на сървърите и как ни се подава електричеството. Така, ако имаме руско захранване от 230V и една фаза на стойка, то 32A автомат може да поддържа ~7kW. Да предположим, че номинално плащаме за 6kW на стойка. Ако доставчикът измерва нашето потребление само по ред от 10 стойки, а не по всяка стойка, и ако автоматът е настроен на условната стойка от 7kW, технически можем в една стойка да похарчим 6.9kW, в друга 5.1kW и всичко ще бъде ок — без наказания.
Обикновено нашата основна цел е минимизация на разходите. Най-добрият критерий за измерване е намаляване на TCO (обща цена на собственост — total cost of ownership). Тя се състои от следните части:
- CAPEX: закупуване на инфраструктура на ДЦ, сървъри, мрежови устройства и кабели
- OPEX: наем на ДЦ, консумирана електрическа енергия, обслужване. OPEX зависи от срока на експлоатация. Разумно е да предположим, че е равен на 3 години.
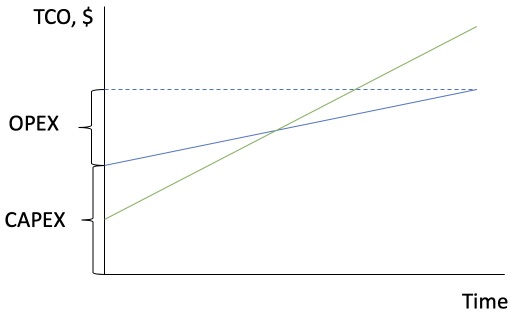
В зависимост от това колко големи са отделните парчета в общия пай, трябва да оптимизираме най-скъпото, а останалото да използва всички останали ресурси възможно най-ефективно.
Да предположим, че имаме вече съществуващ ДЦ, има височина на рафта H единици (за пример H=47), електричество на рафт Prack (Prack=6кВт), и решаваме да използваме h=2U двуетажни сървъри. Ще извадим 2..4 единици от рафта за комутатори, панели и организатори. Тоест физически, в нашия рафт се побират Sh=rounddown((H-2..4)/h) сървъри (т.е. Sh = rounddown((47-4)/2)=21 сървър на рафт). Нека запомним това Sh.
В простия случай всички сървъри в рафта са еднакви. Така, ако запълним рафта сървъри, средно ще можем да изразходваме мощност Pserv=Prack/Sh (Pserv = 6000Вт/21 = 287Вт) на всеки сървър. За простота игнорираме консумацията на комутатора.
Нека направим крачка настрана и да определим какво е максималното потребление на сървъра Pmax. Ако много опростим, много неефективно и съвсем безопасно, можем да прочетем какво е написано на блока на сървъра – това е то.
Ако е по-сложно и по-ефективно, взимаме TDP (термален дизайн пакет) на всички компоненти и ги сумираме (това не е много вярно, но може и така).
Обикновено не знаем TDP на компонентите (освен на CPU), затова взимаме най-правилния, но и най-сложния подход (нужна е лаборатория) – взимаме експериментален сървър с необходимата конфигурация и го натоварваме, например, с Linpack (CPU и памет) и fio (дискове), измерваме потреблението. Ако подходим сериозно, трябва да създадем и най-топлата среда в студения коридор по време на тестовете, защото това влияе и на потреблението на вентилаторите, и на потреблението на CPU. Получаваме максималното потребление на конкретен сървър с конкретна конфигурация в тези конкретни условия под тази конкретна натовареност. Просто имаме предвид, че новият фърмуер на системата, друга версия на софтуера, други условия могат да повлияят на резултата.
В крайна сметка, връщаме се към Pserv и как да го сравним с Pmax. Това е въпрос на разбиране на работата на услугите и на това колко стабилни нерви има вашият технически директор.
Ако не искаме да рискуваме, можем да приемем, че всички сървъри могат едновременно да започнат да консумират своя максимум. В този момент може да настъпи един вход в ДЦ. Инфраструктурата и в тези условия трябва да предоставя услуга, затова Pserv ≡ Pmax. Това е подход, при който надеждността е абсолютно важна.
Ако техническият директор мисли не само за идеалната сигурност, но и за финансовото състояние на компанията и е достатъчно смел, то може да се реши, че
- започваме да управляваме нашите доставчици, а именно, забраняваме провеждането на планирано обслужване по време на планираните пикова натовареност, за да минимизираме риска от спад на един вход;
- и/или нашата архитектура позволява изгубването на рафт/ред/ЦОД, а услугите продължават да работят;
- и/или добре разпределяме натоварването хоризонтално по рафтовете, затова нашите услуги никога не достигат максималното потребление в един рафт всичките заедно.
Тук е много полезно не просто да се предполагат неща, а да се наблюдава потреблението и да се знае как реално при нормални и пиктови условия серверите потребяват електричество. Следователно, след известно анализиране, техническият директор стеснява всичко, което има, и казва: „като волево решение приемаме, че максимално достижимото средно от максимумите на потреблението на серверите на рафт е **толкова** по-ниско от максималното потребление“, условно Pserv=0.8*Pmax.
И тогава в рафта с 6кВт се побират вече не 16 сервери с Pmax = 375Вт, а 20 сервери с Pserv = 375Вт * 0.8 = 300Вт. Тоест, с 25% повече сервери. Това е много голяма икономия — защото и рафтовете ни веднага са с 25% по-малко нужни (а там също ще спестим и за PDU, суичове и кабели). Сериозен недостатък на такова решение е, че трябва постоянно да следим, дали нашите предположения все още са верни. Дали новата версия на фърмуера не променя съществено работата на вентилаторите и потреблението, как разработката изведнъж с новото издание не е започнала да използва серверите много по-ефективно (чети - постигнали по-висока натовареност и по-високо потребление на сервер). Защото тогава и нашите първоначални предположения, и изводите стават веднага неверни. Това е риск, който трябва да се приема отговорно (или да се избягва и тогава да се плаща за очевидно недостатъчно натоварение на рафтовете).
Важно е да се опитваме да разпределяме сървърите от различни услуги в стелажите хоризонтално, ако е възможно. Необходимо е, за да не се случват ситуации, в които една партида сървъри за една услуга пристига, стелажите се запълват вертикално с нея, за да се увеличи „плътността“ (защото така е по-лесно). В действителност обаче се оказва, че един стелаж е запълнен с еднакво натоварени сървъри на една услуга, а друг - с еднакво силно натоварени. Вероятността за падане на втория е значително по-висока, тъй като профилът на натоварване е един и същ, и всичките сървъри в този стелаж започват да консумират еднакво много в резултат на увеличаването на натоварването.
Нека се върнем към разпределението на сървърите в стелажите. Обсъдихме физическите ограничения по място в стелажа и ограниченията по електрическото захранване, сега да погледнем и мрежата. Можем да използваме суичове с 24/32/48 портa N (например имаме 48-портови ToR суичове). Вариантите, за щастие, не са много, ако не се замисляме за break-out кабели. Разглеждаме сценарии, когато имаме един суич на стелаж, един суич на две или три стелажа в група Rnet. Смятам, че повече от три стелажа в група е вече прекалено, тъй като проблемът с кабелите между стелажите става значително по-голям.
И така, за всеки мрежов сценарий (1, 2 или 3 стелажа в група) разпределяме сървърите по стелажите:
Srack = min(Sh, rounddown(Prack/Pserv), rounddown(N/Rnet))
Така че, за варианта с 2 стелажа в групата:
Srack2 = min(21, rounddown(6000/300), rounddown(48/2)) = min(21, 20, 24) = 20 сървъра на стелаж.
Съответно изчисляваме и останалите варианти:
Srack1 = 20
Srack3 = 16
И вече сме почти на финал. Изчисляваме броя на стелажите за разпределение на всички наши сървъри S (нека бъде 1000):
R = roundup(S / (Srack * Rnet)) * Rnet
R1 = roundup(1000 / (20 * 1)) * 1 = 50 * 1 = 50 стелажа
R2 = roundup(1000 / (20 * 2)) * 2 = 25 * 2 = 50 стелажа
R3 = roundup(1000 / (16 * 3)) * 3 = 25 * 2 = 63 стелажа
След това изчисляваме TCO за всеки вариант на базата на броя на стелажите, необходимия брой суичове, окабеляване и т.н. Избираме този вариант, където TCO е по-малко. Печалба!
Забелязваме, че необходимият брой стелажи за вариантите 1 и 2 е един и същ, но цената им ще бъде различна, тъй като броят на суичовете за втория вариант е наполовина по-малък, а дължината на необходимите кабели е по-голяма.
P.S. Ако имате възможност да играете с мощността на рафта и височината на рафта, вариативността се увеличава. Но процесът може да бъде сведнeн до описаното по-горе, просто като избиране на опции. Да, комбинациите ще бъдат повече, но все пак ще остане доста ограничен брой — захранването на рафта за изчисление може да се увеличава на стъпки от 1 kW, стандартните рафтове са в ограничен брой размери: 42U, 45U, 47U, 48U, 52U. Тук за изчислението може да помогне What-If анализът на Excel в режим на Data Table. Разглеждаме получените таблици и избираме минимум.
Източник: habr.com
