

Статията разглежда няколко начина за определяне на математичното уравнение на линията на простата (двойна) регресия.
Всички обсъждани тук методи за решаване на уравнението са основани на метода на най-малките квадрати. Да обозначим методите по следния начин:
- Аналитично решение
- Градиентен спуск
- Стохастичен градиентен спуск
За всеки от методите за решаване на уравнението на правата, в статията са представени различни функции, които основно се делят на тези, които са написани без използването на библиотека NumPy и тези, които за извършване на изчисления използват NumPy. Счита се, че умелото използване на NumPy ще намали разходите за изчисления.
Целият код, представен в статията, е написан на езика python 2.7 с използване на Jupyter Notebook. Изходният код и файлът с данните от пробата са публикувани на
Статията е по-скоро насочена към начинаещи, както и към тези, които вече започват да изучават доста обширната област в изкуствения интелект — машинното обучение.
За илюстрация на материала ще използваме много прост пример.
Условия на примера
Имаме пет стойности, които характеризират зависимостта Y от X (Таблица №1):
Таблица №1 «Условия на примера»
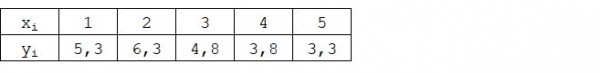
Да считаме, че стойностите  — това е месецът на годината, а
 — приходът през този месец. С други думи, приходът зависи от месеца на годината, а
 — единственият признак, от който зависи приходът.
Примерът е прост, както от гледна точка на условната зависимост на приходите от месеца на годината, така и от гледна точка на броя на стойностите — те са много малко. Въпреки това, такова опростяване ще позволи, което казано на пръсти, да обясни, не винаги с лекота, усвояваните от начинаещите материали. А също и простотата на числата ще позволи на желаещите да решат примера на «хартия» без значителни разходи на труд.
Да предположим, че представената в примера зависимост може да бъде достатъчно добре аппроксимирана с математичното уравнение на линията на простата (двойна) регресия от вида:

където  — това е месецът, в който е получен приходът,
 — приходът, съответстващ на месеца,
 и
 — коефициентите на регресията на оценената линия.
Отбелязваме, че коефициентът  често се нарича ъглов коефициент или градиент на оценената линия; представлява величината, с която ще се промени
 при изменение
 .
Очевидно, че нашата задача в примера е да подберем такива коефициенти в уравнението,  и
 , при които отклоненията на нашите изчислени стойности на приходите по месеци от истинските отговори, т.е. стойностите, представени в извадката, ще бъдат минимални.
Метод на най-малките квадрати
Съгласно метода на най-малките квадрати, отклонението трябва да се изчислява, като се возведе в квадрат. Тази техника позволява да се избегне взаимното заличаване на отклонения, когато те имат противоположни знаци. Например, ако в един случай отклонението е +5 (плюс пет), а в другия -5 (минус пет), то сумата на отклоненията взаимно ще се изключи и ще бъде 0 (нула). Можем и да не возим отклонението в квадрат, а да използваме свойството на модула и по този начин всички отклонения ще бъдат положителни и ще се натрупват. Няма да спираме на този момент подробно, а просто ще отбележим, че за удобство на изчисленията е прието да се вози отклонението в квадрат.
Ето как изглежда формулата, с помощта на която ще определим най-малката сума на квадратите на отклоненията (грешките):

където  — това е функция на апроксимация на истинските отговори (т.е. изчислените от нас приходи),
 — това са истинските отговори (предоставените в извадката приходи),
 — това е индекс на извадката (номер на месеца, в който се определя отклонението)
Нека да диференцираме функцията, да определим уравненията на частичните производни и сме готови да преминем към аналитично решение. Но първо ще направим кратка екскурзия в темата какво е диференциране и ще си припомним геометричния смисъл на производната.
Диференциране
Диференцирането е операция по намиране на производната на функция.
За какво е необходима производната? Производната на функцията характеризира скоростта на изменение на функцията и ни показва нейната посока. Ако производната в зададена точка е положителна, функцията нараства, в противен случай — функцията намалява. И колкото по-голямо е стойността на производната по модул, толкова по-висока е скоростта на изменение на стойностите на функцията, а също така и по-стръмен е ъгълът на наклона на графика на функцията.
Например, в условията на декартовата система координати, стойността на производната в точка M(0,0) равна +25 означава, че в зададена точка, при изместване на стойността  на дясно с условна единица, стойността
 нараства с 25 условни единици. На графиката това изглежда като доста стръмен ъгъл на покачване на стойностите
 от зададената точка.
Друг пример. Стойността на производната е равна на -0,1 означава, че при преместяване  с една условна единица, стойността
 намалява само с 0,1 условна единица. В същото време, на графиката на функцията можем да забележим едва забележителен наклон надолу. Провеждайки аналогия с планината, сякаш много бавно слизаме по полегат склон на планината, за разлика от предишния пример, където трябваше да вземем много стръмни върхове :)
Така че, след като проведем диференциране на функцията  по коефициентите
 и
 , определяме уравненията на частните производни от 1-ви ред. След определяне на уравненията, ще получим система от две уравнения, решавайки които можем да подберем такива стойности на коефициентите
 и
 , при които стойностите на съответните производни в зададените точки се променят на много малка величина, а в случая с аналитичното решение не се променят изобщо. С други думи, функцията на грешката при намерените коефициенти ще достигне минимум, тъй като стойностите на частните производни в тези точки ще са равни на нула.
И така, според правилата на диференцирането уравнението на частната производна от 1-ви ред по коефициента  приема вид:

уравнението на частната производна от 1-ви ред по  приема вид:

В крайна сметка получихме система от уравнения, която има сравнително просто аналитично решение:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Преди да разрешим уравнението, предварително ще заредим, проверим правилността на зареждането и форматираме данните.
Зареждане и форматиране на данните
Необходимо е да се отбележи, че във връзка с това, че за аналитично решение, а впоследствие за градиентно и стохастично градиентно спускане, ще прилагаме кода в две вариации: с използване на библиотеката NumPy и без нейната употреба, ще ни трябва съответно форматиране на данните (вж. кода).
Код за зареждане и обработка на данни
# импортируем все нужные нам библиотеки
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import math
import pylab as pl
import random

# графики отобразим в Jupyter
%matplotlib inline

# укажем размер графиков
from pylab import rcParams
rcParams['figure.figsize'] = 12, 6

# отключим предупреждения Anaconda
import warnings
warnings.simplefilter('ignore')

# загрузим значения
table_zero = pd.read_csv('data_example.txt', header=0, sep='t')

# посмотрим информацию о таблице и на саму таблицу
print table_zero.info()
print '********************************************'
print table_zero
print '********************************************'

# подготовим данные без использования NumPy

x_us = []
[x_us.append(float(i)) for i in table_zero['x']]
print x_us
print type(x_us)
print '********************************************'

y_us = []
[y_us.append(float(i)) for i in table_zero['y']]
print y_us
print type(y_us)
print '********************************************'

# подготовим данные с использованием NumPy

x_np = table_zero[['x']].values
print x_np
print type(x_np)
print x_np.shape
print '********************************************'

y_np = table_zero[['y']].values
print y_np
print type(y_np)
print y_np.shape
print '********************************************'
Визуализация
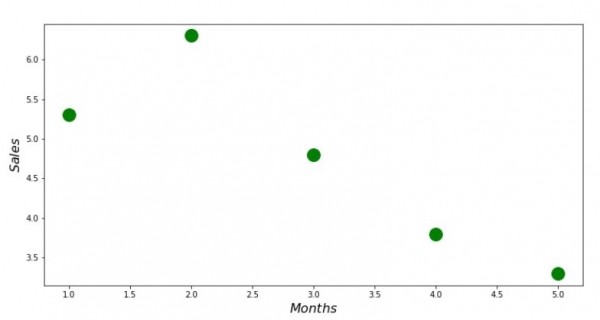
Сега, след като първо, заредихме данните, второ, проверихме правилността на зареждането и накрая форматирахме данните, ще проведем първата визуализация. Често за това се използва методът pairplot библиотека Seaborn. В нашия пример, поради ограничеността на цифрите, няма смисъл да прилагаме библиотека Seaborn. Ние ще използваме обикновена библиотека Matplotlib и ще се фокусираме само върху диаграмата на разпръскване.
Код на диаграмата на разпръскване
print 'Графика №1 "Зависимост на приходите от месец през годината"'

plt.plot(x_us,y_us,'o',color='green',markersize=16)
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.show()
Графика №1 «Зависимост на приходите от месец през годината»
Аналитично решение
Нека използваме най-простите инструменти в python и да решим системата от уравнения:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
По правилото на Крамер ще намерим общия определител, както и определителите по  и по
 , след което, разделяйки определителя по
 на общия определител — ще намерим коефициента
 , аналогично ще намерим коефициента
 .
Код на аналитичното решение
# определим функцию для расчета коэффициентов a и b по правилу Крамера
def Kramer_method (x,y):
        # сумма значений (все месяца)
    sx = sum(x)
        # сумма истинных ответов (выручка за весь период)
    sy = sum(y)
        # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x[i]*y[i]) for i in range(len(x))]
    sxy = sum(list_xy)
        # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x[i]**2) for i in range(len(x))]
    sx_sq = sum(list_x_sq)
        # количество значений
    n = len(x)
        # общий определитель
    det = sx_sq*n - sx*sx
        # определитель по a
    det_a = sx_sq*sy - sx*sxy
        # искомый параметр a
    a = (det_a / det)
        # определитель по b
    det_b = sxy*n - sy*sx
        # искомый параметр b
    b = (det_b / det)
        # контрольные значения (прооверка)
    check1 = (n*b + a*sx - sy)
    check2 = (b*sx + a*sx_sq - sxy)
    return [round(a,4), round(b,4)]

# запустим функцию и запишем правильные ответы
ab_us = Kramer_method(x_us,y_us)
a_us = ab_us[0]
b_us = ab_us[1]
print ' 33[1m' + ' 33[4m' + "Оптимальные значения коэффициентов a и b:"  + ' 33[0m'
print 'a =', a_us
print 'b =', b_us
print

# определим функцию для подсчета суммы квадратов ошибок
def errors_sq_Kramer_method(answers,x,y):
    list_errors_sq = []
    for i in range(len(x)):
        err = (answers[0] + answers[1]*x[i] - y[i])**2
        list_errors_sq.append(err)
    return sum(list_errors_sq)

# запустим функцию и запишем значение ошибки
error_sq = errors_sq_Kramer_method(ab_us,x_us,y_us)
print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений" + ' 33[0m'
print error_sq
print

# замерим время расчета
# print ' 33[1m' + ' 33[4m' + "Время выполнения расчета суммы квадратов отклонений:" + ' 33[0m'
# % timeit error_sq = errors_sq_Kramer_method(ab,x_us,y_us)
Ето какво получихме:
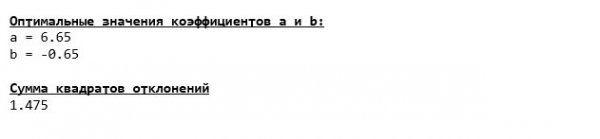
И така, стойностите на коефициентите бяха намерени, сумата на квадратите на отклоненията е установена. Нека изчертаем на хистограмата на разпръскване права линия в съответствие с намерените коефициенти.
Код на регресионната линия
# определим функцию для формирования массива рассчетных значений выручки
def sales_count(ab,x,y):
    line_answers = []
    [line_answers.append(ab[0]+ab[1]*x[i]) for i in range(len(x))]
    return line_answers

# построим графики
print 'Грфик№2 "Правильные и расчетные ответы"'
plt.plot(x_us,y_us,'o',color='green',markersize=16, label = '$True$ $answers$')
plt.plot(x_us, sales_count(ab_us,x_us,y_us), color='red',lw=4,
         label='$Function: a + bx,$ $where$ $a='+str(round(ab_us[0],2))+',$ $b='+str(round(ab_us[1],2))+'$')
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.legend(loc=1, prop={'size': 16})
plt.show()
Графика №2 «Правилни и изчислени отговори»
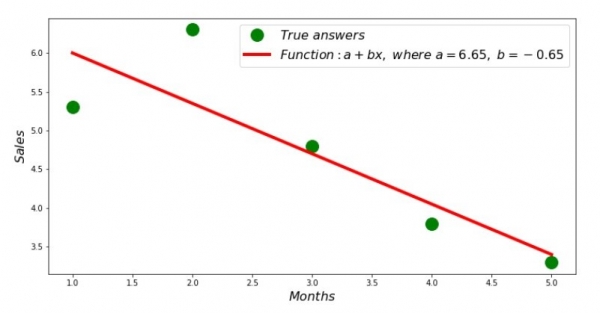
Можем да погледнем графиката на отклоненията за всеки месец. В нашия случай, няма значителна практическа стойност, която можем да извлечем от нея, но ще задоволим любопитството си относно това, колко точно уравнението на простата линейна регресия характеризира зависимостта на приходите от месец през годината.
Код на графиката на отклоненията
# определим функцию для формирования массива отклонений в процентах
def error_per_month(ab,x,y):
    sales_c = sales_count(ab,x,y)
    errors_percent = []
    for i in range(len(x)):
        errors_percent.append(100*(sales_c[i]-y[i])/y[i])
    return errors_percent

# построим график
print 'График№3 "Отклонения по-месячно, %"'
plt.gca().bar(x_us, error_per_month(ab_us,x_us,y_us), color='brown')
plt.xlabel('Months', size=16)
plt.ylabel('Calculation error, %', size=16)
plt.show()
Графика №3 «Отклонения, %»
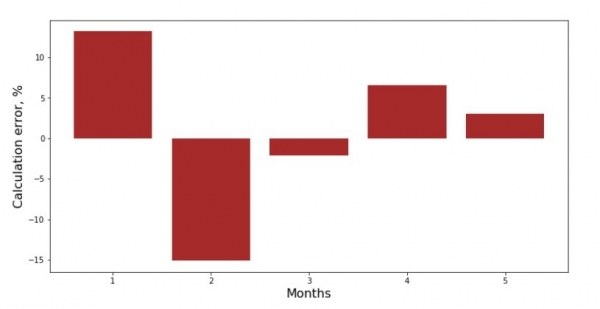
Не е перфектно, но задачата ни беше изпълнена.
Да напишем функция, която да определи коефициентите  и
 използва библиотеката NumPy, по-точно — да напишем две функции: една с използването на псевдообратната матрица (не се препоръчва на практика, тъй като процесът е изчислително сложен и нестабилен), друга с използването на матрично уравнение.
Код на аналитичното решение (NumPy)
# для начала добавим столбец с не изменяющимся значением в 1.
# Данный столбец нужен для того, чтобы не обрабатывать отдельно коэффицент a
vector_1 = np.ones((x_np.shape[0],1))
x_np = table_zero[['x']].values # на всякий случай приведем в первичный формат вектор x_np
x_np = np.hstack((vector_1,x_np))

# проверим то, что все сделали правильно
print vector_1[0:3]
print x_np[0:3]
print '***************************************'
print

# напишем функцию, которая определяет значения коэффициентов a и b с использованием псевдообратной матрицы
def pseudoinverse_matrix(X, y):
    # задаем явный формат матрицы признаков
    X = np.matrix(X)
    # определяем транспонированную матрицу
    XT = X.T
    # определяем квадратную матрицу
    XTX = XT*X
    # определяем псевдообратную матрицу
    inv = np.linalg.pinv(XTX)
    # задаем явный формат матрицы ответов
    y = np.matrix(y)
    # находим вектор весов
    return (inv*XT)*y

# запустим функцию
ab_np = pseudoinverse_matrix(x_np, y_np)
print ab_np
print '***************************************'
print

# напишем функцию, которая использует для решения матричное уравнение
def matrix_equation(X,y):
    a = np.dot(X.T, X)
    b = np.dot(X.T, y)
    return np.linalg.solve(a, b)

# запустим функцию
ab_np = matrix_equation(x_np,y_np)
print ab_np
Да сравним времето, което е било изразходвано за определяне на коефициентите  и
 , в съответствие с трите представени метода.
Код за изчисляване на времето за пресмятания
print ' 33[1m' + ' 33[4m' + "Времето за изпълнение на изчислението на коефициентите без използване на библиотеката NumPy:" + ' 33[0m'
% timeit ab_us = Kramer_method(x_us,y_us)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Времето за изпълнение на изчислението на коефициентите с използване на псевдообратната матрица:" + ' 33[0m'
%timeit ab_np = pseudoinverse_matrix(x_np, y_np)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Времето за изпълнение на изчислението на коефициентите с използване на матрично уравнение:" + ' 33[0m'
%timeit ab_np = matrix_equation(x_np, y_np)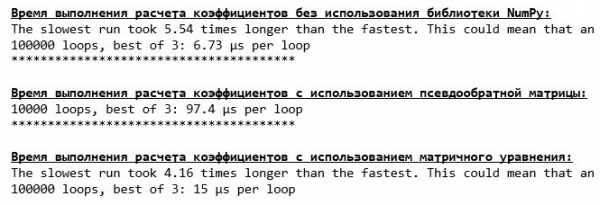
При малом количестве данни, на преден план излиза "собственоръчна" функция, която намира коефициентите чрез метода на Крамер.
Сега можем да преминем към други методи за намиране на коефициентите.  и
 .
Градиентен спуск
Първо да определим какво е градиент. На прост език, градиентът е отсечка, която указва посоката на максимално нарастване на функцията. По аналогия с изкачване в планината, накъдето сочи градиентът, там е и най-стръмното изкачване към върха на планината. Развивайки примера с планината, си спомняме, че всъщност ни трябва най-стръмният спуск, за да достигнем възможно най-бързо до низината, тоест минимума - мястото, където функцията не нараства и не намалява. На това място производната ще бъде равна на нула. Следователно, ни трябва не градиент, а антиградиент. За намиране на антиградиента е нужно просто да умножим градиента по -1 (минус едно).
Обърнете внимание, че функцията може да има няколко минимума и, като слезем в един от тях по предложената по-долу алгоритъм, няма да можем да намерим друг минимум, който евентуално е по-ниско от намерения. Няма нужда да се притесняваме за това! В нашия случай имаме работа с единствен минимум, тъй като нашата функция  на графиката представлява обикновена парабола. Както всички ние прекрасно знаем от училищния курс по математика - параболата има само един минимум.
След като установихме защо ни е необходим градиентът, а също така и че градиентът е отсечка, тоест вектор с дадени координати, които точно представляват онези коефициенти  и
 можем да реализираме градиентното спускане.
Преди да стартираме, предлагам да прочетем само няколко изречения за алгоритъма на спускането:
- Определяме псевдослучйно координатите на коефициентите
 и . В нашия пример ще определим коефициентите в близост до нула. Това е разпространена практика, но за всеки случай може да бъде предвидена специфична практика.
- От координатата изваждаме стойността на частната производна от 1-ви ред в точка . Така, ако производната е положителна, функцията нараства. Следователно, като извадим стойността на производната, ще се придвижим в обратната посока на растежа, т.е. надолу. Ако производната е отрицателна, означава, че функцията в тази точка намалява и като извадим стойността на производната, се движим надолу.
- Извършваме аналогична операция с координатата : изваждаме стойността на частичната производна в точката .
- За да не прескочим минимума и да не излетим в далечния космос, е необходимо да установим размера на стъпката в посока надолу. По принцип, може да се напише цяла статия за това как е по-добре да се установи стъпката и как да се променя в процеса на спускане, за да се намалят разходите за пресмятане. Но сега пред нас е малко различна задача, и чрез научния метод на "проба и грешка" или, както казват хората, емпиричен метод, ще установим размера на стъпката.
- След като извадихме стойностите на производните от зададените координати и получаваме нови координати и . Правим следващата стъпка (изваждане) вече от пресметнатите координати. И така цикълът стартира отново и отново, докато не бъде постигната необходимата сходност.
 и
 . В нашия пример ще определим коефициентите в близост до нула. Това е разпространена практика, но за всеки случай може да бъде предвидена специфична практика.
 изваждаме стойността на частната производна от 1-ви ред в точка
 . Така, ако производната е положителна, функцията нараства. Следователно, като извадим стойността на производната, ще се придвижим в обратната посока на растежа, т.е. надолу. Ако производната е отрицателна, означава, че функцията в тази точка намалява и като извадим стойността на производната, се движим надолу.
 : изваждаме стойността на частичната производна в точката
 .
 и
 получаваме нови координати
 и
 . Правим следващата стъпка (изваждане) вече от пресметнатите координати. И така цикълът стартира отново и отново, докато не бъде постигната необходимата сходност.
Всичко! Сега сме готови да тръгнем на търсене на най-дълбоката долина на Марианската падина. Започваме.
Код за градиентно спускане
# напишем функцию градиентного спуска без использования библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = sum(x_us)
    # сумма истинных ответов (выручка за весь период)
    sy = sum(y_us)
    # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x_us[i]*y_us[i]) for i in range(len(x_us))]
    sxy = sum(list_xy)
    # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x_us[i]**2) for i in range(len(x_us))]
    sx_sq = sum(list_x_sq)
    # количество значений
    num = len(x_us)
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = [a,b]
        errors.append(errors_sq_Kramer_method(ab,x_us,y_us))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)


print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print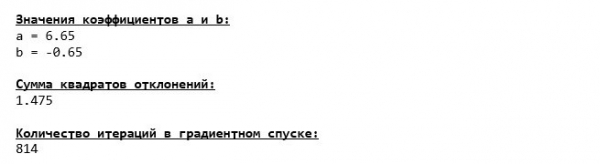
Ние се потопихме на самото дъно на Марианската падина и там открихме същите стойности на коефициентите  и
 , което всъщност и очаквахме.
Ще направим още едно потапяне, само че този път, оборудването на нашето дълбоководно устройство ще бъде с различни технологии, а именно библиотеката NumPy.
Код за градиентно спускане (NumPy)
# перед тем определить функцию для градиентного спуска с использованием библиотеки NumPy,
# напишем функцию определения суммы квадратов отклонений также с использованием NumPy
def error_square_numpy(ab,x_np,y_np):
    y_pred = np.dot(x_np,ab)
    error = y_pred - y_np
    return sum((error)**2)

# напишем функцию градиентного спуска с использованием библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = float(sum(x_np[:,1]))
    # сумма истинных ответов (выручка за весь период)
    sy = float(sum(y_np))
    # сумма произведения значений на истинные ответы
    sxy = x_np*y_np
    sxy = float(sum(sxy[:,1]))
    # сумма квадратов значений
    sx_sq = float(sum(x_np[:,1]**2))
    # количество значений
    num = float(x_np.shape[0])
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = np.array([[a],[b]])
        errors.append(error_square_numpy(ab,x_np,y_np))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print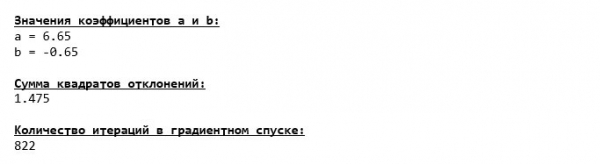
Стойностите на коефициентите  и
 са неизменни.
Нека видим как се е променяла грешката при градиентното спускане, т.е. как е била променяна сумата на квадратите на отклоненията с всяка стъпка.
Код за графиката на сумата на квадратите на отклоненията
print 'График №4 "Сума на квадратите на отклоненията по стъпки"'
plt.plot(range(len(list_parametres_gradient_descence[1])), list_parametres_gradient_descence[1], color='red', lw=3)
plt.xlabel('Стъпки (Итерация)', size=16)
plt.ylabel('Сума на квадратите на отклоненията', size=16)
plt.show()
График №4 «Сума на квадратите на отклоненията при градиентно спускане»
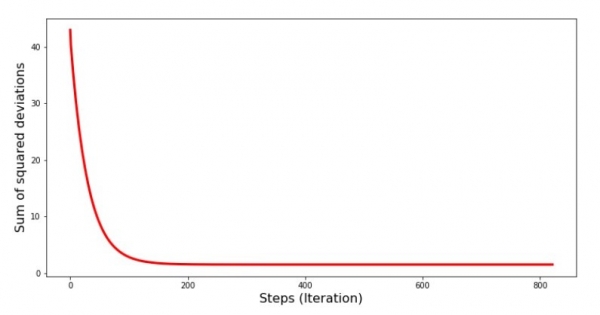
На графиката виждаме, че с всяка стъпка грешката намалява, а след известно количество итерации наблюдаваме почти хоризонтална линия.
Накрая, нека оценим разликата във времето за изпълнение на кода:
Код за определяне на времето за изчисление на градиентното спускане
print ' 33[1m' + ' 33[4m' + "Времето за изпълнение на градиентното спускане без използване на библиотеката NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' + "Времето за изпълнение на градиентното спускане с използване на библиотеката NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)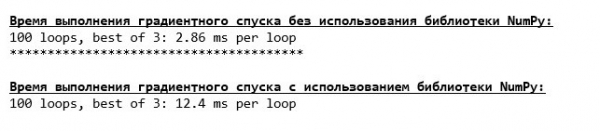
Възможно е да правим нещо не наред, но отново обикновената "ръчна" функция, която не използва библиотека NumPy предполагаемо е по-бърза от функцията, използваща библиотека NumPy.
Но не стоим на едно място, а напредваме към изучаването на още един интересен метод за решаване на уравнението на простата линейна регресия. Запознайте се!
Стохастичен градиентен спуск
За да разберем по-бързо принципа на работа на стохастичното градиентно спускане, е по-добре да определим различията му от обикновеното градиентно спускане. Ние, в случая с градиентното спускане, в уравненията на производните от  и
 използвахме сумите на стойностите на всички признаци и истинските отговори, налични в извадката (т.е. сумата на всички
 и
 ). При стохастичното градиентно спускане няма да използваме всички стойности, налични в извадката, а вместо това, псевдослучайно ще изберем така наречения индекс на извадката и ще използваме неговите стойности.
Например, ако индексът е определен като номер 3 (три), взимаме стойностите  и
 , след което подставяме стойностите в уравненията на производните и определяме новите координати. След това, определяйки координатите, отново псевдослучайно определяме индекса на извадката, подставяме стойностите, съответстващи на индекса в уравненията на частичните производни и по ново определяме координатите
 и
 и т.н. до достигане на сходимост. На пръв поглед може да изглежда, че как това изобщо може да работи, но то работи. Вярно е, че не при всяка стъпка грешката намалява, но тенденцията безспорно е налице.
Какви са предимствата на стохастичния градиентен спуск пред обикновения? Когато размерът на извадката е много голям и се измерва на десетки хиляди стойности, значително по-лесно е да се обработи, да речем, случайна хиляда от тях, вместо цялата извадка. В този случай стартира стохастичният градиентен спуск. В нашия случай, разбира се, няма да усетим голяма разлика.
Разглеждаме кода.
Код за стохастичния градиентен спуск
# определим функцию стох.град.шага
def stoch_grad_step_usual(vector_init, x_us, ind, y_us, l):
#     выбираем значение икс, которое соответствует случайному значению параметра ind
# (см.ф-цию stoch_grad_descent_usual)
    x = x_us[ind]
#     рассчитывыаем значение y (выручку), которая соответствует выбранному значению x
    y_pred = vector_init[0] + vector_init[1]*x_us[ind]
#     вычисляем ошибку расчетной выручки относительно представленной в выборке
    error = y_pred - y_us[ind]
#     определяем первую координату градиента ab
    grad_a = error
#     определяем вторую координату ab
    grad_b = x_us[ind]*error
#     вычисляем новый вектор коэффициентов
    vector_new = [vector_init[0]-l*grad_a, vector_init[1]-l*grad_b]
    return vector_new


# определим функцию стох.град.спуска
def stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800):
#     для самого начала работы функции зададим начальные значения коэффициентов
    vector_init = [float(random.uniform(-0.5, 0.5)), float(random.uniform(-0.5, 0.5))]
    errors = []
#     запустим цикл спуска
# цикл расчитан на определенное количество шагов (steps)
    for i in range(steps):
        ind = random.choice(range(len(x_us)))
        new_vector = stoch_grad_step_usual(vector_init, x_us, ind, y_us, l)
        vector_init = new_vector
        errors.append(errors_sq_Kramer_method(vector_init,x_us,y_us))
    return (vector_init),(errors)


# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])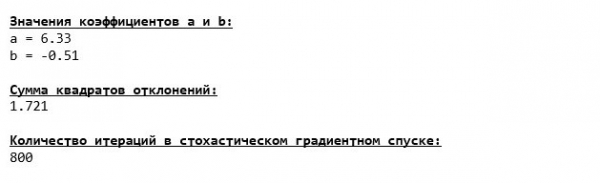
Внимателно гледаме на коефициентите и се хващаме на въпроса „Как така?“. Получихме други стойности на коефициентите.  и
 . Може би стохастичният градиентен спуск е открил по-оптимални параметри на уравнението? Уви, не. Достатъчно е да погледнем сумата на квадратите на отклоненията и да видим, че при новите стойности на коефициентите, грешката е по-голяма. Не бързаме да изпадаме в отчаяние. Нека построим график на изменението на грешката.
Код за график на сумата на квадратите на отклоненията при стохастичен градиентен спуск
print 'Графика №5 "Сума на квадратите на отклоненията по стъпки"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Стъпки (Итерация)', size=16)
plt.ylabel('Сума на квадратите на отклоненията', size=16)
plt.show()
Графика №5 «Сума на квадратите на отклоненията при стохастичния градиентен спуск»
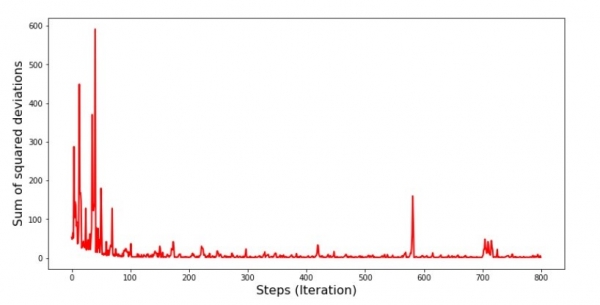
След като погледнем графика, всичко става ясно и сега всичко ще поправим.
И така, какво се случи? Случи се следното. Когато случайно изберем месец, нашият алгоритъм се стреми да намали грешката в изчислението на приходите за избрания месец. След това избираме друг месец и повтаряме изчисляването, но намаляваме грешката вече за втория избран месец. Нека си спомним, че първите два месеца значително се отклоняват от линията на уравнението на простата линейна регресия. Това означава, че когато се избере който и да е от тези два месеца, намалявайки грешката на всеки от тях, нашият алгоритъм сериозно увеличава грешката за цялата извадка. Какво да правим? Отговорът е прост: нужно е да намалим стъпката на спуск. Защото, намалявайки стъпката на спуск, грешката също ще престане да „скача“ нагоре и надолу. По-скоро, грешката „да скача“ няма да спре, но вече няма да го прави толкова бързо :) Нека проверим.
Код за стартиране на SGD с по-малка стъпка
# запустим функцию, уменьшив шаг в 100 раз и увеличив количество шагов соответсвующе
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])

print 'График №6 "Сумма квадратов отклонений по-шагово"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Steps (Iteration)', size=16)
plt.ylabel('Sum of squared deviations', size=16)
plt.show()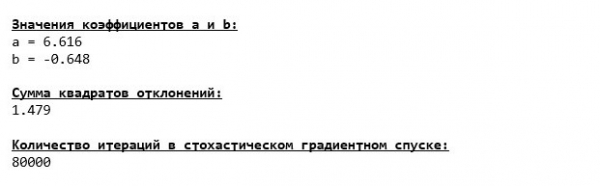
Графика №6 «Сума на квадратите на отклоненията при стохастичния градиентен спуск (80 хил. стъпки)»
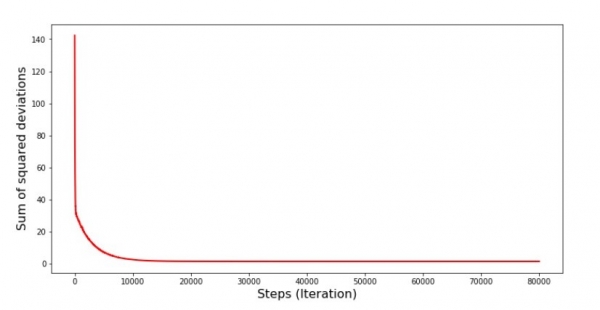
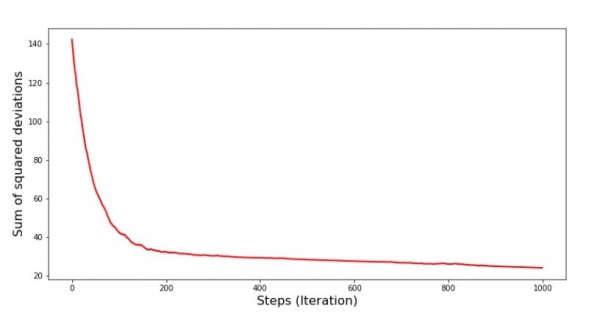
Стойностите на коефициентите се подобриха, но все още не са идеални. Хипотетично, това може да се поправи по следния начин. Избираме, например, при последните 1000 итерации стойностите на коефициентите, при които е допусната минимална грешка. Вярно е, че за това ще трябва да запишем и самите стойности на коефициентите. Ние няма да го правим, а по-добре ще обърнем внимание на графика. Той изглежда гладък и грешката сякаш намалява равномерно. Всъщност, това не е така. Нека да погледнем първите 1000 итерации и да ги сравним с последните.
Код за графика SGD (първите 1000 стъпки)
print 'Графика №7 "Сума на квадратите на отклоненията по стъпки. Първите 1000 итерации"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][:1000])),
         list_parametres_stoch_gradient_descence[1][:1000], color='red', lw=2)
plt.xlabel('Стъпки (Итерация)', size=16)
plt.ylabel('Сума на квадратите на отклоненията', size=16)
plt.show()

print 'Графика №7 "Сума на квадратите на отклоненията по стъпки. Последните 1000 итерации"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][-1000:])),
         list_parametres_stoch_gradient_descence[1][-1000:], color='red', lw=2)
plt.xlabel('Стъпки (Итерация)', size=16)
plt.ylabel('Сума на квадратите на отклоненията', size=16)
plt.show()
Графика №7 «Сума на квадратите на отклоненията SGD (първите 1000 стъпки)»
Графика №8 «Сума на квадратите на отклоненията SGD (последните 1000 стъпки)»
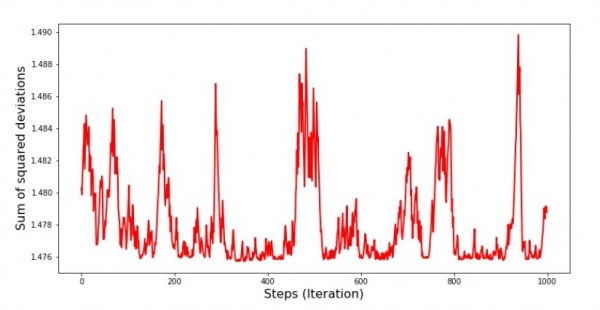
В самото начало на спуска наблюдаваме сравнително равномерно и остро намаляване на грешката. При последните итерации виждаме, че грешката варира около стойността от 1,475 и в някои моменти дори достига до тази оптимална стойност, но после пак се увеличава... Ще повторя, можем да записваме стойностите на коефициентите  и
 , а после да изберем тези, при които грешката е минимална. Въпреки това, имаме по-сериозен проблем: трябваше да направим 80 хиляди стъпки (вж. кода), за да получим стойности, близки до оптималните. А това вече противоречи на идеята за икономия на време за изчисления при стохастичния градиентен спуск спрямо градиентния. Какво може да се поправи и подобри? Не е трудно да се забележи, че при първите итерации уверено вървим надолу и следователно, трябва да оставим голяма стъпка при първите итерации и с напредването напред да намалим стъпката. Няма да го правим в тази статия — и така тя вече е дълга. Желаещите могат сами да помислят как да го направят, не е сложно 🙂
Сега ще изпълним стохастичен градиентен спуск, използвайки библиотеката NumPy (и нека не се спъваме в камъните, които открихме по-рано)
Код за стохастичен градиентен спуск (NumPy)
# для начала напишем функцию градиентного шага
def stoch_grad_step_numpy(vector_init, X, ind, y, l):
    x = X[ind]
    y_pred = np.dot(x,vector_init)
    err = y_pred - y[ind]
    grad_a = err
    grad_b = x[1]*err
    return vector_init - l*np.array([grad_a, grad_b])

# определим функцию стохастического градиентного спуска
def stoch_grad_descent_numpy(X, y, l=0.1, steps = 800):
    vector_init = np.array([[np.random.randint(X.shape[0])], [np.random.randint(X.shape[0])]])
    errors = []
    for i in range(steps):
        ind = np.random.randint(X.shape[0])
        new_vector = stoch_grad_step_numpy(vector_init, X, ind, y, l)
        vector_init = new_vector
        errors.append(error_square_numpy(vector_init,X,y))
    return (vector_init), (errors)

# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])
print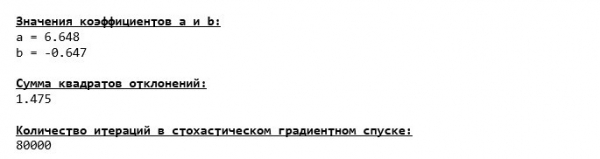
Получените стойности почти съвпадат с тези от спускането без използване на NumPy. Въпреки това, това е логично.
Нека разберем колко време ни отнеха стохастичните градиентни спуски.
Код за определяне на времето за изчисление на SGD (80 хиляди стъпки)
print ' 33[1m' + ' 33[4m' +
"Време за изпълнение на стохастичния градиентен спуск без използване на библиотеката NumPy:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' +
"Време за изпълнение на стохастичния градиентен спуск с използване на библиотеката NumPy:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)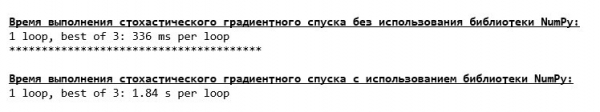
Колкото по-напред в гората, толкова по-тъмни облаци: отново „самописната“ формула показва най-добри резултати. Всичко това води до мисли, че трябва да съществуват още по-фини начини за използване на библиотеката NumPy, които наистина ускоряват операциите по изчисление. В тази статия няма да научим за тях. Но ще имаме какво да помислим в свободното си време:)
Резюме
Преди да резюмирам, бих искал да отговоря на въпроса, който вероятно е възникнал у нашия скъп читател. За какво всъщност са тези „мъчения“ със спусканията, защо да се катерим нагоре и надолу (преимуществено надолу), за да намерим желаното дъно, ако в ръцете ни имаме такова мощно и просто средство, като аналитично решение, което мигновено ни телепортира на правилното място?
Отговорът на този въпрос е на повърхността. В момента разглеждаме много прост пример, в който истинският отговор  зависи от един признак
 . В живота такова не се среща често, затова нека предположим, че имаме 2, 30, 50 или повече признака. Да добавим хиляди, а може би и десетки хиляди стойности за всеки признак. В този случай аналитичното решение може да не издържи теста и да се провали. От своя страна градиентният спуск и неговите вариации ще ни приближават бавно, но сигурно до целта — минимума на функцията. А относно скоростта не се притеснявайте — със сигурност ще разгледаме отново начини, които ще ни позволят да зададем и регулираме дължината на стъпката (т.е. скоростта).
А сега краткото резюме.
Първо, се надявам, че материалът, изложен в статията, ще помогне на начинаещите "дата сайентисти" в разбирането на това как да решават уравнения на проста (а и не само) линейна регресия.
На второ място, разгледахме няколко метода за решаване на уравнението. Сега, в зависимост от ситуацията, можем да изберем този, който най-добре подхожда за решаване на поставената задача.
На трето място, видяхме силата на допълнителните настройки, а именно дължината на стъпката на градиентния спуск. Този параметър не бива да се пренебрегва. Както беше споменато по-горе, с цел намаляване на разходите за извършване на изчисления, дължината на стъпката трябва да се променя по време на спуска.
На четвърто място, в нашия случай "самописните" функции показаха най-добри времеви резултати при изчисленията. Вероятно това е свързано с не най-професионалното приложение на възможностите на библиотеката. NumPy. Както и да е, изводът е следният. От една страна, понякога си струва да се поставят под съмнение утвърдени мнения, а от друга страна — не винаги е нужно да се усложняват нещата — понякога по-простият начин на решаване на задачата се оказва по-ефективен. А така като целта ни беше да разгледаме три подхода за решаване на уравнението на проста линейна регресия, използването на "самописни" функции ни беше напълно достатъчно.
Литература (или нещо подобно)
1. Линейна регресия
2. Метод на най-малките квадрати
3. Производна
4. Градиент
5. Градиентен спуск
6. Библиотека NumPy
Източник: habr.com
