

Справихме се!
«Целта на този курс е да ви подготви за вашето техническо бъдеще.»
 Здравейте, Хабр. Помните ли страхотната статия (+219, 2588 в запазени статии, 429k прочита)?
Така че, при Хеминг (да, да, самоконтролиращи и самокоригиращи се ) има цяла , написана вдъхновена от неговите лекции. Превеждаме я, защото човекът знае какво говори.
Тази книга не е просто за ИТ, тя е книга за начина на мислене на невероятно страхотни хора. «Това не е просто заряд на положително мислене; тя описва условията, които увеличават шансовете за създаване на велико дело.»
Благодарим на Андрей Пахомов за превода.
Теорията на информацията беше разработена от К. Е. Шенън в края на 40-те години на миналия век. Водещите в Bell Labs настояваха да я нарече «Теория на свързването», тъй като това е много по-точно наименование. Поради очевидни причини, наименованието «Теория на информацията» има значително по-голямо влияние върху обществеността, затова Шенън избра именно него, и именно то ни е известно до днес. Самото наименование предполага, че теорията се занимава с информация, и това я прави важна, тъй като все повече навлизаме в информационната епоха. В тази глава ще разгледам някои основни изводи от тази теория, ще представя не строги, а по-скоро интуитивно разбираеми доказателства на някои отделни положения от тази теория, така че да разберете какво всъщност представлява «Теория на информацията», къде можете да я приложите и къде не.
Първо, какво е “информация”? Шенън отождествява информацията с неопределеност. Той избира отрицателния логаритъм от вероятността за събитие като количествена мярка на информацията, която получавате, когато настъпи събитие с вероятност p. Например, ако ви кажа, че в Лос Анджелис времето е мъгливо, тогава p е близо до 1, което по същество не ни дава много информация. Но ако кажа, че през юни в Монтерей вали дъжд, тогава в това съобщение ще има неопределеност и то ще съдържа повече информация. Верен факт не съдържа никаква информация, тъй като log 1 = 0.
Нека разгледаме това по-подробно. Шенън смяташе, че количествената мярка за информация трябва да бъде непрекъсната функция от вероятността на събитието p, и за независими събития тя трябва да бъде адитивна — количеството информация, получено в резултат на провеждането на две независими събития, трябва да бъде равно на количеството информация, получено при провеждането на съвместно събитие. Например, резултатът от хвърлянето на зар и монета обикновено се разглежда като независими събития. Нека преведем казаното на математическия език. Ако I(p) е количеството информация, което съдържа събитие с вероятност p, то за съвместното събитие, състоящо се от две независими събития x с вероятност p1 и y с вероятност p2 получаваме
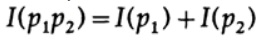
(x и y независими събития)
Това е функционалното уравнение на Коши, вярно за всички p1 и p2. За да решим това функционално уравнение, предполагаме, че
p1 = p2 = p,
това дава
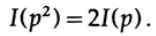
Ако p1 = p2 и p2 = p, то
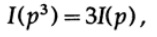
и т.н. Разширявайки този процес, използвайки стандартния метод за експоненти, за всички рационални числа m/n, е валидно следното
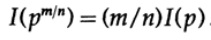
От предполагаемата непрекъснатост на информационната мярка следва, че логаритмичната функция е единственото непрекъснато решение на функционалното уравнение на Коши.
В теорията на информацията е прието основанието на логаритма да е равно на 2, така че бинарният избор съдържа точно 1 бит информация. Следователно, информацията се измерва по формулата
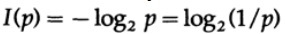
Нека спрем и да разгледаме какво всъщност се случи по-горе. Първо, ние все още не дадохме определение на понятието "информация", просто определихме формулата за количествената й мярка.
На второ място, тази мярка зависи от несигурността и, макар че е достатъчно подходяща за машините — например, телефонни системи, радио, телевизия, компютри и т.н. — тя не отразява нормалното човешко отношение към информацията.
На трето място, това е относителна мярка, тя зависи от текущото състояние на вашето знание. Ако гледате потока от "случайни числа" от генератор на случайни числа, вие предполагате, че всяко следващо число е несигурно, но, ако знаете формулата за изчисляване на "случайни числа", следващото число ще бъде известно и, съответно, няма да съдържа информация.
Така че определението, дадено от Шенон за информация, в много случаи е подходящо за машини, но изглежда не отразява човешкото разбиране на това слово. Именно поради тази причина "Теория на информацията" трябваше да бъде наречена "Теория на комуникацията". Все пак, вече е твърде късно да се променят определенията (благодарение на които теорията получи първоначалната си популярност, и които все още карат хората да мислят, че тази теория се занимава с "информация"), затова трябва да се примирим с тях, но също така трябва да разберете колко далеч е определението за информация, дадено от Шенон, от обичайния смисъл. Информацията на Шенон се занимава с нещо съвсем различно, а именно с несигурността.
Ето какво трябва да помислите, когато предлагате всяка терминология. В каква степен предложеното определение, например, определението на Шенон за информация, съответства на вашата първоначална идея и в каква степен се различава? Почти няма термин, който точно да отразява вашето предишно виждане на концепцията, но в крайна сметка терминологията, която се използва, отразява смисъла на концепцията, затова формализирането на нещо чрез ясни определения винаги внася известен шум.
Нека разгледаме система, чийто азбук е съставен от символи q с вероятности pi. В този случай средното количество информация в системата (очакваната й стойност) е равно на:
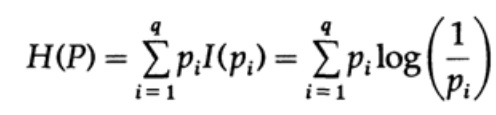
Това се нарича ентропия на системата с разпределение на вероятност {pi}. Използваме термина "ентропия", защото същата математическа форма се появява в термодинамиката и статистическата механика. Именно затова терминът "ентропия" създава около себе си определена аура на важност, която в крайна сметка не е оправдана. Еднаквата математическа форма на записа не означава еднаква интерпретация на символите!
Ентропията на разпределението на вероятностите играе основна роля в теорията на кодиране. Неравенството на Гибс за две различни разпределения на вероятностите pi и qi е едно от важните следствия на тази теория. И така, трябва да докажем, че
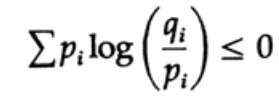
Доказателството се основава на очевидната графика, илюстрирана на рис. 13.I, която показва, че
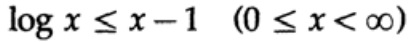
равенството се постига само при x = 1. Прилагаем неравенството на всяка сума от лявата част:
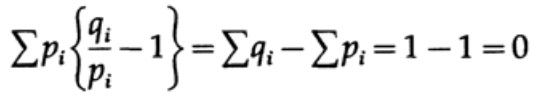
Ако алфавитът на комуникационната система се състои от q символа, то като приемем вероятността за предаване на всеки символ qi = 1/q и подставим q, получаваме от неравенството на Гибс
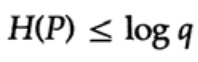
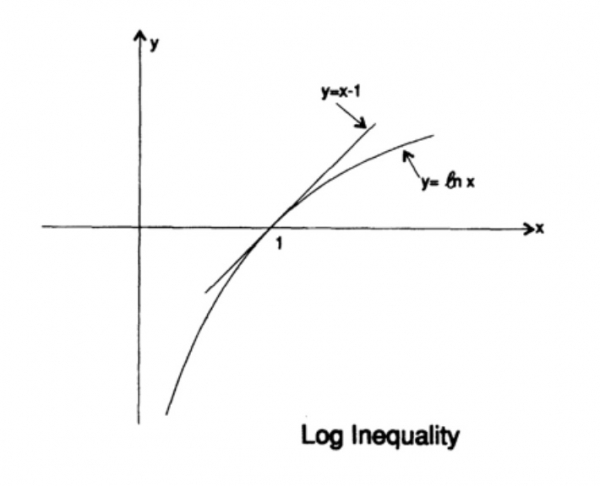
Фигура 13.I
Това означава, че ако вероятността за предаване на всички q символа е еднаква и равна на 1/q, максималната ентропия е равна на ln q; в противен случай неравенството е валидно.
В случай на еднозначно декодируем код, имаме неравенството на Крафт
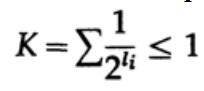
Сега ако определим псевдовероятности
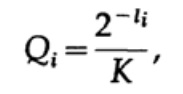
където е крайно 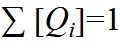 = 1, което следва от неравенството на Гибс,
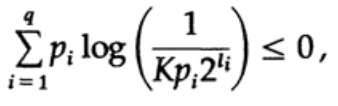
и приложим малко алгебра (имайте предвид, че K ≤ 1, така че можем да опуснем логаритмичния член и е възможно да усилим неравенството по-късно), ще получим
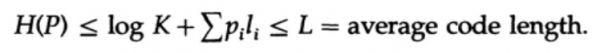
където L е средната дължина на кода.
Така ентропията е минималната граница за всякакъв символен код със средна дължина на кодовата дума L. Това е теоремата на Шенон за канал без шум.
Сега нека разгледаме основната теорема за ограниченията на комуникационните системи, в които информацията се предава под формата на поток от независими битове и присъства шум. Предполага се, че вероятността за правилно предаване на един бит P > 1/2, а вероятността, че стойността на бита ще бъде инвертирана по време на предаване (съществува грешка), е Q = 1 - P. За удобство ще приемем, че грешките са независими и вероятността за грешка е една и съща за всеки изпратен бит — тоест в комуникационния канал присъства „бял шум“.
Имаме дълъг поток от n бита, кодирани в едно съобщение — n-мерно разширение на еднобитовия код. Стойността на n ще определим по-късно. Нека разгледаме съобщението, състоящо се от n бита като точка в n-мерно пространство. Осколко имаме n-мерно пространство — и за простота да предположим, че всяко съобщение има еднаква вероятност да се появи — съществуват M възможни съобщения (M също ще бъде определено по-късно), следователно вероятността за произволно изпратено съобщение е

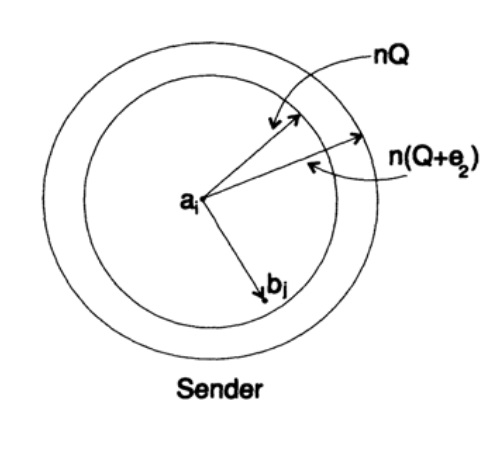
(изпращач)
Графика 13.II
Нека разгледаме концепцията за пропускната способност на канала. Без да навлизаме в детайли, пропускната способност на канала се определя като максималният обем информация, която може да бъде надеждно предадена през комуникационния канал, с оглед на използването на максимално ефективно кодиране. Няма доводи в полза на това, че може да бъде предадено повече информация през комуникационния канал, отколкото неговата капацитет. Това може да се докаже за симетричен бинарен канал (който използваме в нашия случай). Капацитетът на канала при битово изпращане е зададен като
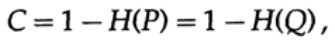
където, както преди, P е вероятността за отсъствие на грешка в който и да е изпратен бит. При изпращане на n независими бита капацитетът на канала се определя като
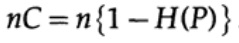
Ако сме близо до пропускната способност на канала, трябва да изпратим почти такъв обем информация за всеки от символите ai, i = 1, …, М. Като имаме предвид, че вероятността за възникване на всеки символ ai е равна на 1 / M, получаваме
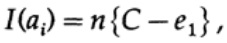
когато изпращаме което и да е от М равновероятни съобщения ai, имаме
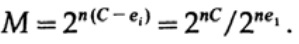
При изпращане на n бита очакваме да възникнат nQ грешки. На практика, за съобщение от n бита, ще имаме приблизително nQ грешки в полученото съобщение. При големи n, относителната вариация ( вариация = ширина на разпределението, )
разпределението на броя грешки ще става все по-тясно с растежа на n.
И така, от страна на предавателя, вземам съобщение ai за изпращане и рисувам сфера около него с радиус
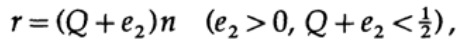
който е малко по-голям от стойността, равна на e2, от очакваното число грешки Q, (рисунка 13.II). Ако n е достатъчно голямо, то съществува произволно малка вероятност за появата на точката на съобщение bj от страна на получателя, която излиза извън пределите на тази сфера. Нека илюстрирам ситуацията, както я виждам от страна на предавателя: имаме произволни радиуси от изпратеното съобщение ai до полученото съобщение bj с вероятност за грешка, равна (или почти равна) на нормалното разпределение, достигащо максимум на nQ. За всяко зададено e2 съществува n, толкова голямо, че вероятността получената точка bj, излизаща извън моята сфера, да бъде толкова малка, колкото желаете.
Сега нека разгледаме тази същата ситуация от ваша страна (фиг. 13.III). От страната на приемника има сфера S( r) с радиус r около приетата точка bj в n-измерното пространство, така че ако приетото съобщение bj е вътре в моята сфера, тогава изпратеното от мен съобщение ai е вътре във вашата сфера.
Как може да възникне грешка? Грешка може да настъпи в случаите, описани в таблицата по-долу:
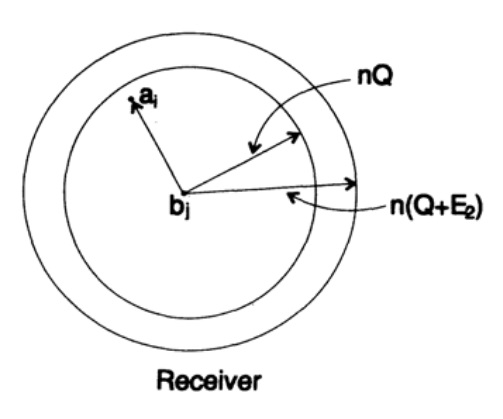
Фигура 13.III
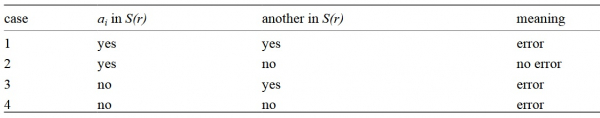
Тук виждаме, че ако в сферата, построена около приетата точка, съществува поне още една точка, съответстваща на възможно изпратено незакодирано съобщение, то при предаването е възникнала грешка, тъй като не можете да определите кое точно от тези съобщения е било предадено. Изпратеното съобщение не съдържа грешка, само ако точката, съответстваща на него, е в сферата и не съществуват други точки, възможни в дадения код, които са в същата сфера.
Имаме математическо уравнение за вероятността за грешка Ре, ако е било изпратено съобщение ai
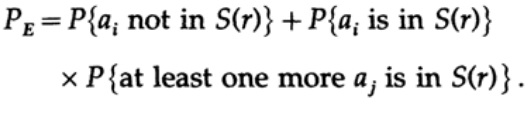
Можем да изхвърлим първия множител във втория член, приемайки го за 1. Така ще получим неравенство
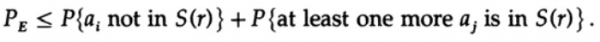
Очевидно е, че
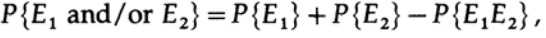
следователно
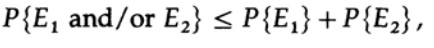
повторно прилагаме към последния член от дясната страна
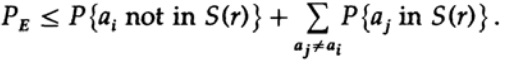
Приемайки n достатъчно голямо, първият член може да се приема за колкото се може по-малък, да речем по-малък от някакво число d. Следователно имаме
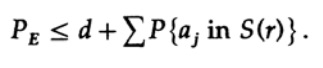
Сега нека разгледаме как може да бъде построен код за проста замяна за кодиране на M съобщения, състоящи се от n бита. Без да имаме представа как точно да изградим кода (кодове с корекция на грешки все още не са били изобретени), Шенън избра случайно кодиране. Хвърлете монета за всеки от n битовете в съобщението и повторете процеса за М съобщения. Общото количество хвърляния на монетата, което трябва да се извърши, е nM, така че възможните

кодови думи, имат еднаква вероятност ½nM. Разбира се, случайният процес на създаване на кодов речник означава, че има вероятност за появата на дубликати, както и кодови точки, които ще бъдат близо една до друга и следователно ще бъдат източник на вероятни грешки. Трябва да се докаже, че ако това не се случва с вероятност по-висока от ниво на грешка, избрано като малко, то зададеното n е достатъчно голямо.
Ключовият момент е, че Шенън е усреднил всички възможни кодови книги, за да намери средната грешка! Ще използваме символа Av [.], за да обозначим средното значение за множество от всички възможни случайни кодови речници. Усредняването по константа d, разбира се, дава константа, тъй като при усредняването всеки член съвпада с всеки друг член в сумата,
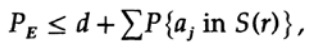
който може да бъде увеличен (M–1 преминава в M)
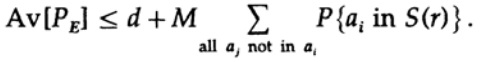
За всяко конкретно съобщение, при усредняване на всички кодови книги, кодиране минава през всички възможни стойности, така че средната вероятност за точката да бъде в сферата е отношението на обема на сферата към общия обем на пространството. Обемът на сферата е
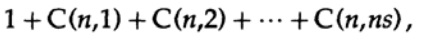
където s=Q+e2 <1/2 и ns трябва да бъде цяло число.
Последният член вдясно е най-голям в тази сума. Първо ще оценим стойността му по формулата на Стърлинг за факториали. След това ще разгледаме коефициента на намаление на члена пред него, имайте предвид, че този коефициент се увеличава при преминаване наляво, така че можем: (1) да ограничим стойността на сумата с геометричната прогресия с този начален коефициент, (2) да разширим геометричната прогресия с ns члена до безкраен брой членове, (3) да изчислим сумата на безкрайната геометрична прогресия (стандартна алгебра, нищо съществено) и накрая да получим пределната стойност (за достатъчно голямо n):
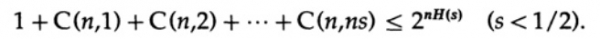
Обърнете внимание как ентропията H(s) се появява в биномиалната идентичност. Забележете, че разлагането в ред на Тейлор H(s)=H(Q+e2) дава оценка, получена като се взема предвид само първата производна и се игнорират всички останали. Сега да съберем крайното изражение:
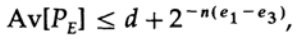
където
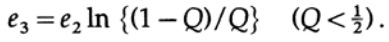
Всичко, което трябва да направим, е да изберем e2, така че e3 < e1, и тогава последният член ще бъде колкото искаме малък, при достатъчно голямо n. Следователно, средната грешка PE може да бъде получена колкото искаме малка при пропускателната способност на канала, колкото искаме близка до C.
Ако средното значение на всички кодове има достатъчно малка грешка, то поне един код трябва да бъде подходящ, следователно, съществува поне една подходяща система за кодиране. Това е важен резултат, получен от Шеннон — „теорема на Шеннон за канала с шум“, като трябва да се отбележи, че той го е доказал за много по-общ случай, отколкото за простичък двоичен симетричен канал, използван от мен. За общия случай математическите изчисления са значително по-сложни, но идеите не са толкова различни, затова много често на примера на частичния случай може да се разкрие истинското значение на теоремата.
Нека критикуваме резултата. Ние многократно повтаряхме: „При достатъчно големи n“. Но колко голямо е n? Много, много голямо, ако наистина искате да бъдете едновременно близки до капацитета на канала и да бъдете уверени в коректната предаване на данни! Толкова голямо, че всъщност ще бъдете принудени да чакате много дълго, за да натрупате съобщение от такова количество битове, за да можете впоследствие да го кодиране. В същото време размерът на речника на произволния код ще бъде просто огромен (защото такъв речник не може да бъде представен в по-кратка форма от пълен списък на всички Mn битове, при положение че n и M са много големи)!
Кодовете за корекция на грешки избягват дългото изчакване на много дълго съобщение, с последващото му кодиране и декодиране през много големи кодови книги, защото те избягват кодовите книги като такива и използват вместо тях обикновени изчисления. В простата теория такива кодове обикновено губят способността да се приближат до капацитета на канала и същевременно да запазят достатъчно ниска честота на грешки, но, когато кодът коригира голям брой грешки, те показват добри резултати. С други думи, ако заложите някаква капацитет на канала за корекция на грешки, то вие трябва да използвате възможността за корекция на грешки по-голямата част от времето, т.е. във всяко изпратено съобщение трябва да бъде коригирано голямо количество грешки, иначе губите този капацитет напразно.
Въпреки това доказаната по-горе теорема все още не е безсмислена! Тя показва, че ефективните системи за предаване трябва да използват обмислени схеми за кодиране на много дълги битови низове. Пример за това са спътниците, които са напуснали пределите на външните планети; с отдалечаването от Земята и Слънцето те са принудени да коригират все повече и повече грешки в блока с данни: някои спътници използват соларни батерии, които дават около 5 W, а други използват атомни източници на захранване, които дават приблизително същата мощност. Слабата мощност на захранването, малките размери на предавателните антени и ограничените размери на приемателните антени на Земята, огромното разстояние, което сигналът трябва да преодолее – всичко това изисква използването на кодове с високо ниво на корекция на грешки за изграждане на ефективна система за комуникация.
Нека се върнем към n-мерното пространство, което използвахме в доказателството по-горе. Обсъждайки го, показахме, че почти целият обем на сферата е съсредоточен около външната повърхност, – така че почти с абсолютна сигурност изпратеният сигнал ще бъде разположен близо до повърхността на сферата, построена около получен сигнала, дори при относително малък радиус на такава сфера. Следователно не е учудващо, че полученият сигнал след корекция на произволно голямо количество грешки, nQ, се оказва произволно близък до сигнала без грешки. Капацитетът на комуникационния канал, който разгледахме по-рано, е ключът към разбирането на това явление. Обърнете внимание, че подобни сфери, построени за кодове на Хеминг с корекция на грешки, не се припокриват. Голямото количество практически ортогонални измерения в n-мерното пространство показва защо можем да поберем M сфери в пространството с малко припокритие. Ако допуснем малко, произволно малко припокритие, което може да доведе само до малко количество грешки при декодиране, може да се постигне плътно разположение на сферите в пространството. Хеминг е гарантирал определено ниво на корекция на грешки, Шенън – ниска вероятност за грешка, но при това запазване на действителната пропускна способност, колкото е възможно близка до капацитета на комуникационния канал, нещо, което кодовете на Хеминг не могат да направят.
Теорията на информацията не казва как да проектираме ефективна система, но посочва посоката на движение към ефективни комуникационни системи. Това е ценен инструмент за изграждане на комуникационни системи между машини, но, както беше споменато по-рано, тя няма особено отношение към това как хората обменят информация помежду си. Степента, в която биологичното наследство наподобява техническите комуникационни системи, просто е неизвестна, следователно в момента не е ясно доколко теорията на информацията е приложима към гените. Нямаме нищо друго освен просто да опитаме, и ако успехът ни покаже машинно-подобния характер на това явление, то неуспехът ще посочи други съществени аспекти на природата на информацията.
Нека не се отклоняваме много. Видяхме, че всички първоначални дефиниции, в по-голяма или по-малка степен, трябва да изразяват същността на нашите първоначални убеждения, но те имат известна степен на изкривяване и поради това се оказват неприложими. Традиционно се счита, че в крайна сметка, дефиницията, която използваме, всъщност определя същността; но, това просто ни указва как да обработваме нещата и по никакъв начин не носи смисъл. Постулационният подход, толкова одобряван в математическите среди, оставя много да се желае на практика.
Сега ще разгледаме пример на IQ тестове, където дефиницията е толкова циклична, колкото искате, и следователно ви обърква. Създава се тест, който предполагаемо измерва интелигентността. След това той се преразглежда, за да стане възможно най-последователен, и след това се публикува и с прост метод се калибрира така, че измереното „интелигентност“ да бъде нормално разпределено (разбира се, по крива на калибровката). Всички дефиниции трябва да се преглеждат отново, не само когато за първи път се предлагат, но и много по-късно, когато се използват в направените изводи. В каква степен границите на дефинициите са подходящи за решената задача? Колко често дефиниции, дадени в едни условия, започват да се прилагат в доста различаващи се условия? Това се случва доста често! В хуманитарните науки, с които неизбежно ще се сблъскате в живота си, това се случва по-често.
Следователно, една от целите на тази презентация за теорията на информацията, освен да демонстрира полезността й, е да ви предупреди за тази опасност или да демонстрира как точно може да се използва за постигане на желан резултат. Отдавна е забелязано, че първоначалните дефиниции определят това, което откривате в крайна сметка, в много по-голяма степен, отколкото изглежда. Първоначалните дефиниции изискват от вас голямо внимание не само в всяка нова ситуация, но и в области, в които работите отдавна. Това ще ви помогне да разберете в каква степен получените резултати са тъй наречена тавтология, а не нещо полезно.
Известната история на Еддингтън разказва за хора, които ловят риба в морето с мрежа. Изучавайки размера на рибите, които са уловили, те определили минималния размер на рибата, която води в морето! Техният извод е обусловен от използвания инструмент, а не от реалността.
Продължение следва…
Който иска да помогне с превода, оформлението и издаването на книгата — пишете на лично съобщение или на имейл magisterludi2016@yandex.ru
Между другото, ние вече стартирахме превода на още една страхотна книга — )
Особено търсим тези, които ще помогнат да се преведе . (превеждаме по 10 минути, първите 20 вече взехме)
Съдържание на книгата и преведени глави
- Въведение в Изкуството на Науката и Инженерството: Учейки се да учим (28 март 1995)
- «Основи на цифровата (дискретна) революция» (30 март 1995)
- «История на компютрите — Хардуер» (31 март 1995)
- «История на компютрите — Софтуер» (4 април 1995)
- «История на компютрите — Приложения» (6 април 1995)
- «Изкуствен интелект — Част I» (7 април 1995)
- «Изкуствен интелект — Част II» (11 април 1995)
- «Изкуствен интелект III» (13 април 1995)
- «n-измерно пространство» (14 април 1995)
- «Теория на кодовете — Представление на информацията, Част I» (18 април 1995)
- «Теория на кодовете — Представление на информацията, Част II» (20 април 1995)
- «Кодове за корекция на грешки» (21 април 1995)
- «Теория на информацията» (25 април 1995)
- «Цифрови филтри, Част I» (27 април 1995)
- «Цифрови филтри, Част II» (28 април 1995)
- «Цифрови филтри, Част III» (2 май 1995)
- «Цифрови филтри, Част IV» (4 май 1995)
- «Симулация, Част I» (5 май 1995)
- Глава 19. Моделиране — II
- «Симулация, Част III» (11 май 1995)
- «Обучение с помощта на компютър» (16 май 1995)
- «Математика» (18 май 1995)
- «Квантова механика» (19 май 1995)
- «Креативност» (23 май 1995). Превод:
- «Експерти» (25 май 1995)
- «Недостоверни данни» (26 май 1995)
- «Системно инженерство» (30 май 1995)
- «Вие получавате това, което измервате» (1 юни 1995)
- «Как знаем какво знаем»
- Hamming, «Вие и Вашето изследване» (6 юни 1995). Превод: Вие и Вашата работа
- Ние го направихме! «Целта на този курс е да ви подготви за вашето техническо бъдеще.»
Който иска да помогне с превода, оформлението и издаването на книгата — пишете на лично съобщение или на имейл magisterludi2016@yandex.ru
Източник: habr.com
