

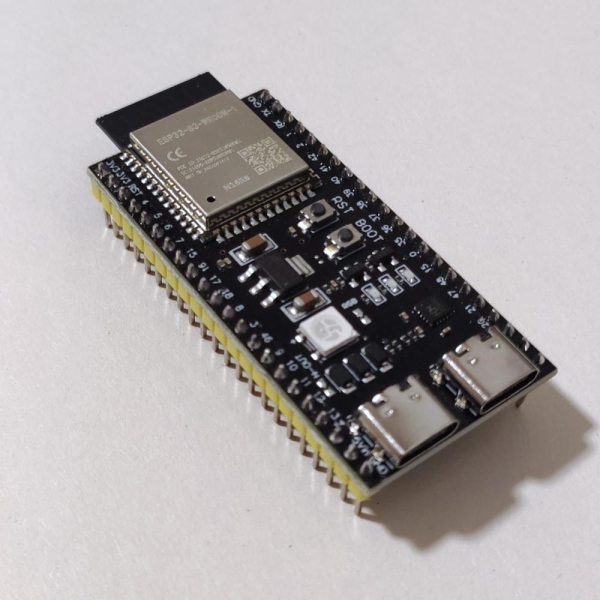
Разработчик Вячеслав Сербов, известный под псевдонимом slvDev, демонстрира осуществил полностью локальную генерацию текста на микроконтроллере ESP32-S3. Созданная им языковая модель содержит 28,9 млн параметров и выдает около 9,9 токена в секунду, не обращаясь к серверу или другим внешним вычислительным ресурсам. Сгенерированные короткие рассказы выводятся на подключенный OLED-дисплей.
Проект esp32-ai была протестирована на модуле ESP32-S3 N16R8, который имеет 512 КБ встроенной SRAM, 8 МБ PSRAM и 16 МБ флеш-памяти. Квантованная до четырех бит модель занимает 14,9 МБ. В репозитории опубликованы исходный код среды исполнения на C, инструменты для обучения и квантования модели, прошивка, тесты и сценарии её загрузки на плату.
Объявленные 28,9 млн параметров не следует напрямую сравнивать с количеством параметров обычных настольных LLM. Согласно подробному отчету разработчика, модель состоит из плотного вычислительного ядра примерно на 559 тысяч параметров, выходного слоя на 3,1 млн параметров и таблицы послойных векторных представлений примерно на 25 млн параметров. Именно последняя обеспечивает основную часть формального размера модели, но не обрабатывается полностью при генерации каждого токена.
Для размещения модели используются три уровня памяти. Наиболее часто используемые данные находятся во внутренней SRAM, выходной слой, KV-кэш и временные буферы — в PSRAM, а 25-миллионная таблица остается во флеш-памяти и доступна через отображение в адресное пространство. Для каждого токена из неё считывается лишь около шести строк общим объёмом примерно 450 байт.
Такое устройство основано на технологии Per-Layer Embeddings, применённой Google в Gemma 3n. Согласно документации Google, PLE-параметры могут храниться вне рабочей памяти модели и добавляться в процесс вывода по мере обработки отдельных слоёв. В esp32-ai этот подход перенесён на иерархию памяти микроконтроллера, где быстрая SRAM особенно ограничена.
Първата коректна версия на средата за изпълнение написана на C е давала само 0,57 токена в секунда. След прехвърлянето на изходния слой в PSRAM, преминаването към осембитови активации, разпределянето на изчисленията между двата ядра Xtensa LX7 и други оптимизации, латентността е била намалена до 94,9 мс на стъпка от модела. Финалната измерена скорост е достигнала 9,88 токена в секунда с оглед на целия процес на генериране. Основното ограничение сега е пропускната способност на PSRAM при четенето на изходния слой.
Моделът е обучен на синтетичен набор от данни TinyStories, състоящ се от прости англоговорящи разкази с ограничен речник. Поради това е способен да продължава фрази и да съчинява малки свързани истории, но не е предназначен за отговаряне на въпроси, изпълнение на инструкции, програмиране или възпроизвеждане на фактически знания. Разработчикът разглежда работата главно като демонстрация на ефективното разположение на модела в паметта на микроконтролера, а не като готов автономен чат-бот.
В актуалната документация авторът отделно подчертава, че esp32-ai е самостоятелна разработка. Проектите llama2.c На Андрей Карпати и по-ранен стартиране на 260-хилядния модел на ESP32-S3 се дават като ориентири и примери за предишни работи: кодът, контролните точки и методиката не са заимствани пряко от тях. Изходният код на esp32-ai се разпространява под MIT лиценз.
Източник: linux.org.ru
