

Здравей, Хабр!
През есента на миналата година се проведе конкурс на Kaggle за класифициране на ръчно нарисувани изображения Quick Draw Doodle Recognition, в който сред другите участва екип от R-програмисти, съставен от , и . Няма да описваме подробно състезанието, това вече е направено в .
Този път не успяхме да спечелим медали, но получихме много ценно опит, затова искахме да споделим с общността за редица най-интересни и полезни неща от Kaggle и в ежедневната работа. Сред разгледаните теми: трудният живот без OpenCV, парсиране на JSON (в тези примери се разглежда интеграция на C++ код в скриптове или пакети на R чрез Rcpp), параметризация на скриптове и докеризация на крайното решение. Целият код от съобщението е наличен в използваем формат в .
Съдържание:
1. Ефективно зареждане на данни от CSV в база MonetDB
Данните в това състезание не са предоставени под формата на готови изображения, а в 340 CSV файла (по един файл за всеки клас), съдържащи JSON с координатите на точките. Свързвайки тези точки с линии, получаваме крайното изображение с размер 256x256 пиксела. Също така за всеки запис се предоставя етикет, дали изображението е било коректно разпознато от класификатора, използван по време на събиране на датасета; двубуквен код на страната на пребиваване на автора на рисунката; уникален идентификатор; времеви етикет и име на класа, съвпадащо с името на файла. Оптимизираната версия на изходните данни тежи 7.4 Гб в архив и около 20 Гб след разархивиране, а пълните данни след разархивиране заемат 240 Гб. Организаторите гарантираха, че и двете версии възпроизвеждат едни и същи рисунки, т.е. пълната версия е излишна. Във всеки случай, съхраняването на 50 млн. изображения в графични файлове или под формата на масиви незабавно беше признато за нерентабилно и решихме да слеем всички CSV файлове от архива train_simplified.zip в база данни с последваща генерация на изображения с необходимия размер "на лето" за всяка партида.
За СУБД беше избрана добре зарекомендала се опция MonetDB, а именно реализицията за R под формата на пакет . Пакетът включва в себе си вградена версия на сървъра на базата данни и позволява да стартирате сървъра директно от сесията на R и да работите с него там. Създаването на база данни и свързването към нея се извършва с една команда:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Ще ни е необходимо да създадем две таблици: една за всички данни и друга за служебна информация за качените файлове (ще е полезно, ако нещо се обърка и процесът трябва да се поднови след качване на няколко файла):
Създаване на таблици
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
Най-бързият метод за зареждане на данни в БД се оказа директното копиране на CSV файлове чрез SQL — командата COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT, където tablename — името на таблицата и път — пътят към файла. При работа с архива открихме, че вградената реализация unzip в R не работи коректно с редица файлове от архива, затова използвахме системния unzip (чрез параметъра getOption("unzip")).
Функция за запис в базата
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
В случай, че е необходимо да предприемете преобразуване на таблицата преди записа в БД, е достатъчно да предадете в аргумента preprocess функция, която ще преобразува данните.
Код за последователно зареждане на данни в базата:
Запис на данни в базата
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
Времето за зареждане на данни може да варира в зависимост от скоростните характеристики на използвания носител. В нашия случай четенето и записването в рамките на един SSD или от флаш устройство (изходния файл) на SSD (БД) отнема по-малко от 10 минути.
Още няколко секунди са необходими за създаването на стълб с целочислена етикетна клас и стълб индекс (ORDERED INDEX) с номера на редовете, по който ще се извършва изборът на наблюдения при създаването на партиди:
Създаване на допълнителни стълбове и индекс
message("Генериране на етикети")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Генериране на номера на редове")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
За да решим задачата за генериране на партида «на лето», трябваше да постигнем максимална скорост на извличане на случайни редове от таблицата дудли. За това използвахме 3 трика. Първият се състоеше в намаляване на размерността на типа, в който се съхранява ID на наблюдението. В изходния набор от данни за съхранение на ID е необходим тип bigint, но броят на наблюденията позволява да се вместят идентификаторите, равни на порядковия номер, в тип int. Търсенето при това става значително по-бързо. Вторият трик беше използването на ORDERED INDEX — до това решение достигнахме емпирически, проверявайки всички налични . Третият се състоеше в използването на параметризирани заявки. Същността на метода се състои в еднократното изпълнение на командата PREPARE с последваща употреба на подготвеното изразяване при създаването на куп от еднотипни заявки, но на практика печалбата в сравнение с простия SELECT се оказа около статистическата грешка.
Процесът на зареждане на данни не изразходва повече от 450 Мб RAM. Тоест, описаният подход позволява управление на датасети с тегло в десетки гигабайти практически на всяко бюджетно оборудване, включително някои едноплатни компютри, което е доста впечатляващо.
Остава да извършим измервания на скоростта на извличане (случайни) данни и да оценим мащабирането при избор на партиди с различен размер:
Бенчмарк на базата данни
library(ggplot2)

set.seed(0)
# Свързване с базата данни
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Функция за подготовка на запитване на страната на сървъра
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Функция за извличане на данни
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Провеждане на бенчмарк тест
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Параметри на бенчмарка
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("медийно време, с") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 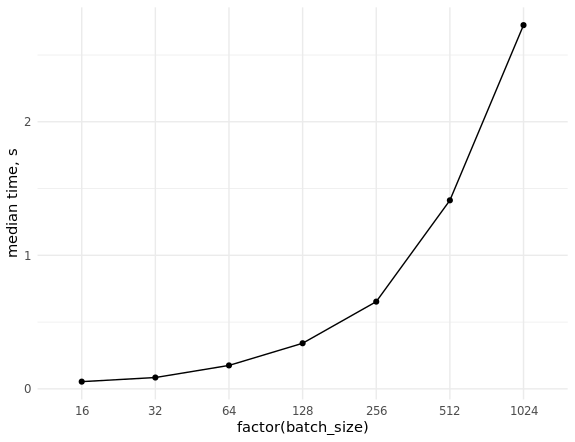
2. Подготовка на партиди
Целият процес на подготовка на партиди се състои от следните етапи:
- Парсинг на няколко JSON-а, съдържащи вектори от низове с координатите на точките.
- Нанасяне на цветни линии по координатите на точките в изображение с необходимия размер (например 256×256 или 128×128).
- Преобразуване на получените изображения в тензор.
В контекста на състезание между kernel-и на Python, задачата беше решена предимно с помощта на OpenCV. Един от най-простите и очевидни аналози на R ще изглежда по следния начин:
Реализация на преобразуването на JSON в тензор на R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # Парсиране на JSON
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Премахване на временното файлче след края на функцията
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Празен график
  plot.new()
  # Размер на графичния прозорец
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Цветове на линиите
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Преобразуване на изображението в 3D масив
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Обединение на 3D масиви в 4D тензор
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
Рисуването се извършва със стандартни средства на R, като се съхранява в временно PNG, което се съхранява в RAM (в Linux временното директории на R са в папка /tmp, монтирана в RAM). След това този файл се прочита като тримерен масив с числа в диапазона от 0 до 1. Това е важно, тъй като по-разпространеният BMP би бил прочетен като raw-масив с hex-кодове на цветове.
Нека тестваме резултата:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 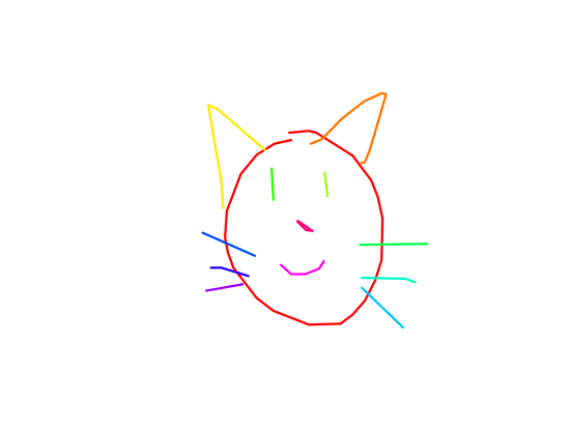
Самият батч ще бъде формулиран по следния начин:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
Тази реализация ни се стори неоптимална, тъй като образуването на големи батчове отнема неподходящо много време, и решихме да се възползваме от опитa на колегите, като включим мощна библиотека OpenCV. В този момент нямаше готов пакет за R (и все още няма), затова беше написана минимална реализация на необходимата функционалност на C++ с интеграция в кода на R с помощта на Rcpp.
За решаването на задачата се използваха следните пакети и библиотеки:
OpenCV за работа с изображения и рисуване на линии. Използвани предварително инсталирани системни библиотеки и заглавни файлове, а също и динамично свързване.
xtensor за работа с многомерни масиви и тензори. Използвахме заглавни файлове, включени в едноименния R-пакет. Библиотеката позволява работа с многомерни масиви, както в редово, така и в колоново подреждане.
ndjson за парсиране на JSON. Тази библиотека се използва в xtensor автоматично при нейното наличие в проекта.
RcppThread за организиране на многопоточна обработка на вектор от JSON-ове. Използвахме заглавни файлове, предоставени от този пакет. Въпреки че е по-малко популярен от RcppParallel пакетът наред с другото се отличава с вграден механизъм за прекъсване на цикъла (interrupt).
Струва си да се отбележи, че xtensor се оказа истинско откритие: освен че разполага с обширен функционал и висока производителност, разработчиците му бяха доста отзивчиви и бързо и подробно отговаряха на възникнали въпроси. С тяхна помощ успяхме да реализираме преобразувания на матрици OpenCV в тензори xtensor, а също и метод за комбиниране на 3-мерни тензори на изображения в 4-мерен тензор с правилни размерности (собственият батч).
Материали за изучаване на Rcpp, xtensor и RcppThread
За компилация на файлове, използващи системни файлове и динамично свързване с инсталираните в системата библиотеки, ние използвахме механизма за плъгини, реализиран в пакета Rcpp. За автоматично намиране на пътища и флагове използвахме популярната linux-утилита pkg-config.
Реализация на Rcpp-плъгин за използване на библиотеката OpenCV
Rcpp::registerPlugin("opencv", function() {
  # Възможни имена на пакета
  pkg_config_name <- c("opencv", "opencv4")
  # Изпълним файл на утилитата pkg-config
  pkg_config_bin <- Sys.which("pkg-config")
  # Проверка за наличието на утилита в системата
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Проверка за наличието на файлове за настройки OpenCV за pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("OpenCV конфигурация за pkg-config не е намерена", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
В резултат на работата на плъгина по време на компилацията ще бъдат подставени следните стойности:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
Кодът за реализиране на парсинг на JSON и формиране на батч за предаване на модела е приведен под спойлера. Предварително добавяме локалната директория на проекта за търсене на заглавни файлове (необходимо за ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Реализация на преобразуването на JSON в тензор на C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Този код трябва да бъде поставен в файл src/cv_xt.cpp и да бъде компилиран с командата Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); също така за работата ще е нужна nlohmann/json.hpp от . Кодът е разделен на няколко функции:
to_xt— шаблонизирана функция за преобразуване на матрица на изображение (cv::Mat) в тензорxt::xtensor;parse_json— функция, която парсва JSON низ, извлича координатите на точките, опакова ги в вектор;ocv_draw_lines— от получения вектор точки рисува многоцветни линии;process— комбинира горепосочените функции, както и добавя възможност за мащабиране на полученото изображение;cpp_process_json_str— обвивка около функциятаprocess, която експортира резултата в R-обект (многомерен масив);cpp_process_json_vector— обвивка около функциятаcpp_process_json_str, която позволява обработка на вектор от низове в многопоточен режим.
За рисуването на многоцветни линии се използва цветова модель HSV с последваща конверсия в RGB. Нека тестваме резултата:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 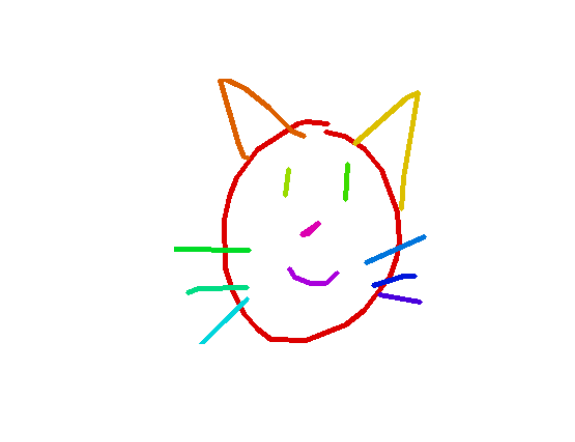
Сравнение на скоростта на работа на реализациите на R и C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Параметри на бенчмарка
cols <- c("expression", "min", "median", "max", "itr/ сек", "total_time", "n_itr")
res_bench[, cols]

#   expression                min     median       max `itr/ сек` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Извършване на измерване
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expression   batch_size      min   median      max `itr/ сек` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>        <bch:tm> <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("медийно време, с") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 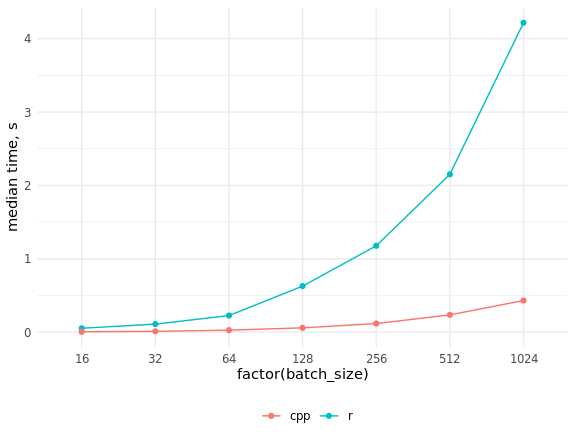
Както виждаме, увеличението на скоростта е много значително и не е възможно да се достигне кодът на C++ чрез паралелизация на кода на R.
3. Итератори за извличане на батчове от БД
R има заслужена репутация на език за обработка на данни, които се побират в RAM, докато Python е по-характерен с итеративната обработка на данни, което позволява лесно и неусетно реализиране на out-of-core изчисления (изчисления с използване на външна памет). Класически и актуален за нас пример за такива изчисления в контекста на обсъжданата задача са дълбоките невронни мрежи, обучаващи се чрез метода на градиентния спуск с аппроксимация на градиента на всяка стъпка по малка порция наблюдения или мини-батч.
Фреймворците за дълбоко обучение, написани на Python, разполагат със специални класове, реализиращи итератори за данни: таблици, изображения в папки, бинарни формати и др. Може да се използват готови варианти или да се пишат собствени за специфични задачи. В R можем да се възползваме от всички функции на библиотеката на Python keras с неговите различни бекенди чрез едноименния пакет, който от своя страна работи върху пакета reticulate. Последният заслужава отделна голяма статия; той не само позволява изпълнение на код на Python от R, но и осигурява предаване на обекти между R и Python сесии, автоматично извършвайки всички необходими преобразувания на типове.
Освободихме се от необходимостта да съхраняваме всички данни в RAM с помощта на MonetDBLite, цялата "невронна" работа ще се извършва от оригиналния код на Python, а ние трябва само да напишем итератор за данни, тъй като няма готов такъв нито за R, нито за Python. Изискванията към него са основно две: той трябва да връща батчовете в безкраен цикъл и да запазва състоянието си между итерациите (последното в R се реализира по най-простия начин с помощта на замикания). По-рано беше необходимо вътре в итератора явно да преобразуваме масивите на R в numpy масиви, но актуалната версия на пакета keras прави това сама.
Итераторът за обучаващи и валидационни данни изглежда така:
Итератор за обучаващи и валидационни данни
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
Функцията приема на вход променлива с връзка към базата данни, номера на използваните редове, брой класове, размер на батча, мащаб (scale = 1 отговаря на рисуването на изображения 256x256 пиксела, scale = 0.5 — 128x128 пиксела), индикатор за цветност (color = FALSE задата рисуването в нюанси на сиво, при използване color = TRUE всички щрихи се рисуват с нов цвят) и индикатор за препроцесиране за мрежи, предобучени на imagenet. Последният е необходим, за да се скалират стойностите на пикселите от интервала [0, 1] до интервала [-1, 1], който е използван при обучението на предоставените в състава keras модели.
Външната функция съдържа проверка на типовете аргументи, таблица data.table с произволно разбъркани номера на редове от samples_index и номера на партидите, брояч и максимален брой партиди, както и SQL израз за извличане на данни от БД. Допълнително, ние определихме вътре бърз аналог на функцията keras::to_categorical(). Използвахме почти всички данни за обучение, оставяйки половин процент за валидиране, така че размерът на епохата беше ограничен от параметъра steps_per_epoch при извикване keras::fit_generator(), и условието if (i > max_i) сработваше само за валидиращия итератор.
Във вътрешната функция се извършва избор на индекси на редове за следващото партида, извличане на записи от БД с увеличаване на брояча на партидите, парсинг на JSON (функция cpp_process_json_vector(), написана на C++) и създаване на масиви, отговарящи на изображенията. След това се създават one-hot вектори с етикети на класовете, масивите със стойности на пикселите и с етикетите се обединяват в списък, който е върнатата стойност. За ускорение на работата беше използвано създаването на индекси в таблиците data.table и модификацията по референция — без тези «трикове» на пакета data.table много трудно се представя ефективна работа с каквито и да е значителни обеми данни в R.
Резултатите от измерванията на скоростта на работа на лаптопа с Core i5 изглеждат по следния начин:
Бенчмарк на итератора
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Индексы за обучаваща извадка
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Индекси за проверъчна извадка
val_ind <- ind[-train_ind]
rm(ind)
# Коэффициент по мащабиране
scale <- 0.5

# Провеждане на измерване
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Параметри за бенчмарка
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("median time, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 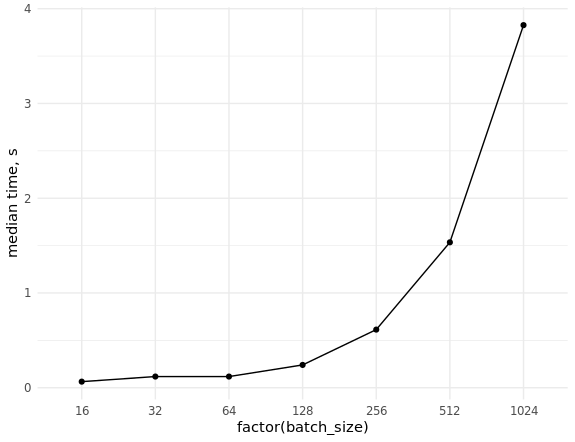
Ако имате достатъчно количество RAM, можете да ускорите работата на базата данни като я преместите в RAM (за нашата задача е достатъчно 32 GB). В Linux по подразбиране се монтира дял /dev/shm, заемащ до половината от обема на RAM. Може да отделите и повече, като редактирате /etc/fstab, за да получите записа на вида tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Задължително перезареждаме и проверяваме резултата, изпълнявайки командата df -h.
Итераторът за тестови данни изглежда много по-просто, тъй като тестовият набор от данни изцяло се съхранява в RAM:
Итератор за тестови данни
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Избор на архитектура на модела
Първата от използваните архитектури беше , особеностите на която са разгледани в съобщението. Тя присъства в стандартната доставка keras и съответно е налична в идентичното име пакет за R. Но при опит да я използвате с едноканални изображения, стана странно: входният тензор винаги трябва да има размер (batch, height, width, 3), т.е. бройте на каналите не може да се променя. В Python такова ограничение няма, затова побързахме и написахме собствена реализация на архитектурата, следвайки оригиналната статия (без дропаута, който съществува в версията на keras):
Архитектура mobilenet v1
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Недостатъците на такъв подход са очевидни. Иска се да се тества много модели, а не е желателно да се преписва всяка архитектура ръчно. Освен това, бяхме лишени от възможността да използваме тежестите на модели, предварително обучени на imagenet. Както обикновено, изучаването на документацията помогна. Функцията get_config() позволява да получите описание на модела в редактиран вид (base_model_conf$layers — обичаен R-генериран списък), а функцията from_config() извършва обратно преобразуване в модел обект:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Сега не е трудно да се напише универсална функция за получаване на всяка от доставените в комплекта keras модели с обучени на imagenet тежести или без тях:
Функция за зареждане на готови архитектури
get_model <- function(name = "mobilenet_v2",
                      input_shape = NULL,
                      weights = "imagenet",
                      pooling = "avg",
                      num_classes = NULL,
                      optimizer = keras::optimizer_adam(lr = 0.002),
                      loss = "categorical_crossentropy",
                      metrics = NULL,
                      color = TRUE,
                      compile = FALSE) {
  # Проверка на аргументите
  checkmate::assert_string(name)
  checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3)
  checkmate::assert_count(num_classes)
  checkmate::assert_flag(color)
  checkmate::assert_flag(compile)

  # Получаваме обект от пакета keras
  model_fun <- get0(paste0("application_", name), envir = asNamespace("keras"))
  # Проверка за наличието на обекта в пакета
  if (is.null(model_fun)) {
    stop("Модел ", shQuote(name), " не е намерен.", call. = FALSE)
  }

  base_model <- model_fun(
    input_shape = input_shape,
    include_top = FALSE,
    weights = weights,
    pooling = pooling
  )

  # Ако изображението не е цветно, променяме размерността на входа
  if (!color) {
    base_model_conf <- keras::get_config(base_model)
    base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
    base_model <- keras::from_config(base_model_conf)
  }

  predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output
  predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax")
  model <- keras::keras_model(
    inputs = base_model$input,
    outputs = predictions
  )

  if (compile) {
    keras::compile(
      object = model,
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )
  }

  return(model)
}
При използване на едноканални изображения предварително обучените тежести не се използват. Това можеше да се поправи: с помощта на функцията get_weights() да получим тежестите на модела под формата на списък от R-масиви, да променим размерността на първия елемент на този списък (като вземем някой един цветен канал или средният от трите), а след това да заредим отново тежестите в модела с функцията set_weights(). Ние не добавихме тази функционалност, тъй като на този етап вече стана ясно, че е по-продуктивно да работим с цветни изображения.
Основната част от експериментите проведохме с mobilenet версия 1 и 2, както и с resnet34. В това състезание добре се представиха по-съвременни архитектури, като SE-ResNeXt. За съжаление, нямахме готови реализации на разположение, а собствени не написахме (но определено ще напишем).
5. Параметризиране на скриптове
За удобство целият код за стартиране на обучението е оформен в единен скрипт, параметризиран с по следния начин:
doc <- '
Използване:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [options]

Опции:
  -h --help                   Покажи това съобщение.
  -l --list-models            Изброи наличните модели.
  -m --model=          Име на модела на невронна мрежа [по подразбиране: mobilenet_v2].
  -b --batch-size=      Размер на партидата [по подразбиране: 32].
  -s --scale-factor=   Фактор на мащабиране [по подразбиране: 0.5].
  -c --color                  Използвай цветни линии [по подразбиране: FALSE].
  -d --db-dir=          Път до директорията на базата данни [по подразбиране: Sys.getenv("db_dir")].
  -r --validate-ratio= Съотношение за валидиране на пробата [по подразбиране: 0.995].
  -n --n-gpu=         Брой GPU [по подразбиране: 1].
'
args <- docopt::docopt(doc)
Пакет docopt представлява реализация за R. С него скриптовете се стартират с прости команди от вида Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db или ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, ако файлът train_nn.R е изпълняем (тази команда ще стартира обучението на модела resnet50 на цветни изображения с размери 128х128 пиксела, базата данни трябва да се намира в папка /home/andrey/doodle_db). В списъка могат да се добавят скорост на обучение, вид оптимизатор и всякакви други параметри за настройка. В процеса на подготовка на публикацията стана ясно, че архитектурата mobilenet_v2 от актуалната версия keras в R се използва заради неотчетени промени в R-пакета — чакаме, докато го поправят.
Този подход позволи значително ускоряване на експериментите с различни модели в сравнение с по-традиционното стартиране на скриптове в RStudio (като алтернатива можем да отбележим пакета ). Но основното предимство е възможността лесно да управлявате стартирането на скриптове в Docker или просто на сървър, без да инсталирате RStudio за това.
6. Докеризация на скриптове
Използвахме Docker с цел да осигурим преносимост на средата за обучение на моделите между членовете на екипа и за бързо разгъване в облака. Можете да започнете своята подготовка с тази относително необичайна за R-програмист инструмент от серия публикации или от .
Docker позволява както да създавате собствени образи "от нулата", така и да използвате други образи като основа за създаване на собствени. При анализа на наличните варианти стигнахме до извода, че инсталирането на драйвери NVIDIA, CUDA+cuDNN и Python библиотеки е доста обемна част от образа и решихме да вземем за основа официалния образ. tensorflow/tensorflow:1.12.0-gpu, добавяйки необходимите R пакети.
Крайният Docker файл изглежда така:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
За удобство използваните пакети бяха изнесени в променливи; основната част от написаните скриптове се копира в контейнерите при изграждането. Също така сменихме командната обвивка на /bin/bash за удобство при работа със съдържанието /etc/os-release. Това позволи да се избегне необходимостта от указване на версия на ОС в кода.
Допълнително беше написан малък bash скрипт, който позволява стартиране на контейнера с различни команди. Например, това могат да бъдат скриптове за обучение на невронни мрежи, които са били предварително поставени в контейнера, или командната обвивка за отстраняване на грешки и мониторинг на работата на контейнера:
Скрипт за стартиране на контейнера
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Ако този bash скрипт бъде стартиран без параметри, в контейнера ще се извика скрипт train_nn.R с подразбиращи се стойности; ако първият позиционен аргумент е "bash", контейнерът ще стартира в интерактивен режим с команден интерпретатор. Във всички останали случаи ще се извърши подмяна на стойностите на позиционните аргументи: CMD="Rscript /app/train_nn.R $@".
Важно е да се отбележи, че директориите с входящите данни и базата данни, както и директорията за запазване на обучените модели, се монтират вътре в контейнера от хост системата, което позволява достъп до резултатите от работата на скриптовете без излишни манипулации.
7. Използване на няколко GPU в Google Cloud
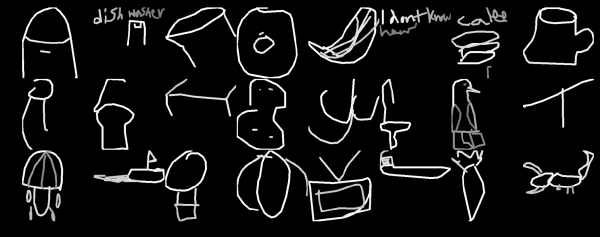
Една от характерните черти на състезанието бяха много шумни данни (вж. заглавната картинка, предоставена от @Leigh.plt от ODS Slack). За справяне с това, голямите партиди помагат, и след експерименти на компютър с 1 GPU решихме да освоим обучението на модели на няколко GPU в облака. Използвахме Google Cloud () заради голямото разнообразие от достъпни конфигурации, приемливи цени и бонус от $300. От ненаситност поръчахме инстанция с 4xV100 с SSD и много RAM, и това се оказа голяма грешка. Пари такава машина яде бързо, при експерименти без установен поток се може да се разорите. За учебни цели е по-добре да вземете K80. Но голямото количество RAM беше полезно - облачният SSD не впечатли с бързодействието си, затова базата данни при всяко стартиране на инстанцията се преносеше на dev/shm.
Най-интересен е фрагментът от кода, отговорен за използването на няколко GPU. Първо моделът се създава на CPU с помощта на мениджър на контекста, точно както на Python:
with(tensorflow::tf$device("/cpu:0"), {
  model_cpu <- get_model(
    name = model_name,
    input_shape = input_shape,
    weights = weights,
    metrics =(top_3_categorical_accuracy,
    compile = FALSE
  )
})
След това несъбран (това е важно) моделът се копира на зададеното количество налични GPU и едва след това се компилира:
model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu)
keras::compile(
  object = model,
  optimizer = keras::optimizer_adam(lr = 0.0004),
  loss = "categorical_crossentropy",
  metrics = c(top_3_categorical_accuracy)
)
Класическата практика с замразяване на всички слоеве, освен последния, обучаване на последния слой, размразяване и дообучаване на модела изцяло за няколко GPU не успя да реализира.
Следенето на обучението се извършваше без използването на tensorboard, ограничавайки се до запис на логове и запазване на модели с информативни имена след всяка епоха:
Колбеки
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. Вместо заключение
Редица проблеми, с които се сблъскахме, все още не успяхме да преодолеем:
- в keras няма готова функция за автоматично търсене на оптимална скорост на обучение (аналога на
lr_finderв библиотеке fast.ai); приложихме усилия, за да преносим на R външни реализации, например, ; - като следствие от предходната точка, не успяхме да подберем правилната скорост на обучение при използване на няколко GPU;
- липсват съвременни архитектури на невронните мрежи, особено предварително обучени на imagenet;
- няма one cycle policy и дискретни скорости на обучение (cosine annealing по нашата молба беше , благодаря ).
Какво полезно успяхме да извлечем от това състезание:
- На сравнително слаб хардуер може без трудности да се работи с прилични (многократно превишаващи размера на RAM) обеми данни. Пакетът data.table економисва памет чрез in-place модификация на таблиците, което позволява да се избегне копирането им, и при правилно използване на неговите възможности почти винаги демонстрира най-висока скорост сред всички известни на нас инструменти за скриптови езици. Запазването на данни в БД позволява в много случаи изобщо да не се мисли за необходимостта да се вмества целия dataset в RAM.
- Бавни функции на R могат да бъдат заменени с бързи на C++ с помощта на пакета Rcpp. Ако допълнително използваме RcppThread или RcppParallel, получаваме кросплатформени многопоточни реализации, така че кодът на ниво R не се налага да се паралелизира.
- С пакета Rcpp може да се работи без сериозни познания по C++, необходимият минимум е изложен . Заглавните файлове за редица страхотни C-библиотеки като xtensor са налични на CRAN, т.е. се формира инфраструктура за реализиране на проекти, интегриращи в R готов високопроизводителен код на C++. Допълнително удобство — подсветката на синтаксиса и статичният анализатор на код на C++ в RStudio.
- docopt позволява да стартирате самостоятелни скриптове с параметри. Това е удобно за използване на отдалечен сървър, включително под docker. В RStudio провеждането на многократни експерименти с обучение на невронни мрежи е неудобно, а и самата инсталация на IDE на сървера не винаги е оправдана.
- Docker осигурява преносимост на кода и възпроизводимост на резултатите между разработчици с различни версии на ОС и библиотеки, както и лесно стартиране на сървъри. Целият pipeline за обучение може да се стартира с едно единствено командно изречение.
- Google Cloud е икономичен начин да експериментирате с преносимо оборудване, но е необходимо внимателно да избирате конфигурациите.
- Измерването на производителността на отделни фрагменти от кода е много полезно, особено в комбинация с R и C++, а с пакета bench — е още по-лесно.
Като цяло този опит беше много полезен и продължаваме да работим по решаването на някои от посочените проблеми.
Източник: habr.com
