

Кодът на софтуерните продукти за машинно обучение често е сложен и доста объркан. Откриването и отстраняването на бъгове в него е ресурсно натоварено начинание. Дори най-простите изискват сериозен подход към мрежовата архитектура, инициализацията на теглата и оптимизацията на мрежата. Малка грешка може да доведе до неприятни проблеми.
Тази статия е посветена на алгоритъма за отстраняване на проблеми с вашите невронни мрежи.
Skillbox препоръчва: Практически курс .
Напомняме: за всички читатели на "Хабра" — отстъпка от 10 000 рубли при записване на всякакъв курс на Skillbox с промокод "Хабр".
Алгоритъмът се състои от пет етапа:
- прост старт;
- потвърждение на загубите;
- проверка на междинните резултати и връзките;
- диагностика на параметрите;
- контрол на работата.
Ако нещо ви се струва по-интересно от останалото, можете веднага да преминете към тези раздели.
Прост старт
Дебъгването на невронна мрежа със сложна архитектура, регуляризация и планираща скорост на обучение е по-трудно от обикновената. Тук действаме малко хитро, тъй като самата точка за отстраняване на проблеми има косвена връзка, но все пак това е важна препоръка.
Простият старт е създаването на опростен модел и обучението му на един набор (точка) данни.
Първо създаваме опростен модел
За бърз старт създаваме малка мрежа с един скрит слой и проверяваме, дали всичко работи коректно. След това постепенно усложняваме модела, проверявайки всеки нов аспект на неговата структура (допълнителен слой, параметър и т.н.) и продължаваме.
Обучаваме модела на единствен набор (точка) данни
Като бърза проверка на работоспособността на проекта можете да използвате една или две точки данни за обучение, за да потвърдите, дали системата работи коректно. Невронната мрежа трябва да покаже 100% точност на обучението и проверката. Ако не е така, то или моделът е твърде малък, или вече имате бъг.
Дори ако всичко е добре, подгответе модела за преминаване на една или няколко епохи, преди да продължите.
Оценка на загубите
Оценката на загубите е основният начин за прецизиране на производителността на модела. Трябва да се уверите, че загубата е съответстваща на задачата, а функциите за загуба се оценяват по коректна скала. Ако използвате повече от един тип загуба, уверете се, че всички те са на едно и също ниво и правилно мащабирани.
Важно е да бъдете внимателни към началните загуби. Проверете колко близък е реалният резултат до очаквания, ако моделът е стартирал с произволна представа. В : «Уверете се, че получавате очаквания резултат при започване на работа с малък брой параметри. По-добре е веднага да проверите загубата на данни (с настройка на степента на регуляризация на нула). Например, за CIFAR-10 с класификатор Softmax, очакваме началните загуби да бъдат 2.302, тъй като очакваната дифузна вероятност е 0,1 за всеки клас (тъй като има 10 класа), а загубата Softmax е отрицателната логаритмична вероятност на правилния клас, тоест –ln(0.1) = 2.302».
За бинарен пример просто се прави аналогичен изчисление за всеки от класовете. Например, данните: 20% 0 и 80% 1. Очакваната начална загуба ще бъде до –0.2ln(0.5) – 0.8ln(0.5) = 0.693147. Ако резултатът е по-голям от 1, това може да показва, че теглата на невронната мрежа не са правилно балансирани или данните не са нормализирани.
Проверяваме междинните резултати и връзките
За дебъгване на невронната мрежа е необходимо да разберете динамиката на процесите вътре в мрежата и ролята на отделните междинни слоеве, тъй като те са свързани. Ето типични грешки, с които можете да се сблъскате:
- неправилни изрази за актуализации на градиента;
- не се прилагат актуализации на теглата;
- изчезващи или експлодиращи градиенти (exploding gradients).
Ако стойностите на градиента са нулеви, това означава, че скоростта на обучение в оптимизатора е твърде малка, или че сте се сблъскали с некоректен израз за актуализация на градиента.
Освен това, трябва да следите стойностите на функциите на активацията, теглата и актуализациите на всеки от слоевете. Например, величината на актуализациите на параметрите (теглата и смещенията) .
Съществува явление, получило названието “Dying ReLU” или , когато невроните ReLU ще дават нула след изучаване на голямо отрицателно значение (bias) за неговите тегла. Тези неврони никога повече не ще се активират никъде в данните.
Можете да използвате проверки на градиента, за да откриете тези грешки, като приближите градиента с помощта на числен подход. Ако е близо до изчислените градиенти, то обратното разпространение е реализирано правилно. За да създадете проверка на градиента, се запознайте с тези чудесни ресурси от CS231 и , както и с на Андрю Нг (Andrew Ng) по тази тема.
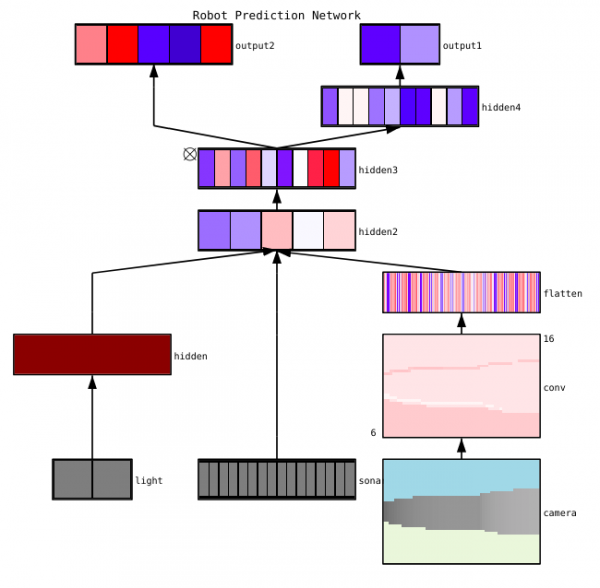
определя три основни метода за визуализация на невронни мрежи:
- Предварителни — прости методи, които ни показват основната структура на обучената модел. Те включват извеждане на форми или филтри на отделни слоеве на невронната мрежа и параметри на всеки слой.
- На базата на активацията. В тях декодираме активирането на отделни неврони или групи неврони, за да разберем техните функции.
- На базата на градиенти. Тези методи обикновено манипулират с градиентите, които се образуват по време на напредване и обратно при обучението на модела (включително карти на значимост и карти на активация на класа).
Има няколко полезни инструмента за визуализация на активации и връзки на отделни слоеве, например, и .
Диагностика на параметрите
Невронните мрежи имат много параметри, които взаимодействат помежду си, което усложнява оптимизацията. Всъщност, тази част е предмет на активни изследвания от страна на специалистите, така че предложенията по-долу трябва да се разглеждат само като съвети, начални точки, от които може да се тръгне.
Размер на пакета (batch size) — ако е необходимо, размерът на пакета трябва да е достатъчно голям, за да получи точни оценки на градиента на грешката, но и достатъчно малък, за да стохастичният градиентен спуск (SGD) може да подреди вашата мрежа. Малките размери на пакета ще доведат до бързо събиране поради шума в процеса на обучение и по-късно — до затруднения в оптимизацията. По-подробно това е описано .
Скорост на обучение — твърде ниска ще доведе до бавна конвергенция или риск да се застрявате в локални минимуми. В същото време, висока скорост на обучение ще предизвика разминаване на оптимизацията, тъй като рискувате да "скочите" през дълбоката, но тясна част на функцията на загубите. Опитайте да използвате планиране на скоростта, за да я намалите в процеса на обучение на невронната мрежа. В курса CS231n .
Ограничение на градиентите— е процес на ограничаване на градиентите на параметрите по време на обратно разпространение до максимална стойност или пределна норма. Полезно е за решаване на проблеми с експлозивни градиенти, с които може да се сблъскате в трета точка.
Пакетна нормализация — се използва за нормализиране на входните данни на всеки слой, което помага за решаване на проблема с вътрешното ковариатно изместване. Ако използвате Dropout и Batch Norma заедно, .
Стохастичен градиентен спуск (SGD) — съществуват няколко разновидности на SGD, които използват моментум, адаптивни скорости на обучение и метода на Нестерова. Въпреки това, никоя от тях не притежава явни предимства по отношение на обучението или обобщаването ().
Регуляризация — е от съществено значение за изграждането на обобщаваща модел, тъй като добавя наказание за сложността на модела или екстремните стойности на параметрите. Това е начин за намаляване на дисперсията на модела без значително увеличаване на неговото отклонение. По-подробна .
За да прецените всичко сами, е необходимо да изключите регуляризацията и да проверите градиента на загубата сами.
Изпадане — е още един метод за регулиране на вашата мрежа за предотвратяване на пренасищане. По време на обучението, изпадането е активно само при поддържане на активността на неврон с определена вероятност p (хиперпараметър) или задаване на нула в противен случай. В резултат на това мрежата трябва да използва различен подмножество от параметри за всяка обучаваща партида, което намалява промените на определени параметри, които стават доминиращи.
Важно: ако използвате както изпадане, така и пакетна нормализация, бъдете внимателни с реда на тези операции или дори с тяхното съвместно използване. Всичко това все още активно се обсъжда и допълва. Ето две важни дискусии по тази тема и .
Контрол на производителността
Става въпрос за документирането на работните процеси и експериментите. Ако не се документира нищо, може да се забрави, например, каква скорост на обучение или тежест на класовете се използва. Благодарение на контрола можете без проблем да преглеждате и възпроизвеждате предишни експерименти. Това позволява да се намали броят на дублиращите се експерименти.
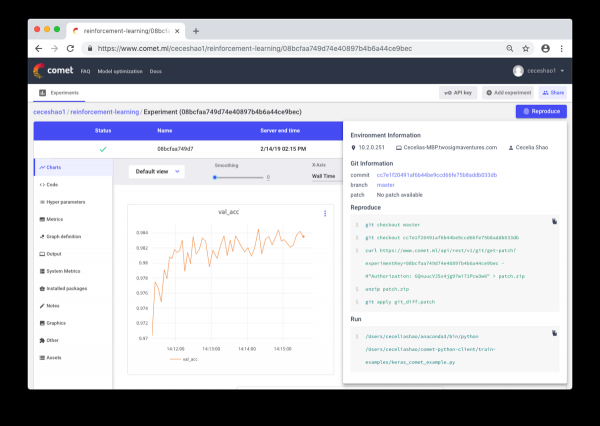
Истината е, че ръчното документиране може да стане сложна задача при голям обем работа. Тук идват на помощ инструменти като Comet.ml, които помагат автоматично да логват набори от данни, промени в кода, история на експериментите и производствени модели, включително ключова информация за вашия модел (хиперпараметри, показатели за производителност на модела и информация за средата).
Невронната мрежа може да бъде доста чувствителна към малки промени, което ще доведе до намаляване на производителността на модела. Проследяването и документирането на работата е първата стъпка, която трябва да предприемете за стандартизиране на средата и моделиране.
Надявам се, че този пост може да стане отправна точка, от която да започнете отстраняването на проблеми с вашата невронна мрежа.
Skillbox препоръчва:
- Двугодишен практически курс .
- Онлайн курс .
- Практически годишен курс .
Източник: habr.com
