

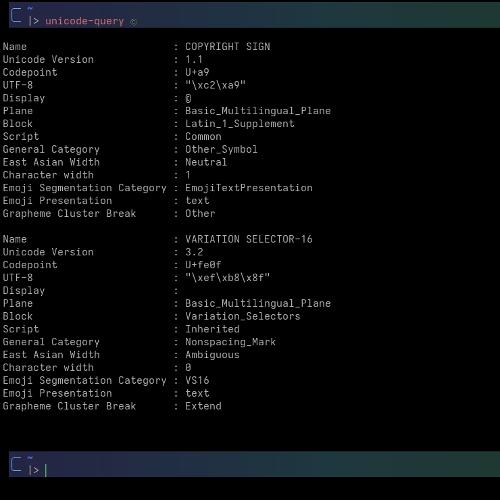
Objavljeno je 0.9.0 izdanje biblioteke za programski jezik C++ (standard C++20) libunicode. Projekat razvija tim programera emulatore terminala Contour i ljuska Endo (u aktivnom razvoju), i distribuira se pod Apache 2.0 licencom.
- podrška standardima Unicode 17.0:
- API za dobijanje Unicode svojstava;
- SIMD optimizacija nekih funkcija (koristeći std::simd ili std::experimental::simd kada su dostupni);
- optimizovana konverzija UTF-8 UTF-16/UTF-32;
- ekvivalent funkcije wcwidth (int unicode::width(char32_t));
- segmentacija teksta po grafemama, simbolima, emodžijima i pismima;
- promena slučaja i upoređivanje stringova;
- visok nivo API-ja za segmentaciju teksta, prikladan za implementaciju oblika teksta.
- pokriće testovima većine mogućnosti biblioteke (širina simbola i segmentacija).
U paketu se takođe nalazi konzolna alatka unicode-query za dobijanje detaljnih informacija o stringovima.
Izmene:
- dodana API funkcija grapheme_cluster_width;
- poboljšanja u radu sa verzijama Unicode-a ('Age');
- potpuna podrška UAX #15 Oblici normalizacije Unicode sa podrškom za obradu u toku:
normalizer norm(Normalization_Form::NFC); // Feed decomposed e + combining acute, then a new starter to trigger emission auto result = norm.feed(U’e’); CHECK(result.empty()); // still buffering result = norm.feed(U’u0301′); CHECK(result.empty()); // still buffering (combining mark) result = norm.feed(U’x’); // starter triggers emission of previous segment REQUIRE_FALSE(result.empty()); CHECK(result == U"u00E9"); // e + acute composed to e-acute result = norm.flush(); CHECK(result == U"x"); // final segment
- funkcija script_extensions sada vraća std::optional<std::span>;
- implementirano je pravilo GB9c za segmentaciju grupa grafema za kombinacije simbola u jezicima grupe Indic;
- u grapheme_segmenter ispravljena pravila za GB11 i GB4/GB5; uklonjen zastarjeli API;
- implementirana je SIMD-optimizovana konverzija UTF-8 u UTF-16/UTF-32;
- širina spojenih simbola Hangul V/T sada je jednaka nuli;
- implementirana je segmentacija prema granicama reči;
- ispravke u C API-ju;
- refaktorisanje sistema za izgradnju i pomoćnog generatora tabela C++;
- dodani kompleksni testovi za konverziju UTF-16/UTF-32;
- u CI dodana statička izgradnja alata unicode-query.
Izvor: linux.org.ru

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish