

Kodovi softverskih proizvoda za mašinsko učenje često su složeni i prilično zbunjujući. Otkrivanje i uklanjanje grešaka u njima predstavlja zahtjevan zadatak. Čak i najjednostavnije zahtijevaju ozbiljan pristup mrežnoj arhitekturi, inicijalizaciji težina i optimizaciji mreže. Mala greška može dovesti do ozbiljnih problema.
Ovaj članak je posvećen algoritmu debagiranja vaših neuronskih mreža.
Skillbox preporučuje: Praktični kurs .
Podsećamo: za sve čitaoce „Habra“ — popust od 10.000 rubalja prilikom upisa na bilo koji kurs Skillbox uz promo kod „Habr“.
Algoritam se sastoji od pet faza:
- jednostavan početak;
- potvrda gubitaka;
- provjera međurezultata i veza;
- dijagnostika parametara;
- kontrolisanje rada.
Ako vam nešto izgleda zanimljivije od ostalog, možete odmah preći na te dijelove.
Jednostavan početak
Debagirati neuronsku mrežu sa složenom arhitekturom, regularizacijom i planiračem brzine učenja je teže nego uobičajenu. Ovde malo prevarićemo, jer sam deo nudi indirektnu povezanost sa debagiranjem, ali to je svejedno važna preporuka.
Jednostavan početak podrazumijeva kreiranje pojednostavljenog modela i njegovo obučavanje na jednom skupu (tački) podataka.
Prvo kreiramo pojednostavljen model
Za brz početak, kreiramo malu mrežu sa jednim skrivenim slojem i provjeravamo da li sve funkcioniše ispravno. Zatim postupno komplikuјemo model, provjeravajući svaki novi aspekt njegove strukture (dodatni sloj, parametar itd.), i idemo naprijed.
Obučavamo model na jedinom skupu (tački) podataka
Kao brzu provjeru funkcionalnosti vašeg projekta možete koristiti jednu ili dvije tačke podataka za obučavanje, kako biste potvrdili ispravnost sistema. Neuronska mreža treba da pokaže 100% tačnost obučavanja i provjere. Ako to nije slučaj, model je previše mali ili već imate grešku.
Čak i ako je sve dobro, pripremite model za prolaz jedne ili više epoha pre nego što krenete dalje.
Procjena gubitaka
Procjena gubitaka je osnovni način za fino podešavanje performansi modela. Morate osigurati da gubitak odgovara zadatku, a funkcije gubitka se ocjenjuju prema ispravnoj skali. Ako koristite više od jednog tipa gubitka, osigurajte da su svi istog obima i ispravno skalirani.
Važno je biti pažljiv prema početnim gubicima. Provjerite koliko se stvarni rezultat približava očekivanom, ako je model započeo s nasumičnom pretpostavkom. U : „Pobrinite se da dobijete rezultat koji očekujete kada počnete raditi s malim brojem parametara. Bolje je odmah provjeriti gubitak podataka (postavljanjem stepena regularizacije na nulu). Na primjer, za CIFAR-10 s klasifikatorom Softmax očekujemo da će početni gubici biti 2.302, jer je očekivana difuzna vjerojatnost 0,1 za svaku klasu (budući da postoji 10 klasa), a gubitak Softmax je negativna logaritamska vjerojatnost ispravne klase kao –ln(0.1) = 2.302“.
Za binarni primjer jednostavno se vrši sličan proračun za svaku od klasa. Evo, na primjer, podaci: 20% 0’s i 80% 1’s. Očekivani početni gubitak iznosi do –0.2ln(0.5) –0.8ln(0.5) = 0.693147. Ako je rezultat veći od 1, to može ukazivati na to da težine neuronske mreže nisu pravilno izbalansirane ili da podaci nisu normalizovani.
Provjeravamo međurezultate i veze
Za debagiranje neuronske mreže potrebno je razumjeti dinamiku procesa unutar mreže i ulogu pojedinih međuslojnih jedinica, budući da su međusobno povezane. Evo tipičnih grešaka s kojima se možete suočiti:
- pogrešni izrazi za ažuriranja gradijenta;
- ažuriranja težina se ne primjenjuju;
- nestajući ili eksplodirajući gradijenti (exploding gradients).
Ako su vrijednosti gradijenta nulte, to znači da je brzina učenja u optimizatoru previše mala, ili da ste naišli na neispravan izraz za ažuriranje gradijenta.
Osim toga, potrebno je pratiti vrijednosti aktivacijskih funkcija, težina i ažuriranja svakog od slojeva. Na primjer, magnitude ažuriranja parametara (težina i pomaka) .
Postoji fenomen koji se naziva “Dying ReLU” ili , kada ReLU neuroni izlaze nulu nakon što su naučili veliko negativno vrijednost (bias) za svoje težine. Ovi neuroni se nikada više neće aktivirati ni na jednom mjestu u podacima.
Možete koristiti proveru gradijenta za identifikaciju ovih grešaka aproksimacijom gradijenta korišćenjem numeričkog pristupa. Ako je blizu izračunatim gradijentima, tada je obrnuto propagiranje pravilno implementirano. Da biste stvorili proveru gradijenta, upoznajte se sa ovim fantastičnim resursima iz CS231 i , kao i sa Endrua Nga (Andrew Nga) o ovoj temi.
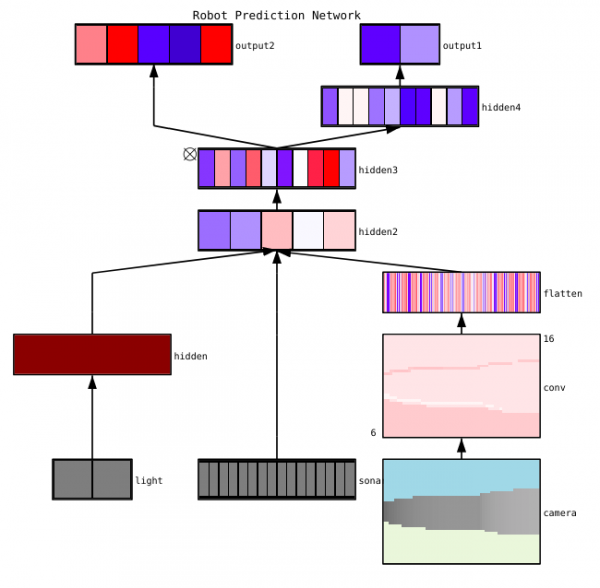
navodi tri glavna metoda vizuelizacije neuronskih mreža:
- Predmetne — jednostavne metode koje nam pokazuju opštu strukturu obučene mreže. One uključuju ispitivanje oblika ili filtera pojedinačnih slojeva neuronske mreže i parametara u svakom sloju.
- Zasnovane na aktivaciji. One mogu da dekodiraju aktivnosti pojedinih neurona ili grupa neurona kako bismo razumeli njihove funkcije.
- Zasnovane na gradijentima. Ove metode obično manipulišu gradijentima koji se formiraju tokom unaprednog i unazadnog prolaza pri obuci modela (uključujući mape značaja i mape aktivacije klase).
Postoji nekoliko korisnih alata za vizuelizaciju aktivacija i veza pojedinačnih slojeva, kao što su i .
Dijagnostika parametara
Neuronske mreže imaju ogroman broj parametara koji međusobno deluju, što otežava optimizaciju. U suštini, ovaj deo je predmet aktivnih istraživanja stručnjaka, tako da se predlozi u nastavku treba smatrati samo savetima, početnim tačkama od kojih se može krenuti.
Veličina serije (batch size) — ako je potrebno, veličina serije treba da bude dovoljno velika da obezbedi tačne procene gradijenta greške, ali dovoljno mala da stohastički gradijentni spust (SGD) može da upravlja vašom mrežom. Male veličine serija dovode do brzog konvergiranja zbog šuma tokom obuke i kasnijih poteškoća u optimizaciji. Više o tome je opisano .
Brzina učenja — previše niska dovodi do sporog konvergiranja ili rizika od zastoja u lokalnim minimumima. Istovremeno, visoka brzina učenja uzrokovaće divergenciju optimizacije, jer rizikujete da "preskočite" duboki, ali uski deo funkcije gubitka. Pokušajte koristiti planiranje brzine kako biste je smanjili tokom obuke neuronske mreže. U kursu CS231n .
Ograničenje gradijenata— obezbeđivanje gradijenata parametara tokom unazadne propagacije prema maksimalnoj vrednosti ili ograničenoj normi. Korisno je za rešavanje problema sa bilo kojim eksplozivnim gradijentima s kojima se možete susresti u trećem delu.
Batch normalizacija — koristi se za normalizaciju ulaznih podataka svakog sloja, što omogućava rešenje problema unutrašnjeg kovarijantnog pomeranja. Ako koristite Dropout i Batch Norm zajedno, .
Stohastički gradijentni spust (SGD) — postoje različite varijante SGD koje koriste moment, adaptivne brzine učenja i Nesterov metod. Međutim, nijedna od njih nema očiglednu prednost u pogledu efikasnosti učenja ili generalizacije ().
Regulacija — je ključna za izgradnju modela koji se može generalizovati, jer dodaje kaznu za složenost modela ili ekstremne vrednosti parametara. To je način smanjenja varijance modela bez značajnog povećanja njenog pristrasnosti. Više .
Da biste sami sve procenili, potrebno je isključiti regulaciju i proveriti gradijent gubitka podataka samostalno.
Dropout — još jedna metoda organizovanja vaše mreže kako bi se sprečila prekomerna opterećenja. Tokom obuke, dropout se ostvaruje samo održavanjem aktivnosti neurona sa određenom verovatnoćom p (hiperparametar) ili podešavanjem na nulu u suprotnom slučaju. Kao rezultat, mreža mora koristiti drugačiji podskup parametara za svaku obučnu seriju, što smanjuje promene određenih parametara koji postaju dominantni.
Važno: ako koristite i dropout i batch normalizaciju, budite oprezni sa redosledom ovih operacija ili čak sa njihovom zajedničkom upotrebom. Sve to još uvek aktivno se raspravlja i dopunjuje. Evo dve važne diskusije na ovu temu i .
Kontrola rada
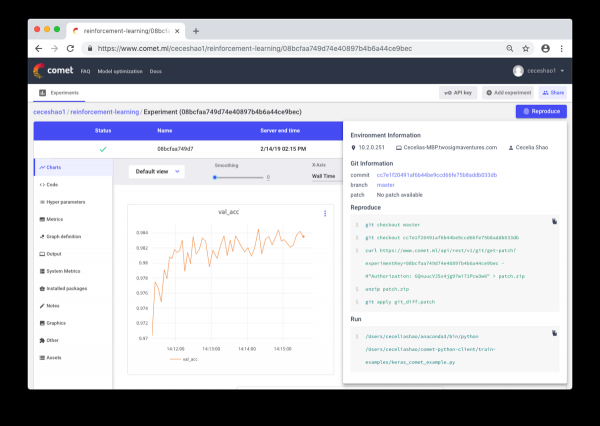
Radi se o dokumentovanju radnih procesa i eksperimenata. Ako ništa ne dokumentujete, možete zaboraviti, na primjer, koja se brzina učenja koristi ili težina klasa. Zahvaljujući kontroli, možete lako pregledati i reproducirati prethodne eksperimente. To omogućava smanjenje broja dupliciranih eksperimenata.
Naravno, ručno dokumentovanje može postati složen zadatak u slučaju velikog obima rada. Tu dolaze u pomoć alati poput Comet.ml, koji pomažu u automatskom beleženju setova podataka, promena koda, istorije eksperimenata i proizvodnih modela, uključujući ključne informacije o vašem modelu (hiperparametri, pokazatelji performansi modela i informacije o okruženju).
Neuronska mreža može biti veoma osetljiva na male promene, što može dovesti do smanjenja performansi modela. Praćenje i dokumentovanje rada je prvi korak koji treba preduzeti kako bi se standardizovalo okruženje i modeliranje.
Nadam se da će ovaj post postati polazna tačka sa kojom ćete započeti podešavanje vaše neuronske mreže.
Skillbox preporučuje:
- Dvogodišnji praktični kurs .
- Online kurs .
- Praktični godišnji kurs .
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish