

Uvod u operativne sisteme
Pozdrav, Habr! Želim da vam predstavim seriju članaka-prevoda jedne zanimljive literature po mom mišljenju — OSTEP. Ovaj materijal duboko istražuje rad unix-sličnih operativnih sistema, odnosno rad sa procesima, raznim planerskim alatima, memorijom i sličnim komponentama koje čine savremeni OS. Izvor svih materijala možete pogledati ovde . Molim vas da uzmete u obzir da je prevod urađen neprofesionalno (dosta slobodno), ali se nadam da sam sačuvao opšti smisao.
Laboratorijske vežbe na ovu temu možete pronaći ovde:
Ostali delovi:
A možete posetiti moj kanal na =)
Planiranje: Multi-Level Feedback Queue
Na ovoj predavanju ćemo razgovarati o problemima razvoja jednog od najpoznatijih pristupa
planiranju, koji se zove Multi-Level Feedback Queue (MLFQ). Prvi put je MLFQ planer opisan 1962. godine od strane Fernanda J. Corbatóa u sistemu koji se zove
Compatible Time-Sharing System (CTSS). Ovi radovi (uključujući i kasnije radove na
Multics) su kasnije predstavljeni za Turingovu nagradu. Planer je
kasnije unaprijeđen i dobio oblik koji možemo vidjeti u
nekim modernim sistemima.
MLFQ algoritam pokušava riješiti 2 fundamentalne preklapajuće probleme.
Prvo, pokušava optimizirati vrijeme okretanja, koje kao što smo razmatrali u prethodnom predavanju, optimizira se metodom pokretanja na početku reda najviše
kratkih zadataka. Međutim, OS ne zna koliko dugo će raditi određeni proces, a to je
neophodno znanje za rad SJF, STCF algoritama. Drugo, MLFQ pokušava
napraviti sistem responzivnim za korisnike (na primjer, za one koji sjede i
bulje u ekran u očekivanju završetka zadatka) i na taj način minimizira vrijeme
odgovora. Nažalost, algoritmi poput RR smanjuju vrijeme odgovora, ali jako
loše utiču na metriku vremena okretanja. Odatle naš problem: Kako dizajnirati
planer koji će ispuniti naše zahtjeve i pritom ništa ne znati o
karakteristikama procesa, uopšte? Kako će planer moći naučiti karakteristike zadataka
koje pokreće i tako donositi bolje odluke o planiranju?
Suština problema: Kako planirati postavljanje zadataka bez idealnog znanja?
Kako razviti planer koji istovremeno minimizira vrijeme odgovora
za interaktivne zadatke a pritom minimizira vrijeme okretanja bez unaprijed
znanja vremena izvršavanja zadatka?
Napomena: učimo iz prethodnih događaja
MLFQ red je sjajan primjer sistema koji se uči iz
prošlih događaja kako bi predvidio budućnost. Slični pristupi često
se susreću u OS (i mnogim drugim industrijama u informatici, uključujući grane
predikcija u hardveru i algoritme keširanja). Slični pristupi
aktivira se kada zadaci imaju faze ponašanja i tako su predvidljivi.
Međutim, s ovom tehnikom treba biti oprezan, jer predviđanja vrlo lako
mogu biti netačna i dovesti sistem do donošenja loših odluka nego što bi
bilo bez ikakvih saznanja.
MLFQ: Osnovna pravila
Razmotrit ćemo osnovna pravila MLFQ algoritma. Iako postoji nekoliko implementacija ovog algoritma,
osnovni pristupi su slični.
U implementaciji koju ćemo razmatrati, MLFQ će imati nekoliko
odvojenih redova, svaki s različitim prioritetima. U svakom trenutku,
zadaca koja je spremna za izvršavanje se nalazi u jednom redu. MLFQ koristi prioritete
da odredi koju zadaću pokrenuti na izvršavanje, tj. zadaća s višim
prioritetom (zadatak iz reda s višim prioritetom) će biti pokrenuta prva
između redova.
Nepobitno, u određenom redu može biti više od jedne zadaće, tako
da će imati isti prioritet. U ovom slučaju, mehanizam
RR će se koristiti za planiranje izvršavanja među tim zadacima.
Tako dolazimo do dva osnovna pravila za MLFQ:
- Pravilo 1: Ako Prioritet(A) > Prioritet(B), izvršit će se zadaća A (B neće)
- Pravilo 2: Ako Prioritet(A) = Prioritet(B), A i B se pokreću koristeći RR
Iz prethodno navedenog, ključni elementi za planiranje MLFQ
su prioriteti. Umesto da dodeljuju fiksni prioritet svakoj
zadaći, MLFQ menja njen prioritet u zavisnosti od ponašanja koje se posmatra.
Na primer, ako zadaća konstantno odlaže rad na CPU-u čekajući unos sa tastature,
MLFQ će održavati prioritet procesa na visokom nivou, jer bi tako
interaktivni proces trebao da funkcioniše. S druge strane, ako zadaća konstantno i
intenzivno koristi CPU kroz duže vreme, MLFQ će smanjiti njen
prioritet. Tako će MLFQ učiti o ponašanju procesa tokom njihove izvedbe
i koristiti to ponašanje.
Ilustrujmo primer kako bi redovi mogli izgledati u određenom trenutku
i tada bi to moglo izgledati ovako:
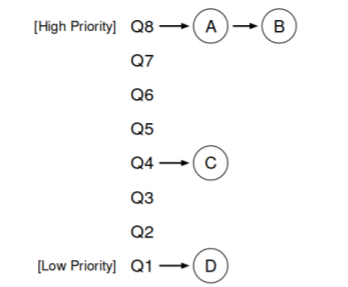
U ovom slučaju, procesi A i B su u redu s najvišim prioritetom. Proces
C je negde napred, a proces D na kraju reda. Prema navedenom
Prema opisima algoritma MLFQ, planer će izvršavati zadatke samo s najvišim
prioritetom prema RR, dok će zadaci C i D biti zapostavljeni.
Naravno, statički snimak neće pružiti potpunu sliku kako MLFQ funkcioniše.
Važno je razumeti kako se slika menja tokom vremena.
Pokušaj 1: Kako menjati prioritet
U ovom trenutku potrebno je odlučiti kako će MLFQ menjati nivo prioritetа
zadataka (i tako poziciju zadataka u redu) tokom njihovog životnog ciklusa. Za
to je potrebno imati na umu radni tok: određeni broj
interaktivnih zadataka s kratkim vremenom rada (i tako često oslobađanje
CPU) i nekoliko dugih zadataka koji koriste CPU celo vreme svog rada, pri čemu
vreme odziva za takve zadatke nije važno. Time se može napraviti prvi pokušaj
implementacije algoritma MLFQ s sledećim pravilima:
- Rule3: Kada zadatak uđe u sistem, postavlja se u red s najvišim
- prioritetom.
- Rule4a: Ako zadatak iskoristi celo određeno vremensko okno, tada se
- njegov prioritet smanjuje.
- Rule4b: Ako zadatak oslobodi CPU pre isteka svog vremenskog okna, tada
- ostaje s istim prioritetom.
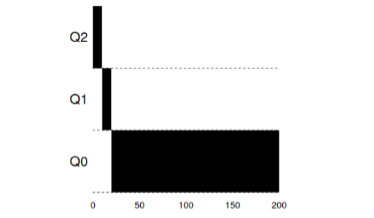
Primer 1: Pojedinačni dugotrajni zadatak
Kao što se može videti u ovom primeru, zadatak se prilikom ulaska postavlja s najvišim
prioritetom. Nakon vremenskog okna od 10 ms, proces se smanjuje po prioritetu
od strane planera. Nakon sledećeg vremenskog okna, zadatak se konačno smanjuje do
najnižeg prioritetа u sistemu, gde ostaje.
Primer 2: Pojava kratkog zadatka
Sada ćemo pogledati primer kako će MLFQ pokušati da se približi SJF-u. U ovom
primeru su dva zadatka: A, koji je dugotrajni zadatak koji stalno
koristi CPU i B, koji je kratki interaktivni zadatak. Pretpostavimo da
je A već radio neko vreme kada je zadatak B stigao.
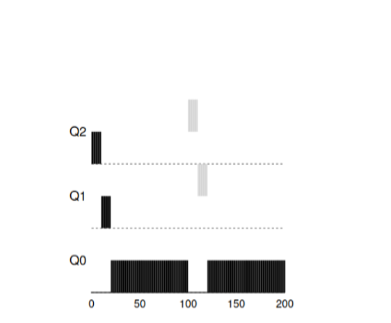
Na ovom grafiku su prikazani rezultati scenarija. Zadatak A, kao i svaki zadatak,
koji koristi CPU našao se na samom dnu. Zadatak B će stići u trenutku T=100 i biće
postavljen u red s najvišim prioritetom. Pošto je vreme njegovog rada kratko, on
će se završiti pre nego što dostigne poslednji red.
Iz ovog primera možemo razumeti glavnu svrhu algoritma: pošto algoritam ne
zna da je zadatak dug ili kratak, prvo pretpostavlja da je zadatak
kratak i daje mu najviši prioritet. Ako je to zaista kratak zadatak, onda
će se brzo izvršiti, inače, ako je to dug zadatak, polako će napredovati
nizom prioriteta i uskoro će dokazati da je to doista dug zadatak koji ne
zahteva odgovor.
Primer 3: Šta je sa unosom i izvozom?
Sada pogledajmo primer sa unosom i izvozom. Kao što je navedeno u pravilu 4b,
ako proces oslobađa procesor, ne koristeći potpuno svoje vreme procesora,
onda ostaje na prethodnom nivou prioriteta. Namena ovog pravila je prilično jednostavna
— ako interaktivni zadatak vrši mnogo operacija ulaza-izlaza, na primer, čekajući
na pritiske tastera ili miša od korisnika, takav zadatak će ranije osloboditi procesor
u odabranom okviru. Ne bismo želeli da smanjimo prioritet takvog zadatka,
pa će tako ostati na prethodnom nivou.
Ovaj primer pokazuje kako će algoritam raditi sa takvim procesima — interaktivni zadatak B, koji treba CPU samo na 1ms pre izvršenja
procesa ulaza-izlaza i dug zadatak A, koji koristi CPU sve vreme.
MLFQ drži proces B sa najvišim prioritetom, jer neprekidno oslobodi
CPU. Ako je B interaktivni zadatak, onda algoritam u tom slučaju ostvaruje
svoj cilj brzo pokrećući interaktivne zadatke.
Problemi sa trenutnim algoritmom MLFQ
U prethodnim primerima izgradili smo osnovnu verziju MLFQ. I čini se da dobro
obavlja svoj posao, pošteno raspoređujući vreme procesora među
dugim zadacima i omogućavajući brze izvršavanje kratkih zadataka ili zadataka koji intenzivno koriste
ulaz-izlaz. Nažalost, ovaj pristup sadrži nekoliko
ozbiljnih problema.
Prvo, problem gladi: ako u sistemu postoji mnogo interaktivnih
zadataka, oni će iskoristiti sve vreme procesora i nijedan dug
zadataka neće imati priliku da se izvrši (gladuju).
Drugo, pametni korisnici bi mogli pisati svoje programe na način da
prevari raspoređivač. Prevara leži u tome da se uradi nešto što bi nateralo
raspoređivač da dodeli procesu više vremena procesora. Algoritam koji
opisao navedeno je potpuno ranjivo na slične napade: pre nego što vreme gotovo
iscrpi, potrebno je izvršiti operaciju ulaza-izlaza (na neku, nije važno koju datoteku)
i na taj način osloboditi CPU. Ovakvo ponašanje omogućava zadržavanje u istoj
prioritetnoj redosledu i ponovo sticanje većeg procenta procesorskog vremena. Ako se to
uradi ispravno (na primer, izvršavati 99% vremena pre oslobađanja CPU-a),
takav zadatak može jednostavno monopolizovati procesor.
Na kraju, program može menjati svoje ponašanje tokom vremena. One zadatke,
koji su koristili CPU, mogu postati interaktivni. U našem primeru slični
zadaci neće dobiti odgovarajuće tretiranje od planer, kao što bi dobili drugi
(izvorni) interaktivni zadaci.
Pitanje za publiku: koje napade na planer bi mogli sprovesti u savremenom svetu?
Pokušaj 2: Povećanje prioriteta
Pokušaćemo da promenimo pravila i vidimo da li možemo izbjeći probleme sa
gladovanjem. Šta bismo mogli učiniti kako bismo garantovali da zadaci vezani za
CPU dobiju svoje vreme (čak i ako ne dugo).
Kao jednostavno rešenje ovog problema, može se predložiti povremeno
povećavanje prioriteta svih takvih zadataka u sistemu. Postoji mnogo načina
da se to postigne, pokušaćemo da realizujemo nešto jednostavno: prebaciti
sve zadatke odmah u najviši prioritet, odakle novo pravilo:
- Rule5: Nakon određenog perioda S prebaciti sve zadatke u sistemu u najvišu redosled.
Naše novo pravilo rešava dva problema odjednom. Prvo, procesi
garantovano ne gladuju: zadaci koji se nalaze u najvišoj redosledu deliće
procesorsko vreme u skladu sa RR algoritmom, i na taj način će svi procesi dobiti
procesorsko vreme. Drugo, ako neki proces, koji je ranije koristio
samo procesor, postane interaktivan, on će ostati u redu sa višim
prioritetom nakon što jednom dobije povećanje prioriteta do najvišeg.
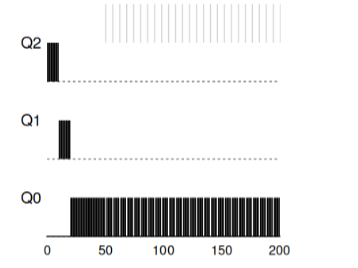
Razmotrimo primer. U ovom scenariju razmatramo jedan proces koji koristi
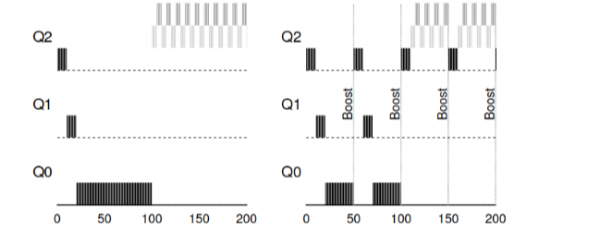
CPU i dva interaktivna, kratka procesa. Slika lijevo prikazuje ponašanje bez povećanja prioriteta, tako da dugačka zadaća počinje gladovati nakon što u sistem stignu dva interaktivna zadatka. Slika desno prikazuje da se svake 50ms izvršava povećanje prioriteta, i tako svi procesi garantirano dobijaju procesorsko vrijeme i periodično se pokreću. 50ms je ovdje uzeto kao primjer, u stvarnosti je ovo broj nešto veći.
Očigledno je da dodavanje vremena periodičnog povećanja S dovodi do
zaključnog pitanja: koja vrijednost bi trebala biti postavljena? Jedan od cijenjenih
sistemskih inženjera John Ousterhout nazivao je slične veličine u sistemima voo-doo
konstantama, jer su nekako zahtijevale crnu magiju za pravilno
postavljanje. I, nažalost, S ima takav miris. Ako se postavi vrijednost prevelikom,
duge zadaće počinju gladovati. A ako se postavi previše niska vrijednost,
interaktivne zadaće neće dobiti dovoljno procesorskog vremena.
Pokušaj 3: Bolje praćenje
Sada imamo još jedan problem koji treba riješiti: kako ne
dopustiti da prevarimo naš planificador? Krivci za ovu mogućnost su
pravila 4a, 4b, koja omogućavaju zadatku da zadrži prioritet, oslobađajući procesor
do isteka dodijeljenog vremena. Kako se nositi s tim?
Rješenje u ovom slučaju može biti bolje praćenje CPU vremena na svakom
nivou MLFQ. Umjesto da zaboravimo vrijeme koje je program koristio
procesor u dodijeljenom vremenskom okviru, treba ga pratiti i sačuvati. Nakon što
proces potroši dodijeljeno mu vrijeme, njegov prioritet treba smanjiti na sljedeći
nivo prioriteta. Sada nije važno kako proces koristi svoje vrijeme — kao
stalno računa na procesoru ili kao mnoštvo poziva. Tako da,
pravilo 4 treba prepisati u sljedeći oblik:
- Pravilo 4: Nakon što je zadatak potrošio dodijeljeno mu vrijeme u trenutnoj redu (bez obzira koliko je puta oslobodio CPU), prioritet takvog zadatka se smanjuje (premješta se niže u redu).
Pogledajmo primjer:
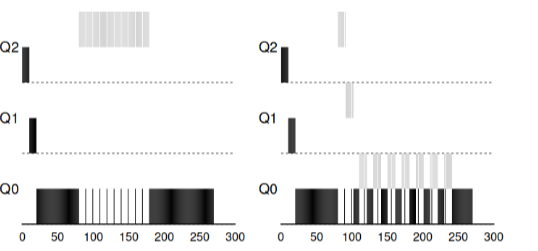 »
Na slici je prikazano šta se događa kada pokušamo prevariti planificador, kao
ako bi se primenila prethodna pravila 4a, 4b, rezultat bi bio sa leve strane. Sa novim
pravilo — rezultat je sa desne strane. Pre zaštite mogla je bilo koja operacija izazvati I/O do završetka i
tako dominirati CPU-om, nakon aktivacije zaštite, bez obzira na ponašanje
I/O, ona će se i dalje spuštati u redove i stoga neće moći nepošteno
zauzeti resurse CPU-a.
Poboljšavamo MLFQ i druga pitanja
Sa navedenim poboljšanjima javljaju se novi problemi: jedno od glavnih
pitanja je kako parametriti ovaj planificador? T.j. Koliko bi trebalo da bude
redova? Kolika bi trebala biti veličina radnog okna unutar reda? Kako
često treba podizati prioritet programa kako bi se izbeglo gladovanje i
uzeti u obzir promenu ponašanja programa? Na ova pitanja nema jednostavnog
odgovora, i samo eksperimenti sa opterećenjima i potonje konfiguriranje
planera mogu dovesti do nekog zadovoljavajućeg balansa.
Na primer, većina implementacija MLFQ omogućava dodavanje različitih
vremenskih intervala različitim redovima. Visokoprioritetnim redovima obično
se dodeljuju kratki intervali. Ovi redovi se sastoje od interaktivnih zadataka,
prebacivanje između kojih je prilično osetljivo i trebalo bi da traje 10 ili manje
ms. U suprotnosti, niskoprioritetni redovi se sastoje od dugih zadataka koji koriste
CPU. U ovom slučaju, dugi vremenski intervali su veoma pogodni (100ms).
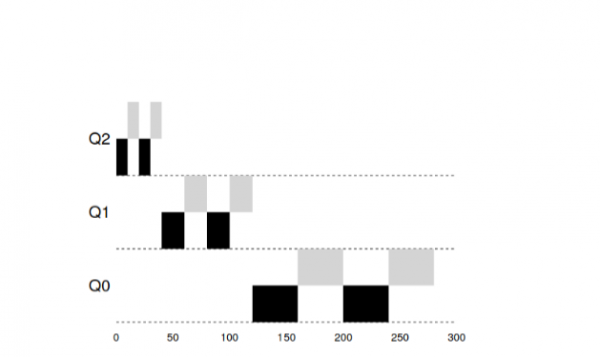
U ovom primeru postoje 2 zadatka koja su radila u visokoprioritetnom redu 20
ms, podeljenih na prozore od 10ms. 40ms u srednjem redu (prozorsko vreme od 20ms) i u niskoprioritetnom
redu prozorsko vreme postalo je 40ms, gde su zadaci završili svoj rad.
Implementacija MLFQ u OS Solaris — klasa planera koji deli vreme.
Planer pruža skup tabela koje precizno definišu kako bi trebalo
da se menja prioritet procesa tokom njegovog života, koja bi trebala biti veličina
dodeljenog okna i kako često treba podizati prioritete zadatka. Administrator
sistema može interagovati sa ovom tabelom i prisiliti planera da se ponaša
drugačije. Po defaultu u ovoj tabeli ima 60 redova sa postepenim povećanjem
veličine prozora od 20ms (visok prioritet) do nekoliko stotina ms (nizak prioritet), a
također s pojačavanjem svih zadataka jednom u sekundi.
Drugi MLFQ zakazivači ne koriste tabelu ili specifična
pravila opisana u ovoj lekciji, naprotiv, oni izračunavaju prioritete koristeći
matematičke formule. Tako, na primjer, zakazivač u FreeBSD-u koristi formulu za
izračunavanje trenutnog prioriteta zadatka, temeljen na tome koliko je proces
koristio CPU. Pored toga, korištenje CPU tokom vremena opada, i tako
povećanje prioriteta događa se pomalo drugačije nego što je opisano iznad. To su
takozvani decay algoritmi. Od verzije 7.1 u FreeBSD-u koristi se zakazivač ULE.
Na kraju, mnogi zakazivači imaju druge karakteristike. Na primjer, neki
zakazivači rezervišu više nivoe za rad operativnog sistema i tako
nijedan korisnički proces neće moći dobiti najviši prioritet u
sistemu. Neki sistemi omogućavaju davanje saveta kako bi pomogli
zakazivaču pravilno postaviti prioritete. Tako, na primjer, pomoću komande nice
možete povećati ili smanjiti prioritet zadatka, čime povećavate ili
smanjujete šanse programa za procesorsko vreme.
MLFQ: Rezime
Opisali smo pristup zakazivanju koji se naziva MLFQ. Njegovo ime
proizlazi iz načina rada — ima nekoliko redova i koristi povratne informacije
za određivanje prioriteta zadatka.
Konačni izgled pravila biće sledeći:
- Rule1: Ako prioritet(A) > Prioritet(B), biće pokrenut zadatak A (B neće)
- Rule2: Ako prioritet(A) = Prioritet(B), A i B se pokreću koristeći RR
- Rule3: Kada zadatak dođe u sistem, smeštena je u red s najvišim prioritetom.
- Pravilo 4: Nakon što je zadatak potrošio dodijeljeno mu vrijeme u trenutnoj redu (bez obzira koliko je puta oslobodio CPU), prioritet takvog zadatka se smanjuje (premješta se niže u redu).
- Rule5: Nakon određenog perioda S prebaciti sve zadatke u sistemu u najvišu redosled.
MLFQ je zanimljiv iz sledećeg razloga — umesto da zahteva znanje o
prirodi zadatka unapred, algoritam proučava prethodno ponašanje zadatka i postavlja
prioritete shodno tome. Tako pokušava da sedi na dva stolca — postići performanse za male zadatke (SJF, STCF) i pošteno pokrenuti duge,
CPU-intenzivne zadatke. Zbog toga mnogi sistemi, uključujući BSD i njihove derivante,
Solaris, Windows, Mac koriste kao zakazivač neku formu algoritma
MLFQ kao osnovnu osnovu.
Dodatni materijali:
- (computing)
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish