

Želeo bih da pričam o novom CLI alatu koji sam napisao za rešenje jednog starog problema.
Problem
Terraform je već dugo standard u DevOps/Cloud/IT zajednici. To je veoma zgodan i koristan alat za rad sa infrastrukturom kao kodom. Ima mnogo prednosti, ali i mnogo izazova i zamki.
Sa Terraformom je veoma lako raditi nove stvari i upravljati njima, menjati ili brisati. A šta je sa onima koji imaju ogromnu infrastrukturu u oblaku koja nije kreirana putem Terraforma? Prepisivanje i ponovno kreiranje cele infrastrukture u oblaku je skupo i rizično.
Sreo sam se sa ovim problemom na dva posla, najjednostavniji primer je kada želite da sve bude u Gitu u obliku Terraform fajlova, a imate 250+ bucket-a, pa pisanje istih za Terraform ručno je prosto previše posla.
Postoji još od 2014. godine u Terraform-u koji je zatvoren 2016. godine, nadajući se da će doći do moguće uvoza.
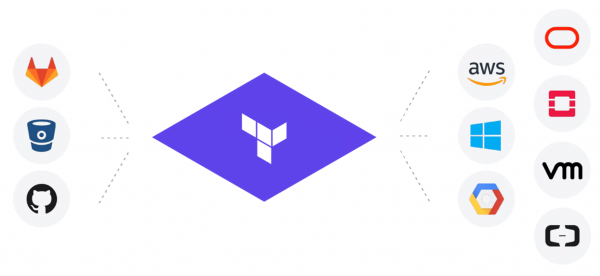
U suštini, sve je kao na slici, samo s desna na levo.
Upozorenje: Autor većinu života ne živi u Rusiji i malo piše na ruskom. Budite oprezni sa pravopisnim greškama.
Rešenja
1. Postoje stara i gotova rešenja za AWS. . Kada sam pokušavao da dobijem svojih 250+ bucket-a preko njega, shvatio sam da je sve loše. AWS već dugo dodaje mnogo novih opcija, a terraforming o njima ne zna i uopšte je u Ruby-ju. . Nakon 2 večeri, poslao sam da dodam više mogućnosti i shvatio da to rešenje nije uopšte odgovarajuće.
Kako terraforming funkcioniše? Uzimaju podatke iz AWS SDK-a i generišu tf i tfstate putem šablona.
Tu su 3 problema:
1. Uvek će biti kašnjenja u ažuriranjima.
2. tf fajlovi ponekad izlaze oštećeni.
3. tfstate se prikuplja odvojeno od tf-a i ne podudara se uvek.
U suštini, teško je dobiti rezultat pri kojem `terraform plan` kaže da nema izmena.
2. `terraform import` — ugrađena komanda u Terraformu. Kako funkcioniše?
Pišete prazan TF fajl sa imenom i vrstom resursa, zatim pokrećete `terraform import` i prosledite ID resursa. Terraform se obraća provajderu, dobija podatke i pravi tfstate fajl.
Tu su 3 problema:
1. Dobijamo samo tfstate fajl, dok je tf prazan koji treba ručno napisati ili konvertovati iz tfstate-a.
2. Može raditi samo sa jednim resursom svaki put i ne podržava sve resurse. A šta da radim sa 250+ bucket-a?
3. Morate znati ID resursa — što znači da treba obaviti to u kodu koji dobija listu resursa.
U suštini, rezultat je delimičan i loše se skalira.
Moje rješenje
Zahtevi:
1. Mogućnost stvaranja tf i tfstate datoteka na osnovu resursa. Na primjer, preuzeti sve bačve/security group/load balancer i što `terraform plan` vraća da nema promjena
2. Potrebna su 2 oblaka GCP + AWS
3. Globalno rješenje koje se lako ažurira svaki put, bez trošenja vremena na svaki resurs po 3 dana rada
4. Napraviti open source – to je problem koji svi imaju
Jezik Go – zato ga volim, i postoji biblioteka za stvaranje HCL datoteka koja se koristi u terraformu + mnogo koda u terraformu koji može biti koristan
Put
Prvi pokušaj
Počeo sam s jednostavnom opcijom. Oslanjanje na oblak putem SDK-a za potrebni resurs i konverzija u polja za terraform. Pokušaj je odmah propao na security group jer mi se nije svidjelo 1,5 dana konvertirati samo security group (a resursa ima mnogo). Dugotrajno je i polja se mogu mijenjati/dodavati
Drugi pokušaj
Zasnovano na ideji opisanoj . Samo uzeti i konvertovati tfstate u tf. Svi podaci su tu i polja su ista. Kako dobiti puni tfstate za mnogo resursa?? Ovdje je pomogla komanda `terraform refresh`. Terraform uzima sve resurse u tfstate-u i po ID-u izvlači podatke i piše sve u tfstate. Dakle, stvoriti prazan tfstate samo s imenima i ID-ima, pokrenuti `terraform refresh` i dobijamo potpuni tfstate. Ura!
Sad ćemo se pozabaviti rekurzivnim pisanjem konvertora za tfstate u tf. Za one koji nikada nisu čitali tfstate, to je JSON, ali poseban.
Evo njegove važne dijela attributes
 "attributes": {
                            "id": "default/backend-logging-load-deployment",
                            "metadata.#": "1",
                            "metadata.0.annotations.%": "0",
                            "metadata.0.generate_name": "",
                            "metadata.0.generation": "24",
                            "metadata.0.labels.%": "1",
                            "metadata.0.labels.app": "backend-logging",
                            "metadata.0.name": "backend-logging-load-deployment",
                            "metadata.0.namespace": "default",
                            "metadata.0.resource_version": "109317427",
                            "metadata.0.self_link": "/apis/apps/v1/namespaces/default/deployments/backend-logging-load-deployment",
                            "metadata.0.uid": "300ecda1-4138-11e9-9d5d-42010a8400b5",
                            "spec.#": "1",
                            "spec.0.min_ready_seconds": "0",
                            "spec.0.paused": "false",
                            "spec.0.progress_deadline_seconds": "600",
                            "spec.0.replicas": "1",
                            "spec.0.revision_history_limit": "10",
                            "spec.0.selector.#": "1",
Evo šta imamo:
1. id — string
2. metadata — niz veličine 1 i u njemu objekt s poljima koji su opisani u nastavku
3. spec — hash veličine 1 i u njemu key,value
Ukratko, zabavan format, sve može ići u dubinu na nekoliko nivoa
                   "spec.#": "1",
                            "spec.0.min_ready_seconds": "0",
                            "spec.0.paused": "false",
                            "spec.0.progress_deadline_seconds": "600",
                            "spec.0.replicas": "1",
                            "spec.0.revision_history_limit": "10",
                            "spec.0.selector.#": "1",
                            "spec.0.selector.0.match_expressions.#": "0",
                            "spec.0.selector.0.match_labels.%": "1",
                            "spec.0.selector.0.match_labels.app": "backend-logging-load",
                            "spec.0.strategy.#": "0",
                            "spec.0.template.#": "1",
                            "spec.0.template.0.metadata.#": "1",
                            "spec.0.template.0.metadata.0.annotations.%": "0",
                            "spec.0.template.0.metadata.0.generate_name": "",
                            "spec.0.template.0.metadata.0.generation": "0",
                            "spec.0.template.0.metadata.0.labels.%": "1",
                            "spec.0.template.0.metadata.0.labels.app": "backend-logging-load",
                            "spec.0.template.0.metadata.0.name": "",
                            "spec.0.template.0.metadata.0.namespace": "",
                            "spec.0.template.0.metadata.0.resource_version": "",
                            "spec.0.template.0.metadata.0.self_link": "",
                            "spec.0.template.0.metadata.0.uid": "",
                            "spec.0.template.0.spec.#": "1",
                            "spec.0.template.0.spec.0.active_deadline_seconds": "0",
                            "spec.0.template.0.spec.0.container.#": "1",
                            "spec.0.template.0.spec.0.container.0.args.#": "3",
Ako želiš zadatak iz programiranja za razgovor za posao, samo pitaj da napišu parser za ovo 🙂
Nakon dugih pokušaja da napišem parser bez grešaka, pronašao sam deo koda u terraform-u, zapravo najvažniji deo. I sve je izgledalo normalno.
Pokušaj tri
Terraform provider su binarne datoteke koje sadrže kod sa svim resursima i logikom za rad sa API-jem oblaka. Svaka cloud platforma ima svoj provider, a terraform ih poziva putem svog RPC protokola između dva procesa.
Sada sam odlučio da se obraćam direktno terraform providerima putem RPC poziva. Izašlo je lepo i omogućilo mi promenu terraform providera na novije verzije i dobijanje novih mogućnosti bez promene koda. Takođe, otkrio sam da ne polja u tfstate-u ne moraju biti u tf-u, a kako to saznati? Samo pitati provider o tome. Onda je počela još jedna rekurzivna borba sa sastavljanjem regularnih izraza za pronalaženje polja unutar tfstate-a na svim nivoima u dubinu.
Na kraju je ispalo korisno CLI alatka koja ima zajedničku infrastrukturu za sve terraform providere i lako se može dodati novi. Takođe, dodavanje resursa zahteva malo koda. Plus, razne pogodnosti poput povezivanja između resursa. Naravno, bilo je mnogo raznih problema koji se svi ne mogu opisati.
Nazvao sam alat Terrafomer.
Finale
Pomoću Terrafomer-a generisali smo 500-700 hiljada linija tf + tfstate koda iz dva oblaka. Uspešno smo uzeli legat stvari i počeli da ih dodirujemo samo preko terrafoma, kao u najboljim idejama infrastrukture kao koda. Jednostavno čarolija kada uzmete ogroman oblak i dobijete ga putem komande u obliku radnih terraform fajlova. A zatim grep/replace/git itd.
Sredio sam i doveo u red, dobio dozvole. Objavio na GitHubu za sve u četvrtak (02.05.19).
Već sam dobio 600 zvezdica, 2 pull request-a za dodavanje podrške za OpenStack i Kubernetes. Dobrim ocjenama. Uopšte, projekat je koristan za ljude.
Preporučujem svima koji žele da počnu da rade sa Terraform-om a da ne prepisuju sve zbog toga.
Biću srećan zbog pull request-a, problema, zvezdica.
Demo
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish