

Definicija DevOps-a je vrlo složena, pa se zbog toga svaki put ponovo pokreće diskusija o tome. Samo na Habr-u postoji hiljade objava na ovu temu. Ali ako ovo čitate, sigurno znate šta je DevOps. Zato što ja - nemam pojma. Zdravo, ja sam Aleksandar Titov (@), i mi ćemo samo razgovarati o DevOps-u i podeliti svoje iskustvo.
Dugo sam razmišljao kako da moj izlaganje bude korisno, zato će ovde biti puno pitanja - ona koja sam sebi postavljao i ona koja postavljam klijentima naše kompanije. Odgovaranjem na ta pitanja, razumevanje postaje bolje. Pričaću zašto je DevOps potreban iz mog ugla, šta to zapravo jeste, opet iz mog stava, i kako shvatiti da se približavate DevOps-u, opet iz mog ugla. Poslednja stavka biće kroz pitanja. Odgovarajući na njih samom sebi, moći ćete da shvatite da li vaša kompanija ide ka DevOps-u ili ima nekih problema.
Nekoliko vremena sam se bavio talasima spajanja i akvizicija. Prvo sam radio u malom startapu Qik, a zatim ga je kupila malo veća kompanija Skype, koju je potom kupila još malo veća kompanija Microsoft. U tom trenutku sam stekao uvid u to kako se predstava o DevOps-u transformiše u različitim veličinama kompanija. Nakon toga sam počeo da gledam na DevOps iz perspektive tržišta, i zajedno s kolegama organizovali smo kompaniju Ekspress 42. Već 6 godina plovimo na tim talasima tržišta.
Osim svega toga, ja sam jedan od organizatora zajednice DevOps Moscow i organizator DevOps -Days 2017, ali 2018. nisam organizovao. Ekspress 42 radi s mnogim kompanijama. Tamo razvijamo DevOps, gledamo kako to funkcioniše, izvodimo zaključke, analiziramo, delimo svoja zapažanja svima, obučavamo ljude zatevama DevOps praksi. U suštini, pokazujemo iskustvo i ekspertizu u ovom smislu.
Zašto DevOps
Prvo pitanje koje progonja sve i uvek - zašto? Mnogi smatraju da je DevOps samo automatizacija ili nešto slično, što je već postojalo u svakoj kompaniji.
— Imali smo Continuous Integration — znači, već je postojao DevOps, i zašto nam treba svo ovo muke? Tamo vani se zabavljaju, a nama ometaju rad!
Tokom 9 godina razvoja zajednice i metodologije postalo je jasno da to ipak nisu marketinjske šminke, ali još uvijek nije do kraja jasno zašto je potreban. Kao i svaki alat i proces, DevOps ima konkretne ciljeve koje na kraju ostvaruje.
Sve to je povezano s time da se svet menja. Odlazi od pristupa preduzeća, kada kompanije odmah krenu ka snu, kako je pevao naš stari klasik iz Petrograda, iz tačke A u tačku B prema određenoj strategiji, sa izgrađenom posebnom strukturom za to.
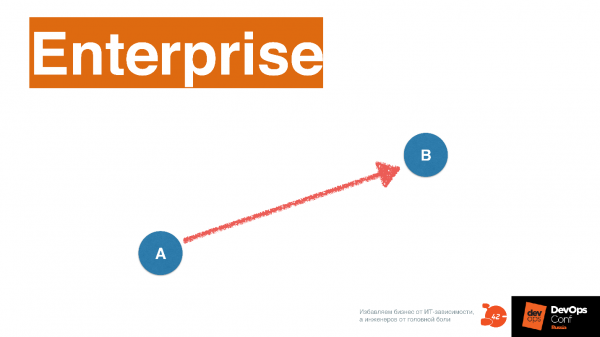
U principu, IT sve i treba da bude postavljen prema ovom pristupu. Ovde se IT koristi isključivo za automatizaciju procesa.
Automatizacija se ne menja često, jer kada kompanija ide utabanim putem — šta da menjate? Ako radi — ne diraj. Sada se u svetu pristupi menjaju, i onaj koji se naziva Agile govori o tome da konačne tačke B odmah nije vidljivo.
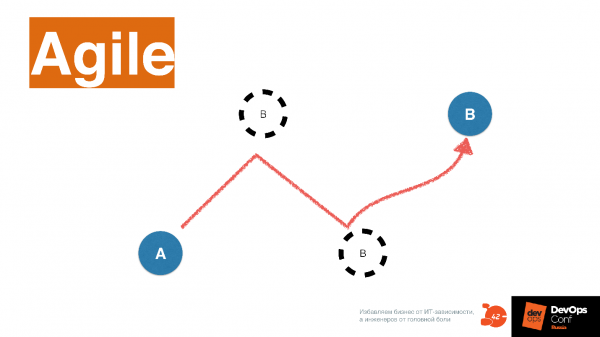
Kada kompanija ide kroz tržište, radi sa klijentom — stalno istražuje tržište i menja konačnu tačku B. Što češće kompanija menja svoj pravac, to je više na kraju uspešna, jer bira više tržišnih niša.
Strategiju demonstrira zanimljiva kompanija o kojoj sam nedavno saznao. One Box Shave – usluga dostave brijača i pribora za brijanje po pretplati u kutiji. Oni znaju da prilagode svoju 'kutiju' za različite klijente. Time se bavi određeni softver koji zatim šalje narudžbinu na korejsku fabriku koja proizvodi robu.
Ovaj proizvod je kupila kompanija Unilever za 1 milijardu dolara. Sada se takmiči sa Gillette-om i uzela mu značajan deo potrošača na američkom tržištu. One Box Shave kažu:
— 4 sečiva? Ozbiljno? Zašto vam to treba — to nikako ne poboljšava kvalitet brijanja. Specijalno odabrani krem, miris i kvalitetan brijač sa dva sečiva rešavaju mnogo više pitanja nego ta budalasta 4 sečiva Gillette-a! Tako ćemo ubrzo stići do 10?
Tako se svet menja. Unilever tvrde da imaju sjajan IT sistem koji to omogućava. Na kraju to izgleda kao koncept Time-to-market, o kojem je već ko samo nije pričao.
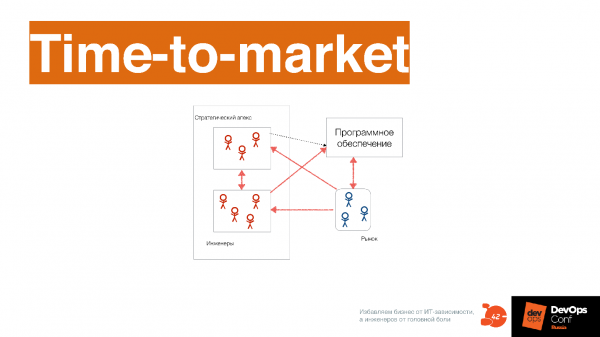
Smisao Time-to-market nije u tome koliko često obavljamo deploy. Moguće je često izvoditi deploy, ali uz to će ciklusi objavljivanja biti dugi. Ako se trogodišnji ciklusi objavljivanja postavljaju jedan na drugi, pomjerajući ih po nedelju, dolazi do toga da kao da se kompanija izvodi deploy jednom nedeljno. A od ideje do konačne realizacije prolazi tri meseca.
Time-to-market je o minimizaciji vremena od ideje do konačne realizacije.
U ovom slučaju softver se direktno povezuje s tržištem. Tako sa klijentom komunicira sajt One Box Shave. Nemaju prodavce - samo sajt na kojem posetilac klikne i ostavlja želje. Stoga, na sajtu je potrebno stalno postavljati nešto novo, ažurirati ga prema željama. Na primer, u Južnoj Koreji se brijaju drugačije nego u Rusiji, i sviđa im se miris ne borovine, već na primer, karamelizovanih šargarepa.
Pošto je potreban brzi menadžment sadržaja sajta, razvoj softvera se drastično menja. Kroz softver moramo saznati šta klijent želi. Nekada smo to saznali nekim zaobilaznim putem, na primer, kroz poslovno upravljanje. Zatim smo projektovali, unosili zahteve u IT sistem, i sve je bilo odlično. Sada je drugačije - softver projektuje svako ko je uključen u proces, uključujući inženjere, jer saznaju kroz tehničke specifikacije kako tržište funkcioniše i takođe dele svoje uvide sa biznisom.
Na primer, u kompaniji Qik smo iznenada saznali da ljudima jako prija da otpremaju kontakt liste na server, i dodali su nam funkcionalnost. Isprva o tome nismo razmišljali. U klasičnoj firmi svi bi smatrali da je to greška, jer u specifikacijama nije napisano da bi to trebalo dobro da funkcioniše, i uopšte je realizovano ad-hoc, isključili bi tu funkciju i rekli: 'To nikome nije potrebno, najvažnije je da osnovna funkcionalnost radi.' A tehnološka kompanija u tome vidi priliku i počinje da menja softver u skladu s tim.
Godine 1968. pronicljiv momak Melvin Conway formulisao je sledeću ideju.
Organizacija koja stvara sistem je ograničena dizajnom koji replicira strukturu komunikacije u toj organizaciji.
Ako želite više detalja, da biste razvili sisteme drugog tipa, morate imati i komunikacijsku strukturu unutar kompanije drugog tipa. Ako imate hijerarhijsku komunikacijsku strukturu, to neće omogućiti izgradnju sistema koji mogu obezbediti veoma visok vremenski okvir Time-to-market.
Pročitajte može . On je važan za razumevanje kulture ili filozofije DevOps-a, jer jedina osnovna stvar koja se menja u DevOps-u je upravo struktura komunikacije između timova..
Sa stanovišta procesa, pre DevOps-a sve faze: analitika, razvoj, testiranje, eksploatacija, prolazile su linearno.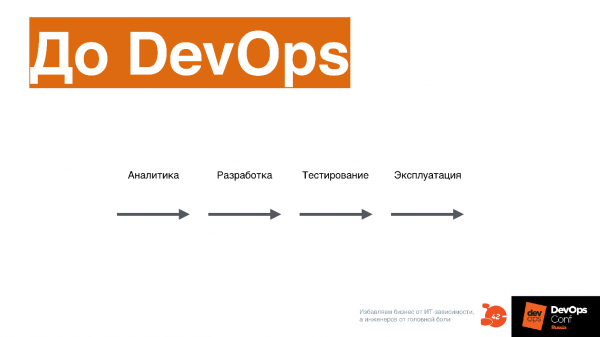
U slučaju DevOps-a, svi ti procesi se odvijaju istovremeno.
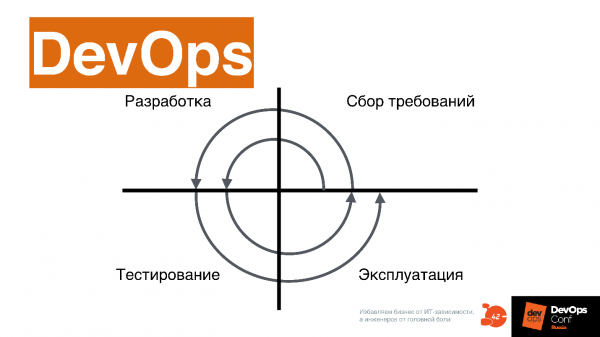
Time-to-market se može ostvariti samo tako. Za ljude koji su radili u starom procesu, ovo deluje pomalo ekstravagantno, i uopšte nije lako.
Zašto je DevOps potrebna?
Za razvoj digitalnih proizvoda. Ako u vašoj kompaniji nema digitalnog proizvoda, DevOps nije potreban — ovo je veoma važno.
DevOps prevazilazi brzinske limite linearne sheme proizvodnje softvera. U njemu se svi procesi odvijaju istovremeno.
Povećava se složenost. Kada DevOps evangelisti pričaju da će vam sa njim biti lakše da puštate softver — to je besmislica.
Sa DevOps-om će sve biti samo složenije.
Na konferenciji na štandu Avita moglo se videti šta znači deploy-ovati Docker kontejner — nerealna zadaća. Složenost postaje neizmerna, morate žonglirati sa mnogo lopti u isto vreme.
DevOps potpuno menja proces i organizaciju u kompaniji — tačnije, ne menja DevOps, već digitalni proizvod. Da biste došli do DevOps-a, ipak morate da promenite ceo proces.
Pitanja za stručnjaka
A šta je sa vama? Pitanja koja možete sebi postaviti, radeći u kompaniji i razvijajući se kao stručnjak.
Imate li strategiju za kreiranje digitalnog proizvoda? Ako imate — već je dobro. To znači da vaša kompanija ide ka DevOps-u.
Da li vaša kompanija već stvara digitalni proizvod? To znači da možete napredovati još više, baviti se zanimljivijim poslovima — s stanovišta DevOps-a, opet. O tome samo govorim.
Da li je vaša kompanija jedan od lidera na tržištu u niši sa digitalnim proizvodom? Spotify, Yandex, Uber – kompanije koje se trenutno nalaze na vrhuncu tehnološkog napretka.
Postavite sebi ova pitanja, i ako su svi odgovori negativni, možda ne bi trebalo da se bavite DevOps-om u ovoj kompaniji. Međutim, ako vas tema DevOps stvarno interesuje, možda biste trebali da pređete u drugu kompaniju? Ako vaša kompanija želi da pređe na DevOps, ali ste na sva pitanja odgovorili 'Ne', onda podseća na divnog nosoroška koji nikada neće da se promeni.
Organizacija
Kao što sam već rekao, prema zakonu Conway-a, organizacija unutar kompanije se menja. Počeću od onoga što ometa DevOps da prodre u samu suštinu kompanije, posebno u kontekstu organizacije.
Problem 'silosâ'
Engleska reč 'silo' ovde je prevedena kao 'kolodet'. Suština ovog problema je da nema razmene informacija između timova.Svaki tim kopa svoju ekspertizu duboko, ne gradeći zajedničku mapu prema kojoj se može orijentisati.
To podseća na osobu koja je tek stigla u Moskvu i još ne zna kako se orijentisati po metro karti. Moskovljani obično savršeno poznaju svoj kvart, dok se po celoj Moskvi orijentišu prema metrou. Kada prvi put stignete u Moskvu, nemate tu veštinu, i jednostavno ste dezorijentisani.
DevOps nudi da prođe kroz ovaj trenutak dezorijentacije i da sve jedinice zajedno izgrade zajedničku mapu saradnje.
Dva faktora otežavaju ovo.
Posledica korporativnog sistema upravljanja. Izgrađena je kao odvojeni hijerarhijski 'silos'. Na primer, postoje određeni KPI-evi u kompanijama koji podržavaju ovaj sistem. S druge strane, teškoće dolaze od ljudi koji imaju problema da izađu van svoje ekspertize i orijentišu se unutar celokupnog sistema. To jednostavno nije prijatno. Zamislite da ste u Bangkoku - tamo se brzo ne možete orijentisati. U DevOps-u je takođe teško orijentisati se, zbog čega ljudi govore da je potrebno naći vodiča da biste tamo došli.
Ali najvažnije je to što problem 'silosâ' za inženjera koji je usvojio duh DevOps-a, pročitao Fowlers i brojne druge knjige, manifestuje se u tome da 'silos'i ne dopuštaju da se urade 'očigledne' stvari.Često se okupljamo posle DevOps Moskovskog događaja, razgovaramo jedni s drugima, a ljudi se žale:
— Htjeli smo jednostavno pokrenuti CI, a ispalo je da menadžmentu to nije potrebno.
To se događa upravo zbog toga što CI i Proces kontinuirane isporuke nalaze se na granici mnogih ekspertiza. Samo ne prevazišavši problem "bunara" na organizacionom nivou, nećete moći napredovati, bez obzira što radili i koliko to tužno bilo.
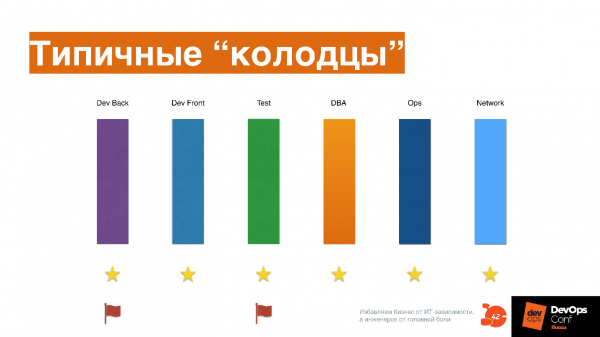
Svaki učesnik u procesu u kompaniji: backend i frontend programeri, testiranje, DBA, održavanje, mreža, kopa u svoju stranu, a niko osim menadžera koji ih nekako promatra i upravlja metodom "deliti i vladati" nema zajedničku kartu.
Ljudi se bore za neke zvezdice ili zastavice, svako kopaju svoju ekspertizu.
Na kraju, kada se pojavi zadatak sve to spojiti zajedno i više se ne boriti za zvezdice i zastavice, postavlja se pitanje - a šta raditi? Moramo se nekako dogovoriti, a kako to učiniti, niko nas u školi nije učio. Još iz škole smo naučeni: osmi razred - vau! - u poređenju sa sedmim! Ovde je isto.
Da li je tako i u vašoj kompaniji?
Da biste to proverili, možete sebi postaviti sledeća pitanja.
Da li timovi koriste zajedničke alate, doprinose li u promene tih zajedničkih alata?
Koliko često se timovi reorganizuju - jedni stručnjaci iz jednog tima prelaze u drugi tim? Upravo u DevOps okruženju to postaje normalno, jer ponekad osoba jednostavno ne može razumeti čime se bavi druga oblast ekspertize. Prelazi u drugi odeljak, radi dve nedelje tamo kako bi stvorila kartu orijentacije i interakcije s tim odeljenjem.
Može li se formirati komisija za promene i nešto promeniti? Ili je za to potrebna jaka ruka najvišeg rukovodstva i naređenje? Nedavno sam napisao na Facebook-u kako jedna malo poznata banka sprovodi alate kroz naređenja: napisali su naređenje, godinu dana implementiramo, gledamo šta se dešava. To, naravno, traje dugo i tužno.
Koliko je važna za menadžere dobijanje ličnih dostignuća bez obzira na dostignuća kompanije?
Ako odgovorite na ta pitanja, biće jasnije imate li taj problem u kompaniji.
Infrastruktura kao kod
Nakon što se ova problematika reši, prva važna praksa bez koje je teško napredovati u DevOps-u je infrastruktura kao kod.
Najčešće se infrastruktura kao kod shvata tako:
— Dajmo da sve automatizujemo putem bash-a, oblepljujemo se skriptama, kako bi administratori imali manje ručnog rada!
Ali to nije tako.
Infrastruktura kao kod podrazumeva da IT sistem koji koristite opisujete kao kod, kako biste stalno razumeli njeno stanje.
Zajedno s drugim timovima kreirate mapu u obliku koda koja je svima razumljiva, prema kojoj se može orijentisati, navigirati. Nema razlike na čemu je to urađeno — Chef, Ansible, Salt, ili se koriste YAML fajlovi u Kubernetes-u — nije bitno.
Na konferenciji je kolega iz 2GIS-a govorio o tome kako su napravili sopstvenu alatku za Kubernetes koja opisuje uređaj pojedinačnih sistema. Da bi opisali 500 sistema, potrebni su im bili posebni alati koji generišu ove opise. Kada postoji ovaj opis, svako može da se upoređuje, prati promene, kako ih izmeniti i poboljšati, i šta im nedostaje.
Slažete se, pojedinačni bash skripti obično ne daju ovo razumevanje. U jednoj od firmi u kojima sam radio, čak je postojalo ime „write only” skript - kada je skripta napisana, a čitati je više nije moguće. Mislite da vam je to poznato.
Infrastruktura kao kod je kod koji opisuje aktuelno stanje infrastrukture. Na ovom kodu zajedno radi mnogo produktivnih, infrastrukturnih i servisnih timova, i što je najvažnije, svi oni treba da razumeju kako ovaj kod uopšte funkcioniše.
Kod se prati u skladu sa najboljim praksama rada sa kodom: zajednička izrada, kod-proveravanje, XP-programiranje, testiranje, pull request-i, CI za infrastrukturni kod — sve to je korisno i može se koristiti.
Kod postaje zajednički jezik za sve inženjere.
Izmena infrastrukture u kodu ne traje dugo. Da, u infrastrukturalnom kodu takođe može postojati tehnički dug. Obično timovi se suočavaju s njim nekih godinu i po nakon što su počeli da primenjuju „infrastrukturu kao kod” u obliku gomile skripti ili čak Ansible-a, koje pišu kao spaghetti kod, i još bash skripte dodaju u to!
Važno: ako još niste probali ovu glupost, zapamtite da Ansible nije bash! Pažljivo čitajte dokumentaciju, istražujte šta se zapravo o tome piše.
Infrastruktura kao kod je razdvajanje infrastrukturnog koda na odvojene slojeve.
U našoj kompaniji ističemo 3 osnovna sloja, koja su vrlo jasna i jednostavna, ali ih može biti više. Možete pogledati svoj infrastrukturni kod i reći da li imate ovaj kriterijum ili ne. Ako se nijedan sloj ne ističe, potrebno je odvojiti vreme i malo refaktorisati.
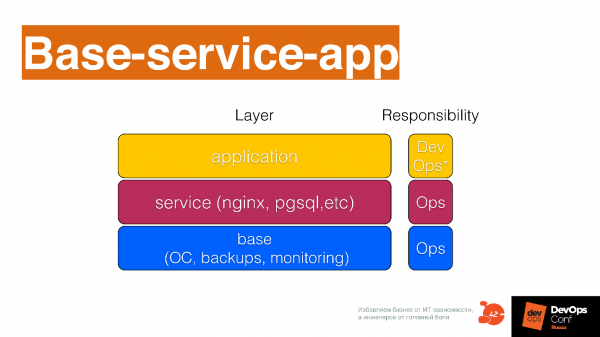
Osnovni sloj je kao što se podešava OS, backup i druge niskonivojske stvari, kao što se na osnovnom nivou implementira Kubernetes.
Sloj servisa su ti servisi koje pružate programerima: logovanje kao servis, monitoring kao servis, baza podataka kao servis, balansiranje opterećenja kao servis, red kao servis, kontinuirana isporuka kao servis - gomila servisa koje različiti timovi mogu pružiti razvoju. Sve to treba opisati kao odvojene module u vašem sistemu za upravljanje konfiguracijom.
Sloj gde se prave aplikacije i opisuje se kako će se deployovati iznad dva prethodna sloja.
Kontrolna pitanja
Da li imate zajednički infrastrukturni repozitorijum? Da li kontrolišete tehnički dug u infrastrukturi? Da li koristite razvojne prakse u infrastrukturnom repozitorijumu? Da li je vaša infrastruktura podeljena na slojeve? Možete proveriti prema šemi Base-service-APP. Koliko je teško napraviti izmenu?
Ako ste se susreli sa situacijom da je unos promena trajao jedan i po dan, to znači da imate tehnički dug i treba ga obraditi. Upravo ste naišli na prepreke tehničkog duga u infrastrukturnom kodu. Sećam se mnogo priča kada je za promenu nekog CCTL-a bilo potrebno prepisati polovinu infrastrukturnog koda, jer je kreativnost i želja za automatizacijom dovela do toga da je svuda sve zakompikovano, svi alati su uklonjeni, i treba refaktorisati.
Kontinuirana isporuka
Sažet ćemo debit i kredit. Prvo se pojavljuje opis infrastrukture, koji može biti prilično osnovan. Nije potrebno sve detaljno opisivati, ali neki osnovni opis je potreban kako biste mogli raditi s tim. Inače, nije jasno na kojoj osnovi da dalje radite neprekidnu isporuku. Sve ove prakse se odvijaju istovremeno kada pređete na DevOps, ali treba početi s razumevanjem onoga što imate i kako njime upravljati. To je upravo praksa infrastruktura kao kod.
Nakon što ste shvatili šta imate i kako njime upravljati, počinjete smišljati kako kod programera maksimalno brzo poslati u produkciju. Mislim na to zajedno s programerom - setimo se problema „bunara“, odnosno nisu to pojedinačni ljudi koji to smišljaju, već tim.
Kada smo s Vanejom Jevtuhovičem videli prvu knjigu Džez Hembla i grupa autora „Continuous Delivery“, koja je objavljena 2009. godine, dugo smo razmišljali kako prevesti njen naziv na srpski jezik. Hteli smo da prevedemo kao „Stalno isporučivanje“, ali, nažalost, preveli smo kao „Neprekidna isporuka“. Čini mi se da u našem nazivu ima nešto rusko, s nabojem.
Stalno isporučivati znači
Kod koji leži u proizvodnom repozitorijumu uvek može biti poslat u produkciju. Može biti i ne poslato, ali uvek je spremno za to. Shodno tome, uvek pišete kod s teško objašnjivim osećajem određenog uzrujanosti u području donjeg dela leđa. To osećanje određene uzrujanosti treba da bude prisutno - ono pokreće misaone procese koji omogućavaju pisanje koda malo drugačije. To se mora zabeležiti u pravilima unutar razvoja.
Da biste stalno isporučivali, potreban je format artefakta koji prolazi kroz infrastrukturnu platformu. Ako na infrastrukturnu platformu šaljete različite formate „otpada životne aktivnosti“, onda postaje neuniformisana, te je teško održavati, javlja se problem tehnološkog duga. Format artefakta treba uskladiti - to je takođe kolektivni zadatak: svi se zajedno treba okupiti, malo razmišljati i smisliti taj format.
Artefakt se kontinuirano poboljšava i mijenja pod proizvodnim okruženjem tokom prolaska kroz pipeline isporuke. Kada artefakt prolazi kroz pipeline, stalno se susreće s neugodnim stvarima koje su slične onim koje artefakt susreće kada ga postavite u proizvodnju. Dok se u klasičnoj razvijanju time bavi sistemski administrator koji vrši isporuku, u DevOps procesu to se dešava neprekidno: ovde su ga testirali, ovde su ga stavili u Kubernetes klaster koji je donekle sličan proizvodnji, ovde su iznenada pokrenuli test opterećenja.
To pomalo podsjeća na igru Pac-Man – artefakt prolazi kroz neku priču. Važno je kontrolirati da li kod stvarno prolazi kroz priču i da li je to nekako povezano s vašom proizvodnjom. Priče iz proizvodnje mogu se unijeti u proces Kontinuirane isporuke: bilo je tako kada je nešto puklo, sada hajde da ovaj scenario jednostavno programiramo u sistem. Svaki put, kod će prolaziti kroz ovaj scenario takođe, i nećete se sledeći put susresti s ovim problemom. Saznaćete za njega mnogo ranije nego što dođe do vašeg klijenta.
Različite strategije isporuke. Na primjer, koristite AB testiranje ili kanarinе isporuke da biste različito testirali kod na različitim klijentima, dobili informacije o tome kako kod radi, i to mnogo ranije nego kada bude isporučen 100 miliona korisnicima.
"Kontinuirana isporuka" izgleda ovako.
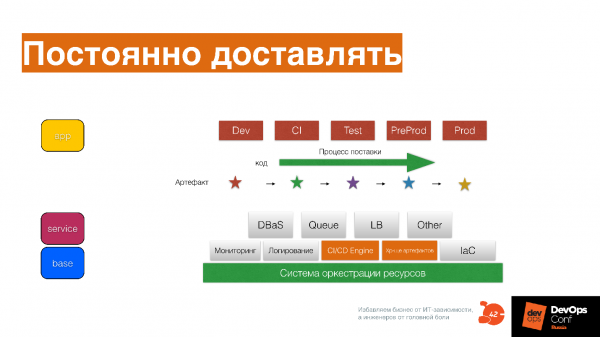
Proces isporuke Dev, CI, Test, PreProd, Prod – to nije odvojeno okruženje, to su stejdži ili stanice s nesagorelim sumama kroz koje prolazi vaš artefakt.
Ako imate infrastrukturni kod koji je opisan kao Base Service APP, on pomaže da ne zaboravite sve scenarije, i zapišete ih takođe u obliku koda za ovaj artefakt, promovišete artefakt i menjate ga tokom kretanja.
Pitanja za samoproveru
Da li je vreme od opisa funkcionalnosti do isporuke u proizvodnju u 95% slučajeva kraće od nedelju dana? Da li se kvalitet artefakta poboljšava na svakoj fazi pipeline-a? Da li postoji priča kroz koju prolazi? Koristite li različite strategije isporuke?
Ako su svi odgovori da, onda ste neverovatno dobri! Napišite odgovore u komentarima - biću srećan).
Povratne informacije
Ovo je najteža praksa od svih. Na konferenciji DevOpsConf, kolega iz Infobipa, govoreći o tome, malo se mučio s rečima, jer je to zaista veoma složena praksa koja zahteva da se prati sve!
Na primer, davno, kada sam radio u Qik-u i shvatili smo da treba da pratimo sve. To smo uradili, i u Zabbix-u smo imali 150.000 stavki koje se neprekidno prate. Bilo je zastrašujuće, tehnički direktor je vrtio prstom na sljepoočnici:
— Ljudi, zašto maltretirate server nečim što je nejasno?
Ali onda se desila situacija koja je pokazala da je ovo zaista odlična strategija.
Jedan od servisa je počeo neprekidno da se ruši. Isprva se nije rušio, zanimljivo je da se kod tamo nije menjao, jer je to bio osnovni broker koji je praktično nemao poslovne funkcionalnosti – samo je prenosi poruke između različitih servisa. Služba se nije menjala 4 meseca, i odjednom je počela da se ruši s greškom „Segmentation fault“.
Bili smo u šoku, otvorili smo naše grafike u Zabbix-u, i otkrili da se, ispostavilo se, pre nekih nedelju i po dana drastično promenilo ponašanje zahteva u API-servisu koji koristi ovaj broker. Potom smo pogledali da li se promenila učestalost slanja određenog tipa poruka. Kasnije smo saznali da su to android-klijenti. Pitali smo:
— Ljudi, šta se kod vas desilo pre nedelju i po dana?
U odgovoru smo čuli zanimljivu priču o tome da su prepravili UI. Verovatno niko odmah ne bi rekao da je promenio HTTP-biblioteku. Za android-klijente je to kao promeniti sapun u kupatilu – jednostavno to ne pamte. Na kraju, nakon 40 minuta razgovora, saznali smo da su ipak promenili HTTP-biblioteku, i promenili su se podrazumevani tajming. To je dovelo do promene ponašanja saobraćaja na API serveru, što je kasnije izazvalo situaciju koja je rezultirala trkom unutar brokera, i on je počeo da se ruši.
Bez dubokog nadgledanja ovo bi bilo potpuno nemoguće otkriti.. Međutim, ako u organizaciji postoji još jedan problem s "bunovima", kada se svi prebacuju jedni na druge, to može trajati godinama. Samo restartujete server jer je nemoguće rešiti problem. Kada pratite, beležite i nadgledate sve događaje koje imate, i koristite monitoring kao testiranje — pišete kod i odmah ukazujete kako ga nadgledati, takođe u vidu koda (već imamo infrastrukturu kao kod), sve postaje jasno kao na dlanu. Čak i tako složeni problemi se lako prate.
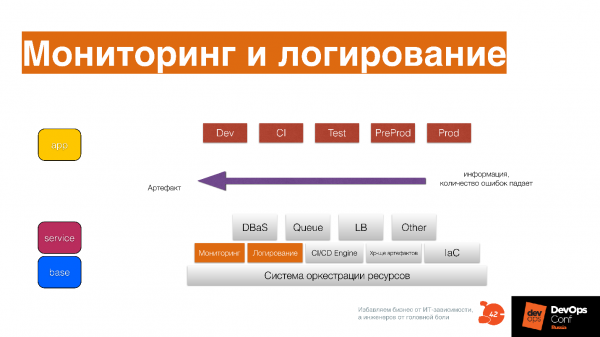
Prikupljajte sve informacije o tome šta se dešava s artefaktom na svakoj fazi procesa isporuke — ne u produkciji.
Monitoring prebacite na CI, i tamo će se već videti neke osnovne stvari. Dalje ćete ih videti i u Test, i u PredProd, i u opterećenju testiranju. Prikupljajte informacije na svim fazama, ne samo metrike i statistike, već i logove: kako je aplikacija implementirana, anomalije — prikupite sve.
U suprotnom, biće teško razjasniti. Već sam rekao da je DevOps veća složenost. Da biste se nosili s ovom složenošću, potrebno je imati dobru analitiku..
Pitanja za samoproveru
Da li je vaš monitoring i logovanje sredstvo razvoja za vas? Da li vaši programeri, pa i vi, kada pišete kod, razmišljate o tome kako ga nadgledati?
Saznajete li o problemima od klijenata? Razumete li klijenta bolje iz monitoringa i logovanja? Razumete li sistem bolje iz monitoringa i logovanja? Menjate li sistem samo zato što ste primetili da trend u sistemu raste i razumete da će za još 3 nedelje sve propasti?
Kada imate ova tri komponente, možete razmišljati o tome kakva vam je infrastruktura u kompaniji.
Infrastrukturna platforma
Smisao nije u tome da je to skup razbacanih alata koji postoje u svakoj kompaniji.
Smisao infrastrukturne platforme je u tome da sve ekipe koriste ove alate i zajednički ih razvijaju.
Jasno je da postoje odvojene ekipe koje su odgovorne za razvoj određenih delova infrastrukturne platforme. Ali, odgovornost za razvoj, funkcionisanje i promovisanje infrastrukturne platforme leži na svakom inženjeru. Na unutarnjem nivou to postaje zajednički alat.
Sve ekipe razvijaju infrastrukturnu platformu, odnoseći se prema njoj kao prema vlastitom IDE-u. U svom IDE-u postavljate različite dodatke kako bi sve izgledalo lepo i brzo, podešavate prečice. Kada otvorite Sublime, Atom ili Visual Studio Code, suočavate se s greškama u kodu i shvatate da je rad postao gotovo nemoguć, odmah postajete tužni i žurite da popravite svoj IDE.
Isto tako se odnosite prema svojoj infrastrukturnoj platformi. Ako shvatite da nešto nije u redu, ostavite zahtev, ako ne možete sami popraviti. Ako je u pitanju nešto jednostavno – ispravite sami, pošaljite pull request – tim će to razmotriti i dodati. Ovo je donekle drugačiji pristup inženjerskom alatu u glavama programera.
Infrastrukturna platforma omogućava prenos artefakta od razvoja do klijenta s stalnim poboljšanjem kvaliteta. U IP-u je programiran skup priča koje se dešavaju s kodom u produkciji. Tokom godina razvoja, ovih priča postaje veoma puno, neke od njih su jedinstvene i odnose se samo na vas – ne mogu se pronaći putem pretrage.
U tom trenutku infrastrukturna platforma postaje vaša konkurentska prednost, jer sadrži ono što konkurentski alat nema. Što je vaša IP dublja, to je veća vaša konkurentska prednost u smislu Time-to-market. Ovde se pojavljuje problem vendor lock: možete koristiti tuđu platformu, ali korišćenjem tuđeg iskustva nećete razumeti koliko je to relevantno za vas. Da, ne može svaka kompanija izgraditi platformu poput Amazona. Ovo je složena granica gde je iskustvo kompanije relevantno njenoj poziciji na tržištu, i ne bi se smelo dozvoliti vendor lock. O tome takođe treba razmisliti.
Dijagram
Ovo je osnovna shema infrastrukturne platforme koja će vam pomoći da uspostavite sve prakse i procese u DevOps kompaniji.
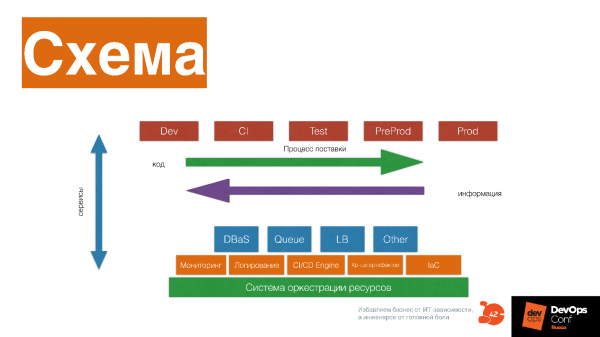
Pogledajmo iz čega se sastoji.
Sistem orkestracije resursa, koji obezbeđuje CPU, memoriju, disk aplikacijama i drugim servisima. Iznad toga su niskonivojski servisi: nadgledanje, logovanje, CI/CD Engine, skladište artefakata, infrastruktura kao kod sistema.
Servisi višeg nivoa: baza podataka kao servis, redovi kao servis, Load Balance kao servis, promjena veličine slika kao servis, Big Data fabrika kao servis. Iznad toga — pipeline koji neprekidno isporučuje modificirani kod vašem klijentu.
Dobijate informacije o tome kako vaše softver radi kod klijenta, menjate, ponovo isporučujete taj kod, dobijate informacije — i tako stalno razvijate i infrastrukturnu platformu i vaše softver.
Na planu, delivery pipeline se sastoji od mnogih faza. Ali to je principijelna shema koja je navedena kao primer — ne treba je ponavljati jedan na jedan. Faze komuniciraju sa servisima kao sa servisima — svaki blok platforme nosi svoju priču: kako se resursi dodeljuju, kako se aplikacija pokreće, kako radi sa resursima, kako se nadgleda i menja.
Važno je razumeti da svaka deo platforme nosi priču, i pitati se — koju priču nosi ovaj blok, možda ga treba odbaciti i zameniti spoljim servisom. Na primer, može li se umesto bloka postaviti Okmeter? Moguće je da su momci već razvili ovu stručnost mnogo više nego mi. Ali možda i nije — možda imamo jedinstvenu stručnost, trebamo postaviti Prometheus i razvijati to dalje.
Kreiranje platforme
To je složen komunikacijski proces. Kada imate osnovne prakse, pokrećete komunikaciju između različitih inženjera i stručnjaka, koji razvijaju zahteve i standarde, i stalno ih menjaju prema različitim alatima i pristupima. Ovde je važna kultura koja postoji u DevOps-u.
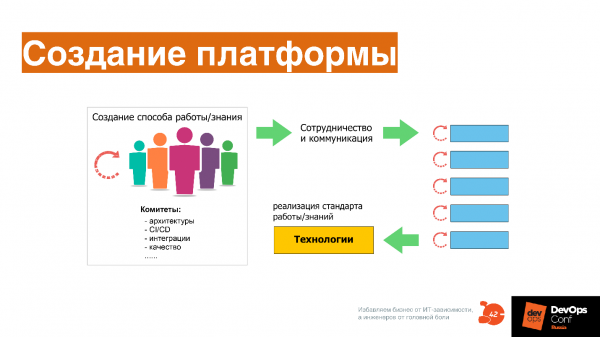
Sa kulturom je sve vrlo jednostavno — to je saradnja i komunikacija, znači želja da se radi u zajedničkom prostoru jedni s drugima, želja da se zajedno ovlada jednim alatom. Ovde nema nikakve raketne nauke — sve je vrlo jednostavno, banalno. Na primer, svi mi živimo u zgradi i održavamo je čistom — to je taj nivo kulture.
A šta je sa vama?
Ponovo pitanja koja možete postaviti sebi.
Da li je infrastrukturna platforma jasno odvojena? Ko je odgovoran za njen razvoj? Razumete li konkurentske prednosti svoje infrastrukturne platforme?
Ova pitanja treba stalno postavljati sebi. Ako nešto možete prebaciti na spoljne servise — treba to uraditi; ako spoljašnji servis počne da blokira vaš rad, treba izgraditi sistem unutar sebe.
Dakle, DevOps…
… to je složen sistem, u kojem treba da budu:
- Digitalni proizvod.
- Poslovni moduli koji razvijaju ovaj digitalni proizvod.
- Produktne timove koji pišu kod.
- Prakse neprekidne isporuke.
- Platforme kao usluga.
- Infrastruktura kao usluga.
- Infrastruktura kao kod.
- Posebne prakse održavanja pouzdanosti, ugrađene unutar DevOps-a.
- Praktika povratne informacije koja sve to opisuje.
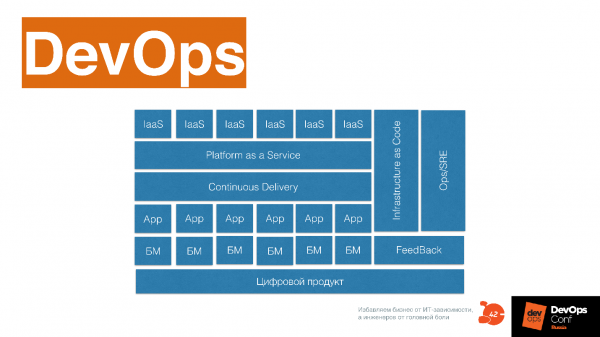
Možete koristiti ovu shemu, obeležavajući ono što već imate u kompaniji u nekom obliku: to se razvilo ili još treba razviti.
Već za par nedelja . u okviru RIT++. Dođite na konferenciju, gde vas čeka mnogo sjajnih predavanja o neprekidnoj isporuci, infrastrukturi kao kod i DevOps transformaciji. , poslednji rok za cene je 20. maja
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish