

Godine 2017. dobili smo konkurs za razvoj transakcionog jezgra investicionog poslovanja Alfa-Banke i počeli smo rad (na HighLoad++ 2018 sa izlaganjem o jezgru investicionog poslovanja Vladimir Dryinkin, vođa sektora transakcionog jezgra investicionog poslovanja Alfa-Banke). Ovaj sistem trebao je da agregira podatke o transakcijama iz različitih izvora u različitim formatima, prilagođava ih u jedinstveni oblik, čuva ih i obezbeđuje pristup njima.
Tokom razvoja sistem je evoluirao i obogaćivao se funkcionalnostima, i u nekom trenutku shvatili smo da se kristalizuje nešto mnogo veće od običnog aplikativnog softvera, napravljenog za rešavanje strogo definisanog skupa zadataka: stvorili smo sistem za izgradnju distribuiranih aplikacija sa peristentnim skladištem. Stečeno iskustvo postalo je osnova novog proizvoda — (TDG).
Želim da pričam o arhitekturi TDG i rešenjima do kojih smo došli tokom razvoja, da vas upoznam sa osnovnim funkcionalnostima i pokažem kako naš proizvod može poslužiti kao osnova za izgradnju potpunih rešenja.
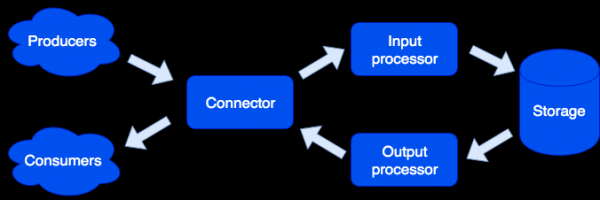
Arhitektonski smo podelili sistem na posebne uloge, od kojih je svaka odgovorna za rešavanje određenog skupa zadataka. Jedan pokrenuti primerak aplikacije ostvaruje jedan ili više tipova uloga. U klasteru može biti nekoliko uloga istog tipa:
Connector
Connector je odgovoran za vezu s vanjskim svetom; njegova je dužnost da primi zahtev, analizirati ga, a ako to uspe, pošalje podatke na obradu u input processor. Podržavamo formate HTTP, SOAP, Kafka, FIX. Arhitektura omogućava jednostavno dodatno podržavanje novih formata, uskoro će biti dodana podrška za IBM MQ. Ako analiza zahteva završi greškom, connector će vratiti grešku; u suprotnom, odgovoriće da je zahtev obrađen uspešno, čak i ako je došlo do greške u njegovoj daljoj obradi. Ovo je učinjeno namerno, kako bi se radilo sa sistemima koji ne znaju ponovo slati zahteve — ili obrnuto, rade to previše uporno. Da se ne bi gubili podaci, koristi se popravna red: objekat prvo ulazi u nju i samo nakon uspešne obrade se uklanja iz nje. Administrator može dobijati obaveštenja o objektima koji su ostali u popravnom redu, a nakon otklanjanja programske greške ili hardverskog kvara može pokušati ponovo.
Input processor
Input processor klasifikuje primljene podatke prema karakterističnim obeležjima i poziva odgovarajuće obradnike. Obradnici su kod u jeziku Lua, koji se izvršava u peskovniku, tako da ne mogu uticati na funkcionisanje sistema. U ovoj fazi podaci se mogu oblikovati u željeni oblik, a po potrebi pokrenuti proizvoljan broj zadataka koji mogu implementirati potrebnu logiku. Na primer, u MDM (Master Data Management) proizvodu, koji se bazira na Tarantool Data Grid, prilikom dodavanja novog korisnika, da ne bismo usporili obradu zahteva, kreiranje zlatne evidencije pokrećemo kao poseban zadatak. Peskovnik podržava zahteve za čitanje, menjanje i dodavanje podataka, omogućava izvršavanje određene funkcije na svim ulogama tipa storage i agregaciju rezultata (map/reduce).
Obradnici se mogu opisati u datotekama:
sum.lua

local x, y = unpack(...)
return x + y
I zatim, deklarisani u konfiguraciji:
functions:
  sum: { __file: sum.lua }
Zašto Lua? Lua je vrlo jednostavan jezik. Na osnovu našeg iskustva, posle nekoliko sati upoznavanja s njim, ljudi počinju da pišu kod koji rešava njihov zadatak. I to ne samo profesionalni programeri, već i, na primer, analitičari. Pored toga, zahvaljujući JIT kompajleru, Lua radi vrlo brzo.
Skladište
Skladište čuva trajne podatke. Prije spremanja, podaci se validiraju prema shemi podataka. Za opis sheme koristimo prošireni format . Primer:
{
    "name": "User",
    "type": "record",
    "logicalType": "Aggregate",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "first_name", "type": "string"},
        {"name": "last_name", "type": "string"}
    ],
    "indexes": ["id"]
}
Na osnovu ovog opisa automatski se generira DDL (Jezik za definiciju podataka) za DBMS Tarantool i shema za pristup podacima.
Podržava se asinkrona replikacija podataka (u planu je dodavanje sinhrone).
Obradni procesor
Ponekad je potrebno obavijestiti vanjske potrošače o dolasku novih podataka, za to postoji uloga Obradni procesor. Nakon što se podaci pohrane, mogu se prenijeti u odgovarajući obradi (na primjer, kako bi ih prilagodili potrebama potrošača) — i zatim se šalju u konektor za slanje. Ovdje se također koristi popravna kvačica: ako objekt niko ne prihvati, administrator može kasnije ponovo pokušati.
Skaliranje
Uloge konektora, ulaznog procesora i izlaznog procesora nemaju stanje, što nam omogućava horizontalno skaliranje sistema jednostavnim dodavanjem novih instanci aplikacije s uključenom ulogom potrebnog tipa. Za horizontalno skaliranje skladišta koristi se organizaciji klastera korištenjem virtuelnih kanti. Nakon dodavanja novog servera, dio kanti sa starih servera u pozadini se premješta na novi server; to se događa transparentno za korisnike i ne utiče na rad cijelog sistema.
Svojstva podataka
Objekti mogu biti veoma veliki i sadržavati druge objekte. Osiguravamo atomskost dodavanja i ažuriranja podataka, čuvajući objekat sa svim zavisnostima u jednom virtuelnom kantui. Tako se isključuje 'razmazivanje' objekta po nekoliko fizičkih servera.
Podržava verzionisanje: svaka ažuriranje objekta stvara novu verziju, i uvek možemo napraviti vremenski preseče i videti kako je svet izgledao tada. Za podatke kojima nije potrebna duga istorija, možemo ograničiti broj verzija ili čak čuvati samo jednu — poslednju, što zapravo isključuje verzionisanje za određenu vrstu. Takođe možemo ograničiti istoriju po vremenu: na primer, brisati sve objekte određene vrste starije od 1 godine. Podržava se i arhiviranje: možemo izvoziti objekte starije od određenog vremena, oslobađajući mesto u klasteru.
Zadaci
Od zanimljivih funkcija, treba istaći mogućnost pokretanja zadataka po rasporedu, na zahtev korisnika ili programski iz peskovnika:
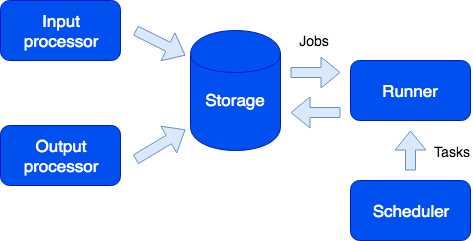
Ovde vidimo još jednu ulogu — runner. Ova uloga nema stanje, i po potrebi je moguće dodati dodatne instance aplikacije sa ovom ulogom u klaster. Odgovornost runn-а je izvršenje zadataka. Kao što je rečeno, iz peskovnika je moguće generisati nove zadatke; oni se čuvaju u redu na storage-u i zatim se izvršavaju na runneru. Ova vrsta zadatka se zove Job. Takođe imamo vrstu zadatka zvanog Task — to su zadaci koje definiše korisnik i pokreće ih po rasporedu (koristi se cron sintaksa) ili na zahtev. Za pokretanje i praćenje takvih zadataka imamo praktičan menadžer zadataka. Da bi ova funkcionalnost bila dostupna, potrebno je aktivirati ulogu scheduler; ova uloga ima stanje, stoga se ne skalira, što zapravo nije potrebno; pri tome, kao i sve ostale uloge, može imati replikat, koja počinje da funkcioniše ukoliko master iznenada otkaže.
Logger
Još jedna uloga se zove logger. Ona prikuplja logove sa svih članova klastera i pruža interfejs za njihovo izvođenje i pregled kroz vebu interfejs.
Servisi
Treba napomenuti da sistem omogućava lako kreiranje servisa. U konfiguracionom fajlu možete navesti koje zahteve usmeriti na korisnikom napisani handler, koji se izvršava u peskovniku. U ovom handleru možete, na primer, izvršiti neki analitički zahtev i vratiti rezultat.
Servis se opisuje u konfiguracionom fajlu:
services:
   sum:
      doc: "sabira dve broja"
      function: sum
      return_type: int
      args:
         x: int
         y: int
GraphQL API se automatski generira i servis postaje dostupan za pozive:
query {
   sum(x: 1, y: 2)
}
To će dovesti do poziva obradnika sum, koji će vratiti rezultat:
3
Profiliranje upita i metrike
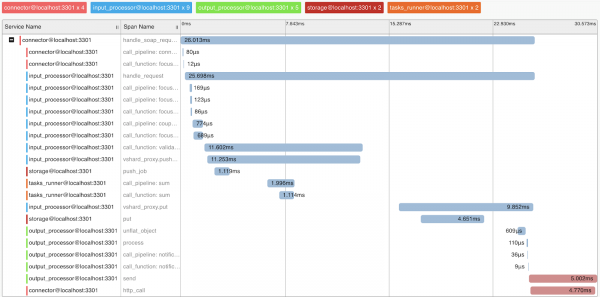
Za razumevanje rada sistema i profiliranje upita implementirali smo podršku za OpenTracing protokol. Sistem može, na zahtev, slati informacije alatima koji podržavaju ovaj protokol, poput Zipkin-a, što omogućava razumevanje kako je upit izvršen:
Naravno, sistem pruža interne metrike koje se mogu prikupljati pomoću Prometheus-a i vizualizovati koristeći Grafana.
Deploy
Tarantool Data Grid može se implementirati iz RPM paketa ili arhive, pomoću alata iz paketa ili Ansible-a, takođe postoji podrška za Kubernetes ().
Aplikacije koje implementiraju poslovnu logiku (konfiguracija, obrada) učitavaju se u implementirani klaster Tarantool Data Grid u obliku arhive putem UI-a ili pomoću skripte, kroz naš pruženi API.
Primjeri aplikacija
Koje aplikacije se mogu kreirati pomoću Tarantool Data Grid? U suštini, većina poslovnih zadataka na razne načine je povezana sa obradom podataka, njihovim skladištenjem i pristupom. Dakle, ako imate velike tokove podataka koje treba pouzdano skladištiti i imati pristup, naš proizvod može vam uštedeti mnogo vremena na razvoju i omogućiti vam da se fokusirate na svoju poslovnu logiku.
Na primer, želimo prikupiti informacije o tržištu nekretnina kako bismo na kraju imali podatke o najpovoljnijim ponudama. U tom slučaju, istakli bismo sledeće zadatke:
- Roboti koji prikupljaju informacije iz otvorenih izvora biće naši izvori podataka. Ovaj zadatak možete rešiti koristeći gotova rešenja ili pisanjem koda na bilo kojem jeziku.
- Nakon toga, Tarantool Data Grid će primiti i sačuvati podatke. Ako se format podataka iz različitih izvora razlikuje, možete napisati kod na jeziku Lua koji će izvršiti konverziju u jedinstven format. Tokom preliminarne obrade takođe možete, na primer, filtrirati ponavljajuće ponude ili dodatno ažurirati podatke u bazi o agentima koji rade na tržištu.
- Sada već imate skalabilno rešenje u klasteru koje možete popuniti podacima i izvoditi upite. Dalje, možete implementirati novu funkcionalnost, na primjer, napisati servis koji će napraviti upit ka podacima i dati najpovoljniju ponudu za dan — to će zahtevati nekoliko redova u konfiguracionom fajlu i malo koda na Lua.
Šta dalje?
Naš prioritet je povećanje pogodnosti razvoja putem . Na primjer, to je IDE s podrškom za profilisanje i debagovanje handler-a koji rade u sandbox-u.
Takođe, veliki naglasak stavljamo na pitanja bezbednosti. Baš sada prolazimo sertifikaciju FSTEK-a Rusije kako bismo potvrdili visok nivo bezbednosti i ispunili zahteve za sertifikaciju softverskih proizvoda koji se koriste u informacionim sistemima ličnih podataka i državnim informacionim sistemima.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish