

To je mit koji je prilično rasprostranjen u oblasti serverskog hardvera. U praksi su hiperkonvergirana rešenja (kada je sve u jednog) potrebna iz mnogo razloga. Istorijski je nastalo da su prve arhitekture razvijene od strane Amazona i Googlea za njihove usluge. Tada je ideja bila da se napravi računska farmi od identičnih čvorova, od kojih svaki ima svoje diskove. Sve je to povezano nekim sistemskim softverom (hipervizorom) i razbijeno na virtuelne mašine. Glavni zadatak je minimalni napor na održavanju jednog čvora i minimalni problemi prilikom skaliranja: jednostavno se dokupi još hiljadu ili dve takvih servera i povežu se zajedno. U praksi su to jedinstveni slučajevi, a mnogo češće se radi o manjem broju čvorova i malo drugačijoj arhitekturi.
Ali prednost ostaje ista — neverovatna jednostavnost skaliranja i upravljanja. Nedostatak — različiti zadaci različito koriste resurse, i negde će lokalnih diskova biti mnogo, negde malo RAM-a i tako dalje, to jest kod različitih tipova zadataka će se smanjivati iskorišćenost resursa.
Ispostavilo se da plaćate 10–15% više za jednostavnost podešavanja. To je i izazvalo mit iz naslova. Dugo smo tražili gde će se tehnologija optimalno primeniti, i pronašli smo. Naime, Cisco nije imao svoje SAN-ove, ali želeo je potpunu tržišnu ponudu servera. I napravili su Cisco Hyperflex — rešenje sa lokalnim skladištima na nodovima.
A iz toga je iznenada proizašlo veoma dobro rešenje za rezervne data centre (Disaster Recovery). Zašto i kako — sada ću objasniti. I pokazati testove klastera.
Gde je potrebno
Hiperkonvergencija — to je:
- Premeštanje diskova u računarske čvorove.
- Potpuna integracija podsystema skladištenja podataka sa podsystemom virtualizacije.
- Premeštanje/integracija sa mrežnim podsystemom.
Ova povezanost omogućava implementaciju mnogih funkcija SAN-a na nivou virtualizacije i sve iz jednog prozora za upravljanje.
U našoj kompaniji su veoma traženi projekti za projektovanje rezervnih DC-ova, a često se bira upravo hiperkonvergentno rešenje zbog mnoštva opcija za replikaciju (do metroklastera) koje dolaze iz kutije.
U slučaju rezervnih data centara obično se radi o udaljenom objektu na lokaciji na drugom kraju grada ili čak u drugom gradu. To omogućava obnavljanje kritičnih sistema u slučaju delimičnog ili potpunog kvara glavnog data centra. Podaci se konstantno repliciraju sa produkcije, a ova replikacija može biti na nivou aplikacije ili na nivou blok uređaja (SAN).
Zato ću sada govoriti o strukturi sistema i testovima, a zatim o nekoliko scenarija stvarne primene sa podacima o uštedama.
Testovi
Naš primer se sastoji od četiri servera, od kojih svaki ima 10 SSD diskova od 960 GB. Postoji posvećen disk za keširanje operacija pisanja i skladištenje servisne virtuelne mašine. Sama rešenja - četvrta verzija. Prva je očigledno bila nedovršena (sudeći po povratnim informacijama), druga je bila još uvek neusavršena, treća je već dovoljno stabilna, a ova se može nazvati verzijom posle završetka beta testiranja na širokoj javnosti. Tokom testiranja nisam uočio probleme, sve radi kao sat.
Izmene u v4Ispravljeno mnogo grešaka.
Prvobitno je platforma mogla raditi samo sa hipervizorom VMware ESXi i podržavala je mali broj nodova. Takođe, proces raspoređivanja nije uvek uspešno završavao, bilo je potrebno ponovo pokrenuti neke korake, bile su probleme sa ažuriranjem sa starih verzija, podaci u GUI se nisu uvek korektno prikazivali (iako ni sada nisam oduševljen prikazom grafikona performansi), ponekad su se javljali problemi na spoju sa virtualizacijom.
Sada su sve dečje bolesti ispravljene, HyperFlex podržava i ESXi i Hyper-V, plus je moguće:
- Kreiranje proširenog klastera.
- Kreiranje klastera za kancelarije bez korišćenja Fabric Interconnect, od dva do četiri noda (kupujemo samo servere).
- Mogućnost rada sa eksternim SAN-ovima.
- Podrška za kontejnere i Kubernetes.
- Kreiranje zona dostupnosti.
- Integracija sa VMware SRM, ako ugrađene funkcionalnosti nisu zadovoljavajuće.
Arhitektura se ne razlikuje značajno od rješenja glavnih konkurenata, pa nisu pokušavali izmisliti točak. Sve to radi na platformi virtualizacije VMware ili Hyper-V. Hardverski se nalazi na poslužiteljima vlastitog razvoja Cisco UCS. Ima onih koji mrze platformu zbog relativne složenosti inicijalnog postavljanja, mnoštva gumba, ne trivijalnog sustava predložaka i zavisnosti, ali ima i onih koji su spoznali zen, prihvatili ideju i više ne žele raditi s drugim poslužiteljima.
Razmatrat ćemo konkretno rješenje za VMware, jer je rješenje prvotno stvoreno za njega i ima veće funkcionalnosti, dok je Hyper-V unaprijeđen tijekom vremena kako ne bi zaostajao za konkurencijom i ispunio tržišna očekivanja.
Postoji klaster poslužitelja opremljenih diskovima. Ima diskove za pohranu podataka (SSD ili HDD — po vašem izboru i potrebama), a tu je i jedan SSD-disk za keširanje. Kada se podaci pišu na datastore, podaci se pohranjuju na keširajući sloj (namjenski SSD-disk i RAM uslužnog VM-a). Paralelno, blok podataka šalje se čvorovima u klasteru (broj čvorova ovisi o faktoru replikacije klastera). Nakon potvrde od svih čvorova o uspješnom pisanju, potvrda se šalje hipervizoru, a zatim — u VM. Zapisani podaci se u pozadini deduplikuju, komprimiraju i pohranjuju na diskove. Pri tome se na diskove za pohranu uvijek zapisuje veliki blok i sukcesivno, što smanjuje opterećenje na diskove za pohranu.
Deduplicitacija i kompresija su stalno uključeni i ne mogu se isključiti. Čitanje podataka se događa izravno s diskova za pohranu ili iz RAM keša. Ako se koristi hibridna konfiguracija, tada se čitanje također kešira na SSD-disku.
Podaci se ne povezuju s trenutnom lokacijom virtualne mašine i ravnomjerno se distribuiraju među čvorovima. Ovaj pristup omogućava ravnomjerno opterećenje svih diskova i mrežnih sučelja. Očigledan nedostatak je što ne možemo maksimalno smanjiti kašnjenje čitanja, jer nema garancije o prisutnosti podataka lokalno. Međutim, smatram da je to beznačajna žrtva u odnosu na ostvarene prednosti. Tim više, kašnjenja u mreži su dostigla takve vrijednosti da praktično ne utječu na ukupni rezultat.
Za svu logiku rada diskovnog podsistema odgovara posebna servisna VM Cisco HyperFlex Data Platform controller, koja se kreira na svakoj čvoru skladišta. U našoj konfiguraciji servisne VM dodeljeno je osam vCPU i 72 GB RAM, što nije malo. Podsećam da sam host ima 28 fizičkih jezgara i 512 GB RAM.
Servisna VM ima pristup fizičkim diskovima direktno putem proboja SAS kontrolera u VM. Komunikacija sa hypervizorom se odvija putem posebnog modula IOVisor, koji presreće ulazno-izlazne operacije, i kroz agenta koji omogućava slanje komandi u API hypervizora. Agent je odgovoran za rad sa HyperFlex snapshot-ima i klonovima.
U hypervizoru, diskovni resursi se montiraju kao NFS ili SMB share (zavisi od tipa hypervizora, pogodite koji je gde). A ispod haube je distribuirani fajl sistem koji omogućava dodavanje funkcionalnosti pravih punopravnih SAN-ova: tanko skladištenje volumena, kompresiju i deduplikaciju, snapshot-e po tehnologiji Redirect-on-Write, sinhronu/asinhronu replikaciju.
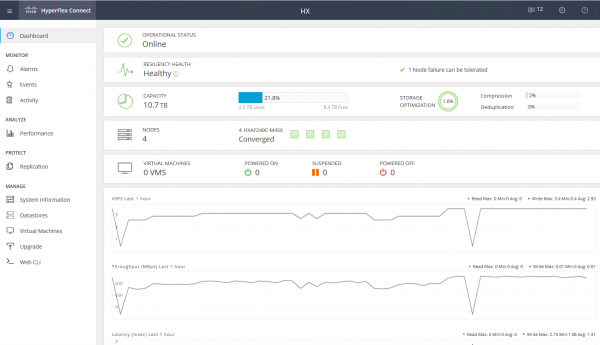
Servisna VM pruža pristup WEB interfejsu za upravljanje HyperFlex podsistemom. Postoji integracija sa vCenter-om, i velika većina svakodnevnih zadataka može se izvršiti iz njega, ali datastores, na primer, bolje je odrezati iz odvojene web aplikacije, ako ste već prešli na brzi HTML5 interfejs, ili koristiti punopravni Flash klijent s punom integracijom. U servisnoj web aplikaciji možete videti performanse i detaljan status sistema.
Postoji i drugi tip čvorova u klasteru — računarski čvorovi. To mogu biti rack ili blade serveri bez ugrađenih diskova. Na tim serverima možete pokretati VM-ove čiji se podaci čuvaju na serverima s diskovima. Sa stanovišta pristupa podacima, nema razlike između tipova čvorova, jer arhitektura predviđa apstrakciju od fizičkog položaja podataka. Maksimalna proporcija računarskih čvorova i čvorova skladišta je 2:1.
Korišćenje računarskih čvorova povećava fleksibilnost prilikom skaliranja resursa klastera: nije nam nužno da kupujemo čvorove s diskovima, ako imamo potrebu samo za CPU/RAM. Takođe možemo dodati blade kavez i ostvariti uštede na smeštaju servera u ormaru.
Kao rezultat, imamo hiper-konvergentnu platformu sa sledećim funkcijama:
- Do 64 čvorova u klasteru (do 32 čvora za skladištenje).
- Minimalni broj čvorova u klasteru je tri (dva za Edge klaster).
- Mehanizam redundantnosti podataka: mirroring s faktorom replikacije 2 i 3.
- Metro klaster.
- Asinkrona replikacija VM na drugi HyperFlex klaster.
- Orkestracija prebacivanja VM u udaljeni data centar.
- Nativni snimci s tehnologijom Redirect-on-Write.
- Do 1 PB korisnog prostora pri faktoru replikacije 3 i bez uzimanja u obzir deduplikacije. Faktor replikacije 2 se ne uzima u obzir, jer to nije opcija za ozbiljan prodajni model.
Još jedna velika prednost je jednostavnost upravljanja i implementacije. Sve složenosti postavljanja UCS servera preuzima specijalizovana VM, koju su pripremili inženjeri Cisco.
Konfiguracija testnog okruženja:
- 2 x Cisco UCS Fabric Interconnect 6248UP kao kontrolni klaster i mrežni sastav (48 portova koji rade u Ethernet režimu 10G/FC 16G).
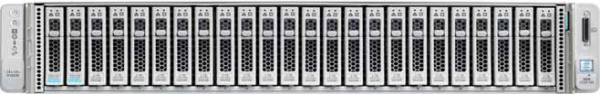
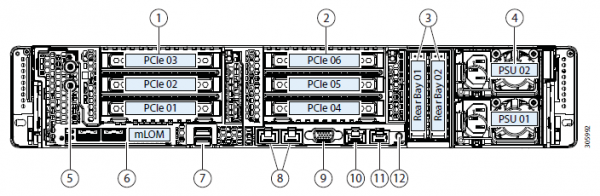
- Četiri servera Cisco UCS HXAF240 M4.
Karakteristike servera:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/dual rank/x4/1.2v
Mreža
UCSC-MLOM-CSC-02 (VIC 1227). 2 porta 10G Ethernet
Storage HBA
Cisco 12G Modular SAS Pass through Controller
Storage Diskovi
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Više opcija konfiguracijePored odabranog hardvera, trenutno su dostupne sledeće opcije:
- HXAF240c M5.
- Jedan ili dva CPU počevši od Intel Silver 4110 do Intel Platinum I8260Y. Dostupna je druga generacija.
- 24 slota za memoriju, moduli od 16 GB RDIMM 2600 do 128 GB LRDIMM 2933.
- Od 6 do 23 diska za podatke, jedan keširajući disk, jedan sistemski i jedan boot disk.
Diskovi kapaciteta
- HX-SD960G61X-EV 960GB 2.5 inčni Enterprise Value 6G SATA SSD (1X izdržljivost) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 inčni Enterprise Value 6G SATA SSD (1X izdržljivost) SAS 3.8 TB.
- Diskovi za keširanje
- HX-NVMEXPB-I375 375GB 2.5 inčni Intel Optane Disk, ekstremne performanse i izdržljivost.
- HX-NVMEHW-H1600* 1.6TB 2.5 inčni Ent. Perf. NVMe SSD (3X izdržljivost) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 inčni Ent. Perf. 12G SAS SSD (10X izdržljivost) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 inčni Ent. Perf. 12G SAS SED SSD (10X izdržljivost) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 inčni Enterprise performance 12G SAS SSD (3X izdržljivost).
Sistemski / Log diskovi
- HX-SD240GM1X-EV 240GB 2.5 inčni Enterprise Value 6G SATA SSD (zahteva nadogradnju).
Diskovi za pokretanje
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Povezivanje na mrežu putem 40G, 25G ili 10G Ethernet portova.
Kao FI mogu biti HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G).
Sam test
Za testiranje diskovnog podsistema koristio sam HCIBench 2.2.1. To je besplatna alatka koja omogućava automatizaciju generisanja opterećenja sa više virtuelnih mašina. Samo opterećenje generiše običan fio.
Naš klaster se sastoji od četiri čvora, faktor replikacije 3, svi diskovi su Flash.
Za testiranje sam stvorio četiri data store-a i osam virtuelnih mašina. Za testove upisa pretpostavlja se scenario kada cache disk ne prepunjava.
Rezultati testova su sledeći:
100 % Čitanje 100 % Nasumično
0 % Čitanje 100 % Nasumično
Blok / dubina reda
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
Podebljano su označene vrednosti nakon kojih nema rasta performansi, a ponekad je čak vidljiva degradacija. To je povezano sa time da nailazimo na performanse mreže / kontrolera / diskova.
- Sekvencijalno čitanje 4432 MB/s.
- Sekvencijalno pisanje 804 MB/s.
- U slučaju kvara jednog kontrolera (kvar virtuelne mašine ili host-a) pad performansi je dvostruko veći.
- U slučaju kvara skladišnog diska — pad za 1/3. Rebuild diska zahteva 5% resursa svakog kontrolera.
Na malom bloku nailazimo na performanse kontrolera (virtuelna mašina), njegov CPU je opterećen 100%, a povecanjem bloka nailazimo na propusnost portova. 10 Gbps nije dovoljno da se oslobodi potencijal AllFlash sistema. Nažalost, uslovi dostupnog demostenda ne dozvoljavaju testiranje na 40 Gbps.
Prema mom uticaju iz testova i proučavanju arhitekture, kroz algoritam koji raspoređuje podatke između svih hostova, dobijamo skalabilne predvidive performanse, ali to je i ograničenje tokom čitanja, s obzirom na to da bi se sa lokalnih diskova moglo izvući i više, ovde bi mogla pomoći brža mreža, na primer, dostupni FI na 40 Gbps.
Takođe, jedan disk za keširanje i deduplikaciju može biti ograničenje, zapravo u ovom stendu možemo pisati na četiri SSD diska. Bilo bi odlično imati mogućnost povećanja broja keširanih diskova i videti razliku.
Stvarna upotreba
Za organizaciju rezervnog DC-a mogu se primeniti dva pristupa (ne razmatramo postavljanje backup-a na udaljenoj lokaciji):
- Aktivno-Pasivna. Sve aplikacije se hostuju u glavnom DC-u. Replikacija je sinhrona ili asinhrona. U slučaju pada glavnog DC-a, potrebno je aktivirati rezervni. To se može uraditi ručno, putem skripti ili aplikacija za orkestraciju. Ovde dobijamo RPO koji je merljiv prema frekvenciji replikacije, a RTO zavisi od reakcije i veština administratora i kvaliteta pripreme i testiranja plana prebacivanja.
- Aktivno-Aktivna. U ovom slučaju postoji samo sinhrona replikacija, dostupnost DC-ova određuje kvorum/arbitrar, smešten strogo na trećoj lokaciji. RPO = 0, dok RTO može dostići 0 (ako aplikacija to dozvoljava) ili biti jednako vremenu potrebnom za rešavanje havarije čvora u virtuelizaciji. Na nivou virtuelizacije se kreira prošireni (Metro) klaster, koji zahteva Aktivno-Aktivnu Skladišnu jedinicu.
Obično kod klijenata već vidimo implementiranu arhitekturu s klasičnom Skladišnom jedinicom u glavnom DC-u, stoga projektujemo još jednu za replikaciju. Kao što sam spomenuo, Cisco HyperFlex nudi asinhronu replikaciju i kreiranje proširenog klastera virtuelizacije. U ovom slučaju, ne trebamo posebnu Skladišnu jedinicu srednjeg ranga i više sa skupim funkcijama replikacije i Aktivno-Aktivnog pristupa podacima na dve Skladišne jedinice.
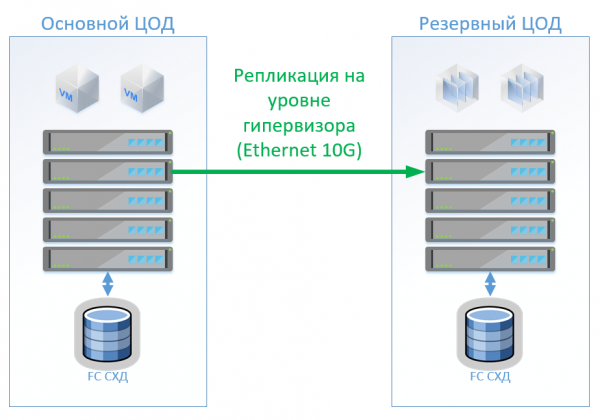
Scenarij 1: Imamo glavni i rezervni DC, platformu virtuelizacije na VMware vSphere. Sve produktivne sisteme imamo u glavnom DC-u, a replikacija virtuelnih mašina se vrši na nivou hipervizora, što omogućava da VM-ovi budu isključeni u rezervnom DC-u. Baze podataka i posebne aplikacije replikujemo ugrađenim alatima i držimo VM-ove uključenim. U slučaju kvara glavnog DC-a, pokrećemo sisteme u rezervnom DC-u. Smatramo da imamo oko 100 virtuelnih mašina. Dok je glavni DC aktivan, u rezervnom DC-u mogu se pokretati testna okruženja i drugi sistemi koji se mogu isključiti u slučaju prebacivanja glavnog DC-a. Takođe je moguć scenarij gde koristimo dvosmernu replikaciju. Sa aspekta hardvera, ništa se neće promeniti.
U klasičnoj arhitekturi postavićemo hibridnu SAN u svaki podatkovni centar sa pristupom putem FibreChannel, tieringom, deduplikacijom i kompresijom (ali ne online), 8 servera po lokaciji, po 2 Ethernet 10G i FibreChannel prekidača. Za replikaciju i upravljanje prebacivanjem u klasičnoj arhitekturi možemo koristiti VMware alate (Replication + SRM) ili neka alternativna rešenja koja su jeftinija i ponekad praktičnija.
Na slici je prikazana šema.
U slučaju korišćenja Cisco HyperFlex dobijamo sledeću arhitekturu:
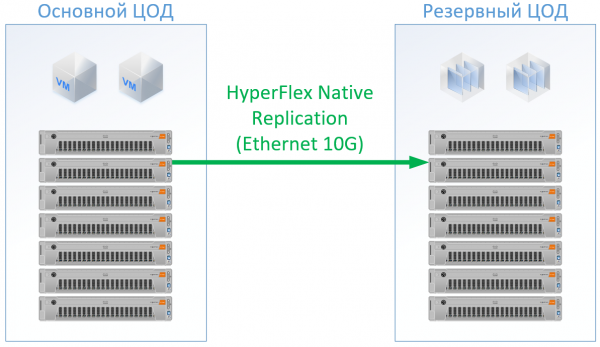
Za HyperFlex koristio sam servere sa velikim resursima CPU/RAM, jer će deo resursa ići na VM kontrolera HyperFlex. Prešao sam malo preko potrebnih resursa u konfiguraciji HyperFlex kako bi garantovao resurse za ostale VM i ne bi favorizovao Cisco. Tako možemo da se odričemo FibreChannel prekidača, a Ethernet portovi neće biti potrebni za svaki server, lokalni saobraćaj se prebacuje unutar FI.
Kao rezultat, dobijena je sledeća konfiguracija za svaki podatkovni centar:
Serveri
8 x 1U server (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
Skladištenje podataka
Hibridna SAN sa FC Front-End (20TB SSD, 130 TB NL-SAS)
—
LAN
2 x Ethernet prekidač 10G sa 12 portova
—
SAN
2 x FC prekidač 32/16Gb sa 24 porta
2 x Cisco UCS FI 6332
Licence
VMware Ent Plus
Replikacija i/ili orkestracija prebacivanja VM
VMware Ent Plus
Za HyperFlex nisam uračunao licence za replikaciju, jer su nam te funkcionalnosti dostupne odmah.
Za klasičnu arhitekturu izabrao sam dobavljača koji je poznat kao kvalitetan i povoljan proizvođač. Za obe opcije primenio sam standardno rešenje, te na kraju dobio realne cene.
Rešenje sa Cisco HyperFlex je bilo 13% jeftinije.
Scenarij 2: kreiranje dva aktivna podatkovna centra. U ovom scenariju projektujemo rasprostranjeni klaster na VMware.
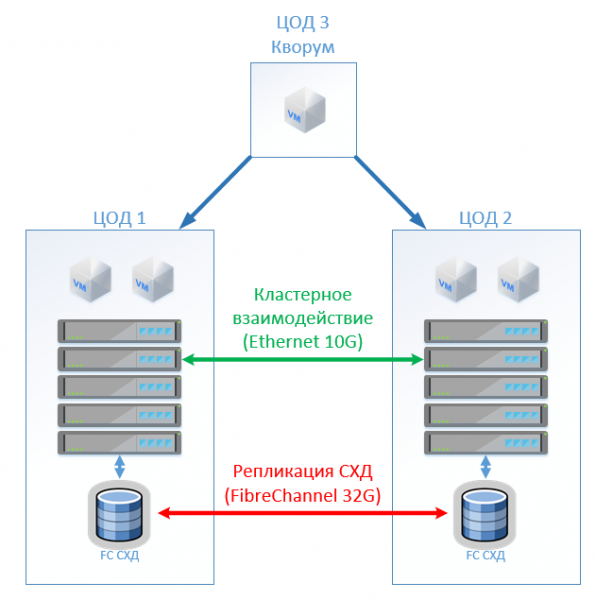
Klasična arhitektura se sastoji od virtualizacionih servera, SAN (FC protokol) i dva SAN koja mogu čitati i pisati između njih. Na svakoj SAN predviđamo korisni kapacitet za lokaciju.
Sa HyperFlex jednostavno kreiramo Stretch Cluster sa istim brojem nodova na obe lokacije. U tom slučaju koristi se faktor replikacije 2+2.
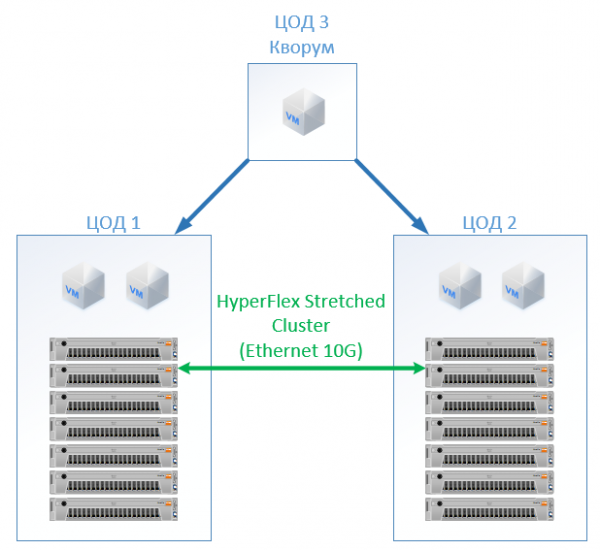
Rezultantna konfiguracija je sledeća:
Klasična arhitektura
HyperFlex
Serveri
16 x 1U server (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
Skladištenje podataka
2 x AllFlash SAN (150 TB SSD)
—
LAN
4 x Ethernet prekidač 10G sa 24 porta
—
SAN
4 x FC prekidač 32/16Gb sa 24 porta
4 x Cisco UCS FI 6332
Licence
VMware Ent Plus
VMware Ent Plus
U svim proračunima nisam uzeo u obzir mrežnu infrastrukturu, troškove data centra itd.: oni će biti isti za klasičnu arhitekturu i za rešenje na HyperFlex.
Prema troškovima, HyperFlex je ispao 5% skuplji. Ovde treba napomenuti da su resursi CPU/RAM za Cisco bili neproporcionalni, jer sam u konfiguraciji ravnomerno popunjavao kanale kontrolera memorije. Troškovi su malo viši, ali ne u ogromnoj meri, što jasno ukazuje da hiperkonvergencija nije nužno "igračka za bogate", već može konkurisati standardnom pristupu izgradnji data centra. Ovo može biti interesantno i onima koji već imaju Cisco UCS servere i odgovarajuću infrastrukturu.
Od prednosti dobijamo odsustvo troškova za administraciju SAN-a i SŽD-a, online kompresiju i dedupikaciju, jedinstvenu tačku ulaza za podršku (virtualizacija, serveri, takođe SŽD), uštedu prostora (ali ne u svim scenarijima), pojednostavljenje eksploatacije.
Što se tiče podrške, ovde je dobijate od jednog dobavljača - Cisco. Ako sudim prema iskustvu sa Cisco UCS serverima, to mi se sviđa, na HyperFlex-u nije bilo potrebe za otvaranjem, sve je već radilo. Inženjeri odgovaraju brzo i mogu da rešavaju ne samo tipične probleme, već i složene granične slučajeve. Ponekad im se obraćam sa pitanjima: "Može li se to uraditi, priključiti ovo?" ili "Ovde sam nešto konfigurisao, i neće da radi. Pomozite!" - oni strpljivo pronađu odgovarajući vodič i ukazuju na pravilne korake, neće reći: "Mi rešavamo samo hardverske probleme."
Linkovi
- Moja e-pošta — StGeneralov@croc.ru
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish