

Pozdravljen, kolega! Danas bih želeo da razgovaram o veoma važnoj temi za mnoge administratore Check Point-a - "Optimizacija CPU i RAM-a". Često se dešava da prolaz i/ili upravljački server troše iznenađujuće mnogo ovih resursa, i želeo bih da shvatim gde oni "beže", i da ih, ako je moguće, efikasnije iskoristim.
1. Analiza
Za analizu opterećenja procesora korisno je koristiti sledeće komande koje se unose u ekspertskom režimu:
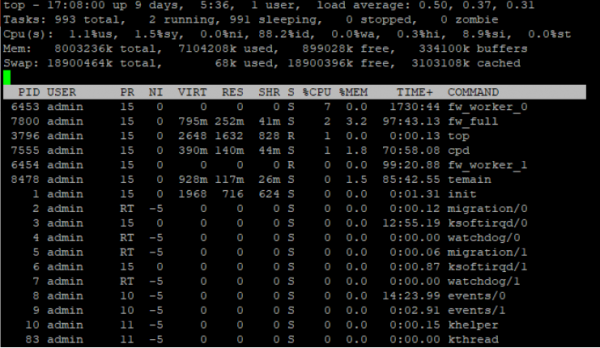
top prikazuje sve procese, količinu resursa CPU i RAM-a u procentima, uptime, prioritet procesa i u realnom vremenui
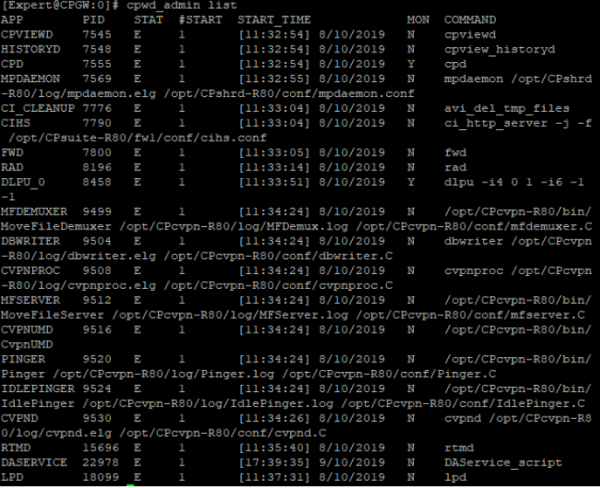
cpwd_admin list Check Point WatchDog Daemon, koji prikazuje sve module uređaja, njihov PID, stanje i broj pokretanja
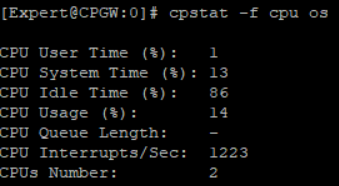
cpstat -f cpu os korišćenje CPU, njihova količina i raspodela procesorskog vremena u procentima
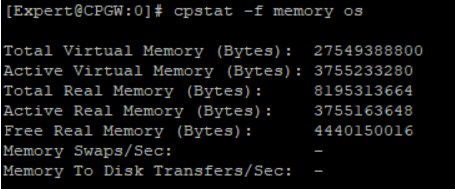
cpstat -f memory os korišćenje virtuelnog RAM-a, koliko ukupno aktivne, slobodne RAM i drugo
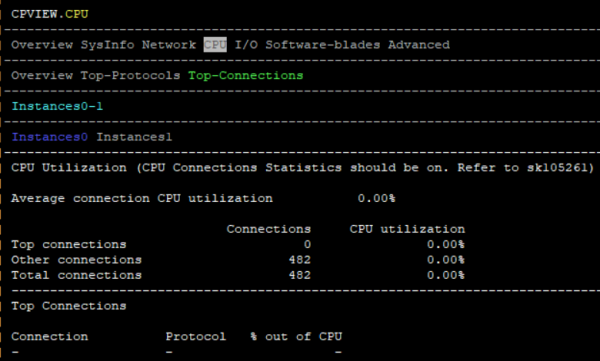
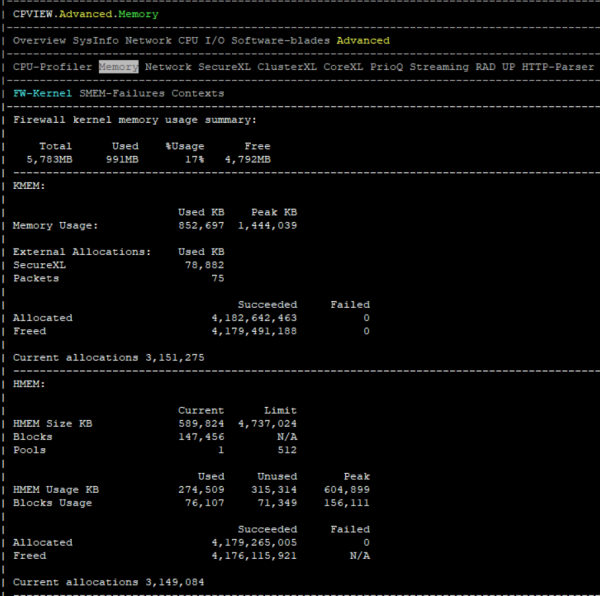
Ispravna zapažanja su da se sve komande cpstat mogu pregledati putem alata cpview. Za to jednostavno treba uneti komandu cpview iz bilo kog režima u SSH sesiji.
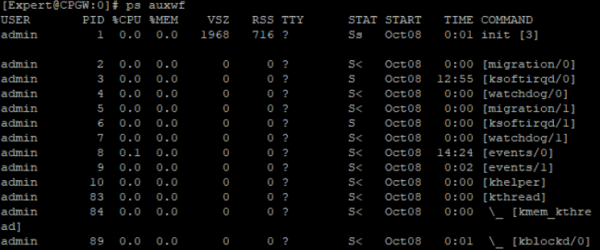
ps auxwf dugački spisak svih procesa, njihovih ID-eva, korišćenih virtuelnih memorija i memorije u RAM-u, CPU
Druga varijacija komande:
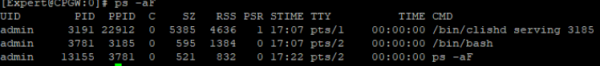
ps -aF prikazaće najviše opterećeni proces
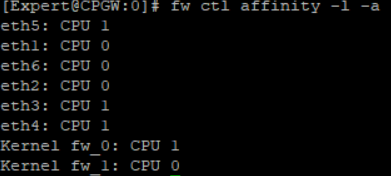
fw ctl affinity -l -a raspodela jezgara među različitim instancama vatrozida, odnosno tehnologija CoreXL
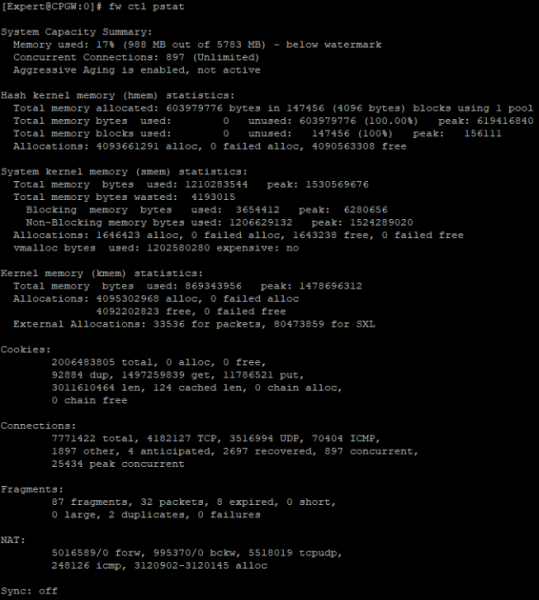
fw ctl pstat analiza RAM-a i opšti pokazatelji konekcija, kolačića, NAT-a
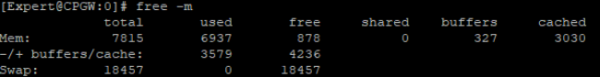
free -m RAM bafer
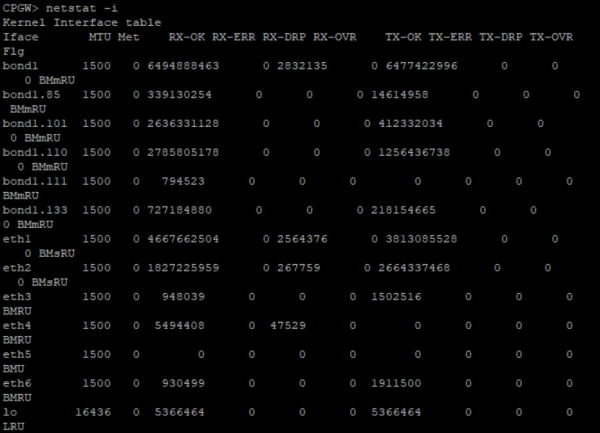
Posebnu pažnju zaslužuje komanda netsat i njene varijacije. Na primer, netstat -i može pomoći u rešavanju problema sa nadzorom bafera. Parametar, RX dropped packets (RX-DRP) u izlazu ove komande, obično raste sam od sebe zbog odbijanja nelegitimnih protokola (IPv6, Bad / Unintended VLAN tags i drugi). Međutim, ako odbijanja dolaze iz drugog razloga, onda bi trebalo iskoristiti ovu , kako bi se započela istraga i shvatilo zašto ovaj mrežni interfejs odbacuje pakete. Kada se otkrije razlog, rad uređaja može se takođe optimizovati.
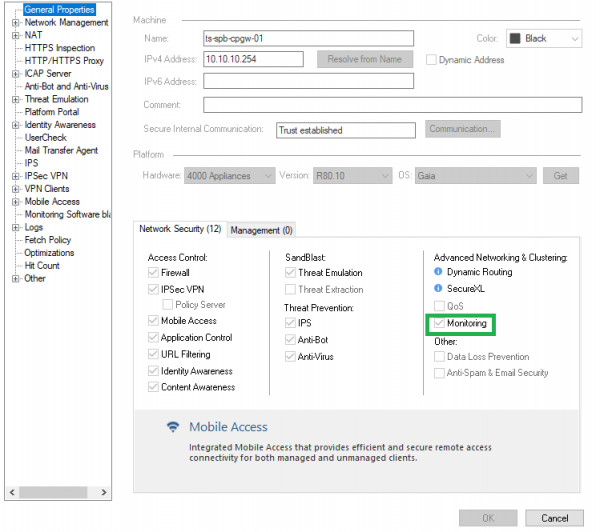
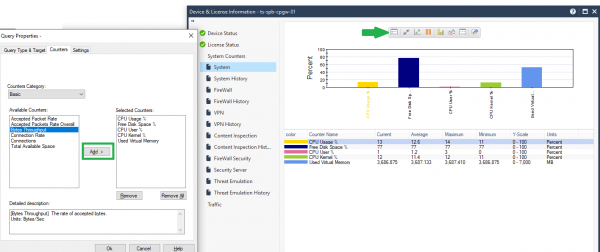
Ako je uključen Monitoring blade, onda se ovi pokazatelji mogu grafički pregledati u SmartConsole-u, klikom na objekat i izborom stavke "Device & License Information".
Na stalnoj osnovi ne preporučuje se uključivanje Monitoring blade-a, ali na dan za testiranje je sasvim u redu.
Štaviše, može se dodavati još više parametara za nadzor, jedan od njih je veoma koristan - Bytes Throughput (propusnost uređaja).
Ako postoji neki drugi sistem nadzora, na primjer, besplatni , temeljen na SNMP-u, također je prikladan za otkrivanje ovih problema.
2. “Curjenje” RAM-a tokom vremena
Često se postavlja pitanje, zašto tokom vremena prolazni ili menadžment server počinje sve više i više trošiti RAM. Želim da vas umirim: to je normalna pojava za Linux slične sisteme.
Gledajući izlaz komandi free -m i cpstat -f memory os na uređaju iz stručnog režima, možete izračunati i pogledati sve parametre vezane za RAM.
Zapravo, dostupna memorija na prolaznom uređaju trenutno iznosi Slobodna memorija + Memorija bafera + Keširana memorija = +-1.5 GB, kao pravilo.
Kao što CŠ kaže, tokom vremena prolazni/menadžment server se optimizira i koristi sve više memorije, dosegnuvši otprilike 80% korištenja, i onda se zaustavlja. Možete ponovo pokrenuti uređaj, i tada će se pokazatelj resetovati. 1.5 GB slobodne RAM-a sigurno je dovoljno za izvršenje svih zadataka, a menadžment rijetko dostiže takve kritične vrednosti.
Također, rezultati pomenutih komandi će pokazati koliko imate Niska memorija (operativna memorija u korisničkom prostoru) i Visoka memorija (operativna memorija u kernel prostoru) iskorišteno.
Kernel procesi (uključujući aktivne module, kao što su Check Point kernel moduli) koriste samo nisku memoriju. Međutim, korisnički procesi mogu koristiti i nisku i visoku memoriju. Štaviše, niska memorija je otprilike jednaka Ukupna memorija.
Trebalo bi se brinuti samo ako se u logovima počnu javljati greške „modules reboot or processes being killed to reclaim memory due to OOM (Out of memory)“. U tom slučaju trebate ponovo pokrenuti prolazni uređaj i obratiti se podršci, ako ponovni start ne pomogne.
Potpuni opis možete pronaći u i .
3. Optimizacija
Ispod su pitanja i odgovori vezani za optimizaciju CPU i RAM. Na njih se vrijedi iskreno odgovoriti i poslušati preporuke.
3.1. Da li je uređaj pravilno odabran? Da li je postavljen probni projekat?
Uprkos pravilnom dimenzioniranju, mreža se mogla jednostavno proširiti, i ova oprema jednostavno ne može da izdrži opterećenje. Druga opcija je ako dimenzioniranje zapravo nije izvršeno.
3.2. Da li je uključena HTTPS inspekcija? Ako jeste, da li je tehnologija konfigurirana u skladu sa najboljim praksama?
Obratite se , ako ste naš klijent, ili .
Redosled pravila u politici HTTPS inspekcije ima veliko značenje za optimizaciju otvaranja HTTPS sajtova.
Preporučeni redosled pravila:
- Pravila bypass sa kategorijama/URL
- Pravila inspect s kategorijama/URL-ovima
- Pravila inspect za sve ostale kategorije
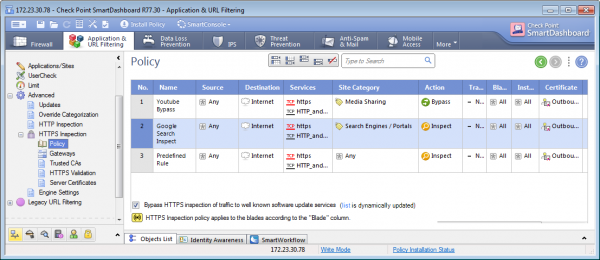
Na sličan način kao i kod pravila za vatrozid, Check Point traži podudarnosti prema paketima od vrha prema dnu, pa je bolje postaviti bypass pravila na vrh, kako bi gateway uštedio resurse i izbjegao prolazak kroz sva pravila ako taj paket treba propustiti.
3.3 Da li se koriste objekti s rasponom adresa?
Objekti sa rasponom adresa, kao što je mreža 192.168.0.0-192.168.5.0, uzimaju znatno više RAM-a nego 5 objekata mreže. Općenito, smatra se dobrom praksom uklanjanje neiskorištenih objekata u SmartConsole, jer svaki put prilikom instalacije politike gateway i upravljački server troše resurse i, što je najvažnije, vrijeme na verifikaciju i primjenu politike.
3.4. Kako je postavljena politika prevencije prijetnji?
Prvo, Check Point preporučuje isticanje IPS-a u poseban profil i kreiranje posebnih pravila za ovu blade.
Na primjer, administrator smatra da je segment DMZ potrebno zaštititi samo pomoću IPS-a. Stoga, kako bi gateway uštedio resurse na obradi paketa drugim blades, potrebno je stvoriti pravilo specifično za ovaj segment s profilom u kojem je uključen samo IPS.
Što se tiče postavki profila, preporučuje se da se one postave prema najboljim praksama u ovom (stranica 17-20).
3.5. Koliko potpisâ u režimu Detekcije postoji u postavkama IPS-a?
Preporučuje se temeljito obraditi potpise u smislu da se onemoguće neiskorišteni (na primjer, potpisi za iskorištavanje proizvoda Adobe zahtijevaju puno računalne snage, i ako klijent nema takve proizvode, ima smisla isključiti te potpise). Nadalje, postaviti Prevent umjesto Detect gdje je to moguće, jer gateway troši resurse na obradu cijele veze u režimu Detekcije, a u režimu Prevent odmah odbacuje vezu i ne troši resurse na potpunu obradu paketa.
3.6. Koje datoteke obrađuju blades Threat Emulation, Threat Extraction, Anti-Virus?
Nema smisla emulirati i analizirati datoteke ekstenzija koje vaši korisnici ne preuzimaju, ili koje smatrate nepotrebnima u vašoj mreži (na primjer, bat, exe datoteke se lako mogu blokirati pomoću Content Awareness blada na razini vatrozida, tako da će se resursi prolaza trošiti manje). Štaviše, u postavkama Emulacije prijetnji možete birati Okruženje (operativni sistem) za emulaciju prijetnji u sandboxu, a postavljanje Okruženja Windows 7 kada svi korisnici rade sa verzijom 10 takođe nema smisla.
3.7. Jesu li pravila vatrozida i pravila na razini aplikacije postavljena prema najboljim praksama?
Ako pravilo ima puno hitova (podudaranja), preporučuje se postavljanje na sam vrh, dok se pravila s malim brojem hitova postavljaju na sam dno. Glavno je osigurati da se ne preklapaju i da ne ometaju jedno drugo. Preporučena arhitektura politike vatrozida:
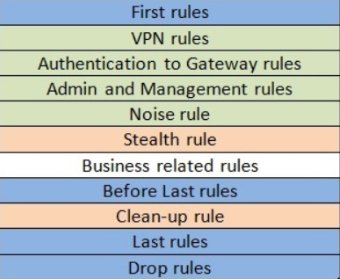
Objašnjenja:
Prva pravila — ovdje se smještaju pravila s najvećim brojem podudaranja.
Pravilo buke — pravilo za odbacivanje parazitskog prometa, poput NetBIOS-a.
Pravilo nevidljivosti — zabrana pristupa prolazima i upraviteljima svima osim onih izvora koji su navedeni u pravilima Autentifikacije prema pravilima prolaza.
Pravila čišćenja, posljednja i pravila odbacivanja, obično se spajaju u jedno pravilo za zabranu svega što nije ranije dopušteno.
Ove najbolje prakse opisane su u .
3.8. Koje postavke ima usluge koje su kreirali administratori?
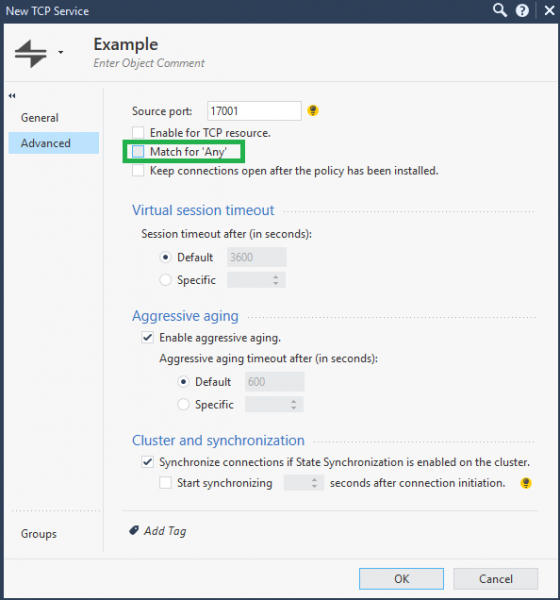
Na primjer, kreira se neka TCP usluga na određenom portu, i ima smisla u naprednim postavkama usluge ukloniti oznaku “Slaganje za bilo što”. U tom slučaju će ova usluga konkretno spadati pod pravilo u kojem figurira, i neće učestvovati u pravilima gdje je u koloni Usluge navedeno Bilo što.
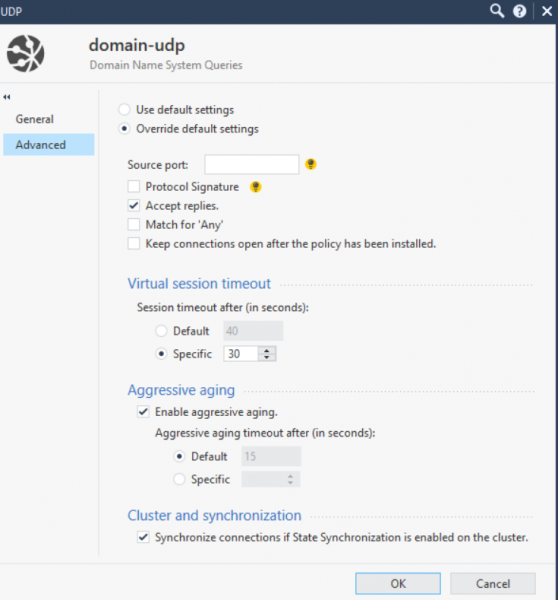
Govoreći o uslugama, vrijedi spomenuti da je ponekad potrebno fino podesiti vrijeme čekanja. Ova postavka omogućit će efikasnije korištenje resursa prolaza, kako ne bi zadržavali predugo TCP/UDP sesije protokola kojima nije potrebno veliko vrijeme čekanja. Na primjer, na donjoj slici, promijenio sam vrijeme čekanja domain-udp usluge sa 40 sekundi na 30 sekundi.
3.9. Koristi li se SecureXL i koliki je postotak ubrzanja?
Kvalitetu rada SecureXL može se provjeriti osnovnim komandama u ekspertnom režimu na prolazu. fwaccel stat i fw accel stats -s. Nakon toga treba istražiti koji promet se ubrzava, koje se šablone mogu još stvoriti.
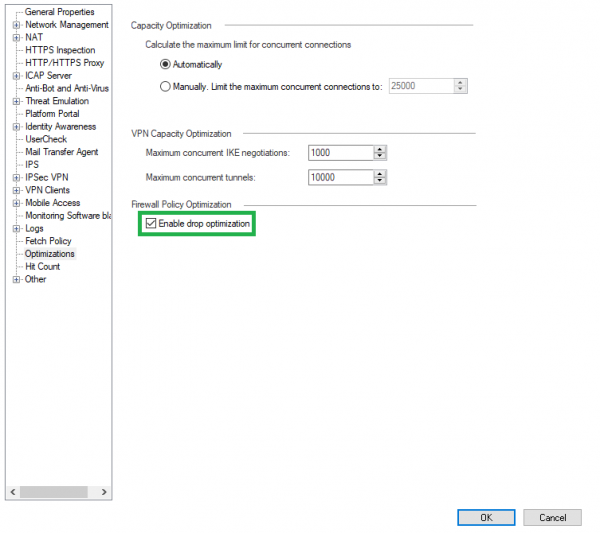
Po defaultu, Drop Templates nisu uključeni, ali njihovo uključivanje pozitivno će utjecati na rad SecureXL. Da biste to omogućili, idite na postavke gateway-a i na karticu Optimizations:
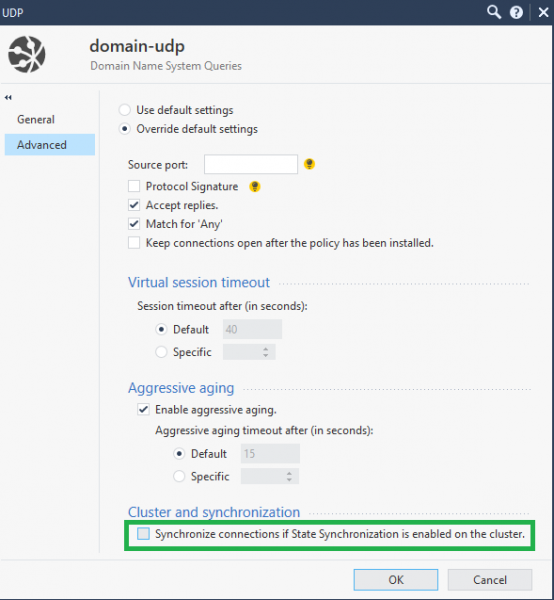
Također, prilikom rada s klasterom za optimizaciju CPU-a može se isključiti sinhronizacija nekritičnih usluga kao što su UDP DNS, ICMP i druge. Za to je potrebno otići u postavke usluge → Advanced → Sinhronizacija veza je omogućena na klasteru.
Sve najbolje prakse opisane su u .
3.10. Kako se koristi CoreXL?
Tehnologija CoreXL, koja omogućava korištenje više CPU-a za firewall instance (module vatrozida), značajno pomaže u optimizaciji rada uređaja. Prvo, komanda fw ctl affinity -l -a prikazuje korištene firewall instance i procesore dodijeljene za potrebne SND (modula koji raspoređuje promet na vatrozidne entitete). Ako nisu svi procesori aktivni, mogu se dodati komandom cpconfig na gateway-u.
Također dobra ideja je postaviti za omogućavanje Multi-Queue. Multi-Queue rešava problem kada se procesor sa SND koristi u velikom procentu, dok firewall instance na drugim procesorima stagniraju. Tada bi SND imao mogućnost da stvara više redova za jedan NIC i postavlja različite prioritete za različit promet na nivou jezgra. Shodno tome, jezgra CPU-a će se koristiti efikasnije. Tehnike su takođe opisane u .
U zaključku, treba napomenuti da ovo nije sve najbolje prakse za optimizaciju rada Check Point-a, ali su najpopularnije. Ako želite da naručite reviziju vaše sigurnosne politike ili rešite problem vezan za Check Point, slobodno se obratite na sales@tssolution.ru.
Hvala na pažnji!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish