

Proces ažuriranja za vašu Kubernetes klaster
U nekom trenutku tokom korišćenja Kubernetes klastera javlja se potreba za ažuriranjem aktivnih nodova. To može obuhvatati ažuriranja paketa, ažuriranje jezgra ili implementaciju novih slika virtuelnih mašina. U terminologiji Kubernetes-a to se naziva .
Ovaj post je deo serije od 4 posta:
- Ovaj post.
- Ispravno gašenje podova u Kubernetes klasteru
- Odloženo gašenje poda prilikom njegovog brisanja
- Kako izbeći vreme zastoja u radu Kubernetes klastera pomoću PodDisruptionBudgets
(nap. prev. očekujte prevode ostalih članaka serije uskoro)
U ovom članku ćemo opisati sve alate koje Kubernetes pruža za postizanje nultog vremena zastoja za radne nodove u vašem klasteru.
Definisanje problema
Na početku ćemo koristiti naivan pristup, identifikovati probleme i proceniti potencijalne rizike ovog pristupa, kao i akumulirati znanje za rešavanje svakog od problema sa kojima se susretnemo tokom cele serije. Kao rezultat, dobićemo konfiguraciju koja koristi lifecycle hooks, readiness probes i Pod disruption budgets za postizanje našeg nultog vremena zastoja.
Da bismo započeli naš put, uzmimo konkretan primer. Recimo da imamo Kubernetes klaster sa dva noda, u kojem je aplikacija pokrenuta sa dva poda, koja se nalaze iza Service:
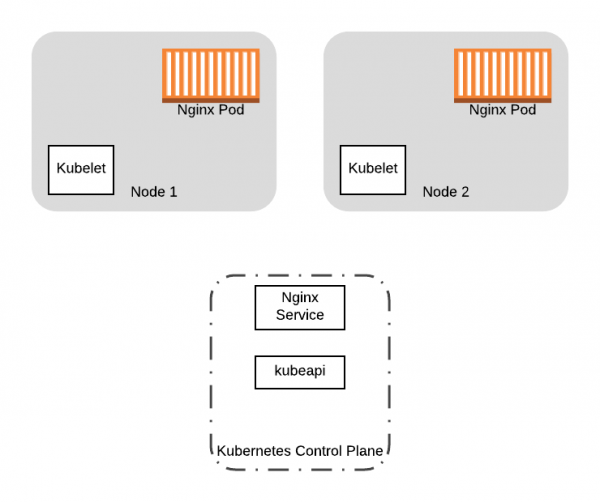
Počnimo sa dva poda sa Nginx-om i servisom pokrenutim na naših dva nodova Kubernetes klastera.
Želimo da ažuriramo verziju jezgra dva radna noda u našem klasteru. Kako ćemo to uraditi? Jednostavno rešenje bi bilo da pokrenemo nove nodove sa ažuriranom konfiguracijom i zatim isključimo stare nodove, istovremeno pokrećući nove. Iako bi to funkcionisalo, biće nekoliko problema sa ovim pristupom:
- Kada isključite stare nodove, aktivni podovi na njima će takođe biti isključeni. Šta ako podovi trebaju biti očišćeni za ispravno isključivanje? Sistem virtualizacije koji koristite možda neće čekati da se proces čišćenja završi.
- Šta ako isključite sve nodove odjednom? Dobijate značajan zastoj dok se podovi presele na nove nodove.
Potrebujemo način ispravnog migriranja podova sa starih nodova i pri tome trebamo biti sigurni da nijedan od naših radnih procesâ nije pokrenut dok vršimo izmjene za nod. Ili kada radimo potpunu zamjenu klastera, kao u primjeru (tj. zamjenjujemo slike VM-a), želimo prenijeti aktivne aplikacije sa starih nodova na nove. U oba slučaja želimo spriječiti zakazivanje novih podova na starim nodovima, a zatim iseliti sve pokrenute podove s njih. Za postizanje ovih ciljeva možemo koristiti komandu kubectl drain.
Redistribucija svih podova sa nodova
Operacija drain omogućava redistribuciju svih podova sa nodova. U procesu izvođenja drain, nod se označava kao unschedulable (oznaka NoSchedule). Ovo sprječava pojavu novih podova na njemu. Zatim drain počinje iseljavati podove sa nodova, završava rad kontejnera koji su trenutno pokrenuti na nodu šaljuci signal TERM kontejnerima u podu.
Iako kubectl drain Odlično se nosi sa iseljavanjem podova, postoje još dva faktora koja mogu uzrokovati neuspjeh prilikom izvođenja operacije drain:
- Vaša aplikacija mora biti u stanju ispravno završavati prilikom prijema
TERMsignala. Kada se podovi iseljavaju, Kubernetes šalje signalTERMkontejnerima i čeka na njihovo zaustavljanje zadato vrijeme, nakon čega, ako se nisu zaustavili, prisilno ih završava. U svakom slučaju, ukoliko vaš kontejner ne reaguje ispravno na signal, i dalje možete isključiti podove neispravno, ako su u tom trenutku pokrenuti (na primjer, ako je transakcija u Bazi podataka). - Gubite sve podove koji sadrže vašu aplikaciju. Ona može biti nedostupna u trenutku pokretanja novih kontejnera na novim nodovima ili, ako su vaši podovi raspoređeni bez kontrolera, mogu se uopšte ne ponovo pokrenuti.
Izbjegavanje zastoja
Kako bismo minimalizovali vrijeme zastoja zbog dobrovoljnog prekida, kao što je operacija drain za nod, Kubernetes pruža sljedeće opcije za upravljanje neuspjesima:
U ostalim dijelovima ciklusa koristit ćemo ove funkcije Kubernetesa za ublažavanje posljedica prenosa podova. Da bismo lakše pratili osnovnu misao, koristit ćemo naš gornji primjer s sljedećom konfiguracijom resursa:
---
apiVersion: apps/v1
kind: Deployment
metadata:
 name: nginx-deployment
 labels:
   app: nginx
spec:
 replicas: 2
 selector:
   matchLabels:
     app: nginx
 template:
   metadata:
     labels:
       app: nginx
   spec:
     containers:
     - name: nginx
       image: nginx:1.15
       ports:
       - containerPort: 80
---
kind: Service
apiVersion: v1
metadata:
 name: nginx-service
spec:
 selector:
   app: nginx
 ports:
 - protocol: TCP
   targetPort: 80
   port: 80
Ova konfiguracija je minimalni primer Deployment, koji upravlja podovima nginx u klasteru. Pored toga, konfiguracija opisuje resurs Service, koji se može koristiti za pristup podovima nginx u klasteru.
Tokom celog ciklusa ćemo iterativno proširivati ovu konfiguraciju kako bi na kraju uključila sve mogućnosti koje Kubernetes pruža za smanjenje vremena prekida.
Da biste dobili potpuno implementiranu i testiranu verziju ažuriranja klastera Kubernetes za nulto vreme prekida na AWS-u i drugim resursima, posetite .
Također pročitajte ostale članke na našem blogu:
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish