

Kanarinac je mala ptica koja neprekidno peva. Ove ptice su osetljive na metan i ugljendioksid. Čak i pri maloj koncentraciji viška gasova u vazduhu gube svest ili umiru. Zlatarice i rudari su nosili ptice sa sobom: dok kanarinci pevaju, može se raditi, a ako utihnu — u rudniku je gas i vreme je za izlazak. Rudari su žrtvovali malu pticu kako bi izlazili iz rudnika živi.
Slična praksa se pojavila i u IT-u. Na primer, u standardnom zadatku implementacije nove verzije servisa ili aplikacije na produkciju, s testiranjem pre toga. Testno okruženje može biti suviše skupo, automatizovani testi ne pokrivaju sve što bi želeli, a ne testirati i žrtvovati kvalitet je rizično. Upravo u takvim slučajevima pomaže pristup Canary Deployment, kada se mali deo pravog produkcijskog saobraćaja pušta na novu verziju. Ovaj pristup pomaže sigurno testirati novu verziju na produkciji, žrtvujući malo za veliku svrhu. Više o tome kako pristup funkcioniše, koje su njegove prednosti i kako ga realizovati, govori Andrej Markelov (), na primeru implementacije u kompaniji Infobip.
Andrej Markelov — vodeći inženjer-programer u Infobipu, već 11 godina se bavi razvojem aplikacija na Javi u oblasti finansija i telekomunikacija. Razvija Open Source proizvode, aktivno učestvuje u Atlassian zajednici i piše plugine za Atlassian proizvode. Evangelista je Prometheusa, Dockera i Redis-a.
O kompaniji Infobip
To je globalna telekomunikacijska platforma koja omogućava bankama, maloprodaji, internet prodavnicama i transportnim kompanijama da šalju poruke svojim klijentima putem SMS-a, push obaveštenja, e-mailova i glasovnih poruka. U ovoj delatnosti stabilnost i pouzdanost su ključni kako bi klijenti pravovremeno primali poruke.
IT infrastruktura Infobipa u brojkama:
- 15 data centara širom sveta;
- 500 jedinstvenih servisa u upotrebi;
- 2500 instanci servisa, što je znatno više od broja timova;
- 4,5 TB mesečnog saobraćaja;
- 4,5 milijarde telefonskih brojeva;
Biznis raste, a s njim i broj izdanja. Izvršavamo oko 60 izdanja dnevno, jer klijenti žele više funkcionalnosti i kapaciteta. Ali to je težak zadatak — ima mnogo servisa, a malo timova. Moramo brzo pisati kod koji mora da funkcioniše na produkciji bez grešaka.
Izdanja
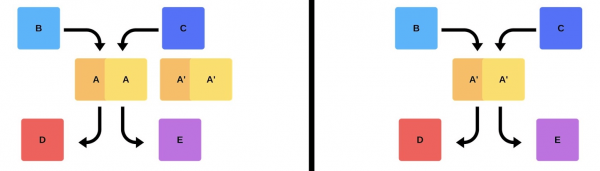
Tipičan proces objavljivanja kod nas izgleda ovako. Na primer, postoji servisi A, B, C, D i E, a svaki od njih razvija zasebni tim.
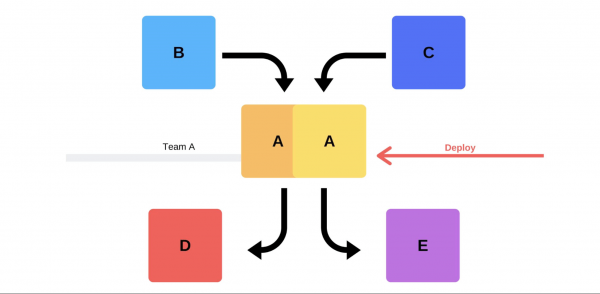
U nekom trenutku, tim servisa A odlučuje da objavi novu verziju, ali timovi servisa B, C, D i E o tome nemaju saznanja. Postoje dve opcije kako će tim servisa A postupiti.
Sprovesti inkrementalno objavljivanje: prvo će zameniti jednu verziju, a zatim drugu.
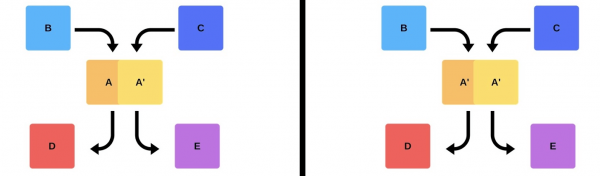
Ali postoji i druga opcija: tim pronađe dodatne resurse i mašine,, objavi novu verziju, a zatim preusmeri ruter, i verzija će početi da radi u produkciji.
U bilo kojoj opciji, nakon objavljivanja gotovo uvek se javljaju problemi, čak i ako je verzija testirana. Testirati se može ručno, može automatizovano, može se i ne testirati — problemi će se pojaviti u svakom slučaju. Najjednostavniji i ispravniji način da ih rešimo je da se vratimo na radnu verziju. Tek tada možemo istraživati štetu, uzroke i rešavati ih.
Dakle, šta želimo?
Problemi nam nisu potrebni. Ako ih kupci otkriju brže od nas, to će uticati na reputaciju. Zbog toga moramo pronaći probleme brže od kupaca.. Radom unapred, minimiziramo štetu.
U isto vreme, želimo ubrati objavljivanje, kako bi se to dešavalo brzo, lako, prirodno i bez stresa za tim. Inženjere, DevOps inženjere i programere treba čuvati — objavljivanje nove verzije predstavlja stres. Tim nije potrošni materijal, težimo racionalnom korišćenju ljudskih resursa..
Problemi objavljivanja
Korisnički saobraćaj je nepredvidiv.Nemoguće je predvideti kada će korisnički saobraćaj biti minimalan. Ne znamo gde i kada će kupci započeti svoje kampanje — možda večeras u Indiji, a sutra u Hong Kongu. Uzimajući u obzir veliku vremensku razliku, objavljivanje čak i u 2 sata noću ne garantuje da kupci neće pretrpeti štetu.
Problemi provajdera.Mesenžeri i provajderi su naši partneri. Ponekad imaju greške koje izazivaju propuste tokom objavljivanja novih verzija.
Raspodeljeni timovi.Timovi koji razvijaju klijentsku i backend stranu nalaze se u različitim vremenskim zonama. Zbog toga često ne mogu da se dogovore jedni sa drugima.
Data centri se ne mogu ponoviti u stazu.U jednom data centru ima 200 servera — nemoguće je replicirati to u peščaniku čak ni približno.
Downtimeis unacceptable! We have an acceptable level of availability (Error Budget) when we operate 99.99% of the time, with the remaining percentage being the 'margin of error.' Achieving 100% reliability is impossible, but it's essential to constantly monitor for outages and downtimes.
Classic Solutions
Write Code Without Bugs. When I was a young developer, managers approached me with requests to release without bugs, but that's not always possible.
Write Tests. Tests work, but sometimes not in the way the business wants. Making money is not the responsibility of the tests.
Test on Stage. In my 3.5 years at Infobip, I have never seen the state of staging even partially matching production.
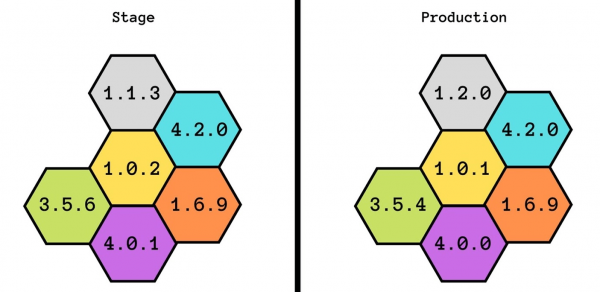
We even tried to develop this idea: first, we had staging, then pre-production, and then pre-production of pre-production. But this didn’t help — they didn't even match in capacity. With staging, we can guarantee basic functionality, but we don’t know how it will perform under load.
The release is done by the one who developed it. This is a good practice: even if someone changes the comment name, they immediately add it to production. This helps foster accountability and not forget about the changes made.
Additional complexities also exist. For the developer, it is a stress to spend a lot of time checking everything manually.
Coordinated Releases. This option is usually proposed by management: 'Let's agree that you will test and add new versions every day.' This does not work: there is always a team waiting for everyone else or vice versa.
Smoke Tests
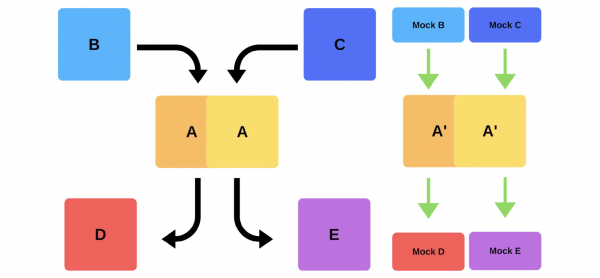
Another way to address our deployment issues. Let's consider how smoke tests work in the previous example when Team A wants to deploy a new version.
First, the team deploys one instance to production. Messages in the instance from mocks simulate real traffic, so that it matches normal daily traffic. If everything goes well, the team switches the new version to user traffic.
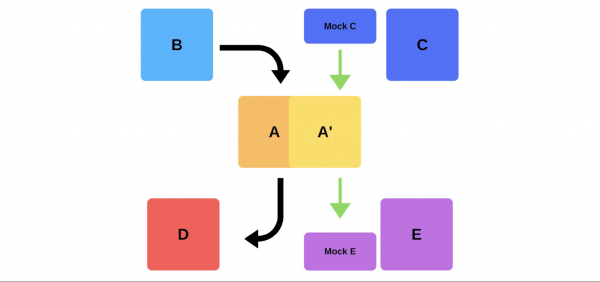
The second option is to deploy with additional hardware. The team tests it in production, then switches, and everything works.
The disadvantages of smoke tests:
- Testovima se ne može vjerovati. Gdje pronaći isti promet kao na produkciji? Može se koristiti jučerašnji ili tjedan dana star promet, ali on ne odgovara uvijek trenutnom.
- Teško je održavati. Moraćemo održavati testne račune, neprestano ih resetirati prije svakog deploya, kada se u skladištu šalju aktivne evidencije. To je složenije od pisanja testa u vlastitom pijesku.
Jedina prednost ovdje — može se provjeriti performanse.
Canary izdanja
Zbog nedostataka smoke testova počeli smo koristiti canary izdanja.
Praksa, slična onoj kada su kopači koristili kanarince za indikaciju nivoa plinova, našla je svoje mjesto i u IT-u. Pustimo malo stvarnog produkcijskog prometa na novu verziju, nastojeći da se uklopimo u Service Level Agreement (SLA). SLA je naše 'pravo na grešku', koje možemo iskoristiti jednom godišnje (ili za neki drugi vremenski period). Ako sve prođe dobro, dodajemo više prometa. Ako ne — vraćamo prethodne verzije.
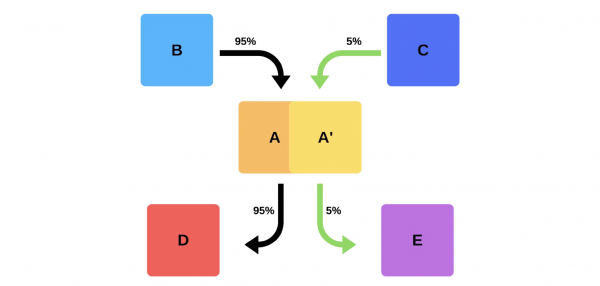
Implementacija i nijanse
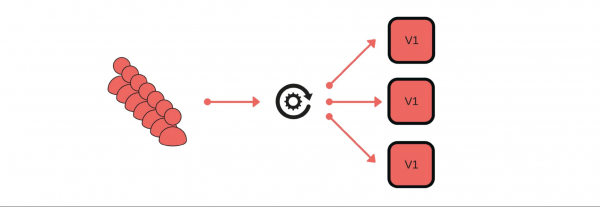
Kako smo implementirali canary izdanja? Na primjer, grupa klijenata šalje poruke preko naše usluge.
Deploy ide ovako: uklanjamo jedan čvor iz load balancera (1), mijenjamo verziju (2) i posebno pustimo malo prometa (3).
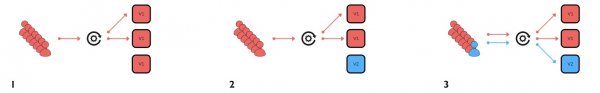
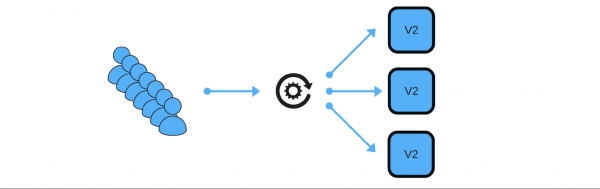
Uglavnom, bit će sretni svi u grupi, čak i ako jedan korisnik bude nezadovoljan. Ako sve prođe dobro — mijenjamo sve verzije.
Prikazat ću shematski kako to izgleda za mikroservise u većini slučajeva.
Postoji Service Discovery i još dvije usluge: S1N1 i S2. Prva usluga (S1N1) obavještava Service Discovery kada se pokrene, a Service Discovery ga pamti. Druga usluga s dva čvora (S2N1 i S2N2) također obavještava Service Discovery prilikom pokretanja.
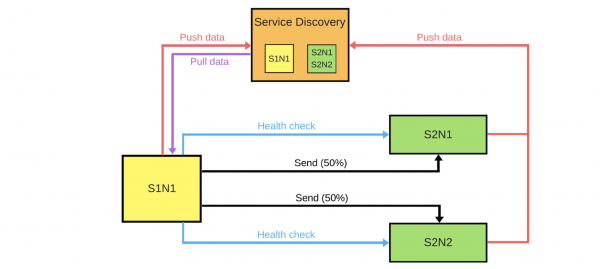
Druga usluga za prvu radi kao server. Prva usluga traži od Service Discovery informacije o svojim serverima, a kada ih dobije — traži i provjerava ih ("health check"). Kada ih provjeri, šalje im poruke.
Kada netko želi implementirati novu verziju druge usluge, javlja Service Discovery da će druga čvor biti kanary čvor: na njega će se slati manje prometa, jer će proći deploy. Uklanjamo kanary čvor iz load balancera i prva usluga ne šalje mu promet.
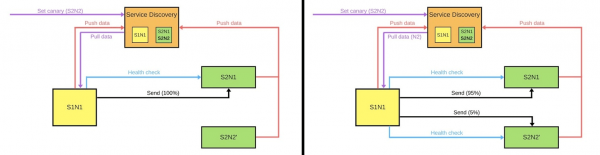
Menjamo verziju i Service Discovery zna da je druga čvora sada canary — možemo joj dati manje opterećenja (5%). Ako je sve u redu, menjamo verziju, vraćamo opterećenja i nastavljamo dalje.
Da bismo sve ovo realizovali, potrebni su nam:
- balansiranje;
- monitoring, jer je važno znati šta očekuje svaki korisnik i kako detaljno rade naše usluge;
- analiza verzija, kako bismo razumeli koliko dobro će nova verzija raditi u produkciji;
- automatizacija — pišemo redosled implementacije (deployment pipeline).
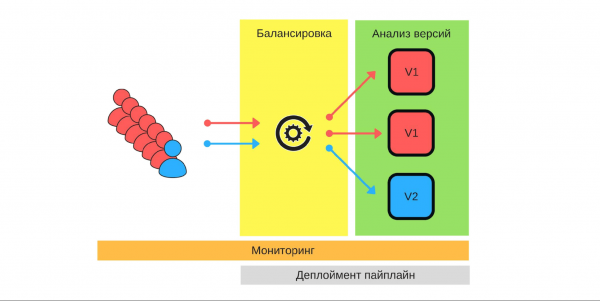
Balansiranje
To je prvo o čemu treba da razmislimo. Postoje dve strategije balansiranja.
Najjednostavnija opcija je kada jedna čvora uvek bude canary. Ova čvora uvek dobija manje saobraćaja i počinjemo implementaciju s njom. U slučaju problema, uporedićemo njen rad pre implementacije i tokom nje. Na primer, ako je grešaka postalo dvostruko više, šteta se takođe povećala dvostruko.
Canary čvora definiše se tokom implementacije. Kada se implementacija završi i skinemo status canary čvora, balans saobraćaja će se obnoviti. Sa manje mašina dobijamo poštenu raspodelu.
Monitorisanje
Temelj canary releasa. Moramo tačno razumeti zašto to radimo i koje metrike želimo da prikupljamo.
Primjeri metrika koje prikupljamo s naših usluga.
- Količina grešaka, koje se beleže u logovima. Ovo je očigledan pokazatelj da sve funkcioniše kako treba. U celini, to je dobra metrika.
- Vreme izvršenja zahteva (latencija). Ovu metriku prate svi, jer svi žele da rade brzo.
- Veličina reda (propusnost).
- Količina uspešnih odgovora po sekundi.
- Vreme izvršenja 95% svih zahteva.
- Biznis metrike: koliko novca biznis zarađuje u određenom vremenskom periodu ili odlivi korisnika. Ove metrike za našu novu verziju mogu biti važnije od onih koje dodaju inženjeri.
Primeri metrika u većini popularnih sistema za monitoring.
Counter. Ovo je neka rastuća veličina, na primer, broj grešaka. Ovu metriku je jednostavno interpolirati i proučiti grafikon: juče je bilo 2 greške, a danas 500, što znači da nešto nije u redu.
Broj grešaka u minuti ili sekundi je ključna metrika koja se može izračunati pomoću Counter-a. Ovi podaci daju jasnu predstavu o radu sistema tokom vremena. Razmotrićemo na primeru grafika broja grešaka u sekundi za dve verzije produkcijskog sistema.
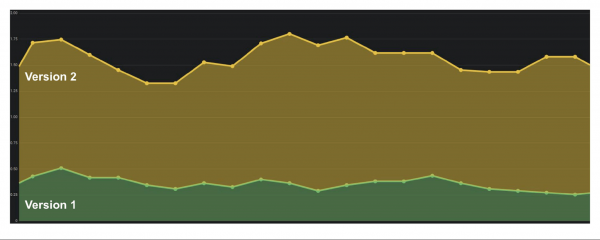
U prvoj verziji je bilo malo grešaka, moguće je da audita nije bilo. U drugoj verziji je situacija znatno lošija. Možemo sa sigurnošću reći da postoje problemi, pa treba da se vratimo na prethodnu verziju.
Gauge. Metrike su slične Counter-u, ali beležimo vrednosti koje se mogu i povećavati i smanjivati. Na primer, vreme izvršenja zahteva ili veličina reda.
Na grafikonu je primer vremena odziva (latencija). Iz grafika se može videti da su verzije slične i da mogu da se koriste. Ali ako pažljivo pogledamo, primećujemo promene u veličini. Ako se vreme izvršenja zahteva povećava sa dodavanjem korisnika, odmah je jasno da postoji problem — ranije to nije bila situacija.
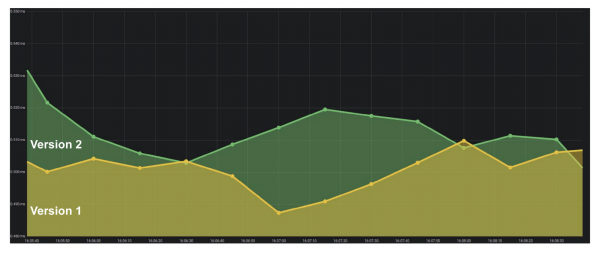
Summary. Jedna od najvažnijih metrika za biznis su percentili. Metodika pokazuje da u 95% slučajeva naš sistem radi onako kako želimo. Možemo se pomiriti sa problemima na nekim mestima, jer razumemo opštu tendenciju, koliko je sve dobro ili loše.
Brze postavke
ELK Stack. Canary se može implementirati koristeći Elasticsearch — beležimo greške kada se događaji odvijaju. Jednostavnim API pozivom možemo dobiti broj grešaka u bilo kom trenutku i uporediti ih sa prethodnim periodima: GET /applg/_cunt?q=level:errr.
Prometheus. Dobro se pokazao u Infobip-u. Omogućava implementaciju višedimenzionalnih metrika zahvaljujući korišćenju labela.
Možemo koristiti level, instance, service, kombinovati ih u jednom sistemu. Pomoću offset možemo videti, na primer, vrednost veličine pre nedelju dana jednostavnim komandama GET /api/v1/query?query={query}, gde {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Analiza verzija
Postoji nekoliko strategija za analizu verzija.
Posmatrati metrike samo canary-node. Jedna od najjednostavnijih opcija: implementirali smo novu verziju i proučavamo samo njeno funkcionisanje. Međutim, ako inženjer u tom trenutku počne da analizira logove, nervozno osvežavajući stranice, ovo rešenje se ne razlikuje od ostalih.
Canary-noda se upoređuje sa bilo kojom drugom nodom.Ovo je upoređenje s drugim instancama koje rade pod punim opterećenjem. Na primer, ako se sa malim opterećenjem situacija ne poboljšava ili nije bolja nego na stvarnim instancama, nešto nije u redu.
Canary čvor se upoređuje sa samim sobom iz prošlosti. Čvorovi dodeljeni canaryju mogu se upoređivati sa istorijskim podacima. Na primer, ako je pre nedelju dana sve bilo u redu, možemo se osloniti na te podatke da bismo razumeli trenutnu situaciju.
Automatizacija
Želimo osloboditi inženjere ručnog upoređivanja, pa je važno implementirati automatizaciju. Proces implementacije obično izgleda ovako:
- započinjemo;
- uklanjamo čvor iz balansiranja;
- postavljamo canary čvor;
- aktiviramo balancer sa ograničenom količinom prometa;
- upoređujemo.
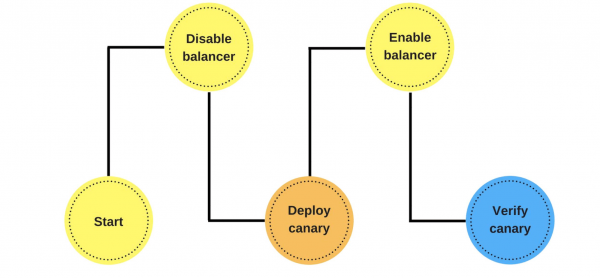
U ovoj fazi implementiramo automatsko upoređivanje. Kako to može izgledati i zašto je bolje od provere nakon implementacije, razmotrićemo na primeru iz Jenkins-a.
Ovo je pipeline u Groovy-ju.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary nije uspela, potrebno je da se vrati"
        return false
    }
}
Ovde u petlji postavljamo da ćemo upoređivati novi čvor tokom jednog sata. Ako canary proces još nije završen — pozivamo funkciju. Ona javlja da li je sve u redu ili ne: def isOk = compare(srv, canary, time, base, offset, metrics).
Ako je sve u redu — sleep DEFAULT SLEEP, na primer, na sekundu, i nastavljamo. Ako nije, izlazimo — implementacija nije uspela.
Opis metrike. Pogledajmo kako može izgledati funkcija compare na primeru DSL.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
Pretpostavimo da upoređujemo broj grešaka i želimo saznati koliko je grešaka u sekundi tokom poslednjih 5 minuta.
Imamo dve vrednosti: osnovnu i canary čvora. Vrednost canary čvora — trenutna. Osnovna — baseValue — to je vrednost bilo kog drugog čvora koji nije canary. Upoređujemo vrednosti prema formuli koju postavljamo na osnovu svog iskustva i posmatranja. Ako je vrednost canaryValue loša, onda implementacija nije uspela i vraćamo se nazad.
Zašto je sve ovo potrebno?
Čovek ne može proveriti stotine i hiljade metrika., a posebno to učiniti brzo. Automatska poređenja pomažu u provjeri svih metrika i brzo obavještavaju o problemima. Vrijeme obavještavanja je ključno: ako se nešto dogodilo u posljednje 2 sekunde, šteta neće biti toliko velika kao da se to dogodilo prije 15 minuta. Dok neko primijeti problem, piše podršci, a podrška nam se obraća da izvršimo rollback, možemo izgubit klijente.
Ako je proces prošao i sve je dobro, automatski deploy-amo sve ostale čvorove. U to vrijeme inženjeri ne rade ništa. Tek kada pokrenu canary, odlučuju koje metrike uzeti, koliko vremena raditi poređenje, koju strategiju koristiti.
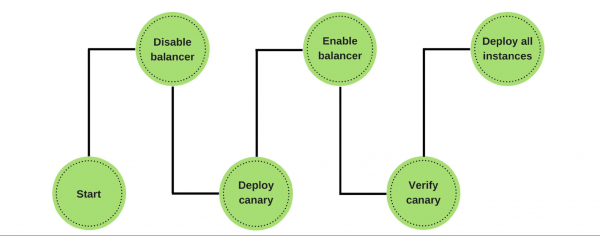
Ako su se pojavili problemi — automatski vraćamo canary čvor, radimo na prethodnim verzijama i ispravljamo greške koje su pronađene. Na metriku je lako pronaći i vidjeti štetu od nove verzije.
Prepreke
Ostvariti to, naravno, nije jednostavno. Prije svega je potreban sistem monitoringa. Inženjeri imaju svoje metrike, podrška i analitičari — druge, a biznis treće. Opšti sistem je zajednički jezik kojim razgovaraju biznis i razvoj.
Treba provjeriti u praksi stabilnost metrika. Provjera pomaže razumjeti, koji minimalni skup metrika je potreban da bi se osigurao kvalitet.
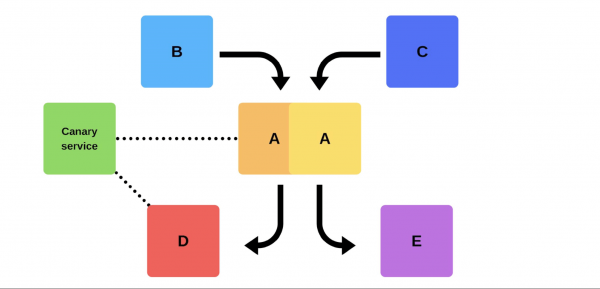
Kako to postići? Koristiti canary servis ne u trenutku deploy-a. Dodajemo na staroj verziji neki servis, koji u bilo kojem trenutku može uzeti bilo koji dodijeljen čvor, smanjiti promet bez deploy-a. Nakon toga uspoređujemo: analiziramo greške i tražimo onu granicu kada ostvarujemo kvalitet.
Koju korist smo imali od canary izdanja
Minimizirali smo procenat štete od grešaka. Većina grešaka prilikom deploy-a događa se zbog nesaglasnosti nekih podataka ili prioriteta. Takvih grešaka je znatno manje, jer možemo riješiti problem u prvim sekundama.
Optimizirali smo rad timova. Novajlijama je dato ‘pravo na grešku’: mogu deploy-ati u proizvodnju bez straha od greške, pojavljuje se dodatna inicijativa, poticaj za rad. Ako nešto pokvare, to neće biti kritično, a onaj koji je pogriješio neće biti otpušten.
Automatizirali smo deploy. To više nije ručni proces kao ranije, već pravi automatizirani. Ali traje duže.
Istakli smo važne metrike. Cijela kompanija, od poslovanja do inženjera, razume šta je zaista važno u našem proizvodu, koje metrike, poput korisničkog odljeva i priliva. Kontrolišemo proces: testiramo metrike, uvodimo nove, gledamo kako stare funkcionišu, da bismo izgradili sistem koji će generisati više prihoda.
Imamo mnogo sjajnih praksi i sistema koji nam pomažu. I pored toga, težimo biti profesionalci i obavljati svoj posao kvalitetno, bez obzira na to imamo li sistem koji će nam pomoći ili ne.
Inženjerski pristupi i prakse — . Ako ste postigli uspehe na putu ka tehničkoj izvrsnosti i spremni ste da podelite šta vam je u tome pomoglo, — .
Planiramo održati 8. juna. Razumemo da je trenutno teško doneti odluku o učešću na konferenciji. Ali smatramo da karantin nije izgovor da prekinemo profesionalnu komunikaciju i razvoj. Zato ćemo u svakom slučaju pronaći način da prodiskutujemo izazove tehničkog vođe i pristupe njihovom rešenju — ako bude potrebno, preći ćemo online i pokrenuti umrežavanje tamo!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish