

Prevodi članka su pripremljeni posebno za studente kursa .
— softverski razvijač, zaljubljenik u Go i ljubitelj rešavanja složenih problema. Također je održavatelj Prometheusa i suosnivač Kubernetes SIG instrumentation. U prošlosti je bio inženjer proizvodnje u SoundCloudu i vodio grupu za praćenje u CoreOS-u. Trenutno radi u Googleu.
— inženjer infrastrukture u Improbable. Interesuje se za nove tehnologije i probleme distribuiranih sistema. Ima iskustvo niskonivnog programiranja u Intelu, iskustvo doprinositelja u Mesosu i SRE proizvodno iskustvo svetske klase u Improbable-u. Pomaže u unapređenju sveta mikroservisa. Njegove tri ljubavi: Golang, open source i odbojka.
Gledajući naš vodeći proizvod SpatialOS, možete pretpostaviti da Improbable zahteva visoko dinamičnu cloud infrastrukturu globalnog obima sa desetinama Kubernetes klastera. Bili smo među prvima koji su počeli koristiti sistem praćenja . Prometheus može pratiti milionske metrike u realnom vremenu i dolazi sa moćnim jezikom upita koji omogućava izdvajanje neophodnih informacija.
Jednostavnost i pouzdanost Prometheusa jedan su od njegovih osnovnih prednosti. Međutim, nakon postizanja određenog skupa, suočili smo se sa nekoliko nedostataka. Za reševanje ovih problema razvili smo — projekat otvorenog koda koji je razvio Improbable, za besprekornu transformaciju postojećih Prometheus klastera u jedinstveni sistem praćenja sa neograničenim skladištem istorijskih podataka. Thanos je dostupan na Githubu .
Naši ciljevi sa Thanusom
Kada se dostigne određeni obim, pojavljuju se problemi koji prevazilaze mogućnosti običnog Prometheusa. Kako pouzdano i ekonomično skladištiti petabajte istorijskih podataka? Može li se to uraditi bez štete vremenu odgovora na upit? Da li je moguće pristupiti svim metrima smeštenim na različitim Prometheus serverima putem jednog API upita? Može li se na neki način spojiti replikirani podaci prikupljeni pomoću Prometheus HA?
Da bismo rešili ta pitanja, stvorili smo Thanos. U narednim odeljcima objašnjavamo kako smo pristupili rešenju ovih pitanja i objašnjavamo ciljeve koje smo imali.
Upit podataka iz više instanci Prometheus-a (global query)
Prometheus nudi funkcionalan pristup šardiranju. Čak i jedan Prometheus server osigurava dovoljnu skalabilnost da oslobodi korisnike od složenosti horizontalnog šardiranja u praktički svim scenarijima korištenja.
Iako je ovo odličan model implementacije, često je potrebno pristupiti podacima na različitim Prometheus serverima kroz jedinstveni API ili korisničko sučelje — globalni pregled. Naravno, postoji mogućnost prikaza više upita u jednoj Grafana ploči, ali svaki upit se može izvršiti samo na jednom Prometheus serveru. S druge strane, pomoću Thanos-a možete zatražiti i agregirati podatke sa više Prometheus servera, jer su svi dostupni s jedne krajnje tačke.
Ranije, da bismo dobili globalni pregled u Improbableu, organizovali smo naše instance Prometheus-a u višeslojnu . To je podrazumijevalo kreiranje jednog meta-servera Prometheus koji prikuplja deo metrika sa svakog 'listnog' servera.
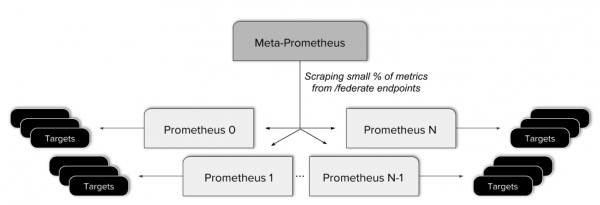
Ovaj pristup se pokazao problematičnim. Doveo je do komplikacije konfiguracije, dodavanja dodatne potencijalne tačke kvara i primene složenih pravila za pružanje federirane krajnje tačke samo sa potrebnim podacima. Osim toga, takva federacija ne omogućava pravilan globalni pregled, jer nisu svi podaci dostupni iz jednog API upita.
S ovim je usko povezana jedinstvena prezentacija podataka prikupljenih na visoko dostupnim (high-availability, HA) Prometheus serverima. HA model Prometheus samostalno prikuplja podatke dvaput, što je toliko jednostavno da jednostavnije ne može biti. Međutim, korišćenje objedinjene i de-duplikovane prezentacije oba toka bi bilo znatno praktičnije.
Naravno, u visoko dostupnim Prometheus serverima postoji potreba. U Improbableu zaista ozbiljno pristupamo minutnom praćenju podataka, ali imati jedan primjerak Prometheus-a na klasteru predstavlja jedinstvenu tačku kvara. Svaka greška u konfiguraciji ili kvar opreme potencijalno može dovesti do gubitka važnih podataka. Čak i jednostavna implementacija može dovesti do malih zastoja u prikupljanju metrika, budući da ponovo pokretanje može biti značajno duže od intervala preuzimanja.
Pouzdano skladištenje historijskih podataka
Jeftin, brz i dugoročan sistem za pohranu metrika je naš san (koji dijeli većina korisnika Prometheusa). U Improbable-u smo bili primorani postaviti rok pohrane metrika na devet dana (za Prometheus 1.8). To postavlja očigledna ograničenja na to koliko daleko možemo pogledati unazad.
Prometheus 2.0 je u tom smislu bolji, jer broj vremenskih serija više ne utiče na ukupne performanse servera (vidi ). Ipak, Prometheus pohranjuje podatke na lokalnom disku. Iako visoko efikasna kompresija podataka može značajno smanjiti upotrebu lokalnog SSD-a, na kraju ipak postoji ograničenje na količinu sačuvanih istorijskih podataka.
Osim toga, u Improbable-u brinemo o pouzdanosti, jednostavnosti i troškovima. Veliki lokalni diskovi su teži za upravljanje i rezervne kopije. Skupi su i zahtevaju više alata za rezervne kopije, što dovodi do dodatne složenosti.
Smanjenje uzorkovanja
Kada smo počeli raditi s istorijskim podacima, shvatili smo da postoje fundamentalni problemi s O-velikim, koji čine upite sve sporijim ako radimo s podacima iz nedelja, meseci i godina.
Standardno rešenje ovog problema bi bilo (downsampling) — smanjenje frekvencije uzorkovanja signala. Smanjenjem uzorkovanja možemo „smanjiti razmeru“ na duži vremenski opseg i održati istu količinu uzoraka, što će omogućiti očuvanje odzivne sposobnosti upita.
Smanjenje uzorkovanja starih podataka je neizbežan zahtev svakog rešenja za dugoročno skladištenje i prevazilazi vaniliju Prometheus-a.
Dodatni ciljevi
Jedan od prvobitnih ciljeva projekta Thanos bio je besprijekorna integracija sa postojećim instalacijama Prometheus-a. Drugi cilj bio je jednostavna upotreba s minimalnom barijerom ulaska. Sve zavisnosti treba lako zadovoljiti kako za male, tako i za velike korisnike, što takođe podrazumeva neznatne osnovne troškove.
Arhitektura Thanosa
Nakon što su u prethodnom odeljku navedeni naši ciljevi, hajde da radimo na njima i vidimo kako Thanos rešava te probleme.
Globalna perspektiva
Da bismo dobili globalni pregled postojećih instanci Prometheusa, treba da povežemo jedinstvenu tačku ulaza zahteva sa svim serverima. Time se bavi komponenta Thanos. . Deployuje se pored svakog Prometheus servera i funkcioniše kao proxy, opslužujući lokalne podatke Prometheus-a putem gRPC interfejsa Store API, koji omogućava pretragu vremenskih serija podataka prema oznakama i vremenskom intervalu.
S druge strane se nalazi horizontalno skalabilna komponenta Querier bez stanja, koja radi malo više od jednostavnog odgovaranja na PromQL zahteve putem standardnog Prometheus HTTP API-a. Komponente Querier, Sidecar i druge Thanos komponente međusobno komuniciraju putem .
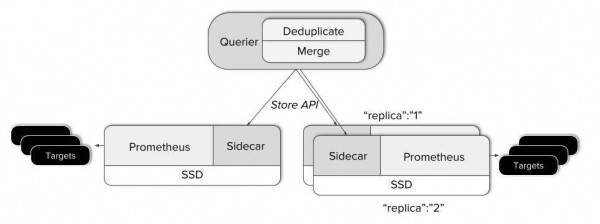
- Kada Querier primi zahtev, povezuje se sa odgovarajućim serverom Store API, tj. našim Sidecar-ima, i dobija vremenske serije podataka sa odgovarajućih Prometheus servera.
- Nakon toga kombinuje odgovore i izvršava PromQL zahtev na njima. Querier može da kombinuje kako nepovezane podatke, tako i duplicirane podatke sa HA Prometheus servera.
Ovo rešava najveći deo naše zagonetke — objedinjavanje podataka sa izolovanih Prometheus servera u jedinstveni prikaz. U suštini, Thanos se može koristiti samo zbog ove mogućnosti. Nema potrebe za izvršenjem bilo kakvih izmena na postojećim Prometheus serverima!
Neograničeno vreme skladištenja!
Međutim, pre ili kasnije, želećemo da sačuvamo podatke koji prevazilaze uobičajeno vreme skladištenja Prometheusa. Za skladištenje istorijskih podataka izabrali smo objektno skladište. Ono je široko dostupno u bilo kojem oblaku, kao i u lokalnim datacenters, i veoma je isplativo. Pored toga, skoro svako objektno skladište je dostupno putem dobro poznatog S3 API-a.
Prometheus upisuje podatke iz memorije na disk otprilike svaka dva sata. Blok sačuvanih podataka sadrži sve podatke za određeni vremenski interval i je nepromenljiv. To je veoma praktično, jer Thanos Sidecar može jednostavno pregledati folder sa podacima Prometheus-a i, kako nove blokove postaju dostupne, učitati ih u korpe objektnih skladišta.
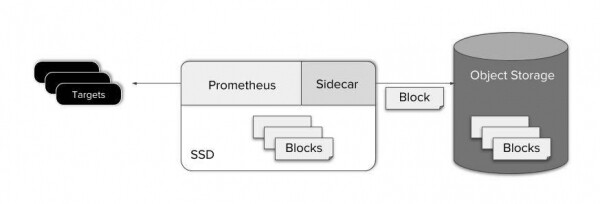
Učitavanje u objektno skladište odmah nakon upisa na disk takođe omogućava očuvanje jednostavnosti “skrapera” (Prometheus i Thanos Sidecar). To pojednostavljuje održavanje, troškove i dizajn sistema.
Kao što vidite, backup podataka se sprovodi veoma jednostavno. Ali šta je sa zahtevom za podacima u objektnom skladištu?
Thanos Store komponenta deluje kao proxy za dobijanje podataka iz objektnog skladišta. Kao i Thanos Sidecar, učestvuje u gossip klasteru i implementira Store API. Tako, postojeći Querier mogu ga posmatrati kao Sidecar, kao još jedan izvor time series podataka — ne zahteva nikakvu posebnu konfiguraciju.
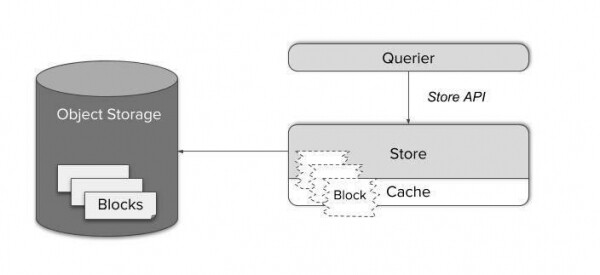
Blokovi time series podataka se sastoje od nekoliko velikih datoteka. Učitavanje po zahtevu bi bilo prilično neefikasno, a lokalno keširanje bi zahtevalo ogromnu memoriju i prostor na disku.
Umesto toga, Store Gateway zna kako da rukuje formatom skladišta Prometheus. Zahvaljujući pametnom planeru upita i keširanju samo neophodnih indeksnih delova blokova, moguće je smanjiti složene upite na minimalan broj HTTP zahteva prema datotekama objektnog skladišta. Tako možemo smanjiti broj zahteva za četiri do šest redova i postići vreme odziva koje je u suštini teško razlikovati od zahteva za podacima na lokalnom SSD-u.
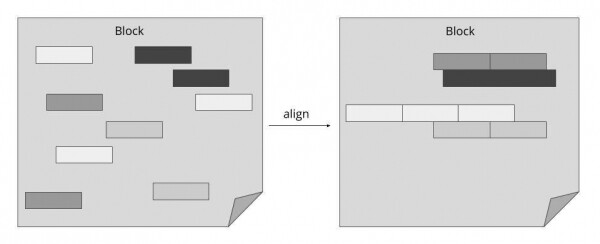
Kao što je prikazano na dijagramu iznad, Thanos Querier značajno smanjuje troškove po jednom zahtevu za podacima u objektnom skladištu, koristeći format skladišta Prometheus i postavljajući povezane podatke blizu. Koristeći ovaj pristup, možemo kombinovati mnoštvo pojedinačnih zahteva u minimalan broj bulk operacija.
Kompaktovanje i downsampling
Nakon što se novi blok time series podataka uspešno učita u objektnom skladištu, posmatramo ga kao "istorijske" podatke koji odmah postaju dostupni putem Store Gateway.
Međutim, nakon nekog vremena blokovi iz jednog izvora (Prometheus sa Sidecar) se akumuliraju i više ne koriste sav potencijal indeksiranja. Da bismo rešili ovaj problem, uveli smo još jednu komponentu nazvanu Compactor. Ona jednostavno primenjuje lokalni mehanizam kompaktovanja Prometheus na istorijske podatke u objektnom skladištu i može se pokrenuti kao jednostavna periodična paketna eksekucija.
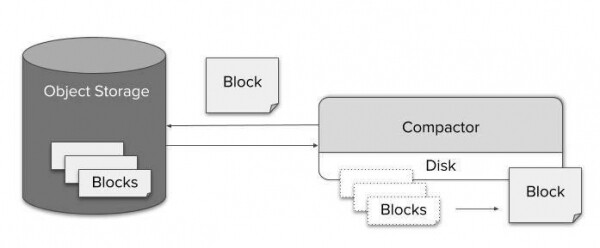
Zahvaljujući efikasnom kompresovanju, upit u skladište tokom dužeg vremenskog perioda ne predstavlja problem u smislu veličine podataka. Međutim, potencijalni trošak dekompresije milijarde vrednosti i njihovo prosleđivanje kroz obradu upita neizbežno će dovesti do naglog povećanja vremena izvršenja upita. S druge strane, pošto na svaku tačku ekrana dolazi stotine tačaka podataka, postaje nemoguće čak i vizualizovati podatke u punoj rezoluciji. Tako, daunsampling nije samo moguć, nego neće dovesti do primetnog gubitka tačnosti.
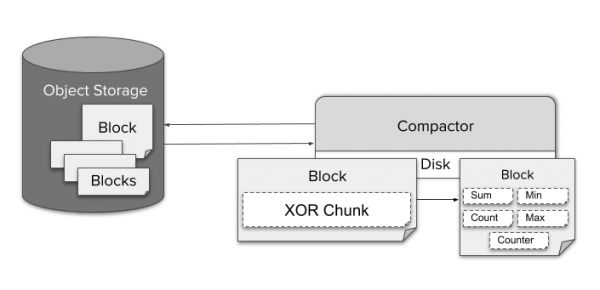
Za daunsampling podataka, Compactor kontinuirano agregira podatke sa rezolucijom od pet minuta i jednog sata. Za svaki neobrađeni fragment, kodiran pomoću TSDB XOR kompresije, čuvaju se različite vrste agregiranih podataka, kao što su min, max ili sum za jedan blok. To omogućava Querier-u automatski da izabere agregat koji odgovara datom PromQL upitu.
Za korišćenje podataka sa smanjenom preciznošću korisniku nije potrebna nikakva specijalna konfiguracija. Querier automatski prelazi između različitih rezolucija i neobrađenih podataka kako korisnik povećava ili smanjuje zoom. Ako želi, korisnik može direktno upravljati ovim putem parametra “step” u upitu.
Pošto je trošak skladištenja jednog GB mali, Thanos po defaultu čuva izvorne podatke, podatke sa rezolucijom od pet minuta i jednog sata. Nema potrebe za brisanjem izvornih podataka.
Recording pravila
Čak i sa Thanos-om, recording pravila su značajan deo monitorskog steka. Ona smanjuju složenost, kašnjenje i trošak upita. Takođe su korisna za korisnike da dobiju agregirane podatke po metrikama. Thanos se oslanja na vanilija instance Prometheusa, tako da je sasvim u redu čuvati recording pravila i alerting pravila na postojećem Prometheus serveru. Međutim, u nekim slučajevima, to može biti nedovoljno:
- Globalni alert i pravilo (na primer, upozorenje kada usluga ne radi na više od dva od tri klastera).
- Pravilo za podatke van lokalnog skladišta.
- Težnja da se sva pravila i alerti čuvaju na jednom mestu.
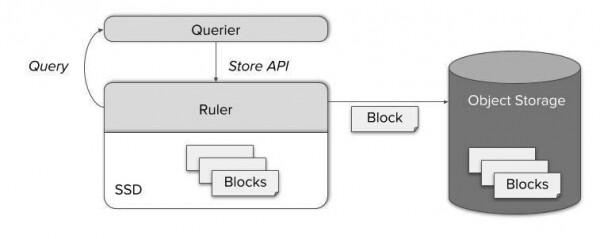
Za sve ove situacije, Thanos uključuje poseban komponent, nazvan Ruler, koji izračunava pravila i upozorenja putem Thanos Queries. Pružajući dobro poznati StoreAPI, Query čvor može pristupiti svežim izračunatim metrima. Kasnije se takođe čuvaju u objektnoj skladištu i postaju dostupni putem Store Gateway-a.
Moć Thanos-a
Thanos je dovoljno fleksibilan da se može prilagoditi vašim zahtevima. To je posebno korisno prilikom migracije sa jednostavnog Prometheusa. Hajde da se brzo podsetimo, na malom primeru, šta smo naučili o komponentama Thanos-a. Evo kako da prenesete vaš vanilasti Prometheus u svet “neograničenog skladištenja metrika”:
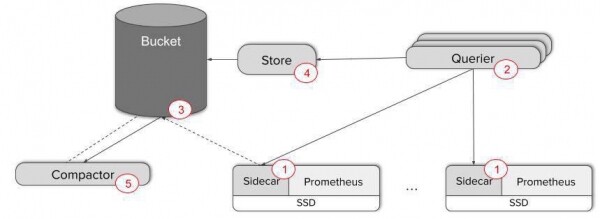
- Dodajte Thanos Sidecar na vaše Prometheus servere — na primer, kao susedni kontejner u Kubernetes pod.
- Razvijte više kopija Thanos Querier-a za pregled podataka. U ovoj fazi je lako postaviti gossip između Scraper-a i Querier-a. Za proveru interakcije komponenti koristite metriku ‘thanos_cluster_members’.
Samo ova dva koraka su dovoljna da obezbede globalni pregled i besprekornu deduplifikaciju podataka od potencijalnih HA kopija Prometheusa! Jednostavno povežite svoje dashboarde sa HTTP Querier-ovim krajnjim tačkama ili koristite Thanos UI interfejs direktno.
Međutim, ako vam je potrebna zaštita metrika i dugoročno skladištenje, moraćete da uradite još tri koraka:
- Kreirajte AWS S3 ili GCS bucket. Podesite Sidecar za kopiranje podataka u te buckete. Sada možete minimizovati lokalno skladištenje podataka.
- Razvijte Store Gateway i povežite ga sa postojećim gossip klasterom. Sada možete slati zahteve za podatke iz rezervnih kopija!
- Razvijte Compactor kako biste poboljšali efikasnost upita za duže vremenske intervale, koristeći kompresiju i downsampling.
Ako želite da saznate više, slobodno pogledajte naše i !
U samo pet koraka, pretvorili smo Prometheus u pouzdan sistem monitoringa sa globalnim pregledom, neograničenim vremenom skladištenja i potencijalnom visokom dostupnošću metrika.
Pull request: potrebni ste nam!
od samog početka je bio projekat sa otvorenim kodom. Besprekorno integrisanje sa Prometheus-om i mogućnost korišćenja samo dela Thanos-a čini ga odličnim izborom za skaliranje sistema monitoringa bez dodatnih napora.
Uvijek nam je drago primiti GitHub Pull Request i Issues. U isto vrijeme, slobodno nas kontaktirajte putem Github Issues ili Slack-a., ako imate pitanja ili povratne informacije, ili želite podijeliti svoje iskustvo! Ako vam se sviđa ono što radimo u Improbable, slobodno nam se obratite — !
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish