

SQL, šta može biti jednostavnije? Svako od nas može napisati jednostavan upit — jednostavno upišemo select, nabrajam potrebne kolone, potom from, ime tabele, malo uslova u gdje i to je to — korisni podaci su kod nas, praktično nezavisno od toga koja SODB trenutno radi u pozadini (a možda i ). Rezultat je da se rad sa gotovo bilo kojim izvorom podataka (relacijskim i drugim) može posmatrati sa stanovišta običnog koda (sa svim posljedicama — kontrola verzija, revizija koda, statička analiza, automatski testovi i sve to). I to se ne odnosi samo na same podatke, sheme i migracije, već na celokupno poslovanje skladišta. U ovom članku ćemo govoriti o svakodnevnim zadacima i problemima rada sa raznim BD pod pritiskom "baze podataka kao koda".
I započećemo odmah sa . Prvi sukobi tipa "SQL protiv ORM" primeti su još u .
Objektno-relacijsko mapiranje
Zagovornici ORM-a tradicionalno cene brzinu i jednostavnost razvoja, nezavisnost od SODB i čistoću koda. Za mnoge od nas kod rada sa BD (a često i sama BD)
obično izgleda otprilike ovako…
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
Model je obeležen pametnim anotacijama, a negde iza scene časni ORM generiše i izvršava tone nekog SQL koda. Usput rečeno, programeri se svim silama pokušavaju ograničiti od svoje BD kilometrima apstrakcija, što govori o nekoj .
S druge strane barikada, proponenti čistog "ručno rađenog" SQL-a ističu mogućnost istiskivanja svih sokova iz svoje SODB bez dodatnih slojeva i apstrakcija. Rezultat su "data-centric" projekti, gde se bazom bave posebno obučeni ljudi (oni su "bazisti", oni su "bazovici", oni su "bazdenci", itd.), dok programerima ostaje samo da "povuku" gotove prikaze i sačuvane procedure, ne zalazeći u detalje.
A šta ako uzmemo najbolje iz dva sveta? Kao što je to učinjeno u fantastičnom alatu sa afirmativnim nazivom . Navešću nekoliko rečenica iz opšte koncepcije u mom slobodnom prevodu, a detaljnije se može upoznati sa njom .
Clojure je izvrsan jezik za kreiranje DSL-ova, ali SQL je već sam po sebi odličan DSL, i ne trebamo još jedan. S-izrazi su divni, ali ovdje ne donose ništa novo. Na kraju dobijamo zagrade samo radi zagrada. Ne slažete se? Tada pričekajte trenutak kada apstrakcija nad bazom podataka počne propuštati, i započećete borbu sa funkcijom. (raw-sql)
Šta raditi? Ostavimo SQL kao običan SQL — jedan fajl za jedan upit:
-- ime: korisnici-po-državi
select *
  from users
 where country_code = :country_code
… a zatim pročitajte ovaj fajl, pretvarajući ga u običnu Clojure funkciju:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; Funkcija imenom `users-by-country` je kreirana.
;;; Koristimo je:
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
Pridržavajući se načela "SQL odvojeno, Clojure odvojeno", dobijate:
- Bez sintaktičkih iznenađenja. Vaša baza podataka (kao i svaka druga) ne odgovara SQL standardu 100% — ali za Yesql to nije važno. Nikada nećete trošiti vreme na traženje funkcija sa sintaksom ekvivalentnom SQL-u. Nikada se nećete morati vraćati na funkciju (raw-sql "some (‘funky’ :: SYNTAX)")).
- Najbolja podrška uređivaču. Vaš uređivač već ima odličnu podršku za SQL. Čuvajući SQL kao SQL, jednostavno ga možete koristiti.
- Kompatibilnost sa timom. Vaši DBA-ovi mogu čitati i pisati SQL koji koristite u svom Clojure projektu.
- Jednostavnija podešavanja performansi. Potrebno je izraditi plan za problematičan upit? Nema problema, kada je vaš upit običan SQL.
- Ponovno korišćenje upita. Povedite iste SQL-fajlove u druge projekte, jer je to jednostavno stari dobri SQL — jednostavno ih podelite.
Po mom mišljenju, ideja je veoma cool i istovremeno jednostavna, što je omogućilo projektu da dobije brojne na raznim jezicima. A mi ćemo dalje pokušati primeniti sličnu filozofiju odvajanja SQL koda od svega ostalog daleko izvan ORM-a.
IDE & DB-upravljači
Počnimo s jednostavnom svakodnevnom zadaćom. Često moramo tražiti određene objekte u bazi podataka, na primjer, pronaći tabelu u shemi i proučiti njenu strukturu (koje kolone, ključevi, indeksi, ograničenja i drugo se koriste). Od svake grafičke IDE ili barem osnovnog DB-managera najprije očekujemo upravo te mogućnosti. Da bude brzo i da ne moramo čekati pola sata dok se ne otvori prozor s potrebnim informacijama (osobito pri sporoj vezi s udaljenom bazom podataka), a osim toga, da dobijene informacije budu svježe i aktuelne, a ne keširane starine. Što je složenija i veća baza podataka i što je veći broj njih, to je teže to postići.
Ali obično odbacim miš negdje i jednostavno pišem kod. Recimo, potrebno je saznati koje tabele (i s kojim svojstvima) se nalaze u shemi "HR". U većini SGBD-a željeni rezultat može se postići jednostavnim upitom iz information_schema:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
Od baze do baze sadržaj takvih tabela-referenci varira ovisno o sposobnostima svake SGBD. I, na primjer, za MySQL iz ovog iste referentne osobe možemo dobiti specifične za ovu SGBD parametre tabele:
select table_name
     , storage_engine -- Korisni "motor" ("MyISAM", "InnoDB" itd.)
     , row_format     -- Format reda ("Fixed", "Dynamic" itd.)
     , ...
  from information_schema.tables
 where schema = 'HR'
Oracle ne može koristiti information_schema, ali ima , i ne nastaju velike probleme:
select table_name
     , pct_free       -- Minimum slobodnog prostora u podatkovnom bloku (%)
     , pct_used       -- Minimum korištenog prostora u podatkovnom bloku (%)
     , last_analyzed  -- Datum posljednjeg prikupljanja statistike
     , ...
  from all_tables
 where owner = 'HR'
Nije izuzetak ni ClickHouse:
select name
     , engine -- Korisni "motor" ("MergeTree", "Dictionary" itd.)
     , ...
  from system.tables
 where database = 'HR'
Sličnu stvar možemo učiniti i u Cassandri (gdje postoje columnfamilies umjesto tabela i keyspace-ovi umjesto shema):
select columnfamily_name
     , compaction_strategy_class  -- Strategija skupljanja smeća
     , gc_grace_seconds           -- Vrijeme života smeća
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
Za većinu ostalih baza podataka također se mogu smisliti slični upiti (čak i u Mongo postoje , koja sadrži informacije o svim kolekcijama u sistemu).
Naravno, na ovaj način možete dobiti informacije ne samo o tabelama, već i o bilo kojem objektu. Povremeno, dobri ljudi dijele takve kodove za različite baze podataka, kao što je, na primjer, u seriji članaka na Habr-u 'Funkcije za dokumentiranje PostgreSQL baza podataka' (, , ). Naravno, držati svih ovih mnogo upita u glavi i stalno ih unositi - to nije "veliko zadovoljstvo", pa u svom omiljenom IDE-u/uredniku imam unaprijed pripremljen set snippeta za često korištene upite, i ostaje samo da upišem imena objekata u šablon.
U konačnici, ovakav način navigacije i pretraživanja objekata je mnogo fleksibilniji, štedi puno vremena i omogućava vam da dobijete upravo one informacije i u onom obliku koji vam je sada potreban (kao što je, na primjer, opisano u postu ).
Operacije sa objektima
Nakon što smo pronašli i proučili potrebne objekte, pravo je vrijeme da s njima učinimo nešto korisno. Naravno, također ne podižući prste sa tastature.
Nije tajna da će jednostavno brisanje tabele izgledati gotovo identično u svim bazama podataka:
drop table hr.personsA kada je u pitanju kreiranje tabele, situacija već postaje zanimljivija. Praktično svaka DBMS (uključujući i mnoge NoSQL) na neki način podržava 'create table', a većina njegovih dijelova će se malo razlikovati (ime, lista kolona, tipovi podataka), ali ostali detalji mogu se drastično razlikovati i zavise od unutrašnje strukture i mogućnosti konkretne DBMS. Moj omiljeni primjer - u dokumentaciji Oracle-a samo jedni 'goli' BNF-ovi za sintaksu 'create table' . Druge DBMS imaju skromnije mogućnosti, ali svaka od njih takođe poseduje mnoštvo zanimljivih i jedinstvenih karakteristika za kreiranje tabela (, , , ). Teško da će bilo koji grafički 'wizard' iz nove IDE (posebno univerzalne) moći potpuno pokriti sve ove mogućnosti, a ako i može, to će biti prizor koji nije za slabe nerve. U isto vrijeme, pravilno i na vreme napisan operator create table omogućiće vam da lako iskoristite sve njih, učinite čuvanje i pristup vašim podacima pouzdanim, optimalnim i maksimalno udobnim.
Također, u mnogim DBMS-ima postoje specifične vrste objekata koje nedostaju u drugim DBMS-ima. Osim toga, možemo izvoditi operacije ne samo nad objektima baze podataka, već i nad samim DBMS-om, na primjer, "ubiti" proces, osloboditi određeno područje memorije, uključiti praćenje, preći u "read only" režim i mnogo više.
A sada malo da crtamo
Jedan od najčešćih zadataka je izgradnja dijagrama s objektima baze podataka, kako bismo na lijepoj slici vidjeli objekte i veze između njih. To može gotovo svaka grafička IDE, pojedine "command line" alatke, specijalizirani grafički alati i modelari. Koji će vam nešto nacrtati "kako znaju", a blago uticati na ovaj proces može se učiniti samo pomoću nekoliko parametara u konfiguracijskoj datoteci ili odabirom u interfejsu.
Međutim, ovaj problem može se riješiti mnogo jednostavnije, fleksibilnije i elegantrnije, naravno uz pomoć koda. Za izgradnju dijagrama bilo koje složenosti imamo nekoliko specijaliziranih jezika za označavanje (DOT, GraphML itd.), a uz njih cijeli niz aplikacija (GraphViz, PlantUML, Mermaid) koje mogu čitati takve upute i vizualizirati ih u raznim formatima. A informacije o objektima i vezama između njih već znamo kako dobiti.
Prikažimo mali primjer onoga kako bi to moglo izgledati, koristeći PlantUML i (s lijeve strane SQL upit koji generira potrebnu uputu za PlantUML, a s desne strane rezultat):
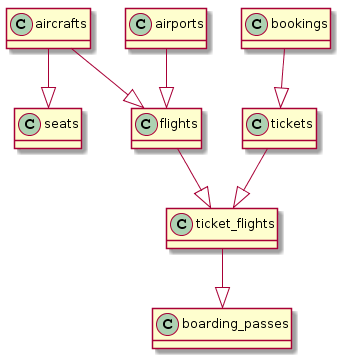
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
A ako se malo potrudimo, možemo na osnovu dobiti nešto što liči na pravi ER-dijagram:
SQL upit malo složeniji
-- Naslov
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Tabele
select format('Table(%s, "%s n informacije o %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Veze između tabela
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "A %s može imati mnogo %s"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Podnožje
select '@enduml' 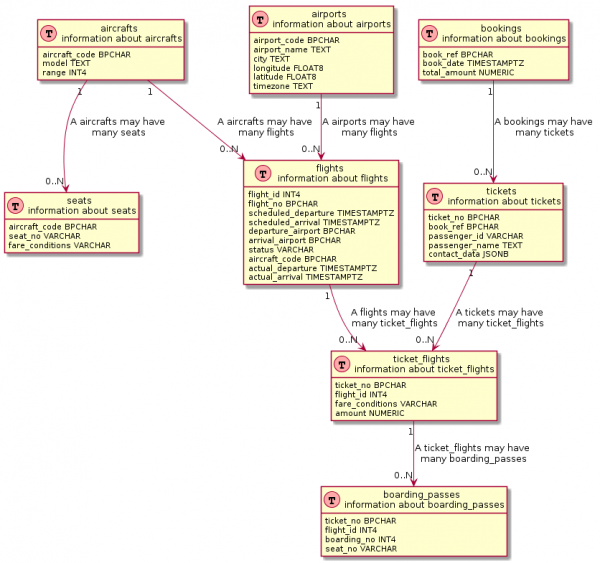
Ako pažljivo pogledamo, mnogi alati za vizualizaciju koriste slične upite. Međutim, ti upiti obično su duboko , a da ne spominjemo bilo kakvu modifikaciju.
Metrije i monitoring
Preći ćemo na tradicionalno složenu temu — praćenje performansi Baze Podataka. Setit ću se male istinite priče koju mi je ispričao "jedan moj prijatelj". Na jednom projektu postojala je moćna DBA osoba, i malo ko od programera ju je lično poznavao, a ni video je nije (uostalom, pričalo se da radi negde u susednoj zgradi). U kritičnom trenutku, kada je produkcijski sistem velikog maloprodajnog lanca počinjao ponovo da "slabo funkcioniše", on je tiho slao slike grafikona iz Oracle Enterprise Manager-a, na kojima su kritična mesta bila pažljivo istaknuta crvenom olovkom za "razumljivost" (to, blago rečeno, nije mnogo pomagalo). I tako je prema ovoj "fotografiji" trebalo rešavati problem. Pri tom, niko nije imao pristup dragocenom (u oba smisla te reči) Enterprise Manager-u, jer je sistem složen i skup, a ko zna — "programeri bi mogli nešto da pokvare". Stoga su programeri "empirijski" pronalazili mesto i uzrok usporavanja i izdavali zakrpu. Ako zastrašujuće pismo od DBA nije ponovo stizalo u bliskoj budućnosti, svi su sa olakšanjem uzdahnuli i vraćali se svojim trenutnim zadacima (do novog Pisma).
Ali proces praćenja može izgledati veselije i prijateljskije, a najvažnije — dostupno i transparentno za sve. Ispod osnovnog dela, kao dodatak glavnim sistemima praćenja (koji su nedvosmisleno korisni i u mnogim slučajevima nezamenljivi). Svaka DBMS slobodno i potpuno besplatno želi da podeli informacije o svom trenutnom stanju i performansama. U istoj "krvavoj" Oracle DB gotovo sve informacije o performansama mogu se dobiti iz sistemskih prikaza, počevši od procesa i sesija pa do stanja bafer keša (na primer, , deo "Praćenje"). U Postgresql-u takođe postoji čitav niz sistemskih prikaza za , posebno neophodni u svakodnevnom životu svakog DBA, kao što su , , . U MySQL-u za to postoji čak i poseban šema . A u MongoDB-u je ugrađeni koji agnegrira podatke o performansama u sistemsku kolekciju .
Dakle, opremljeni nekim skanerom metrika (Telegraf, Metricbeat, Collectd), koji može izvoditi prilagođene sql upite, skladištem tih metrika (InfluxDB, Elasticsearch, Timescaledb) i vizualizatorom (Grafana, Kibana), možemo dobiti prilično lagan i fleksibilan sistem za nadzor, koji će biti usko integriran s drugim općim sistemskim metrikama (dobijenim, na primjer, sa serverskih aplikacija, iz OS-a itd.). Kao što je to ostvareno u pgwatch2, gdje se koristi kombinacija InfluxDB + Grafana i skup upita na sistemskim prikazima, kojima se takođe mogu .
U ukupnom zbiru
I ovo je samo približan popis onoga što se može učiniti s našom bazom podataka putem običnog SQL koda. Uvjeravam vas, sigurno možete pronaći još mnogo primjena, pišite u komentarima. A o tome kako (i što je najvažnije zašto) automatizirati i uključiti sve to u svoj CI/CD pipeline razgovarat ćemo sljedeći put.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish