

Prije pola godine — javni za PostgreSQL.
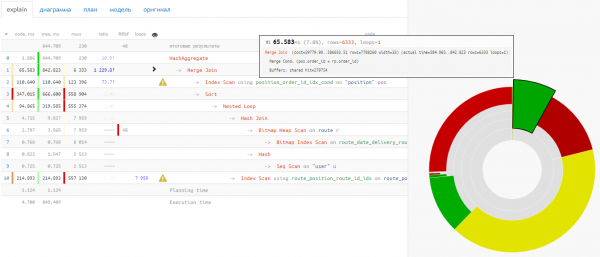
Tokom proteklih meseci, napravili smo izveštaj o njemu , pripremili sažetak na temelju preporuka koje daje… ali najvažnije — prikupili smo vaše povratne informacije i pratili stvarne upotrebe.
I sada smo spremni da vas obavestimo o novim mogućnostima koje možete iskoristiti.
Podrška za različite formate planova
Plan iz loga, zajedno sa upitom
Direktno iz konzole ističemo ceo blok, počevši od reda sa Query Text, sa svim vodećim razmacima:
        Query Text: INSERT INTO  dicquery_20200604  VALUES ($1.*) ON CONFLICT (query)
                           DO NOTHING;
        Insert on dicquery_20200604  (cost=0.00..0.05 rows=1 width=52) (actual time=40.376..40.376 rows=0 loops=1)
          Conflict Resolution: NOTHING
          Conflict Arbiter Indexes: dicquery_20200604_pkey
          Tuples Inserted: 1
          Conflicting Tuples: 0
          Buffers: shared hit=9 read=1 dirtied=1
          ->  Result  (cost=0.00..0.05 rows=1 width=52) (actual time=0.001..0.001 rows=1 loops=1)
… i kopiramo sve direktno u polje za plan, ne deleći ništa:
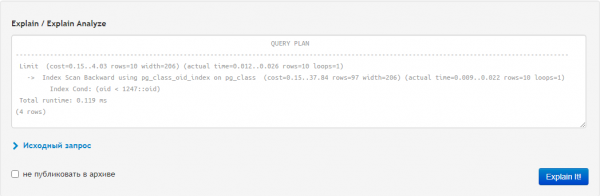
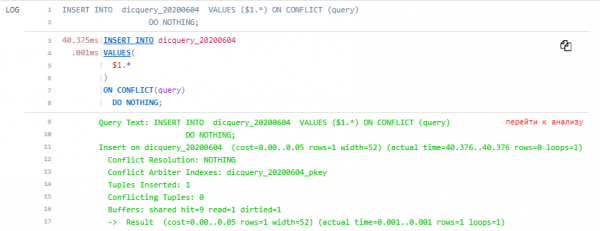
Na izlazu dobijamo dodatak razrađenoj planu i tab koji se zove «kontekst», gde je naš upit prikazan u svoj svojoj lepoti:
JSON i YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM pg_class;
"[
{
"Plan": {
"Node Type": "Seq Scan",
"Parallel Aware": false,
"Relation Name": "pg_class",
"Alias": "pg_class",
"Startup Cost": 0.00,
"Total Cost": 1336.20,
"Plan Rows": 13804,
"Plan Width": 539,
"Actual Startup Time": 0.006,
"Actual Total Time": 1.838,
"Actual Rows": 10266,
"Actual Loops": 1,
"Shared Hit Blocks": 646,
"Shared Read Blocks": 0,
"Shared Dirtied Blocks": 0,
"Shared Written Blocks": 0,
"Local Hit Blocks": 0,
"Local Read Blocks": 0,
"Local Dirtied Blocks": 0,
"Local Written Blocks": 0,
"Temp Read Blocks": 0,
"Temp Written Blocks": 0
},
"Planning Time": 5.135,
"Triggers": [
],
"Execution Time": 2.389
}
]"Bilo sa spoljnim navodnicima, kao što kopira pgAdmin, ili bez — kopiramo u isto polje, na izlazu — lepota:
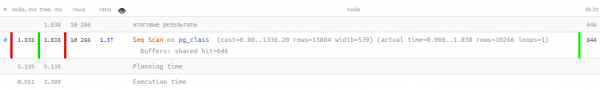
Proširena vizualizacija
Vreme planiranja / Vreme izvršavanja
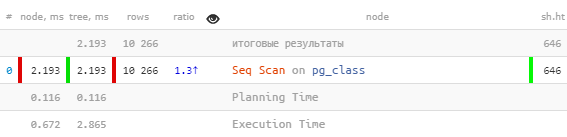
Sada je bolje videti gde je dodatno vreme otišlo tokom izvršavanja upita:
I/O Timing
Ponekad se moramo suočiti sa situacijom kada u planu izgleda kao da se resursi nisu previše koristili za čitanje ili pisanje, ali vreme izvršenja je naizgled preveliko.
Ovde moramo reći: "Oh, verovatno je u tom trenutku disk na serveru bio preopterećen, pa se čitalo tako dugotrajno!" Ali to nije previše tačno…
Međutim, to se može odrediti apsolutno pouzdano. Radi se o tome da među opcijama konfiguracije PG servera postoji :
Uključuje mjerenje vremena ulazno/izlaznih operacija. Ova opcija je po defaultu isključena, jer za to treba stalno tražiti trenutno vrijeme od operativnog sistema, što može značajno usporiti rad na nekim platformama. Za procjenu troškova mjerenja vremena na vašoj platformi možete koristiti alatku pg_test_timing. Statistiku ulazno/izlaznih operacija možete dobiti kroz prikaz pg_stat_database, u izlazu EXPLAIN (kada se koristi opcija BUFFERS) i kroz prikaz pg_stat_statements.
Ovu opciju možete uključiti i unutar lokalne sesije:
SET track_io_timing = TRUE;A sada dolazi najzanimljiviji deo - naučili smo da razumemo i prikažemo ove podatke uzimajući u obzir sve transformacije stabla izvršavanja:
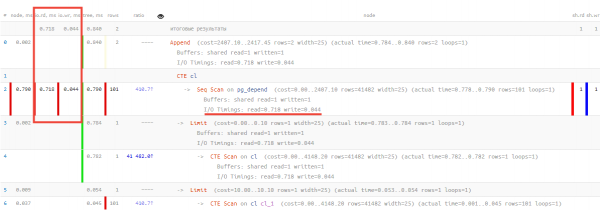
Ovde možete primijetiti da je od 0.790ms ukupnog vremena izvršavanja, 0.718ms trajalo čitanje jedne stranice podataka, 0.044ms - pisanje iste, dok je na sve ostale korisne aktivnosti utrošeno samo 0.028ms!
Budućnost sa PostgreSQL 13
Kompletan pregled novina možete pronaći , a mi ćemo se konkretno osvrnuti na promjene u planovima.
Planiranje bafera
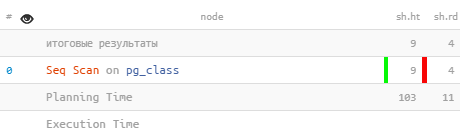
Uzimanje u obzir resursa dodeljenih planerima, našlo je svoje odraze još u jednoj zakrpi koja se ne odnosi na pg_stat_statements. EXPLAIN sa opcijom BUFFERS će prijaviti broj bafera korišćenih u fazi planiranja:
 Sekvencijalno skeniranje pg_class (stvarni redovi=386 petlje=1)
   Baferi: zajednički hit=9 pročitao=4
 Vreme planiranja: 0.782 ms
   Baferi: zajednički hit=103 pročitao=11
 Vreme izvršavanja: 0.219 ms
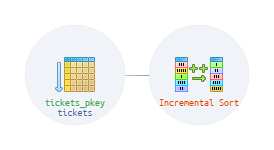
Inkremetno sortiranje
U slučajevima kada je potrebno sortirati po više ključeva (k1, k2, k3…), planer sada može iskoristiti znanje da su podaci već sortirani po nekoliko od prva dva ključa (npr. k1 i k2). U ovom slučaju, nije potrebno ponovo sortirati sve podatke, već ih može podeliti u sekvencijalne grupe sa istim vrednostima k1 i k2 i "dovršiti" sortiranje po ključu k3.
Na taj način, cijelo sortiranje se raspada na nekoliko sekvencijalnih sortiranja manjeg obima. To smanjuje potrebnu memoriju, a također omogućava prikazivanje prvih podataka ranije, pre nego što bude izvršeno potpuno sortiranje.
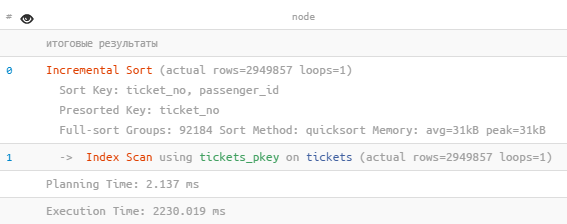
 Inkrementalna Sortacija (stvarni redovi=2949857 ciklusa=1)
   Ključ Sortiranja: ticket_no, passenger_id
   Prethodno sortirani ključ: ticket_no
   Grupe za punu sortaciju: 92184 Metoda Sortiranja: brza sortacija Memorija: prosječno=31kB vrhunac=31kB
   ->  Indeksno pretraživanje koristeći tickets_pkey na tickets (stvarni redovi=2949857 ciklusa=1)
 Vrijeme Planiranja: 2.137 ms
 Vrijeme Izvršavanja: 2230.019 ms
Poboljšanja UI/UX
Screenshotovi, svuda su!
Sada je na svakoj kartici dostupna brzo uzeti screenshot kartice u međuspremnik u punoj širini i dubini kartice — „cirkon“ desno-gore:
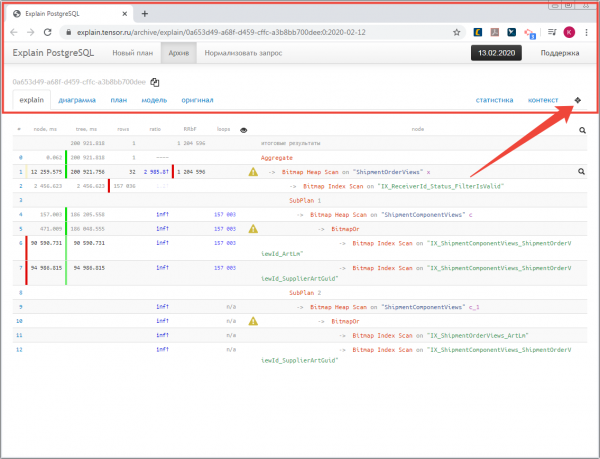
U osnovi, većina slika za ovu publikaciju dobivena je upravo tako.
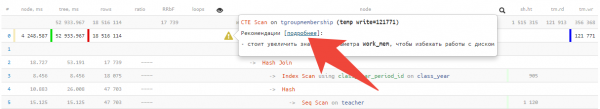
Preporuke na čvorovima
Nije ih samo više, već o svakoj možete , prelazom na link:
Brisanje iz arhiva
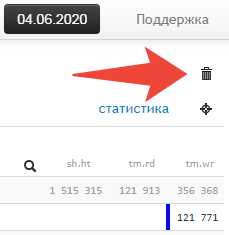
Neki su jako tražili dodavanje mogućnosti da se „potpuno“ uklone čak i neobjavljeni planovi u arhivu — molim vas, dovoljno je pritisnuti odgovarajuću ikonu:
Pa, ne zaboravimo da imamo , gdje možete slati svoja zapažanja i prijedloge.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish