

Mi smo u Badoo-u stalno u toku sa novim tehnologijama i procjenjujemo da li ih treba koristiti u našem sistemu. Želimo da podijelimo jedno od takvih istraživanja sa zajednicom. Ono je posvećeno Loki - sistemu za agregaciju logova.
Loki je rešenje za skladištenje i pregled logova, a takođe ovaj stek pruža fleksibilan sistem za analizu i slanje podataka u Prometheus. U maju je objavljeno novo ažuriranje koje aktivno promovišu kreatori. Zanimalo nas je šta Loki može, koje mogućnosti pruža i u kojoj meri može biti alternativa ELK - steku koji trenutno koristimo.
Šta je Loki
Grafana Loki je skup komponenti za potpuni rad sa logovima. Za razliku od drugih sličnih sistema, Loki se oslanja na ideju indeksiranja samo metapodataka logova - oznaka (labels) (kao i u Prometheusu), dok se sami logovi kompresuju u odvojene delove.
,
Pre nego što pređem na opis mogućnosti korišćenja Lokija, želim da objasnim šta se podrazumeva pod "idejom indeksiranja samo metapodataka". Uporedićemo pristup Lokija i pristup indeksiranju u tradicionalnim rešenjima, poput Elastica, na primeru jednog reda iz nginx loga:
172.19.0.4 - - [01/Jun/2020:12:05:03 +0000] "GET /purchase?user_id=75146478&item_id=34234 HTTP/1.1" 500 8102 "-" "Stub_Bot/3.0" "0.001"Tradicionalni sistemi analiziraju cijelu liniju, uključujući polja sa velikim brojem jedinstvenih vrednosti user_id i item_id, i sve čuvaju u velikim indeksima. Prednost ovog pristupa je u tome što se složeni upiti mogu izvoditi brzo, jer je skoro sve podatke - u indeksu. Međutim, to dolazi po cijenu povećanja veličine indeksa, što dovodi do zahtjeva za memorijom. Na kraju, puni tekstualni indeks logova je uporediv po veličini sa samim logovima. Da bi se brže pretraživalo, indeks mora biti učitan u memoriju. I što je više logova, brže indeks raste i više memorije troši.
Loki pristup zahtijeva da se iz stringa izvuku samo potrebni podaci, čija količina nije velika. Tako dobijamo mali indeks i možemo pretraživati podatke filtrirajući ih prema vremenu i prema algoritmima indeksa, a zatim skenirajući preostale regularnim izrazima ili pretragom podstringa. Proces se čini ne najbržim, ali Loki deli upit na više delova i izvršava ih paralelno, obrađujući veliku količinu podataka u kratkom vremenskom periodu. Broj shardova i paralelnih upita u njima se može podesiti; tako količina podataka koja se može obraditi u jedinici vremena linearno zavisi od količine dostupnih resursa.
Ova kompromis između velikog brzog indeksa i malog indeksa s paralelnim punim pretraživanjem omogućuje Lokiju da kontroliše troškove sistema. Može se fleksibilno konfigurirati i proširiti prema potrebama.
Loki stack se sastoji od tri komponente: Promtail, Loki, Grafana. Promtail prikuplja logove, obrađuje ih i šalje u Loki. Loki ih čuva. A Grafana može zahtevati podatke iz Lokija i prikazati ih. U suštini, Loki se može koristiti ne samo za skladištenje logova i pretraživanje istih. Cijeli stack daje velike mogućnosti za obradu i analizu dolaznih podataka koristeći Prometheus način.
Opis procesa instalacije možete pronaći .
Pretraživanje logova
Pretraživanje logova može se obaviti u posebnom interfejsu Grafana — Explorer. Za upite se koristi jezik LogQL, vrlo sličan PromQL-u koji se koristi u Prometheus-u. U principu, može se smatrati distribuiranim grep-om.
Interfejs za pretraživanje izgleda ovako:
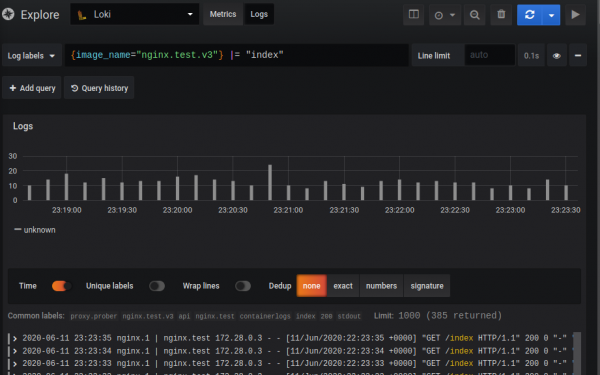
Sam upit se sastoji od dva dela: selector i filter. Selector — to je pretraga po indeksiranim metapodacima (etiketama) koji su dodeljeni logovima, a filter — to je pretraživačka string ili regex, pomoću kojeg se filtriraju unosi određeni selektorom. U datom primeru: U vitičastim zagradama — selektor, sve što je nakon — filter.
{image_name="nginx.promtail.test"} |= "index"Zbog principa rada Lokija nije moguće praviti upite bez selektora, ali etikete se mogu praviti koliko god opštima.
Selector — to su key-value vrednosti u vitičastim zagradama. Možete kombinovati selektore i postavljati različite uslove pretrage koristeći operatore =, != ili regularne izraze:
{instance=~"kafka-[23]",name!="kafka-dev"}
// Pronaći će logove s oznakom instance, koji imaju vrijednosti kafka-2, kafka-3, i isključiti dev
Filter je tekst ili regex koji će filtrirati sve podatke koje je dobio selektor.
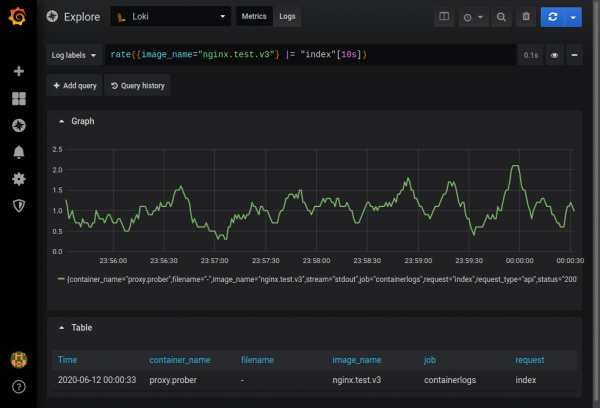
Postoji mogućnost dobijanja ad-hoc grafika na temelju dobijenih podataka u režimu metrics. Na primjer, može se saznati učestalost pojavljivanja u logovima nginx zapisa koji sadrže string index:
Potpuni opis mogućnosti može se pronaći u dokumentaciji .
Parsiranje logova
Postoji nekoliko načina za prikupljanje logova:
- Pomoću Promtail-a, standardne komponente stoga za prikupljanje logova.
- Direktno iz Docker kontejnera pomoću
- Koristiti Fluentd ili Fluent Bit, koji mogu slati podatke u Loki. Za razliku od Promtail-a, oni imaju spremne parsere praktički za svaku vrstu loga i također se nose s multiline logovima.
Obično se za parsiranje koristi Promtail. On radi tri stvari:
- Pronalazi izvore podataka.
- Pridružuje im oznake.
- Šalje podatke u Loki.
Trenutno Promtail može čitati logove s lokalnih datoteka i iz systemd journal-a. Mora biti instaliran na svakoj mašini s koje se prikupljaju logovi.
Postoji integracija s Kubernetes-om: Promtail automatski putem Kubernetes REST API-ja saznaje stanje klastera i prikuplja logove s node-a, servisa ili poda, odmah dodjeljujući oznake na osnovu metapodataka iz Kubernetesa (ime poda, ime datoteke itd.).
Također se mogu dodjeljivati oznake na osnovu podataka iz loga putem Pipeline-a. Pipeline Promtail-a može se sastojati od četiri tipa faza. Detaljnije u , ovdje ću napomenuti neke nijanse.
- Faze parsiranja. Ovo je faza RegEx i JSON. U ovoj fazi izvlačimo podatke iz logova u takozvanu extracted map. Izvlačiti možemo iz JSON-a, jednostavno kopirajući nam potrebna polja u extracted map, ili putem regularnih izraza (RegEx), gdje se u extracted map “mapiraju” named groups. Extracted map predstavlja key-value skladište, gdje je key ime polja, a value njegova vrijednost iz logova.
- Faze transformacije. Ova faza ima dvije opcije: transform, gde postavljamo pravila transformacije, i source — izvor podataka za transformaciju iz extracted map. Ako u extracted map nema takvog polja, biće kreirano. Tako možemo kreirati oznake koje nisu zasnovane na extracted map. U ovoj fazi možemo manipulisati podacima u extracted map koristeći dovoljno moćan . Također, važno je napomenuti da se extracted map u potpunosti učitava prilikom parsiranja, što omogućava, na primjer, provjeru vrijednosti unutar nje: “{{if .tag}tag value exists{end}}”. Predložak podržava uvjete, petlje i određene funkcije za stringove, poput Replace i Trim.
- Faze akcije. U ovoj fazi možete nešto učiniti s izvučenim podacima:
- Kreirati oznaku iz extracted data koja će biti indeksirana u Loki.
- Promijeniti ili postaviti vrijeme događaja iz zapisnika.
- Izmijeniti podatke (tekst zapisnika) koji će otići u Loki.
- Kreirati metrike.
- Faze filtriranja. Faza match, gdje možete ili poslati u /dev/null zapise koji nam nisu potrebni, ili ih uputiti na dalju obradu.
Pokažem na primjeru obrade običnih nginx-logs kako se mogu parsirati logovi koristeći Promtail.
Za test ćemo koristiti kao nginx-proxy modificiranu sliku nginx jwilder/nginx-proxy:alpine i mali demon koji može postavljati HTTP zahtjeve samom sebi. Demonu su postavljeni neki endpointi na koje može davati odgovore različitih veličina, s različitim HTTP statusima i s različitim kašnjenjima.
Prikupljati ćemo logove s docker kontejnera koji se nalaze na putu /var/lib/docker/containers//-json.log
U docker-compose.yml podešavamo Promtail i navodimo put do konfiguracije:
promtail:
  image: grafana/promtail:1.4.1
 // ...
 volumes:
   - /var/lib/docker/containers:/var/lib/docker/containers:ro
   - promtail-data:/var/lib/promtail/positions
   - ${PWD}/promtail/docker.yml:/etc/promtail/promtail.yml
 command:
   - '-config.file=/etc/promtail/promtail.yml'
 // ...
Dodajemo u promtail.yml put do logova (u konfiguraciji postoji opcija "docker", koja to radi s jednom linijom, ali to ne bi bilo tako pregledno):
scrape_configs:
 - job_name: containers

   static_configs:
       labels:
         job: containerlogs
         __path__: /var/lib/docker/containers/*/*log  # samo za linux
Uključivanjem ove konfiguracije, logovi će ulaziti u Loki sa svih kontejnera. Da bismo to izbjegli, mijenjamo postavke testnog nginx-a u docker-compose.yml — dodajemo logiranje polje tag:
proxy:
 image: nginx.test.v3
//…
 logging:
   driver: "json-file"
   options:
     tag: "{{.ImageName}}|{{.Name}}"
Prilagođavamo promtail.yml i postavljamo Pipeline. Ulaze logovi sledećeg formata:
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] \"GET /api/index HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.096\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.66740443Z"}
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] \"GET /200 HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.000\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.702925272Z"}
Faza Pipeline:
 - json:
     expressions:
       stream: stream
       attrs: attrs
       tag: attrs.tag
Izdvajamo iz ulaznog JSON polja stream, attrs, attrs.tag (ako postoje) i stavljamo ih u extracted map.
 - regex:
     expression: ^(?P([^|]+))|(?P([^|]+))$
     source: "tag"
Ako je polje tag uspješno dodano u extracted map, pomoću regex-a izvlačimo imena slike i kontejnera.
 - labels:
     image_name:
     container_name:
Dodeljujemo oznake. Ako se u extracted podacima pronađu ključevi image_name i container_name, njihovi vrijednosti će biti dodeljeni odgovarajućim oznakama.
 - match:
     selector: '{job="docker",container_name="",image_name=""}'
     action: drop
Izužemo sve logove koji nemaju postavljene oznake image_name i container_name.
  - match:
     selector: '{image_name="nginx.promtail.test"}'
     stages:
       - json:
           expressions:
             row: log
Za sve logove koji imaju image_name jednak nginx.promtail.test, izvlačimo iz izvornih logova polje log i stavljamo ga u extracted map sa ključem row.
  - regex:
         # potiskuje forego boje
         expression: .+nginx.+|.+[0m(?P[a-z_.-]+) +(?P.+)
         source: logrow
Čistimo ulazni string pomoću regularnih izraza i izdvajamo nginx virtual host i string nginx loga.
     - regex:
         source: nginxlog
         expression: ^(?P[w.]+) - (?P[^ ]*) [(?P[^ ]+).*] "(?P[^ ]*) (?P[^ ]*) (?P[^ ]*)" (?P[d]+) (?P[d]+) "(?P[^"]*)" "(?P[^"]*)"( "(?P[d.]+)")?
Parsamo nginx log pomoću regularnih izraza.
    - regex:
           source: request_url
           expression: ^.+.(?Pjpg|jpeg|gif|png|ico|css|zip|tgz|gz|rar|bz2|pdf|txt|tar|wav|bmp|rtf|js|flv|swf|html|htm)$
     - regex:
           source: request_url
           expression: ^/photo/(?P[^/?]+).*$
       - regex:
           source: request_url
           expression: ^/api/(?P[^/?]+).*$
Razlažemo request_url. Pomoću regex-a određujemo svrhu zahteva: da li je ka statičkim sadržajima, fotografijama, API-ju i postavljamo u extracted map odgovarajući ključ.
       - template:
           source: request_type
           template: "{{if .photo}}photo{{else if .static_type}}static{{else if .api_request}}api{{else}}other{{end}}"
Pomoću uslovnih operatora u Template proveravamo postavljena polja u extracted map i postavljamo za polje request_type potrebne vrijednosti: photo, static, API. Postavljamo other ako nije uspelo. Sada request_type sadrži vrstu zahteva.
       - labels:
           api_request:
           virtual_host:
           request_type:
           status:
Postavljamo oznake api_request, virtual_host, request_type i status (HTTP status) na osnovu onoga što je uspelo da se stavi u extracted map.
       - output:
           source: nginx_log_row
Menjamo output. Sada u Loki odlazi očišćen nginx log iz extracted map.
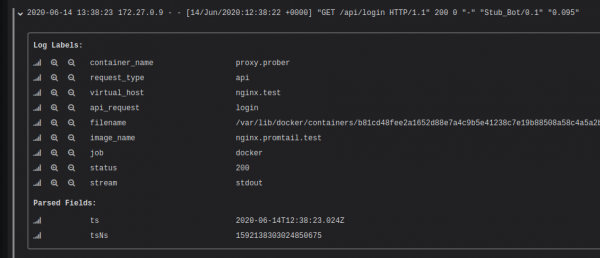
Nakon pokretanja datog konfiguracije, može se videti da je svakoj stavci dodeljeno oznake na osnovu podataka iz loga.
Potrebno je imati na umu da izvlačenje oznaka s velikim brojem vrednosti (kardinalnost) može značajno usporiti rad Loki. Drugim rečima, ne treba stavljati user_id u indeks. Više o tome pročitajte u članku “”. Ali to ne znači da nije moguće pretraživati po user_id bez indeksa. Potrebno je koristiti filtre prilikom pretraživanja („grebati“ po podacima), dok indeks ovde služi kao identifikator toka.
Vizualizacija logova
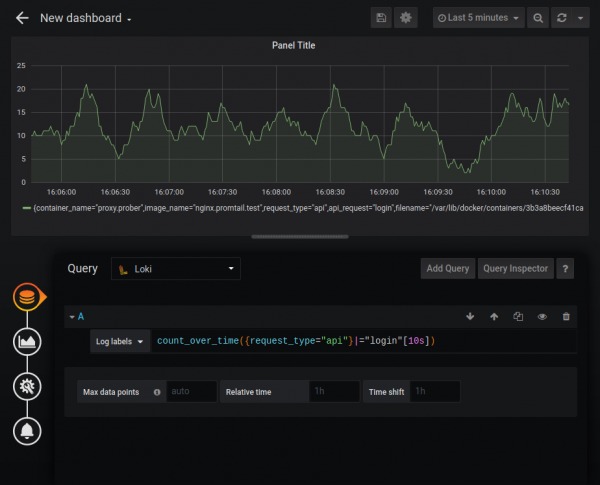
Loki može igrati ulogu izvora podataka za grafike Grafana, koristeći LogQL. Podržane su sledeće funkcije:
- rate — broj zapisa u sekundi;
- count over time — broj zapisa u dodeljenom opsegu.
Takođe postoje agregacione funkcije Sum, Avg i druge. Mogu se praviti prilično složeni grafici, na primer grafikon broja HTTP grešaka:
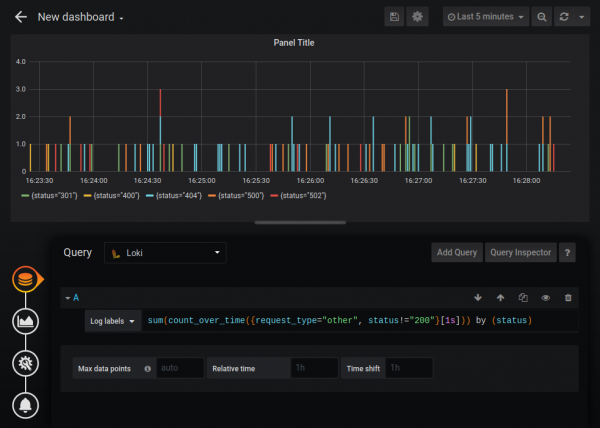
Standardni izvor podataka Loki je donekle ograničen u funkcionalnosti u poređenju sa izvorom podataka Prometheus (na primer, nije moguće promeniti legendu), ali Loki se može povezati kao izvor sa tipom Prometheus. Nisam siguran da li je ovo dokumentovano ponašanje, ali prema odgovoru developera “”, na primer, to je sasvim legalno, i Loki je potpuno kompatibilan sa PromQL.
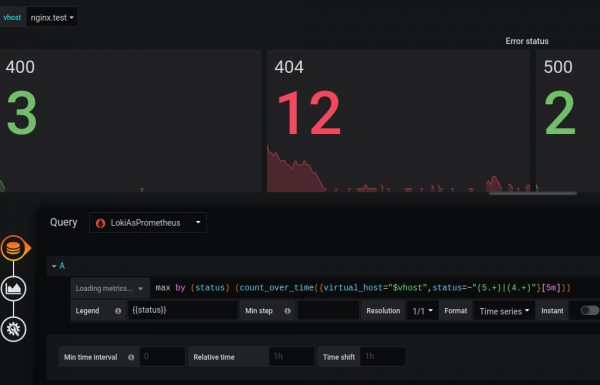
Dodajemo Loki kao izvor podataka sa tipom Prometheus i dodajemo URL /loki:

I možemo praviti grafike, kao da radimo sa metrikama iz Prometheus:
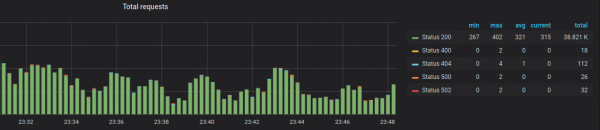
Mislim da je razlika u funkcionalnosti privremena i da će developeri to ispraviti u budućnosti.
Metrike
U Loki je dostupna mogućnost ekstrakcije numeričkih metrika iz logova i slanje u Prometheus. Na primer, u logu nginx su prisutni količine bajtova na odgovor, kao i vreme u sekundama koje je bilo potrebno za odgovor, uz određenu modifikaciju standardnog formata loga. Ovi podaci se mogu izvući i poslati u Prometheus.
Dodajemo još jedan odeljak u promtail.yml:
- match:
   selector: '{request_type="api"}'
   stages:
     - metrics:
         http_nginx_response_time:
           type: Histogram
           description: "vreme odgovora ms"
           source: response_time
           config:
             buckets: [0.010,0.050,0.100,0.200,0.500,1.0]
- match:
   selector: '{request_type=~"static|photo"}'
   stages:
     - metrics:
         http_nginx_response_bytes_sum:
           type: Counter
           description: "ukupno bajtova odgovora"
           source: bytes_out
           config:
             action: add
         http_nginx_response_bytes_count:
           type: Counter
           description: "broj bajtova odgovora"
           source: bytes_out
           config:
             action: inc
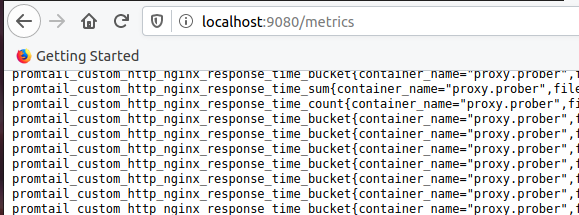
Opcija omogućava definisanje i ažuriranje metrika na osnovu podataka iz extracted map. Ove metrike se ne šalju u Loki — one se pojavljuju na Promtail /metrics endpoint-u. Prometheus treba biti konfigurisan na način da primi podatke dobijene u ovoj fazi. U datom primeru za request_type="api" prikupljamo histogram metriku. Ovaj tip metrika omogućava lako dobijanje percentila. Za statiku i fotografije prikupljamo sumu bajtova i broj redova u kojima smo dobili bajtove, kako bismo izračunali prosečnu vrednost.
O metrikama više pročitajte .
Otvaramo port na Promtail:
promtail:
     image: grafana/promtail:1.4.1
     container_name: monitoring.promtail
     expose:
       - 9080
     ports:
       - "9080:9080"
Uveravamo se da su metrike sa prefiksom promtail_custom pojavile:
Konfigurišemo Prometheus. Dodajemo job promtail:
- job_name: 'promtail'
 scrape_interval: 10s
 static_configs:
   - targets: ['promtail:9080']
I crtamo grafikon:
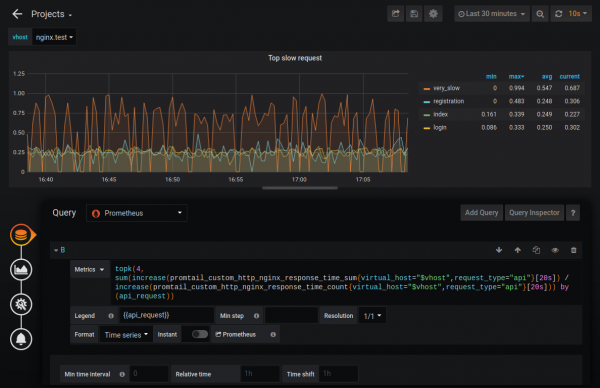
Na taj način možemo saznati, na primer, četiri najsporija upita. Takođe, na ovim metrikama se može postaviti praćenje.
Skaliranje
Loki može raditi u režimu jednog izvršnog binarnog fajla (single binary mode) ili u deljenom (horizontally-scalable mode). U drugom slučaju može čuvati podatke u oblaku, pri čemu se čuvaju čankovi i indeksi odvojeno. U verziji 1.5 implementirana je mogućnost čuvanja na jednom mestu, ali još uvek se ne preporučuje korišćenje u produkciji.
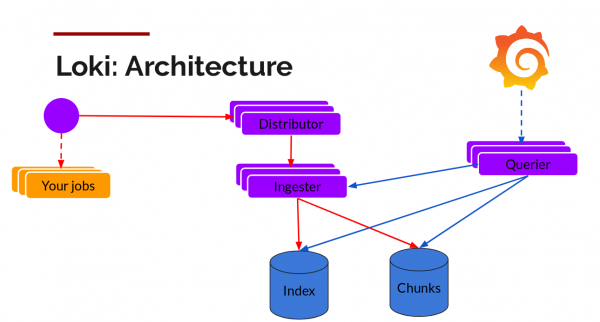
Čankovi se mogu čuvati u S3-kompatibilnim skladištima, a za čuvanje indeksa koristiti horizontalno skalabilne baze podataka: Cassandra, BigTable ili DynamoDB. Ostali delovi Lokija — Distributors (za upis) i Querier (za upite) — su stateless i takođe se horizontalno skaliraju.
Na konferenciji DevOpsDays Vancouver 2019, jedan od učesnika Callum Styan je izneo da njegov projekat sa Lokijem ima petabajte logova sa indeksom manjim od 1% od ukupne veličine: “”.
Uporedba Loki i ELK
Veličina indeksa
Za testiranje dobijene veličine indeksa, uzeo sam logove sa nginx kontejnera, za koji je podešen Pipeline, kako je gore navedeno. Fajl sa logovima sadržao je 406.624 reda ukupne veličine 109 MB. Logovi su generisani tokom jednog sata, otprilike po 100 zapisa u sekundi.
Primer dva reda iz loga:
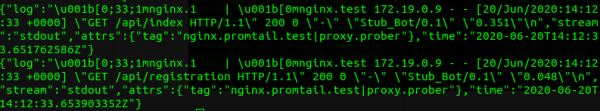
Pri indeksaciji ELK ovo je dalo veličinu indeksa od 30,3 MB:
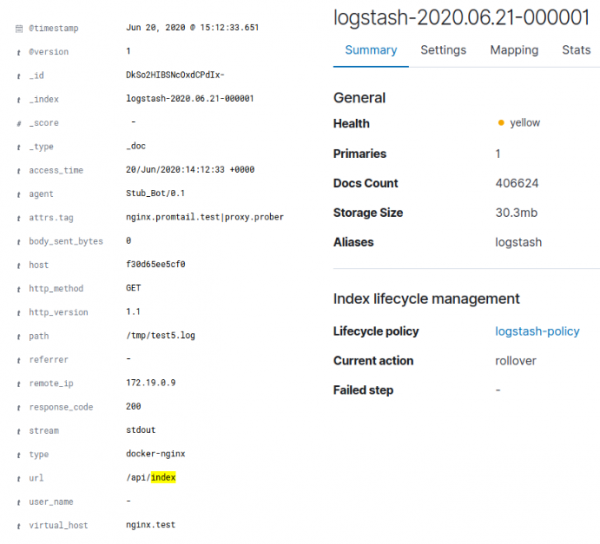
U slučaju Loki to je dalo oko 128 KB indeksa i otprilike 3,8 MB podataka u česticama. Treba napomenuti da je log generisan veštački i nije se razlikovao po velikoj raznolikosti podataka. Jednostavni gzip na izvornoj Docker JSON-loga sa podacima davao je kompresiju od 95,4%, a s obzirom na to da su se u Loki slali samo očišćeni nginx-logs, smanjenje na 4 MB je objašnjivo. Ukupan broj jedinstvenih vrednosti za oznake Loki bio je 35, što objašnjava mali veličinu indeksa. Za ELK, log se takođe čistio. Tako je Loki smanjio izvorne podatke za 96%, a ELK za 70%.
Potrošnja memorije
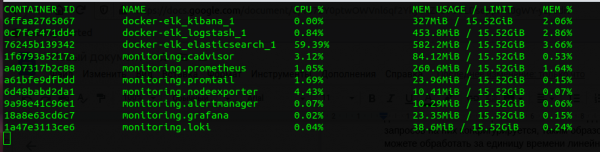
Ako uporedimo ceo stack Prometheus i ELK, Loki „jede“ nekoliko puta manje. Jasno je da servis na Go koristi manje nego servis na Javi, i poređenje veličine JVM Heap Elasticsearch i dodeljene memorije za Loki nije ispravno, ali ipak treba napomenuti da Loki koristi mnogo manje memorije. Njegova prednost u CPU nije tako očigledna, ali takođe postoji.
Brzina
Loki brže „proždire“ logove. Brzina zavisi od mnogih faktora — kakvi su logovi, koliko ih kompleksno parsiramo, mreža, disk itd. — ali je očigledno viša nego kod ELK (u mom testu — otprilike dvostruko). To se objašnjava time što Loki stavlja mnogo manje podataka u indeks i, samim tim, provodi manje vremena na indeksiranju. Sa brzinom pretrage situacija je obrnuta: Loki se značajno usporava na podacima veličine veće od nekoliko gigabajta, dok brzina pretrage kod ELK ne zavisi od veličine podataka.
Pretraživanje logova
Loki značajno zaostaje za ELK po mogućnostima pretrage logova. Grep sa regularnim izrazima je moćna stvar, ali nije dorasla pravoj bazi podataka. Nedostatak range-upita, agregacija samo po oznakama, nemogućnost pretrage bez oznaka — sve to nas ograničava u potrazi za zanimljivim informacijama u Loki. To ne implicira da se pomoću Lokija ništa ne može pronaći, ali određuje tok rada sa logovima, gde prvo pronalazite problem na grafikonima Prometheus, a zatim prema tim oznakama tražite šta se dogodilo u logovima.
Interfejs
Prvo, to je lepo (izvinite, nisam mogao da se suzdržim). Grafana ima lepši interfejs, ali Kibana je mnogo funkcionalnija.
Prednosti i mane Lokija
Prednosti uključuju činjenicu da se Loki integriše sa Prometheusom, tako da metrikama i alarmima pristupamo odmah. Pogodan je za prikupljanje i čuvanje logova iz Kubernetes Podova, jer nasleđuje service discovery od Prometheusa i automatski dodaje oznake.
Od nedostataka, ističe se slaba dokumentacija. Neke stvari, poput karakteristika i mogućnosti Promtail-a, pronašao sam samo tokom proučavanja koda, srećom open-source. Još jedan nedostatak su slabe mogućnosti parsiranja. Na primer, Loki ne podržava parsiranje multiline logova. Takođe, može se smatrati nedostatkom to što je Loki relativno mlada tehnologija (verzija 1.0 objavljena je u novembru 2019. godine).
Zaključak
Loki je 100% zanimljiva tehnologija koja je pogodna za manje i srednje projekte, omogućavajući rešavanje brojnih zadataka vezanih za agregaciju logova, pretragu logova, praćenje i analizu logova.
Ne koristimo Loki u Badoo-u, jer imamo ELK stack koji nam odgovara i koji je tokom godina razvijen sa raznim prilagođenim rešenjima. Za nas je ključna tačka pretraga logova. Sa skoro 100 GB logova dnevno, važno nam je da možemo brzo pronalaziti sve i još malo više. Za izradu grafika i praćenje koristimo druga rešenja koja su prilagođena našim potrebama i međusobno povezana. Stack Loki ima određene prednosti, ali nam neće pružiti više od onoga što već imamo, a njegove prednosti sigurno neće nadoknaditi troškove migracije.
Iako je nakon istraživanja postalo jasno da ne možemo koristiti Loki, nadamo se da će vam ova objava pomoći u vašem odabiru.
Repozitorij sa kodom korišćenim u članku se nalazi .
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish