

Pozdrav svima! Ja sam CV programer u KROK-u. Već 3 godine realizujemo projekte u oblasti CV. Tokom tog vremena, radili smo razne stvari, kao što su: praćenje vozača da tokom vožnje ne piju, ne puše, ne razgovaraju telefonom, da gledaju na put, a ne u snove ili oblake; beleženje onih koji koriste posebne trake i zauzimaju više mesta na parkiralištu; osiguravanje da radnici nose kacige, rukavice itd.; identifikacija zaposlenog koji želi da uđe na objekat; brojanje svega što je moguće.
Zašto ovo govorim?
Tokom realizacije projekata naišli smo na razne probleme, a neke od njih ili poznajete ili ćete se susresti sa njima u budućnosti.
Modeliramo situaciju
Zamislite da ste se zaposlili u mladoj kompaniji “N”, čija je delatnost povezana sa ML. Radimo na ML (DL, CV) projektu, a zatim, iz raznih razloga, prelazimo na drugi posao, jednostavno uzimamo pauzu, i vraćamo se na svoj ili neki drugi projekat sa nevronskom mrežom.
- Dolazi trenutak istine, potrebno je da se setimo na čemu smo stali, koje hiperpodatke smo probali i, što je najvažnije, kakvi su bili rezultati. Postoji mnogo načina na koje su ljudi čuvali informacije o svim pokretanjima: u mislima, u konfiguracijama, u sveskama, u radnom okruženju u oblaku. Video sam i primer kada su hiperpodatci bili sačuvani kao komentarisane linije u kodu, jednostavno mašta na delu. A sada zamislite da se ne vraćate svom projektu, već projektu osobe koja je napustila kompaniju i nasleđujete kod i model pod nazivom model_1.pb. Da bismo dodatno osvetlili situaciju, zamislite da ste vi i novajlija.
- Idemo dalje. Da bismo pokrenuli kod, potrebno je da stvorimo okruženje za sve koji će raditi s njim. Često se dešava da nam to okruženje nije ostavljeno iz raznih razloga. To takođe može postati složena zadatak. Ne želimo trošiti vreme na ovaj korak, zar ne?
- Obučavamo model (na primjer, detektor automobila). Dolazimo do trenutka kada postaje prilično dobar — vreme je da sačuvamo rezultat. Nazovimo ga car_detection_v1.pb. Zatim obučavamo još jedan — car_detection_v2.pb. Nakon nekog vremena naši kolege ili mi sami obučavamo još i još, koristeći različite arhitekture. Na kraju se stvori gomila artefakata, informacije o kojima treba pažljivo sakupiti (ali to ćemo uraditi kasnije, jer imamo prioritetnija posla).
- I to je sve! Imamo model! Možemo krenuti sa obukom sledećeg modela, razvojem arhitekture za rešavanje novog zadatka ili možemo otići na čaj? A ko će obaviti deploy?
Identifikovanje problema
Rad na projektu ili proizvodu — to je trud mnogih ljudi. Kako vreme prolazi, ljudi odlaze i dolaze, projekata postaje više, a sami projekti postaju složeniji. U svakom slučaju, situacije iz opisane gornje petlje (i ne samo to) u raznim kombinacijama će se pojavljivati iz iteracije u iteraciju. Sve to vodi do gubitka vremena, zbrke, nervoze, možda — nezadovoljstva klijenata, a na kraju — do propuštenog novca. Iako obično hodamo po istim starim zategnutim mestima, mislim da niko ne želi da iznova prolazi kroz te momente.
Dakle, prošli smo kroz jedan razvojni ciklus i vidimo da postoje problemi koje treba rešiti. Za to je potrebno:
- zgodno skladištenje rezultata rada;
- olakšati proces uključivanja novih zaposlenih;
- pojednostaviti proces postavljanja razvojnog okruženja;
- podesiti proces verzionisanja modela;
- imati zgodan način validacije modela;
- pronaći alat za upravljanje stanjem modela;
- pronaći način isporuke modela u produkciju.
Izgleda da je potrebno smisliti workflow koji bi omogućio lako i zgodno upravljanje ovim životnim ciklusom? Ova praksa se naziva MLOps.
MLOps, ili DevOps za mašinsko učenje, omogućava timovima stručnjaka za obradu i analizu podataka i IT stručnjacima da sarađuju, kao i da povećavaju brzinu razvoja i raspoređivanja modela uz pomoć praćenja, verifikacije i sistema upravljanja za modele mašinskog učenja.
Možete , šta o svemu ovome misle momci iz Google-a. Iz članka je jasno da je MLOps prilično obimna stvar.
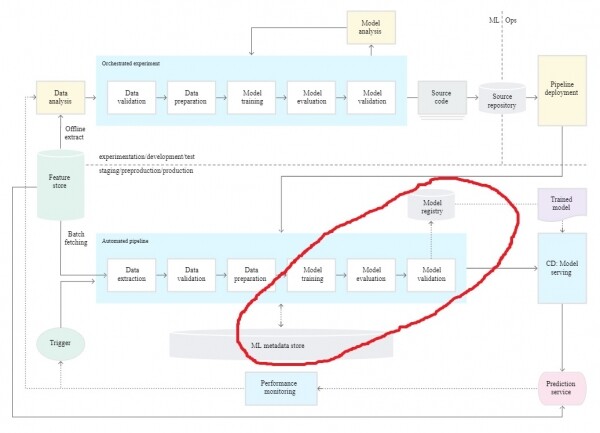
U nastavku svog članka opisat ću samo dio procesa. Za implementaciju ću koristiti alat MLflow, budući da je to open-source projekt, za povezivanje je potreban mali broj koda, a postoji i integracija s popularnim ml okvirom. Možete potražiti na internetu druge alate, kao što su Kubeflow, SageMaker, Trains itd., i možda pronaći onaj koji bolje odgovara vašim potrebama.
"Gradeći" MLOps na primjeru korištenja alata MLFlow
MLFlow je platforma s otvorenim izvorom za upravljanje životnim ciklusom ml modela ().
MLflow uključuje četiri komponente:
- MLflow Tracking – rješava pitanja snimanja rezultata i parametara koji su doveli do tih rezultata;
- MLflow Project – omogućava pakiranje koda i njegovo reproduciranje na bilo kojoj platformi;
- MLflow Models – odgovara za implementaciju modela u produkciju;
- MLflow Registry – omogućava pohranu modela i upravljanje njihovim stanjem u centraliziranom skladištu.
MLflow upravlja s dvjema entitetama:
- pokretanje – to je puni ciklus obuke, parametri i metričke podatke koje želimo registrirati;
- eksperiment – to je “tema” pod kojom su okupili pokretanja.
Svi koraci primjera su realizirani na operativnom sustavu Ubuntu 18.04.
1. Postavljamo server
Kako bismo mogli lako upravljati našim projektom i dobiti sve potrebne informacije, postavit ćemo server. MLflow tracking server ima dva osnovna komponenta:
- backend store – odgovara za pohranu informacija o registriranim modelima (podržava 4 DBMS: mysql, mssql, sqlite, i postgresql);
- artifact store – odgovara za pohranu artefakata (podržava 7 varijanti pohrane: Amazon S3, Azure Blob Storage, Google Cloud Storage, FTP server, SFTP Server, NFS, HDFS).
Kao artifact store za jednostavnost ćemo uzeti sftp server.
- stvaramo grupu
$ sudo groupadd sftpg - dodajemo korisnika i postavljamo mu lozinku
$ sudo useradd -g sftpg mlflowsftp $ sudo passwd mlflowsftp - korigiramo nekoliko postavki pristupa
$ sudo mkdir -p /data/mlflowsftp/upload $ sudo chown -R root.sftpg /data/mlflowsftp $ sudo chown -R mlflowsftp.sftpg /data/mlflowsftp/upload - dodajemo nekoliko linija u /etc/ssh/sshd_config
Match Group sftpg ChrootDirectory /data/%u ForceCommand internal-sftp - ponovo pokrećemo uslugu
$ sudo systemctl restart sshd
Kao backend store uzmimo postgresql.
$ sudo apt update
$ sudo apt-get install -y postgresql postgresql-contrib postgresql-server-dev-all
$ sudo apt install gcc
$ pip install psycopg2
$ sudo -u postgres -i
# Kreirajte novog korisnika: mlflow_user
[postgres@user_name~]$ createuser --interactive -P
Unesite ime uloge za dodavanje: mlflow_user
Unesite lozinku za novu ulogu: mlflow
Ponovo unesite: mlflow
Da li nova uloga treba da bude superkorisnik? (y/n) n
Da li nova uloga može da kreira baze podataka? (y/n) n
Da li nova uloga može da kreira još novih uloga? (y/n) n
# Kreirajte bazu podataka mlflow_bd u vlasništvu mlflow_user
$ createdb -O mlflow_user mlflow_db
Za pokretanje servera potrebno je instalirati sledeće python pakete (preporučujem da kreirate posebno virtuelno okruženje):
pip install mlflow
pip install pysftp
Pokrećemo naš server
$ mlflow server
                 --backend-store-uri postgresql://mlflow_user:mlflow@localhost/mlflow_db
                 --default-artifact-root sftp://mlflowsftp:mlflow@sftp_host/upload
                --host server_host
                --port server_port
2. Dodajemo praćenje
Da rezultati naših treninga ne bi nestali, da buduće generacije programera razumeju šta se dešavalo, a stariji kolege i vi mogli da analizirate proces učenja, potrebno je dodati praćenje. Praćenje podrazumeva čuvanje parametara, metrika, artefakata i svih dodatnih informacija o pokretanju obuke, u našem slučaju, na serveru.
U ovom primeru, kreirao sam mali koristeći Keras za segmentaciju svega što se nalazi u . Za dodavanje praćenja, kreirao sam datoteku mlflow_training.py.
Evo redova u kojima se dešava najzanimljivije:
def run(self, epochs, lr, experiment_name):
        # dobijanje ID-a eksperimenta, kreiranje eksperimenta u slučaju njegove odsutnosti
        remote_experiment_id = self.remote_server.get_experiment_id(name=experiment_name)
        # kreiranje "run" i dobijanje njegovog ID-a
        remote_run_id = self.remote_server.get_run_id(remote_experiment_id)

        # naznačite da želimo da sačuvamo rezultate na udaljenom serveru
        mlflow.set_tracking_uri(self.tracking_uri)
        mlflow.set_experiment(experiment_name)

        with mlflow.start_run(run_id=remote_run_id, nested=False):
            mlflow.keras.autolog()
            self.train_pipeline.train(lr=lr, epochs=epochs)

        try:
            self.log_tags_and_params(remote_run_id)
        except mlflow.exceptions.RestException as e:
            print(e)
Ovdje self.remote_server je mali sloj preko metoda mlflow.tracking. MlflowClient (napravio sam ga radi jednostavnosti), putem kojih kreiram eksperiment i pokretanje na serveru. Zatim navodim gdje bi rezultati pokretanja trebali da se šalju (mlflow.set_tracking_uri(self.tracking_uri)). Aktiviram automatsko logovanje mlflow.keras.autolog(). Trenutno MLflow Tracking podržava automatsko logovanje za TensorFlow, Keras, Gluon XGBoost, LightGBM, Spark. Ako vaš okvir ili biblioteka nije na listi, možete logovati na eksplicitan način. Pokrećemo obuku. Registrujemo tagove i ulazne parametre na udaljenom serveru.
Par redova i vi, kao i svi zainteresovani, dobijate pristup informacijama o svim pokretanjima. Super, zar ne?
3. Organizujemo projekat
Sada ćemo to učiniti tako da pokretanje projekta bude jednostavno. U tu svrhu, dodajemo datoteku MLproject i conda.yaml u koren projekta.
MLproject
name: flow_segmentation
conda_env: conda.yaml

entry_points:
  main:
    parameters:
        categories: {help: 'lista kategorija iz coco dataset'}
        epochs: {type: int, help: 'broj epoha u obuci'}

        lr: {type: float, default: 0.001, help: 'stopa učenja'}
        batch_size: {type: int, default: 8}
        model_name: {type: str, default: 'Unet', help: 'Unet, PSPNet, Linknet, FPN'}
        backbone_name: {type: str, default: 'resnet18', help: 'primjer resnet18, resnet50, mobilenetv2 ...'}

        tracking_uri: {type: str, help: 'adresa servera'}
        experiment_name: {type: str, default: 'Moj_eksperiment', help: 'ime eksperimenta na udaljenom i lokalnom serveru'}
    command: "python mlflow_training.py
            --epochs={epochs}
            --categories={categories}
            --lr={lr}
            --tracking_uri={tracking_uri}
            --model_name={model_name}
            --backbone_name={backbone_name}
            --batch_size={batch_size}
            --experiment_name={experiment_name}"
MLflow projekt ima nekoliko svojstava:
- Name — ime vašeg projekta;
- Environment — u mom slučaju conda_env ukazuje na to da se koristi Anaconda za pokretanje i opis zavisnosti se nalazi u datoteci conda.yaml;
- Entry Points — ukazuje koje datoteke i sa kojim parametrima možemo pokrenuti (svi parametri prilikom pokretanja obuke automatski se loguju)
conda.yaml
name: flow_segmentation
channels:
  - defaults
  - anaconda
dependencies:
  - python==3.7
  - pip:
    - mlflow==1.8.0
    - pysftp==0.2.9
    - Cython==0.29.19
    - numpy==1.18.4
    - pycocotools==2.0.0
    - requests==2.23.0
    - matplotlib==3.2.1
    - segmentation-models==1.0.1
    - Keras==2.3.1
    - imgaug==0.4.0
    - tqdm==4.46.0
    - tensorflow-gpu==1.14.0
Kao okruženje za izvršavanje možete koristiti docker, za više informacija obratite se .
4. Pokrećemo obuku
Kloniramo projekat i prelazimo u direktorijum projekta:
git clone https://github.com/simbakot/mlflow_example.git
cd mlflow_example/
Za pokretanje potrebno je instalirati biblioteke
pip install mlflow
pip install pysftp
Budući da u primjeru koristim conda_env, na vašem računaru mora biti instaliran Anaconda (ali to se može zaobići instaliranjem svih potrebnih paketa ručno i igrajuci se sa parametrima pokretanja).
Svi pripremni koraci su završeni i možemo početi s pokretanjem obuke. Iz korijena projekta:
$ mlflow run -P epochs=10 -P categories=cat,dog -P tracking_uri=http://server_host:server_port .Nakon unosa komande, automatski će se stvoriti conda okruženje i započeti treniranje.
U gornjem primjeru, proslijedio sam broj epoha za obuku, kategorije na koje želimo segmentirati (cjelovitu listu možete pogledati ) i adresu našeg udaljenog servera.
Cjelokupnu listu mogućih parametara možete pogledati u datoteci MLproject.
5. Evaluiramo rezultate obuke
Nakon završetka obuke možemo u pregledniku otići na adresu našeg servera
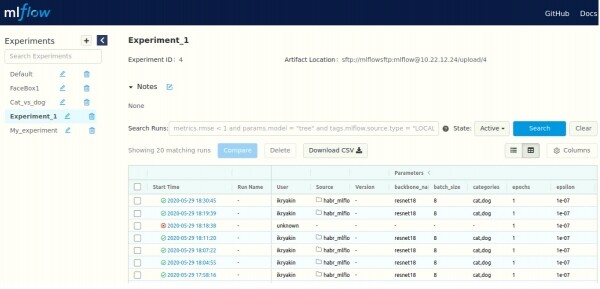
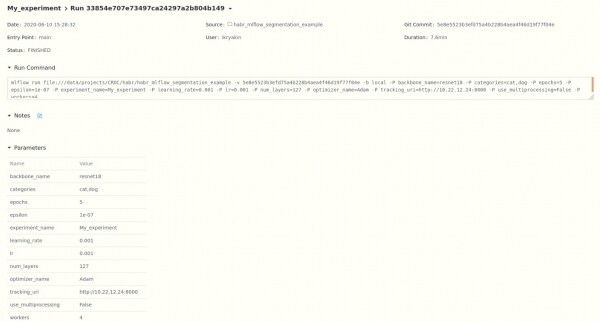
Ovdje vidimo popis svih eksperimenata (s lijeve strane na vrhu), kao i informacije o izvođenjima (u sredini). Možemo pogledati detaljnije informacije (parametri, metrike, artefakti i dodatne informacije) o svakom izvođenju.
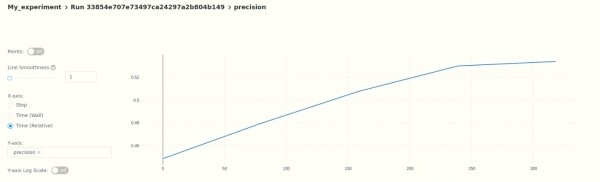
Za svaku metrik možemo posmatrati istoriju promene
Dakle, trenutno možemo analizirati rezultate u "ručnom" režimu, takođe možete postaviti i automatsku validaciju pomoću MLflow API.
6. Registrujemo model
Nakon što smo analizirali naš model i odlučili da je spreman za upotrebu, pristupamo njegovoj registraciji, za to biramo odgovarajuće izvođenje (kao što je prikazano u prethodnom stavku) i idemo dolje.
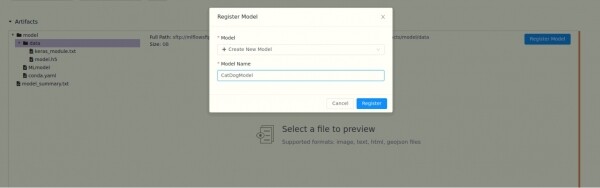
Nakon što smo dali ime našem modelu, on dobija verziju. Kada se sačuva drugi model s istim imenom, verzija će se automatski povećati.
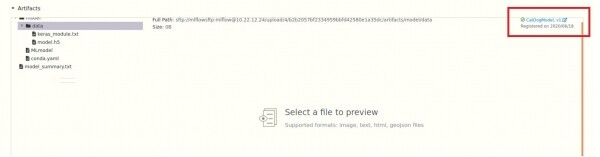
Za svaki model možemo dodati opis i odabrati jedan od tri statusa (Staging, Production, Archived), kasnije možemo preko API-a pristupiti tim statusima, što uz verzioniranje pruža dodatnu fleksibilnost.
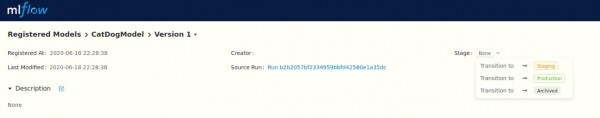
Također imamo jednostavan pristup svim modelima
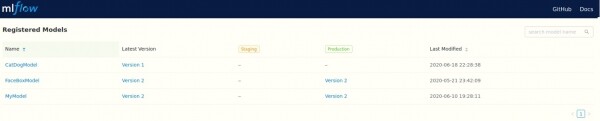
i njihovim verzijama.
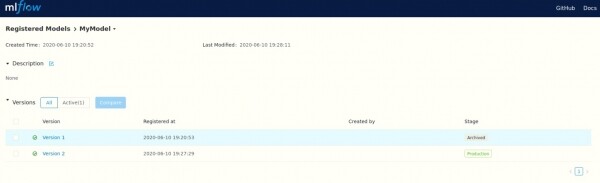
Kao i u prethodnom stavku, sve operacije mogu se izvršiti pomoću API.
7. Deployujemo model
U ovom trenutku već imamo trenirani (keras) model. Primjer, kako ga možemo koristiti:
class SegmentationModel:
    def __init__(self, tracking_uri, model_name):

        self.registry = RemoteRegistry(tracking_uri=tracking_uri)
        self.model_name = model_name
        self.model = self.build_model(model_name)

    def get_latest_model(self, model_name):
        registered_models = self.registry.get_registered_model(model_name)
        last_model = self.registry.get_last_model(registered_models)
        local_path = self.registry.download_artifact(last_model.run_id, 'model', '.\/')
        return local_path

    def build_model(self, model_name):
        local_path = self.get_latest_model(model_name)

        return mlflow.keras.load_model(local_path)

    def predict(self, image):
        image = self.preprocess(image)
        result = self.model.predict(image)
        return self.postprocess(result)

    def preprocess(self, image):
        image = cv2.resize(image, (256, 256))
        image = image / 255.
        image = np.expand_dims(image, 0)
        return image

    def postprocess(self, result):
        return result
Ovdje je self.registry ponovo mala obavijača nad mlflow.tracking.MlflowClient, radi lakšeg korištenja. Suština je da se obraćam udaljenom serveru i tražim model s navedenim imenom, a pritom najnoviju verziju iz produkcije. Zatim preuzimam artefakt lokalno u folder .\/model i sastavljam model iz te direktorije mlflow.keras.load_model(local_path). Sada možemo koristiti naš model. CV (ML) developeri se mogu nesmetano baviti unapređenjem modela i objavljivanjem novih verzija.
U zaključku
Predstavio sam sistem koji omogućava:
- centralizovano čuvanje informacija o ML modelima, napretku i rezultatima obuke;
- brzo postavljanje razvojne sredine;
- praćenje i analiziranje napretka rada na modelima;
- lakše vođenje verzionisanja i upravljanje stanjem modela;
- jednostavno implementiranje dobijenih modela.
Ovaj primjer je pojednostavljen i služi kao početna tačka za izgradnju vlastitog sistema, koji možda uključuje automatizaciju procjene rezultata i registraciju modela (tačka 5 i tačka 6). Možda ćete dodati verzionisanje setova podataka ili nešto drugo? Pokušao sam prenijeti misao da vam je potreban MLOps u cjelini, a MLflow je samo sredstvo za postizanje tog cilja.
Napišite koje probleme ste imali, a ja nisam spomenuo?
Šta biste dodali u sistem da bi zadovoljavao vaše potrebe?
Koje alate i pristupe koristite da riješite sve ili dio problema?
P.S. Ostavljam par linkova:
github projekat —
MLflow —
Moja radna adresa e-pošte, za pitanja — ikryakin@croc.ru
U našoj kompaniji povremeno se organizuju različiti događaji za IT stručnjake. Na primer, 8. jula u 19:00 po MSK biće održan mitap o CV-u u online formatu. Ako vas zanima, možete se prijaviti. .
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish