

Napomena prev.: autor ovog članka (Luc Perkins) — developer advocate u organizaciji CNCF, koja je dom za takve Open Source projekte kao što su Linkerd, SMI (Service Mesh Interface) i Kuma (usput, jeste li se ikada zapitali zašto nemamo Istio na ovom spisku?). Ponovo pokušavajući doneti bolju razumijevanje zajednici DevOps o modernom uzbunu pod nazivom „service mesh“, on iznosi 16 karakterističnih mogućnosti koje ovakva rešenja pružaju.
Danas ― jedna od najvažnijih tema u oblasti softverskog inženjerstva (i sa pravom!). Smatram da je ova tehnologija neverovatno perspektivna i sanjam o tome da postanem svedok njenog širokog prihvaćanja (naravno, kada to ima smisla). Ipak, još uvek je okružena auranom misterije za većinu ljudi. Čak i oni koji su dobro upoznati s njom često imaju poteškoća u formulisanju njenih prednosti i šta ona zapravo predstavlja (uključujući i vašeg skromnog službenika). U ovom članku ću pokušati ispraviti situaciju tako što ću nabrojati različite upotrebe „servisnih mreža“*.
* Napomena prevodioca: u ovom članku će se koristiti takav prevod („servisna mreža“) za još uvek novu terminologiju service mesh.
Ali prvo želim da istaknem nekoliko napomena:
- Nikada nisam radio sa servisnim mrežama i nisam ih koristio van projekata započetih u svrhu sopstvenog obrazovanja. S druge strane, ja sam napisao gomilu dokumentacije za unutrašnju service mesh kompanije Twitter 2015. godine (tada se to još nije zvalo „servisna mreža“) i učestvovao sam u razvoju sajta i dokumentacije za , tako da to nešto znači.
- Moj spisak je okvirni i nepotpun. Sasvim su mogući nepoznati scenariji upotrebe, a vremenom će sigurno nastati nove varijante kako se tehnologija razvija i njen uticaj raste.
- U isto vreme, daleko ne svaka postojeća implementacija service mesh podržava sve navedene slučajeve upotrebe. Stoga se moji izrazi poput „service mesh može…“ treba čitati kao „određene, a možda i sve popularne implementacije service mesh mogu…“.
- Redosled primera nema nikakvo značenje.
Kratak spisak:
- otkrivanje servisa;
- enkripciju;
- autentifikacija i autorizacija;
- balansiranje opterećenja;
- circuit breaking;
- automatsko skaliranje;
- kanarinski deploy menti;
- plavo-zeleni deploy menti;
- provera stanja;
- opterećenje napajanja;
- mirroring saobraćaja;
- izolacija;
- ograničenje brzine zahteva, ponovni pokušaji i vremenska ograničenja;
- telemetrija;
- auditing;
- vizualizacija.
1. Otkrivanje usluga
TL;DR: Povežite se s drugim uslugama u mreži pomoću jednostavnih imena.
Usluge treba da imaju mogućnost automatskog „pronalaženja“ jedna druge putem adekvatnih imena – na primer, service.api.production, pets/staging ili cassandra. Oblak okruženja razlikuju se svojom elastičnošću, i iza jednog imena može se skrivati više instanci usluge. Jasno je da u takvoj situaciji fizički nije moguće hardkodirati sve IP adrese.
Pored toga, kada jedna usluga pronalazi drugu, ona mora imati mogućnost slanja zahteva toj usluzi, ne plašeći se da će doći do njenog neaktivnog primera. Drugim rečima, service mesh mora pratiti dostupnost svih instanci usluga i održavati listu hostova u što aktuelnijem stanju.
Svaka service mesh implementira mehanizam otkrivanja usluga na svoj način. Trenutno je najrasprostranjeniji način delegiranje spoljnim procesima poput DNS Kubernetes-a. U prošlosti smo u Twitteru za ove svrhe koristili sistem imena . Pored toga, tehnologija service mesh omogućava pojavu korisničkih mehanizama imenovanja (iako još nisam naišao na implementaciju SM sa ovom funkcionalnošću).
2. Enkripcija
TL;DR: Oslobodite se nešifrovanog saobraćaja među uslugama i neka ovaj proces bude automatizovan i skalabilan.
Prijatno je znati da napadači ne mogu proći u vašu unutrašnju mrežu. Firewall-i se odlično snalaze u tome. Ali šta će se desiti ako haker ipak prodre unutra? Hoće li moći raditi šta god poželi s međuslužbenim saobraćajem? Uzmimo u obzir da se to ne bi trebalo desiti. Da bismo sprečili takav scenario, potrebno je implementirati mrežu sa nulom poverenja (zero-trust), u kojoj je sav saobraćaj među uslugama šifrovan. Većina savremenih service mesh mreža to ostvaruje putem uzajamnog (mutual TLS, mTLS). U nekim slučajevima, mTLS funkcioniše u celim oblakom i klasterima (mislim da će i međupalnetarne komunikacije jednog dana biti uređene slično).
Naravno, za mTLS service mesh nije obavezna. Svaka usluga može sama da se pobrine za svoj TLS, ali to znači da će morati da pronađe način za generisanje sertifikata, distribuiranje istih među hostovima usluge, uključivanje u aplikaciju koda koji će učitati te sertifikate iz fajlova. Da, ne zaboravite ni na ažuriranje tih sertifikata u određenim intervalima. Servisne mreže automatizuju mTLS pomoću sistema poput , koji, s druge strane, automatizuju proces izdavanja i rotacije sertifikata.
3. Autentifikacija i autorizacija
TL;DR: Utvrdite ko je inicijator zahteva i odredite šta mu je dopušteno da radi pre nego što zahtev stigne do usluge.
Usluge često žele da znaju ko ko izvršava zahtev (autentifikacija), i koristeći te informacije, odlučuju šta tom subjektu je dopušteno da radi (autorizacija). U ovom slučaju za zamenicu „ko“ mogu se sakriti:
- Druge usluge. To se naziva „autentifikacijom peer’a’. Na primer, usluga
webželi da pristupi usluzidb. Servisne mreže obično rešavaju slične probleme uz pomoć mTLS: sertifikati u ovom slučaju igraju ulogu neophodnog identifikatora. - Neki korisnici-ljudi. To se naziva „autentifikacijom zahteva’. Na primer, korisnik
haxor69želi da kupi novu lampu. Servisne mreže pružaju različite mehanizme, na primer, .Mnogi od nas su to radili u kodu aplikacije. Stigne zahtev, pregledamo tabelu
users, pronađemo korisnika i uporedimo lozinku, a zatim proverimo kolonupermissionsitd. U slučaju servisne mreže to se dešava još pre nego što zahtev stigne do usluge.
Nakon što smo utvrdili odakle je došao zahtev, potrebno je odrediti šta tom subjektu je dopušteno da radi. Neke servisne mreže omogućavaju postavljanje osnovnih pravila (o tome ko i šta može da radi) u obliku YAML fajlova ili u komandnoj liniji, dok druge nude integraciju sa okvirima poput . Krajnji cilj je ostvariti da vaše usluge prihvataju sve zahteve, smelo pretpostavljajući da dolaze iz pouzdanog izvora i ovo je dozvoljeno.
4. Balansiranje opterećenja
TL;DR: Raspodelite opterećenje među instancama usluge prema određenom obrascu.
„Servis“ u okviru servisne sekte vrlo često se sastoji od mnogih identičnih instanci. Na primjer, danas servis cache se sastoji od 5 kopija, a sutra njihovo broj može porasti na 11. Zahtevi koji se šalju cache, treba rasporediti u skladu s određenom svrhom. Na primjer, minimizirati kašnjenje ili maksimizirati verovatnoću da dođe do radne instance. Najčešće se koristi algoritam rotacionog deljenja (Round-robin), ali postoji i mnoge druge - na primjer, metoda težinskog (weighted) raspoređivanja zahteva (može se odabrati preferirane ciljeve), kružno (ring) heširanje (korišćenje doslednog heširanja za upstream hostove) ili metoda najmanjeg broja zahteva (preference se daje instanci sa najmanjim brojem zahteva).
Klasični balansirnici imaju i druge funkcije, kao što su HTTP keširanje i zaštita od DDoS, ali one nisu baš relevantne za east-west promet (tj. za promet koji se dešava unutar Data centra - napomena prev.). (tipična oblast primene service mesh). Naravno, nije obavezno koristiti service mesh za balansiranje opterećenja, međutim, ona omogućava postavljanje i kontrolu politika balansiranja za svaku uslugu iz centralizovanog upravljačkog sloja, čime se eliminiše potreba za pokretanjem i podešavanjem posebnih balansirnika u mrežnom steku.
5. Prekid veze (circuit breaking)
TL;DR: Prekidajte saobraćaj ka problematičnoj usluzi i kontrolirajte štetu u najgorem scenariju.
Ako iz bilo kog razloga usluga ne može da podnese saobraćaj, service mesh pruža nekoliko opcija za rešavanje ovog problema (o drugim opcijama biće reči u odgovarajućim odeljcima). Circuit breaking je najstroža opcija isključivanja usluge iz saobraćaja. Međutim, sam po sebi nema smisla - potreban je plan B. Moguće je obezbediti povratni pritisak () na usluge koje obavljaju zahteve (samo se ne zaboravite da podešavate svoju service mesh za to!), ili, na primjer, obeležiti stranicu statusa u crveno i preusmeriti korisnike na alternativnu stranicu sa „padajućim kitom“ („Twitter is down“).
Servisne mreže omogućavaju ne samo određivanje, kada će doći do isključenja i šta to be followed by. In this case, 'when' can include any combination of specified parameters: total number of requests over a certain period, number of concurrent connections, pending requests, active retries, etc.
You likely won't want to abuse circuit breaking, but it's nice to know there's a backup plan in case of emergencies.
6. Auto-scaling
TL;DR: Increase or decrease the number of service instances based on defined criteria.
Service meshes are not schedulers, so they do not perform scaling on their own. However, they can provide information upon which schedulers will base their decisions. Since service meshes have access to all traffic between services, they possess extensive information about what is happening: which services are facing issues, which ones are underutilized (the allocated resources are wasted), etc.
For example, Kubernetes scales services based on CPU and memory usage of pods (see our report "" — note from the translator), but if you decide to scale based on any other metric (in our case, related to traffic), a special metric will be needed. A guide shows how to do this using , i , but the process itself is quite complex. We would like the service mesh to simplify it, allowing us to simply set conditions like 'increase the number of service instances auth, if the number of requests awaiting execution exceeds a threshold for one minute.'
7. Canary Deployments
TL;DR: Test new features or versions of the service on a subset of users.
Recimo da razvijate neki SaaS proizvod i planirate da objavite novu verziju. Testirali ste je na stagingu i ona je odlično prošla. Međutim, još uvek vas muče određene sumnje u vezi sa njenim ponašanjem u stvarnim uslovima. Drugim rečima, potrebno je testirati novu verziju na stvarnim zadacima, a da pritom ne ugrozite poverenje korisnika. Kanarinske implementacije su savršene za to. Omogućavaju vam da predstavite novu funkciju određenom podskupu korisnika. Ovaj podskup može da se sastoji od najlojalnijih korisnika, onih koji koriste besplatnu verziju proizvoda ili korisnika koji su izrazili želju da budu „kraljevi eksperimenta.“
Servisni mrežni sistemi to omogućavaju, omogućavajući da se definišu kriterijumi koji određuju ko i koju verziju aplikacije će videti, a saobraćaj se odgovarajuće usmerava. Pri tom, za same servise ništa se ne menja. Verzija 1.0 servisa smatra da svi zahtevi dolaze od korisnika koji trebaju da je vide, dok verzija 1.1 isto to veruje za svoje korisnike. A vi u međuvremenu možete menjati procenat saobraćaja između stare i nove verzije, preusmeravajući rastući broj korisnika na novu, ako se ona stabilno ponaša i vaši „kraljevi eksperimenta“ daju odobrenje.
8. Plavo-zeleni rasporedi
TL;DR: Uvedite novu kul funkciju, ali budite spremni da je odmah povučete.
Poenta je da se objavi nova "plava" usluga pokretanjem paralelno sa starom, "zelenom". Ako sve prođe u redu i nova usluga se dobro pokaže, stara može postupno da se ugasi. (Nažalost, jednog dana će i ova nova "plava" usluga doživeti sudbinu "zelene" i nestati...) Plavo-zeleni rasporedi se razlikuju od kanarinskih po tome što nova funkcija pokriva odjednom sve korisnike (a ne deo); poenta je imati „rezervnu luku“ u slučaju da nešto pođe po zlu.
Servisne mreže nude veoma praktičan način testiranja "plave" usluge i trenutnog prebacivanja na radnu "zelenu" u slučaju problema. Da ne spominjemo da usput pružaju mnoštvo informacija (vidi deo "Telemetrija" ispod) o radu "plave", koje pomažu da se shvati da li je spremna za punu eksploataciju.
Napomena prev.: Više o različitim strategijama implementacije u Kubernetesu (uključujući pomenute canary, blue/green i druge) možete pročitati u .
9. Provera zdravlja
TL;DR: Pratite koje instance servisa su funkcionalne i reagujte na one koje to više nisu.
Provera zdravlja (health check) pomaže da se donese odluka o tome da li su instance servisa spremne da primaju i obrađuju saobraćaj. Na primer, u slučaju HTTP servisa, proba zdravlja može izgledati kao GET zahtev na endpoint /health. Odgovor 200 OK će značiti da je instanca zdrava, svaki drugi odgovor označava da nije spremna da primi saobraćaj. Servisne mreže omogućavaju da se definiše način na koji će se proveravati funkcionalnost, kao i učestalost sa kojom će se ova proba vršiti. Te informacije se zatim mogu koristiti za druge svrhe — na primer, za ravnotežu opterećenja i circuit breaking.
Dakle, provera zdravlja nije samostalan scenario korišćenja, već se obično koristi za postizanje drugih ciljeva. Takođe, u zavisnosti od rezultata proba zdravlja, mogu biti potrebne spoljašnje akcije (u odnosu na druge ciljeve servisnih mreža): na primer, ažuriranje stranice stanja, kreiranje issue-a na GitHub-u ili popunjavanje JIRA tiketa. A servisna mreža nudi praktičan mehanizam za automatizaciju svega ovoga.
10. Odbacivanje opterećenja (load shedding)
TL;DR: Preusmeravajte saobraćaj kao odgovor na privremeni skok u korišćenju.
Ako neka usluga postane preopterećena saobraćajem, možete privremeno preusmeriti deo tog saobraćaja na drugo mesto (tj. "odbaciti", "preliti" (shed) ga tamo). Na primer, u rezervnu uslugu ili data-centar, ili u stalni Tema. Kao rezultat toga, usluga će nastaviti obraditi deo zahteva umesto da se potpuno obustavi. Oslobađanje opterećenja je poželjnije od prekida vezi, ali nije preporučljivo prekomerno ga koristiti. Omogućava sprečavanje kaskadnih kvarova koji mogu uzrokovati pad downstream usluga.
11. Paralelizacija/zrcaljenje saobraćaja
TL;DR: Pošaljite jedan zahtev na više mesta odjednom.
Ponekad postoji potreba za slanjem zahteva (ili skupa zahteva) na više usluga odjednom. Tipičan primer je slanje dela produkcionog saobraćaja na staging uslugu. Glavni web server produkcije šalje zahtev nižoj usluzi products.production i samo njoj. A service mesh inteligentno kopira taj zahtev i šalje ga na products.staging, o čemu web server čak ni ne sumnja.
Još jedan povezan slučaj korišćenja service mesh, koji se može implementirati pored paralelizacije saobraćaja, je . Podrazumeva slanje istih zahteva različitim verzijama usluge i proveru da li se sve verzije ponašaju jednako. Do sada nisam sreo implementaciju service mesh koja ima integrisani sistem regresionog testiranja poput , ali sama ideja se čini perspektivnom.
12. Izolacija
TL;DR: Delite svoju service mesh na mini-mreže.
Takođe poznata kao segmentacija, izolacija je umetnost razdvajanja servisne mreže na logički odvojene segmente koji ne znaju ništa jedni o drugima. Izolacija je donekle slična kreiranju virtuelnih privatnih mreža. Suštinska razlika je u tome što i dalje možete koristiti sve prednosti service mesh (poput otkrivanja usluga), ali uz dodatnu sigurnost. Na primer, ako haker uspe da prodre u uslugu u jednoj od podmreža, neće moći da vidi koje usluge su pokrenute u drugim podmrežama ili da presreće njihov saobraćaj.
Pored toga, prednosti mogu biti i organizacione. Možda ćete želeti da podelite usluge na podmreže na osnovu strukture kompanije i oslobodite programere od kognitivnog opterećenja uzrokovanog potrebom da drže u umu celu service mesh.
13. Ograničavanje frekvencije zahteva, ponovni pokušaji i tajmauti
TL;DR: Nema više potrebe za uključivanjem hitnih zadataka za upravljanje zahtjevima u bazu koda.
Sve te stvari mogle bi se smatrati zasebnim slučajevima upotrebe, ali odlučio sam ih spojiti zbog jedne zajedničke karakteristike: preuzimaju na sebe zadatke upravljanja životnim ciklusom zahtjeva, obično se rješavaju kroz aplikacijske biblioteke. Ako razvijate web server na Ruby on Rails (koji nije integriran s service mesh-om) i izvršava zahtjeve prema backend servisima putem , aplikacija će morati sama odlučiti što učiniti ako N zahtjeva ne uspije. Također će morati utvrditi koji volumen prometa ovi servisi mogu obraditi i 'hardcodirati' te parametre uz pomoć posebne biblioteke. Pored toga, aplikacija će morati odlučiti kada je vrijeme da odustane i dopusti zahtjevu da istekne (prema timeoutu). A za promjenu bilo kojeg od prethodno navedenih parametara, web server će morati biti zaustavljen, rekonstruiran i ponovo pokrenut.
Prenošenje ovih zadataka na servisnu mrežu ne znači samo da programeri servisa više neće morati brinuti o njima, već i da se mogu sagledavati na širi način. Ako se koristi složeni lanac servisa, recimo, A -> B -> C -> D -> E, potrebno je uzeti u obzir cijeli životni ciklus zahtjeva. Ako je cilj produžiti timeout u servisu C, logično je to učiniti odjednom, a ne parcijalno: ažurirati kod servisa i čekati da pull request bude prihvaćen i CI sistem postavi ažurirani servis.
14. Telemetrija
TL;DR: Prikupite sve potrebne (i nepotrebne) informacije od servisa.
Telemetrija je opšti termin koji obuhvata metrike, distribuirano praćenje i logove. Servisne mreže nude mehanizme za prikupljanje i obradu svih tri tipa podataka. Ovdje postaje malo nejasno, jer je broj mogućih opcija prevelik. Za prikupljanje metrike postoje i drugi alati, a za prikupljanje logova možete koristiti , , i dr. (na primjer, ClickHouse s našim za K8s — napomena prev.), za distribuirano praćenje postoji i slično. Svaka servisna mreža može podržavati određene alate, a ne podržavati druge. Bit će zanimljivo vidjeti može li projekt osigurati određenu konvergenciju.
U ovom slučaju prednost tehnologije service mesh je u tome što sidecar kontejneri mogu, u principu, prikupiti sve gore navedene podatke sa svojih usluga. Drugim rečima, na raspolaganje dobijate jedinstveni sistem prikupljanja telemetrije, a service mesh može obraditi sve te informacije na različite načine. Na primer:
- posmatrati logove nekog servisa u CLI;
- pratiti obim zahteva sa panela za upravljanje service mesh;
- prikupljati raspoređene tragove i preusmeravati ih u sistem kao što je Jaeger.
Pažnja, subjektivno mišljenje: Uopšteno govoreći, telemetrija je oblast u koju je snažno uključivanje servisne mreže nepoželjno. Prikupljanje osnovnih informacija i praćenje u realnom vremenu nekih «zlatnih metrika» poput procenta uspešnih zahteva i latencija je normalno, ali hajde da se nadamo da nećemo biti svedoci pojave nekih Frankenštajn stekova koji će pokušati da zamene specijalizovane sisteme, od kojih su neki već dobro dokazani i dobro proučeni.
15. Revizija
TL;DR: Onaj ko zaboravlja lekcije iz istorije, osuđen je da ih ponavlja.
Revizija je veština posmatranja važnih događaja unutar sistema. U slučaju service mesh-a, to može značiti praćenje ko je slao zahteve ka određenim endpoint-ima određenih servisa ili koliko puta se u poslednjem mesecu dogodio neki događaj u vezi sa bezbednošću.
Jasno je da je revizija veoma povezana sa telemetrijom. Razlika je u tome što se telemetrija obično povezuje sa stvarima kao što su performanse i tehnička efikasnost, dok revizija može imati veze sa pravnim i drugim pitanjima koja nadilaze strogo tehničke sfere (na primer, usklađenost sa GDPR-om - Opštom regulativom EU o zaštiti podataka).
16. Vizualizacija
TL;DR: Neka živi React.js - nepresuđeni izvor neobičnih interfejsa.
Možda postoji prikladniji termin, ali ga ne znam. Samo mislim na grafičko predstavljanje service mesh-a ili nekih njenih komponenti. Ove vizualizacije mogu uključivati indikatore kao što su prosečne latencije, informacije o konfiguraciji sidecar kontejnera, rezultate provere zdravlja i obaveštenja.
Rad u okruženju orijentisanom na usluge nosi mnogo veću kognitivnu opterećenost u poređenju sa Njegovom Veličanstvom Monolitom. Zato kognitivni pritisak treba smanjiti po svaku cenu. Banalan grafički interfejs za service mesh, sa mogućnošću klika na dugme i dobijanja željenog rezultata, može biti presudan za rast popularnosti ove tehnologije.
Nisu uključeni u listu
Prvobitno sam planirao da uključim još nekoliko scenarija korišćenja, ali sam na kraju odlučio da to ne uradim. Evo ih zajedno sa razlozima mog odluke:
- Multi-datacentar. U mom viđenju, to nije toliko scenario korišćenja, koliko uska i specifična oblast primene servisnih mreža ili nekog skupa funkcija poput otkrivanja usluga.
- Ingress i egress. Ovo je povezana oblast, ali sam se ograničio (možda veštački) scenarijom korišćenja 'east-west' saobraćaja. Ingress i egress zaslužuju poseban članak.
Zaključak
To je za sada sve! Ponovo, ova lista je prilično uslovna i verovatno nije potpuna. Ako mislite da sam nešto propustio, ili napravio grešku, obratite mi se na Twitteru (). Molim vas, poštujte pravila pristojnosti.
P.S. od prevodioca
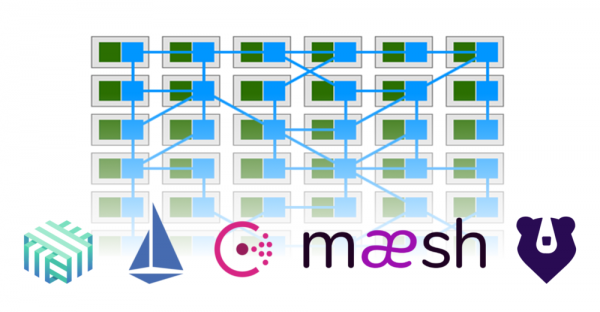
Kao osnova za naslovnu ilustraciju članka uzeta je slika iz članka '' (autor — Gregory MacKinnon). Na njoj je prikazano kako je deo funkcionalnosti iz aplikacija (zelenom bojom) prešao u service mesh, koja obezbeđuje međusobne povezanosti među njima (plavom bojom).
Takođe pročitajte na našem blogu:
- «»;
- «»;
- «».
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish