

Danas neće biti nikakvih složenih slučajeva ili kompliciranih SQL algoritama. Sve će biti vrlo jednostavno, na nivou Kapitana Očiglednost — radimo pregled registra događaja s sortiranjem prema vremenu.
Dakle, ovdje imamo tabelu u bazi events, a ona ima polje ts — to je tačno ono vreme po kojem želimo da ove zapise prikazujemo sortirane:
CREATE TABLE events(
  id
    serial
      PRIMARY KEY
, ts
    timestamp
, data
    json
);

CREATE INDEX ON events(ts DESC);
Jasno je da neće biti samo deset zapisa, zato će nam biti potrebna na neki način stranica navigacije.
#0. «Я у мамы погроммист»
cur.execute("SELECT * FROM events;")
rows = cur.fetchall();
rows.sort(key=lambda row: row.ts, reverse=True);
limit = 26
print(rows[offset:offset+limit]);
Čak i skoro ne šala — retko, ali se sreće u divljini. Ponekad, nakon rada sa ORM-om, teško je prebaciti se na 'direktni' rad sa SQL-om.
Ali hajde da pređemo na uobičajenije i manje očigledne probleme.
#1. OFFSET
SELECT
  ...
FROM
  events
ORDER BY
  ts DESC
LIMIT 26 OFFSET $1; -- 26 - zapisa na stranici, $1 - početak stranice
Odakle ovde broj 26? To je okvirna količina zapisa koja popunjava jedan ekran. Tačnije, 25 prikazanih zapisa, plus 1, koja signalizira da u pretrazi ima još nečega i ima smisla nastaviti dalje.
Naravno, ovu vrednost ne treba 'ukalupljivati' u telo upita, već je predavati kao parametar. Ali u tom slučaju, planirnik PostgreSQL-a neće moći da se oslanja na saznanje da će biti relativno malo zapisa — i lako može izabrati neefikasan plan.
I dok je u interfejsu aplikacije pregled registra implementiran kao prebacivanje između vizuelnih 'stranica', niko dugo ne primećuje ništa sumnjivo. Tačno do trenutka kada se, u borbi za praktičnost UI/UX, odluče da redešavaju interfejs na 'beskonačno skrolovanje' — tj. svi zapisi registra se prikazuju kao jedinstvena lista koju korisnik može da pomera gore-dole.
I tako, prilikom još jednog testiranja uhvate vas na dupliranju zapisa u registru. Zašto, kada na tabeli postoji normalan indeks (ts), na koji se oslanja vaš upit?
Tačno zato što niste uzeli u obzir da ts nije jedinstveni ključ u ovoj tabeli. U suštini, ni vrednosti nisu jedinstvene, kao i kod svake "vrijeme" u realnim uvjetima — zato se ista stavka u dva susjedna upita lako "preskoči" sa stranice na stranicu zbog drugačijeg konačnog poretka unutar sortiranja iste vrijednosti ključa.
U stvari, ovdje se skriva još jedan problem koji je puno teže primijetiti — neke stavke se neće prikazati uopće! Jer su "duplicirane" stavke zauzele nečije mjesto. Detaljno objašnjenje s lijepim slikama možete .
Proširujemo indeks
Snalažljiv programer shvata — potrebno je učiniti ključ indeksa jedinstvenim, a najjednostavniji način je proširiti ga unaprijed jedinstvenim poljem, za što je PK odličan:
CREATE UNIQUE INDEX ON events(ts DESC, id DESC);A upit se mutira:
SELECT
  ...
ORDER BY
  ts DESC, id DESC
LIMIT 26 OFFSET $1;
#2. Переход на «курсоры»
Nakon nekog vremena dolazi do vas DBA i "raduje" vas činjenicom da vaši upiti , i uopće, vrijeme je da pređete na navigaciju od posljednje prikazane vrijednosti. Vaš upit se opet mutira:
SELECT
  ...
WHERE
  (ts, id) < ($1, $2) -- posljednje primljene u prethodnom koraku vrijednosti
ORDER BY
  ts DESC, id DESC
LIMIT 26;
Olakšano ste uzdahnuli, sve dok nije došlo...
#3. Чистка индексов
Zato što je jednom vaš DBA pročitao i shvatio da "neposljednji" timestamp — to nije dobro. I opet je došao do vas — sada s mišlju da taj indeks ipak treba da se vrati u (ts DESC).
Ali šta da radimo s prvim problemom "skakanja" stavki između stranica?.. Sve je jednostavno — potrebno je birati blokove s nefixiranim brojem stavki!
Uopće, ko nam zabranjuje da čitamo ne "tačno 26", već "ne manje od 26"? Na primjer, tako da se u sljedećem bloku nađu stavke s unaprijed drugim vrijednostima ts — tada neće biti problema s "preskakanjem" stavki između blokova!
Evo kako to postići:
SELECT
  ...
WHERE
  ts = coalesce((
    SELECT
      ts
    FROM
      events
    WHERE
      ts < $1
    ORDER BY
      ts DESC
    LIMIT 1 OFFSET 25
  ), '-infinity')
ORDER BY
  ts DESC;
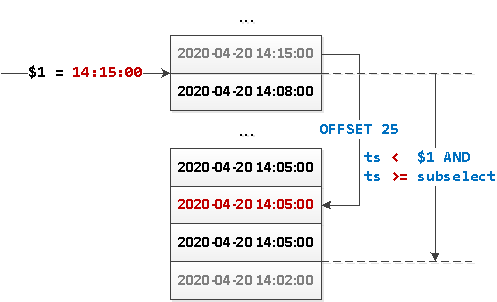
Šta se ovdje uopće dešava?
- Idemo na 25 stavki "dole" i dobijamo "graničnu" vrijednost
ts. - Ako tamo već nema ništa, zamjenjujemo NULL-vrijednost sa
-infinity. - Oduzimamo cijeli segment vrijednosti između dobijene vrijednosti
tsi proslijeđene iz interfejsa parametra $1 (prethodne "posljednje" prikazane vrijednosti). - Ako blok vrati manje od 26 zapisa, onda je to poslednji.
Isto to u slici:
Budući da sada imamo uzorak koji nema određeni 'početak', ništa nam ne preprečuje da 'okrenemo' ovaj upit unazad i implementiramo dinamičko učitavanje blokova podataka od 'referentne tačke' u obe strane — kako naniže, tako i naviše.
Napomena
- Da, u tom slučaju pristupamo indeksu dva puta, ali sve je 'čisto preko indeksa'. Stoga, ugnježdeni upit će dovesti do samo jednog dodatnog Index Only Scan-a.
- Izgleda prilično očigledno da se ovom metodom može koristiti samo kada imate vrednosti
tskoje se mogu preklapati samo slučajno, i ima ih malo. Međutim, ako je vaš tipični slučaj 'milion zapisa u 00:00:00.000', tako ne treba raditi. U tom smislu, ne treba dopuštati takve slučajeve. Ali ako se već tako dogodilo, koristite varijantu s proširenim indeksom.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish