

U ovom postu želimo podijeliti zanimljiv način rješavanja konfiguracije distribuiranog sistema.
Konfiguracija je direktno predstavljena u Scala jeziku na siguran način. Primjer implementacije je detaljno opisan. Različiti aspekti prijedloga se razmatraju, uključujući utjecaj na cjelokupan proces razvoja.
()
Introduction
Izgradnja robusnih distribuiranih sistema zahtijeva korištenje ispravne i koherentne konfiguracije na svim čvorovima. Tipično rješenje je korištenje tekstualnog opisa implementacije (terraform, ansible ili slično) i automatski generisanih konfiguracionih datoteka (često specifičnih za svaki čvor/ulogu). Takođe, želimo koristiti iste protokole istih verzija na svakom komunikacijskom čvoru (u suprotnom bismo doživjeli probleme s nekompatibilnošću). U JVM svijetu to znači da bi biblioteka za razmjenu poruka trebala biti iste verzije na svim komunikacijskim čvorovima.
Šta je sa testiranjem sistema? Naravno, trebali bismo imati jedinične testove za sve komponente prije nego što pređemo na integracione testove. Da bismo mogli ekstrapolirati rezultate testiranja na vrijeme izvođenja, moramo osigurati da verzije svih biblioteka budu identične u okruženjima za izvođenje i testiranje.
Kada pokrećemo integracione testove, često je mnogo lakše imati istu klasu putanja na svim čvorovima. Samo trebamo osigurati da se ista klasa putanja koristi prilikom implementacije. (Moguće je koristiti različite klase putanja na različitim čvorovima, ali je teže predstaviti ovu konfiguraciju i ispravno je implementirati.) Kako bismo pojednostavili stvari, razmatraćemo samo identične klase putanja na svim čvorovima.
Konfiguracija se obično razvija zajedno sa softverom. Obično koristimo verzije za prepoznavanje različitih
faza evolucije softvera. Čini se razumnim pokriti konfiguraciju pod upravljanjem verzijama i identificirati različite konfiguracije nekim oznakama. Ako postoji samo jedna konfiguracija u produkciji, možemo koristiti jednu verziju kao identifikator. Ponekad možemo imati više produkcijskih okruženja. I za svako okruženje možda će nam trebati zasebna grana konfiguracije. Tako se konfiguracije mogu označiti sa granom i verzijom kako bi jedinstveno identificirale različite konfiguracije. Svaka oznaka grane i verzija odgovaraju jedinstvenoj kombinaciji distribuiranih čvorova, portova, vanjskih resursa i verzija biblioteka klase na svakom čvoru. Ovdje ćemo pokriti samo jednu granu i identifikovati konfiguracije trokomponentnom decimalnom verzijom (1.2.3), na isti način kao i druge artefakte.
U modernim okruženjima konfiguracione datoteke više se ne modifikuju ručno. Tipično generišemo
konfiguracione datoteke u vrijeme implementacije i nakon toga. Stoga bi se moglo postaviti pitanje zašto još uvijek koristimo tekstualni format za konfiguracione datoteke? Održivija opcija je smještanje konfiguracije unutar kompilacione jedinice i koristi se od koristi od validacije konfiguracije u vrijeme kompilacije.
U ovom postu ćemo ispitati ideju zadržavanja konfiguracije u kompiliranom artefaktu.
Kompilabilna konfiguracija
U ovom odjeljku ćemo raspraviti primjer statičke konfiguracije. Dvije jednostavne usluge — echo usluga i klijent echo usluge se konfigurišu i implementiraju. Zatim se instanciraju dva različita distribuirana sistema s obje usluge. Jedan je za konfiguraciju jednog čvora, a drugi za konfiguraciju dva čvora.
Tipičan distribuirani sistem se sastoji od nekoliko čvorova. Čvorovi se mogu identificirati koristeći neki tip:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
ili samo
case class NodeId(hostName: String)ili čak
object Singleton
type NodeId = Singleton.type
Ovi čvorovi obavljaju različite uloge, pokreću neke usluge i trebaju biti sposobni komunicirati s drugim čvorovima putem TCP/HTTP veza.
Za TCP vezu je potrebna barem jedna broj porta. Također želimo osigurati da klijent i server razgovaraju istim protokolom. Da bismo modelirali vezu između čvorova, deklarišimo sljedeću klasu:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])gdje Port je samo jedan Int unutar dozvoljenog opsega:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Refined tipovi
Pogledajte biblioteka. Ukratko, omogućava dodavanje ograničenja u vrijeme kompajliranja drugim tipovima. U ovom slučaju Int samo su dozvoljene 16-bitne vrijednosti koje mogu predstavljati broj porta. Nema obaveze da se koristi ova biblioteka za ovaj pristup konfiguraciji. Jednostavno se čini da se vrlo dobro uklapa.
Za HTTP (REST) možda ćemo također trebati putanju servisa:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Fantom tip
Kako bismo identifikovali protokol tokom kompajliranja, koristimo Scala funkciju deklarisanja tipnog argumenata Protokol koja se ne koristi u klasi. To je takozvani fantom tip. Tokom izvršavanja rijetko nam je potreban instanca identifikatora protokola, zato ga ne skladištimo. Tokom kompajliranja ovaj fantom tip pruža dodatnu tipnu sigurnost. Ne možemo proći port sa pogrešnim protokolom.
Jedan od najšire korištenih protokola je REST API sa Json serijalizacijom:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]gdje RequestMessage je osnovni tip poruka koje klijent može poslati serveru i ResponseMessage je odgovor poruka sa servera. Naravno, možemo kreirati i druge opise protokola koji preciziraju komunikacijski protokol sa željenom preciznošću.
Za potrebe ovog posta koristićemo jednostavniju verziju protokola:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]U ovom protokolu, poruka zahteva se dodaje url-u, a poruka odgovora se vraća kao običan string.
Konfiguracija servisa može se opisati imenom servisa, kolekcijom portova i nekim zavisnostima. Postoji nekoliko mogućih načina kako predstaviti sve te elemente u Scali (na primer, HList, algebarske datum tipove). Za potrebe ovog posta koristićemo Cake Pattern i predstaviti kombinabilne delove (module) kao traitove. (Cake Pattern nije zahtjev za ovaj pristup konfiguraciji koja se može kompajlirati. To je samo jedna moguća implementacija ideje.)
Zavisnosti se mogu predstavljati korišćenjem Cake Pattern kao endpointi drugih čvorova:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Echo servis samo treba konfigurisan port. I izjavljujemo da ovaj port podržava echo protokol. Napomena da ne trebamo specificirati određeni port u ovom trenutku, jer trait omogućava deklaracije apstraktnih metoda. Ako koristimo apstraktne metode, kompajler će zahtevati implementaciju u instanci konfiguracije. Ovde smo pružili implementaciju (8081) i ona će se koristiti kao podrazumijevana vrijednost ako je izostavimo u konkretnoj konfiguraciji.
Možemo izjaviti zavisnost u konfiguraciji klijenta echo servisa:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Zavisnost ima isti tip kao echoService. Konkretno, zahteva isti protokol. Stoga, možemo biti sigurni da će, ako povežemo ova dva zavisnosti, raditi ispravno.
Implementacija servisa
Servis treba funkciju za pokretanje i uredno zatvaranje. (Sposobnost zatvaranja servisa je kritična za testiranje.) Ponovo, postoji nekoliko opcija za specifikaciju takve funkcije za određenu konfiguraciju (na primer, mogli bismo koristiti tipne klase). Za ovaj post ćemo ponovo koristiti Cake Pattern. Možemo predstaviti servis koristeći cats.Resource koji već pruža bracketiranje i oslobađanje resursa. Da bismo stekli resurs, trebamo pružiti konfiguraciju i neku vremensku kontekst. Tako funkcija za pokretanje servisa može izgledati ovako:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
gdje
Podešavanje— tip konfiguracije koja je potrebna ovom pokretaču servisaAddressResolver— objekat za izvođenje koji ima sposobnost da pribavi stvarne adrese drugih čvorova (nastavite da čitate za detalje).
ostali tipovi dolaze iz cats:
F[_]— tip efekta (u najjednostavnijem slučajuF[A]može biti samo() => A. U ovom postu ćemo koristiticats.IO.)Reader[A,B]— više ili manje sinonim za funkcijuA => Bcats.Resource— ima načine da nabavi i oslobodiTimer— omogućava spavanje/mjerenje vremenaContextShift— analogExecutionContextApplicative— omotač funkcija u efektu (skoro monada) (možda ćemo ga na kraju zameniti nečim drugim)
Koristeći ovaj interfejs možemo implementirati nekoliko servisa. Na primer, servis koji ne radi ništa:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Pogledajte za druge implementacije servisa — ,
and .)
Čvor je jedinstveni objekat koji pokreće nekoliko servisa (pokretanje lanca resursa omogućeno je Cake Pattern-om):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Napomena da u čvoru specifično definišemo tip konfiguracije koji je potreban ovom čvoru. Kompajler nam neće dopustiti da gradimo objekat (Cake) s nedovoljnom vrstom, jer svaka servisna karakteristika definiše ograničenje na Podešavanje tip. Takođe nećemo moći da pokrenemo čvor bez pružanja kompletne konfiguracije.
Rešavanje adrese čvora
Da bismo uspostavili vezu, potrebna nam je stvarna adresa hosta za svaki čvor. Moguće je da se sazna kasnije nego ostale delove konfiguracije. Stoga, potrebna nam je metoda za pružanje mapiranja između id čvora i njegove stvarne adrese. Ovo mapiranje je funkcija:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Postoji nekoliko mogućih načina za implementaciju takve funkcije.
- Ako znamo stvarne adrese pre implementacije, tokom instanciranja hostova čvorova, možemo generisati Scala kod sa stvarnim adresama i kasnije pokrenuti gradnju (što obavlja provjere u vreme kompajliranja i zatim pokreće skup testova integracije). U ovom slučaju, naša funkcija mapiranja je poznata statički i može se pojednostaviti na nešto poput
Map[NodeId, NodeAddress]. - Ponekad dobijemo stvarne adrese samo u kasnijoj fazi kada je čvor zapravo pokrenut, ili nemamo adrese čvorova koji još nisu pokrenuti. U ovom slučaju, mogli bismo imati servis za otkrivanje koji se pokreće pre svih drugih čvorova i svaki čvor bi mogao da oglašava svoju adresu u tom servisu i pretplatiti se na zavisnosti.
- Ako možemo da izmenimo
/etc/hosts, možemo koristiti unapred definisane nazive hostova (poputmy-project-main-nodeandecho-backend) i jednostavno povezati ovo ime sa IP adresom u vreme implementacije.
U ovom postu ne pokrivamo ove slučajeve u više detalja. U stvari, u našem probnom primeru svi čvorovi će imati istu IP adresu — 127.0.0.1.
U ovom postu ćemo razmotriti dva rasporeda distribuiranog sistema:
- Jedan čvor, gde su svi servisi smešteni na jednom čvoru.
- Dva čvora, gde su servis i klijent na različitim čvorovima.
Konfiguracija za raspored je sledeća:
Konfiguracija jednog čvora
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifikator jedinog čvora
  \/\/ konfiguracija servera
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Tip sigurne specifikacije uslužnog porta. *\/
  override def portNumber: PortNumber = 8088

  \/\/ konfiguracija klijenta

  \/** Koristićemo uslugu pruženu od istog hosta. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ konfiguracija kontrolera životnog ciklusa
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ dodatnih 0.5 sekundi kako bi bilo 10 zahteva, a ne 9.
}
Ovde kreiramo jedinstvenu konfiguraciju koja proširuje i konfiguraciju servera i klijenta. Takođe konfigurišemo kontroler životnog ciklusa koji će obično prekinuti klijenta i server nakon životnog veka prolaznog intervala.
Isti set implementacija usluga i konfiguracija može se koristiti za kreiranje rasporeda sistema sa dva odvojena čvora. Samo treba da kreiramo sa odgovarajućim uslugama:
Konfiguracija dva čvora
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! specifikacija zavisnosti
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ dodatnih 0.5 sekundi kako bi bilo 10 zahteva, a ne 9.

    def testMessage: String = "dolly"
  }
Pogledajte kako specificiramo zavisnost. Pominjemo pruženu uslugu drugog čvora kao zavisnost trenutnog čvora. Tip zavisnosti se proverava jer sadrži fantomski tip koji opisuje protokol. A u vreme izvođenja imaćemo ispravan identifikator čvora. Ovo je jedan od važnih aspekata predloženog pristupa konfiguraciji. Omogućava nam da port postavimo samo jednom i budemo sigurni da se pozivamo na ispravan port.
Implementacija dva čvora
Za ovu konfiguraciju koristimo potpuno iste implementacije usluga. Nema nikakvih promena. Ipak, kreiramo dve različite implementacije čvora koje sadrže različit set usluga:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Prvi čvor implementira server i samo mu je potrebna konfiguracija servera. Drugi čvor implementira klijenta i treba mu drugačiji deo konfiguracije. Obojici čvorova potrebna je neka specifikacija životnog veka. U svhu ovog posta, čvor usluge će imati beskonačan životni vek koji će moći biti prekinut korišćenjem SIGTERM, dok će echo klijent prekinuti nakon konfigurisane ograničene dužine. Pogledajte za detalje.
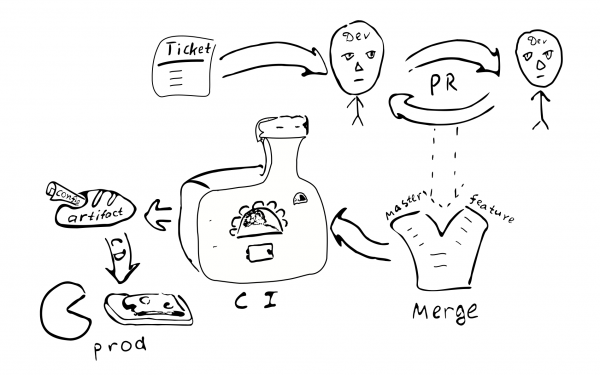
Overall razvojni proces
Hajde da vidimo kako ovaj pristup menja način na koji radimo sa konfiguracijom.
Konfiguracija kao kod će biti kompajlirana i proizvoditi artefakt. Čini se razumnim odvojiti artefakt konfiguracije od drugih kod artefakata. Često možemo imati mnoštvo konfiguracija na istoj bazi koda. I naravno, možemo imati više verzija različitih grana konfiguracije. U konfiguraciji možemo odabrati određene verzije biblioteka i to će ostati konstantno svaki put kada implementiramo ovu konfiguraciju.
Promena u konfiguraciji postaje promena u kodu. Tako da bi trebala biti pokrivena istim procesom osiguranja kvaliteta:
Tiket -> PR -> pregled -> spajanje -> kontinuirana integracija -> kontinuirano implementiranje
Slede posljedice ovog pristupa:
- Konfiguracija je koherentna za instancu određenog sistema. Čini se da ne postoji način da dođe do pogrešne veze između čvorova.
- Nije lako promijeniti konfiguraciju samo na jednom čvoru. Čini se nerazumnim prijavljivati se i mijenjati neke tekstualne datoteke. Tako da odstupanje u konfiguraciji postaje manje moguće.
- Male promjene u konfiguraciji nisu lake za implementaciju.
- Većina promjena u konfiguraciji slijedi isti proces razvoja i prolazi kroz pregled.
Da li imamo potrebu za odvojenom repozitorijom za produkcijsku konfiguraciju? Produkcijska konfiguracija može sadržavati osjetljive informacije koje bismo željeli zadržati van dohvata mnogih ljudi. Stoga bi vrijedilo zadržati odvojenu repozitoriju s ograničenim pristupom koja će sadržavati produkcijsku konfiguraciju. Možemo podijeliti konfiguraciju na dva dijela - jedan koji sadrži većinu otvorenih parametara produkcije i jedan koji sadrži tajni dio konfiguracije. To bi omogućilo pristup većini programera na većinu parametara dok bi se pristup zaista osjetljivim informacijama ograničio. Lako je ostvariti ovo koristeći međuslojevite karakteristike s zadanim vrijednostima parametara.
Varijacije
Pogledajmo prednosti i nedostatke predloženog pristupa u poređenju s drugim tehnikama upravljanja konfiguracijom.
Prvo ćemo nabrojati nekoliko alternativnih pristupa različitim aspektima predloženog načina upravljanja konfiguracijom:
- Tekstualna datoteka na ciljnoj mašini.
- Centralizovana skladišna jedinica ključ-vrijednost (poput
etcd/zookeeper). - Komponente podprocesa koje se mogu ponovo konfigurisati/ponovno pokrenuti bez ponovnog pokretanja procesa.
- Konfiguracija van artefakta i kontrole verzija.
Tekstualna datoteka pruža određenu fleksibilnost za ad-hoc ispravke. Sistem administrator može se prijaviti na ciljni čvor, napraviti promjenu i jednostavno ponovo pokrenuti uslugu. Ovo možda nije najbolje za veće sisteme. Nema tragova o promjeni. Promjena nije pregledana od strane drugog nekoga. Može biti teško utvrditi šta je uzrokovalo promjenu. Nije testirana. Sa stanovišta distribuiranog sistema, administrator može jednostavno zaboraviti ažurirati konfiguraciju na jednom od drugih čvorova.
(Usput, ako se na kraju ukaže potreba za korištenjem tekstualnih konfiguracijskih datoteka, morat ćemo samo dodati parser + validator koji može proizvesti isti Podešavanje tip i to bi bilo dovoljno za početak korištenja tekstualnih konfiguracija. Ovo takođe pokazuje da je složenost konfiguracije u vrijeme kompilacije nešto manja od složenosti tekstualnih konfiguracija, jer u verzijama zasnovanim na tekstu trebamo dodatni kod.)
Centralizovano skladište ključ-vrednost je dobar mehanizam za distribuciju meta parametara aplikacije. Ovde moramo razmisliti o tome šta smatramo konfiguracionim vrijednostima i šta je samo podatak. Dajući funkciju C => A => B obično rijetko mijenjane vrijednosti nazivamo "konfiguracija", dok često menjani podaci C — samo ulazni podaci. Konfiguracija treba biti obezbeđena funkciji ranije nego podaci A . Imajući ovu ideju, možemo reći da je očekivana učestalost promjena ono što se može koristiti za razlikovanje konfiguracionih podataka od običnih podataka. Takođe, podaci obično dolaze iz jednog izvora (korisnik), a konfiguracija dolazi iz drugog izvora (administrator). Baveći se parametrima koji se mogu mijenjati nakon inicijalizacije procesa dovodimo do povećanja složenosti aplikacije. U vezi s takvim parametrima morat ćemo se baviti mehanizmima isporuke, parsiranjem i validacijom, te rukovanjem s neispravnim vrijednostima. Stoga bismo, da bismo smanjili složenost programa, najbolje učinili smanjenjem broja parametara koji se mogu mijenjati tijekom vremena izvođenja (ili ih čak potpuno eliminirati). A. Given this idea we can say that it’s expected frequency of changes what could be used to distinguish configuration data from just data. Also data typically comes from one source (user) and configuration comes from a different source (admin). Dealing with parameters that can be changed after process initialization leads to an increase of application complexity. For such parameters we’ll have to handle their delivery mechanism, parsing and validation, handling incorrect values. Hence, in order to reduce program complexity, we’d better reduce the number of parameters that can change at runtime (or even eliminate them altogether).
Iz perspektive ovog posta trebamo napraviti razliku između statičkih i dinamičkih parametara. Ako logika usluge zahtijeva rijetku promjenu nekih parametara tokom rada, tada ih možemo nazvati dinamičkim parametrima. U suprotnom su statički i mogu se konfigurirati koristeći predloženi pristup. Za dinamičku rekonfiguraciju mogu biti potrebni drugi pristupi. Na primjer, dijelovi sistema mogu se ponovno pokrenuti sa novim parametrima konfiguracije na sličan način kao što se ponovo pokreću zasebni procesi distribuiranog sistema.
(Moje skromno mišljenje je da treba izbjegavati rekonfiguraciju tokom rada jer povećava složenost sistema.
Možda bi bilo jednostavnije osloniti se na podršku operativnog sistema za ponovno pokretanje procesa. Iako to možda nije uvijek moguće.)
Jedan važan aspekt korištenja statičke konfiguracije koji ponekad tjera ljude da razmatraju dinamičku konfiguraciju (bez drugih razloga) je zastoja usluge tokom ažuriranja konfiguracije. Doista, ako moramo napraviti promjene u statičkoj konfiguraciji, moramo restartovati sistem kako bi nove vrijednosti postale aktivne. Zahtjevi za zastoje razlikuju se među različitim sistemima, tako da to možda nije kritično. Ako jeste kritično, moramo unaprijed planirati bilo kakva ponovno pokretanja sistema. Na primjer, mogli bismo implementirati . U ovom scenariju, kad god trebamo ponovo pokrenuti sistem, pokrećemo novu instancu sistema paralelno, zatim prebacujemo ELB na nju, dok starom sistemu omogućavamo da završi servisiranje postojećih veza.
Što je s čuvanjem konfiguracije unutar verzioniranog artefakta ili izvan njega? Čuvanje konfiguracije unutar artefakta u većini slučajeva znači da je ova konfiguracija prošla isti proces osiguranja kvaliteta kao i drugi artefakti. Tako se može biti siguran da je konfiguracija dobre kvalitete i pouzdana. Nasuprot tome, konfiguracija u odvojenoj datoteci znači da nema tragova ko i zašto je napravio promjene u toj datoteci. Da li je to važno? Vjerujemo da je za većinu proizvodnih sistema bolje imati stabilnu i visokokvalitetnu konfiguraciju.
Verzija artefakta omogućava da se sazna kada je stvorena, koje vrijednosti sadrži, koje funkcije su omogućen / onemogućene, ko je bio odgovoran za svaku promjenu u konfiguraciji. Možda će biti potrebno malo truda da se konfiguracija zadrži unutar artefakta i to je izbor dizajna koji treba donijeti.
Prednosti i nedostaci
Ovde želimo istaknuti neke prednosti i raspraviti neke nedostatke predloženog pristupa.
Prednosti
Značajke kompajlabilne konfiguracije potpunog distribuiranog sistema:
- Statička provjera konfiguracije. Ovo daje visok nivo povjerenja da je konfiguracija ispravna s obzirom na tipovne restrikcije.
- Bogati jezik konfiguracije. Obično su drugi pristupi konfiguraciji ograničeni na najviše zamjenu varijabli.
Korištenjem Scale može se koristiti širok spektar jezičnih karakteristika kako bi se konfiguracija poboljšala. Na primjer, možemo koristiti traitove za pružanje defaultnih vrijednosti, objekte za postavljanje različitih opsega, možemo se pozvati navals definiran samo jednom u vanjskom opsegu (DRY). Moguće je koristiti literalne sekvence ili instance određenih klasa (Seq,Map, itd.). - DSL. Scala ima dobru podršku za pisce DSL-a. Može se koristiti ove karakteristike za uspostavljanje jezika konfiguracije koji je prikladniji i prijatniji za krajnjeg korisnika, tako da je konačna konfiguracija barem čitljiva za korisnike iz domena.
- Integritet i koherentnost među čvorovima. Jedna od prednosti imanja konfiguracije za cijeli distribuirani sistem na jednom mestu je to da su sve vrijednosti definisane striktno jednom i zatim ponovo korištene u svim mjestima gde su potrebne. Također, sigurne deklaracije portova osiguravaju da u svim mogućim ispravnim konfiguracijama čvorovi sistema govore istim jezikom. Postoje eksplicitne zavisnosti među čvorovima što otežava zaboraviti pružiti neke usluge.
- Visoka kvaliteta promjena. Opći pristup proslijeđivanja promjena konfiguracije kroz normalan PR proces postavlja visoke standarde kvalitete i u konfiguraciji.
- Istodobne promjene konfiguracije. Kada god napravimo bilo kakve promjene u konfiguraciji, automatska implementacija osigurava da se svi čvorovi ažuriraju.
- P pojednostavljenje aplikacije. Aplikacija ne mora parsirati i validirati konfiguraciju niti se nositi s neispravnim vrijednostima konfiguracije. To pojednostavljuje cjelokupnu aplikaciju. (Neki porast složenosti je u samoj konfiguraciji, ali to je svjesna kompenzacija prema sigurnosti.) Vrlo je jednostavno vratiti se na običnu konfiguraciju — samo dodajte nedostajuće dijelove. Lakše je početi s kompajliranom konfiguracijom i odgoditi implementaciju dodatnih dijelova za neki kasniji trenutak.
- Verzionirana konfiguracija. Zbog toga što promjene konfiguracije prate isti razvojni proces, kao rezultat dobijamo artefakt s jedinstvenom verzijom. To nam omogućava da, ako je potrebno, prebacimo konfiguraciju nazad. Možemo čak postaviti konfiguraciju koja je korištena prije godinu dana i ona će raditi potpuno identično. Stabilna konfiguracija poboljšava predvidljivost i pouzdanost distribuiranog sistema. Konfiguracija je fiksirana u vrijeme kompajliranja i ne može se lako mijenjati na produkcijskom sistemu.
- Modularnost. Predloženi okvir je modularan i moduli se mogu kombinirati na razne načine
za podršku različitim konfiguracijama (postavkama/rasporedima). Konkretno, moguće je imati raspored malog opsega s jednim čvorom i raspored velikog opsega s više čvorova. Razmjerno je imati više produkcijskih postavki. - Testiranje. U svrhe testiranja može se implementirati lažna usluga i koristiti je kao zavisnost na siguran način. Mogu se održavati različiti testni rasporedi s raznim dijelovima zamijenjenim lažnjacima istovremeno.
- Integracijsko testiranje. Ponekad je u distribuiranim sistemima teško izvoditi integracijska testiranja. Koristeći opisani pristup tipavno sigurne konfiguracije cijelog distribuiranog sistema, možemo pokrenuti sve distribuirane dijelove na jednom serveru na kontroliran način. Lako je emulirati situaciju
kada neka od usluga postane nedostupna.
Nedostaci
Pristup kompajliranoj konfiguraciji razlikuje se od «normalne» konfiguracije i možda neće odgovarati svim potrebama. Evo nekih nedostataka kompajlirane konfiguracije:
- Statička konfiguracija. Možda nije pogodna za sve aplikacije. U nekim slučajevima postoji potreba za brzo popravljanjem konfiguracije u produkciji zaobilazeći sve sigurnosne mjere. Ovaj pristup otežava to. Kompajliranje i ponovno implementiranje su potrebni nakon svake promjene u konfiguraciji. Ovo je i karakteristika i teret.
- Generisanje konfiguracije. Kada konfiguraciju generira neki alat za automatizaciju, ovaj pristup zahtijeva naknadno kompajliranje (što također može propasti). Moguće je da će biti potrebni dodatni napori da se integrira ovaj dodatni korak u sistem izgradnje.
- Instrumenti. Danas postoji mnogo alata koji se oslanjaju na konfiguracije bazirane na tekstu. Neki od njih
neće biti primjenjivi kada je konfiguracija kompajlirana. - Potrebna je promjena u razmišljanju. Programeri i DevOps su navikli na konfiguracijske datoteke u tekstualnom formatu. Ideja o kompajliranju konfiguracije može im se činiti čudnom.
- Prije uvođenja kompajlabilne konfiguracije potreban je visokokvalitetan proces razvoja softvera.
Postoje neka ograničenja implementiranog primjera:
- Ako pružimo dodatnu konfiguraciju koja nije zahtevana od implementacije čvora, kompajler nas neće pomoći da otkrijemo odsutnu implementaciju. Ovo se može riješiti korištenjem
HListili ADT-ova (case klasa) za konfiguraciju čvora umjesto traitova i Cake Pattern-a. - Moramo pružiti neki šablon u konfiguracijskoj datoteci: (
package,import,objekatdeklaracije;
override def‘s za parametre koji imaju podrazumijevane vrijednosti). Ovo se može djelomično riješiti korištenjem DSL-a. - U ovom postu ne pokrivamo dinamičku rekonekciju klastera sličnih čvorova.
Zaključak
U ovom postu razgovarali smo o ideji direktnog predstavljanja konfiguracije u izvornoj kodu na tip siguran način. Ovaj pristup se može koristiti u mnogim aplikacijama kao zamena za XML i druge tekstualne konfiguracije. Iako je naš primer implementiran u Scali, mogao bi se takođe preneti na druge kompajlabilne jezike (kao što su Kotlin, C#, Swift, itd.). Ovaj pristup se može isprobati u novom projektu i, ako ne odgovara dobro, vratiti se starom načinu.
Naravno, kompajlabilna konfiguracija zahteva visok kvalitet procesa razvoja. U zamenu, obećava da će pružiti jednako visok kvalitet robusne konfiguracije.
Ovaj pristup se može proširiti na razne načine:
- Mogu se koristiti makroi za vršenje validacije konfiguracije i greške na vreme kompajliranja u slučaju bilo kakvih neuspjeha poslovne logike.
- DSL se može implementirati za predstavljanje konfiguracije na način koji je prijateljski prema korisnicima domena.
- Dinamičko upravljanje resursima uz automatske prilagodbe konfiguracije. Na primer, kada prilagodimo broj čvorova klastera, mogli bismo hteti (1) da čvorovi dobiju malo modifikovanu konfiguraciju; (2) da klaster menadžer primi nove informacije o čvorovima.
Hvala
Želim da se zahvalim Andrey Saksonovu, Pavlu Popovu i Antonu Nehaevu za inspirativne povratne informacije o nacrtu ovog posta koje su mi pomogle da ga učinim jasnijim.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish