

Prezentacija iz 2015. godine Alekseja Lesovskog "Duboko istraživanje unutrašnje statistike PostgreSQL"
Izjava autora prezentacije: Napominjem da je ova prezentacija datirana novembrom 2015. godine — prošlo je više od 4 godine i mnogo se toga dogodilo. Verzija 9.4 o kojoj se govori u prezentaciji više nije podržana. Tokom poslednje 4 godine objavljeno je 5 novih verzija sa brojnim novitetima, poboljšanjima i promenama u vezi sa statistikom, a deo materijala je zastareo i nije aktuelan. Tokom revidiranja pokušao sam da označim te delove kako ne bih doveo čitatelje u zabludu. Nije bilo moguće ponovo napisati te delove, ima ih previše i na kraju bi to dovelo do potpuno druge prezentacije.
Sistem upravljanja podacima PostgreSQL je ogroman mehanizam, koji se sastoji od mnogih podsistema, čiji skladan rad direktno utiče na performanse sistema. Tokom eksploatacije prikupljaju se statistike i informacije o radu komponenti, što omogućava procenu efikasnosti PostgreSQL-a i preduzimanje mera za poboljšanje performansi. Međutim, ovih informacija je jako mnogo i predstavljene su u prilično pojednostavljenom formatu. Obrada ovih informacija i njihova interpretacija ponekad je veoma složen zadatak, a "zoo" alata i utilitarnih programa lako može zbuniti i naprednog DBA.
Dobar dan! Zovem se Aleksej. Kao što je Ilija rekao, pričat ću o statistici PostgreSQL.
Statistika aktivnosti PostgreSQL-a. PostgreSQL ima dve vrste statistike. Jedna je statistika aktivnosti, o kojoj će biti reči. Druga je statistika planera o raspodeli podataka. Govoriću upravo o statistici aktivnosti PostgreSQL-a, koja nam omogućava da procenimo performanse i eventualno ih poboljšamo.
Obratiću pažnju na to kako efikasno koristiti statistiku za rešavanje raznih problema koji se mogu pojaviti.
Šta neće biti obuhvaćeno u prezentaciji? U prezentaciji se neću baviti statistikom planera, jer je to posebna tema koja zahteva zasebnu prezentaciju o tome kako se podaci čuvaju u bazi i kako planer zahteva dobija predstavu o kvalitativnim i kvantitativnim karakteristikama tih podataka.
I neće biti pregleda alata, neću upoređivati jedan proizvod sa drugim. Nema reklama. To ćemo odbaciti.
Želim vam pokazati da korištenje statistike može biti korisno. To je neophodno. Korištenje nje nije zastrašujuće. Trebat će nam samo običan SQL i osnovno znanje o SQL-u.
I razgovarat ćemo o tome koju statistiku odabrati za rješavanje problema.
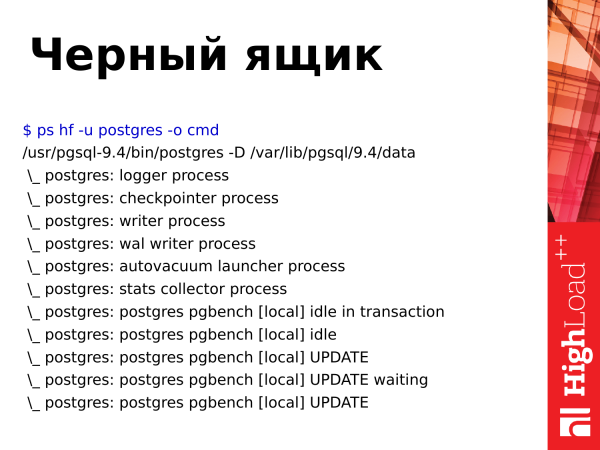
Ako pogledamo PostgreSQL i u operativnom sistemu pokrenemo komandu za prikaz procesa, vidjet ćemo "crnu kutiju". Vidjet ćemo neke procese koji nešto rade, i po nazivima možemo otprilike naslutiti što rade. Ali, suštinski, to je crna kutija, ne možemo zaviriti unutra.
Možemo pogledati opterećenje procesora u top, možemo pogledati iskorištenost memorije pomoću nekih sistemskih alata, ali ne možemo zaviriti unutra u PostgreSQL. Za to su nam potrebni drugi alati.
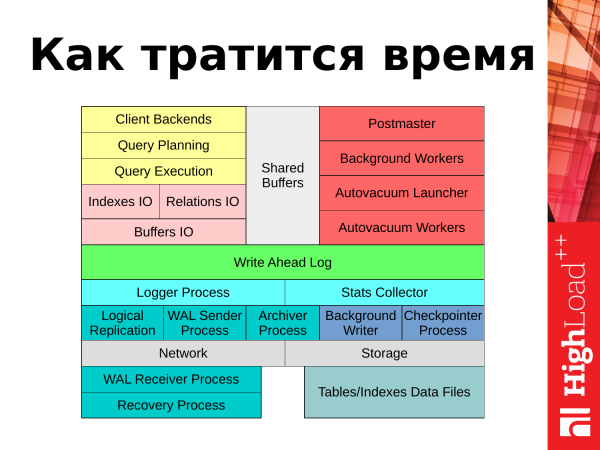
I nastavljajući dalje, govorit ću o tome gdje se troši vrijeme. Ako zamislimo PostgreSQL kao neku shemu, moći ćemo odgovoriti na pitanje gdje se troši vrijeme. Tu su dvije stvari: obrada zahtjeva klijenata iz aplikacija i pozadinski zadaci koje PostgreSQL izvršava za održavanje svoje funkcionalnosti.
Ako počnemo razmatrati od gornjeg lijevog ugla, možemo pratiti obradu klijentovih zahtjeva. Zahtjev dolazi od aplikacije i za daljnji rad otvara se klijentska sesija. Zahtjev se predaje planeru. Planer izrađuje plan zahtjeva. Šalje ga dalje na izvršenje. Odvija se neki blokovski unos-izlaz podataka povezanih s tabelama i indeksima. Potrebni podaci se čitaju s diskova u memoriju u specijalnu oblast "shared buffers". Rezultati zahtjeva, ako su to ažuriranja, brisanja, bilježe se u dnevniku transakcija u WAL-u. Neka statistička informacija dolazi u log ili u kolektor statistike. I rezultat zahtjeva se vraća klijentu. Nakon čega klijent može ponoviti sve iznova s novim zahtjevom.
Što je s pozadinskim zadacima i pozadinskim procesima? Imamo nekoliko procesa koji osiguravaju funkcionalnost i održavaju bazu podataka u normalnom radnom stanju. Ovi procesi također će biti obrađeni u izlaganju: to su autovacuum, checkpointer, procesi povezani s replikacijom, background writer. Svakog od njih ću obraditi tokom izlaganja.
Koji su problemi vezani za statistiku?
- PostgreSQL 9.4 nudi mnogo informacija. Pruža 109 mjera za pregled statističkih podataka. No, ako se u bazi podataka čuva mnogo tabela, šema, baza, tada će se sve te mjere morati pomnožiti s odgovarajućim brojem tabela i baza. To znači da informacija postaje još više. A lako je zaroniti u nju.
- Sljedeći problem je taj da je statistika predstavljena brojčanim pokazateljima. Ako pogledamo ovu statistiku, vidjet ćemo stalno rastuće brojeve. I ako je od trenutka resetiranja statistike prošlo jako dugo vremena, vidjet ćemo milijarde vrijednosti. A one nam ništa ne govore.
- Nema historije. Ako je došlo do nekog kvara, nešto je palo prije 15-30 minuta, ne možemo iskoristiti statistiku da vidimo što se dogodilo prije 15-30 minuta. To je problem.
- Nedostatak ugrađenog alata u PostgreSQL-u predstavlja problem. Razvijači jezgra ne pružaju nikakav alat. Nemaju ništa takvo. Oni jednostavno daju statistiku u bazi. Koristite, pravite upite kako želite.
- Budući da ne postoji ugrađeni alat u PostgreSQL-u, to uzrokuje drugi problem. Mnoštvo alata trećih strana. Svaka kompanija koja ima više-manje sposobne ruke pokušava napisati svoj program. Na kraju, u zajednici ima mnogo alata koje možemo koristiti za rad sa statistikama. U nekim alatima postoje određene mogućnosti, u drugim nema, ili postoje neke nove mogućnosti. I pojavljuje se situacija da je potrebno koristiti dva, tri ili četiri alata koja se međusobno preklapaju i imaju različite funkcije. To je vrlo neugodno.
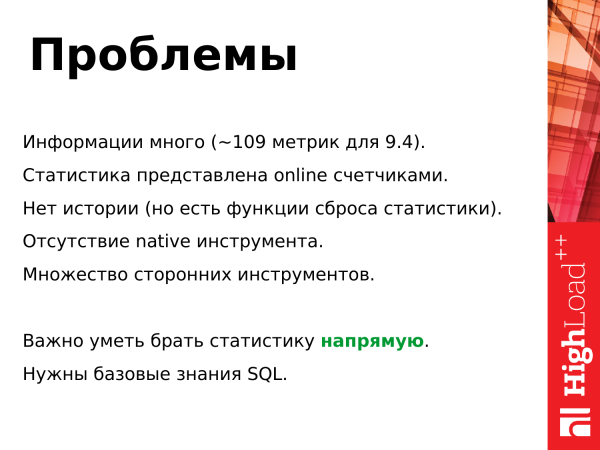
Što iz toga slijedi? Važno je znati kako direktno uzeti statistiku, da ne bismo zavisili od programa, ili nekako poboljšali te programe: dodali neke funkcije kako bismo dobili svoju korist.
I potrebna su osnovna znanja SQL-a. Da bismo dobili neke podatke iz statistike, potrebno je sastaviti SQL upite, tj. morate znati kako se sastavljaju select, join.
Statistika nam nudi nekoliko stvari. Možemo ih podijeliti u kategorije.
- Prva kategorija su događaji koji se dešavaju u bazi. To su kada u bazi dođe do nekog događaja: upit, pristup tabeli, automatska vakuumacija, potpisivanja; svi to su događaji. Prikladni brojači za ove događaje se inkrementiraju. I možemo pratiti te događaje.
- Druga kategorija su svojstva objekata kao što su tabele, baze. Ona imaju svojstva. To je veličina tabela. Možemo pratiti rast tabela, rast indeksa. Možemo pogledati promene u dinamičkom rastu.
- Treća kategorija je vreme potrošeno na događaj. Upit je događaj. Ima svoju konkretno meru trajanja. Ovdje se pokrenuo, ovdje se završio. To možemo pratiti. Takođe se beleži vreme čitanja bloka sa diska ili zapisivanja. Takve stvari se takođe prate.
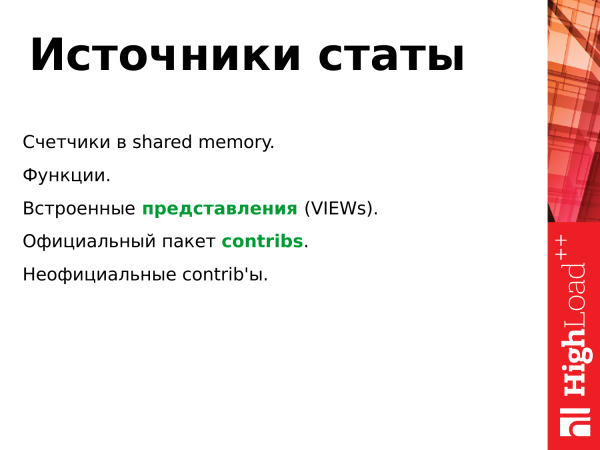
Izvori statistike predstavljeni su na sledeći način:
- U deljenoj memoriji (shared buffers) postoji segment za smeštanje statističkih podataka, tu su i ti brojači koji se neprekidno inkrementiraju kada se dogode određeni događaji ili se jave neki momenti u radu baze.
- Svi ovi brojači nisu dostupni korisniku i čak ni administratoru. To su niskonivojske stvari. Da bi im se obratili, PostgreSQL pruža interfejs u vidu SQL funkcija. Možemo napraviti selektovanje pomoću ovih funkcija i dobiti neku metriku (ili skup metrika).
- Međutim, korišćenje ovih funkcija nije uvek praktično, stoga su funkcije osnova za prikaze (VIEWs). To su virtualne tabele koje pružaju statistiku o nekoj konkretnoj podsistemu ili o nekom skupu događaja u bazi podataka.
- Ove ugrađene prikaze (VIEWs) su glavni korisnički interfejs za rad sa statistikom. One su dostupne po defaultu bez dodatne konfiguracije, možete ih odmah koristiti, gledati, uzimati informacije odatle. A tu su i dodaci. Dodaci su zvanični. Možete instalirati paket postgresql-contrib (na primer, postgresql94-contrib), učitati neophodni modul u konfiguraciji, postaviti parametre za njega, restartovati PostgreSQL i možete da ga koristite. (Napomena. Zavisno od distribucije, u poslednjim verzijama, paket dodataka je deo osnovnog paketa.).
- Postoje neoficijelni contrib. Oni nisu uključeni u standardnu distribuciju PostgreSQL-a. Moraju se ili kompajlirati ili instalirati kao biblioteka. Mogućnosti su različite, u zavisnosti od toga šta je razvio programer ovog neoficijelnog contrib-a.
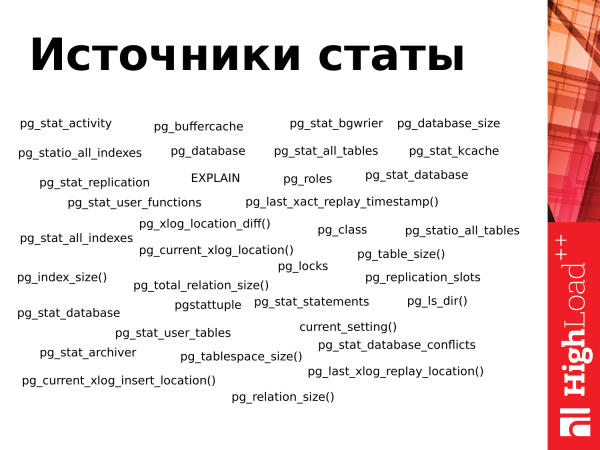
Na ovoj slici prikazani su svi prikazi (VIEWs) i deo funkcija koje su dostupne u PostgreSQL 9.4. Kao što vidimo, njih je mnogo. I prilično je lako zbuniti se ako se prvi put susrećete s njima.
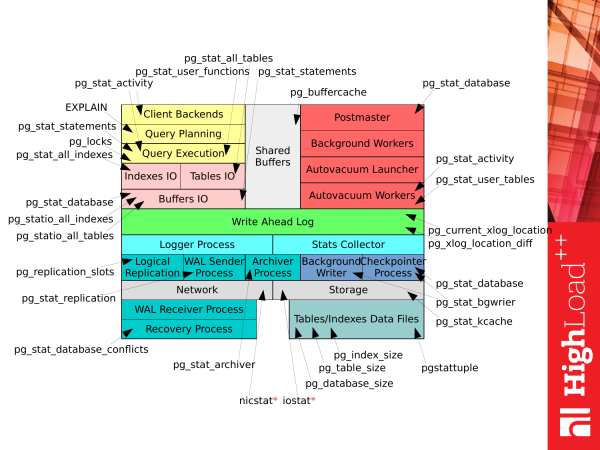
Međutim, ako uzmemo prethodnu sliku Kako se troši vreme na PostgreSQL i uskladimo to s ovom listom, dobijamo ovakvu sliku. Svaki prikaz (VIEWs) ili svaka funkcija može se koristiti u određenim ciljevima za dobijanje odgovarajuće statistike kada PostgreSQL radi. Tako možemo dobiti neku informaciju o radu podsistema.
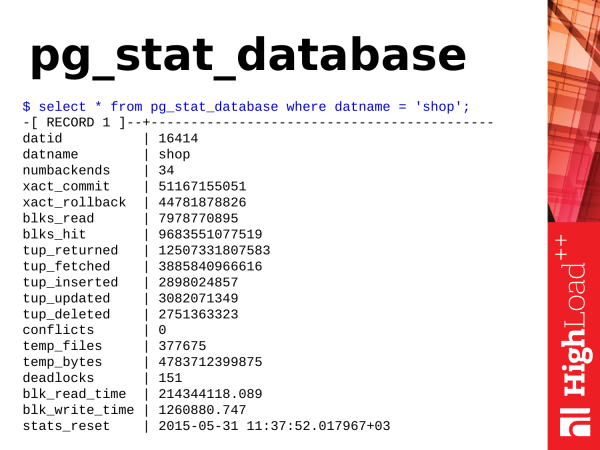
Prvo što ćemo razmotriti je pg_stat_database. Kao što vidimo, ovo je prikaz. Ima mnogo informacija. Raznolike informacije. I pruža vrlo korisno saznanje o tome šta se dešava u bazi podataka.
Šta možemo korisnog iz toga izvući? Počnimo sa najjednostavnijim stvarima.
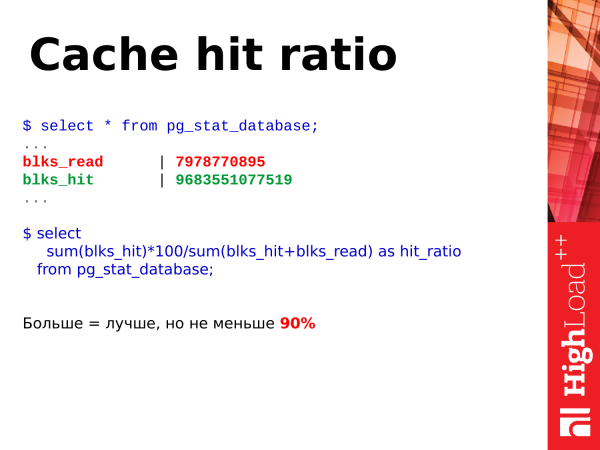
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
Prvo što možemo pogledati – to je procenat trafika u kešu. Procenat trafika u kešu – to je korisna metrika. Omogućava nam da procenimo koliki deo podataka dolazi iz shared buffers keša, a koliki deo se čita s diska.
Jasno je da što više imamo trafika u kešu, to bolje. Ovu metriku procenjujemo kao procenat. Na primer, ako je procenat ovog trafika u kešu veći od 90%, to je dobro. Ako pada ispod 90%, to znači da nemamo dovoljno memorije za zadržavanje ‘vrućeg’ dela podataka u memoriji. I da bi PostgreSQL koristio te podatke, mora da se obrati disku, a to je sporije nego da se podaci čitaju iz memorije. Već treba razmišljati o povećanju memorije: ili povećati shared buffers, ili nadograditi fizičku memoriju (RAM).
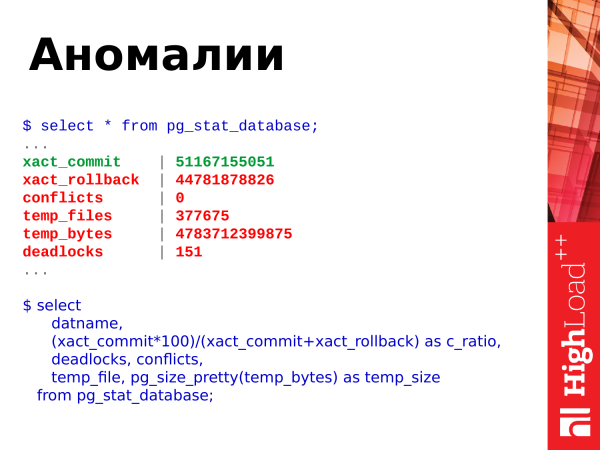
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
Šta još možemo izvući iz ovog prikaza? Možemo pogledati anomalije koje se dešavaju u bazi. Šta se ovde prikazuje? Tu su commits, rollbacks, kreiranje vremenskih datoteka, njihov volumen, deadlocks i konflikti.
Možemo iskoristiti ovaj upit. Ova SQL naredba je prilično jednostavna. I možemo pogledati ove podatke kod nas.
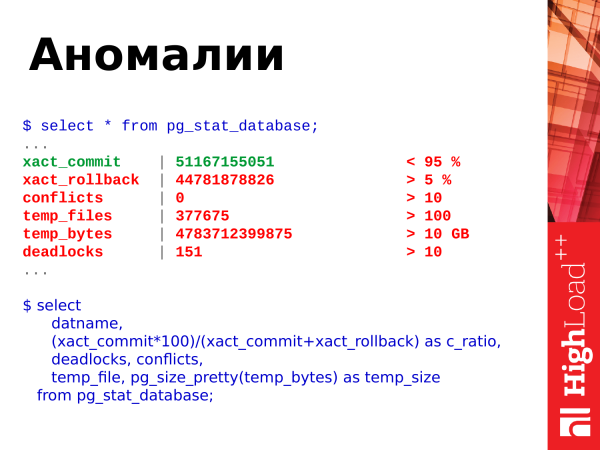
I ovdje su odmah pragovi. Gledamo omjer commit-a i rollback-a. Commits su uspješna potvrđenja transakcije. Rollbacks su povratak, tj. transakcija je izvršavala neku akciju, opterećivala bazu, nešto obračunavala, a zatim je došlo do greške i rezultati transakcije su odbačeni. Tj. broj rollback-a, koji se konstantno povećavaju, je loš. I treba ih nekako izbjegavati, te ispraviti kod kako bi se to spriječilo.
Konflikti (conflicts) su povezani s replikacijom. I njih također treba izbjegavati. Ako imate nekakve upite koji se izvršavaju na replici i javljaju se konflikti, potrebno je analizirati te konflikte, vidjeti što se događa. Detalje možete pronaći u logovima. I eliminirati konfliktne situacije kako bi upiti aplikacije radili bez grešaka.
Deadlocks su također loša situacija. Kada se upiti bore za resurse, jedan upit se obratio jednom resursu i dobio je blokadu, drugi upit se obratio drugom resursu i također dobio blokadu, a zatim su se oba upita obratila resursima jedan drugog i zaključala se čekajući da susjed otpusti blokadu. To je također problematična situacija. Treba ih rješavati na nivou prepisivanja aplikacija i serijalizacije pristupa resursima. I ako primijetite da se váš deadlocks konstantno povećavaju, treba analizirati detalje u logovima, razraditi nastale situacije i utvrditi u čemu je problem.
Privremeni datoteke (temp_files) su također loše. Kada korisničkom upitu nedostaje memorije za smještaj operativnih, privremenih podataka, on stvara datoteku na disku. I sve operacije koje bi mogao izvršiti u privremenom bufferu u memoriji, počinje izvršavati na disku. To je sporo. To povećava vrijeme izvršavanja upita. I klijent koji je poslao upit PostgreSQL-u će dobiti odgovor malo kasnije. Ako se sve te operacije izvrše u memoriji, Postgres će odgovoriti mnogo brže i klijent će manje čekati.
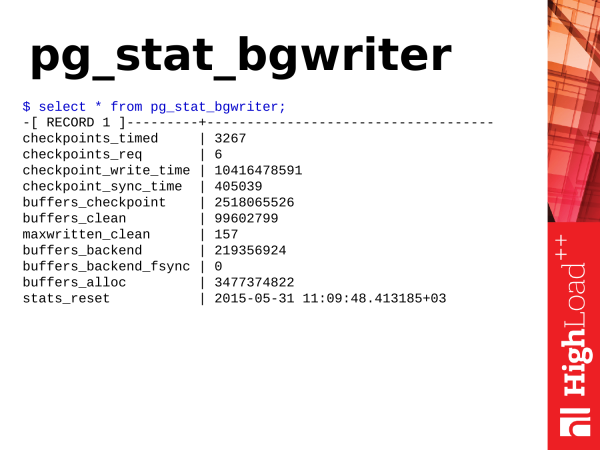
Pg_stat_bgwriter je prikaz koji opisuje rad dva pozadinska podsistema PostgreSQL-a: to su checkpointer i background writer.
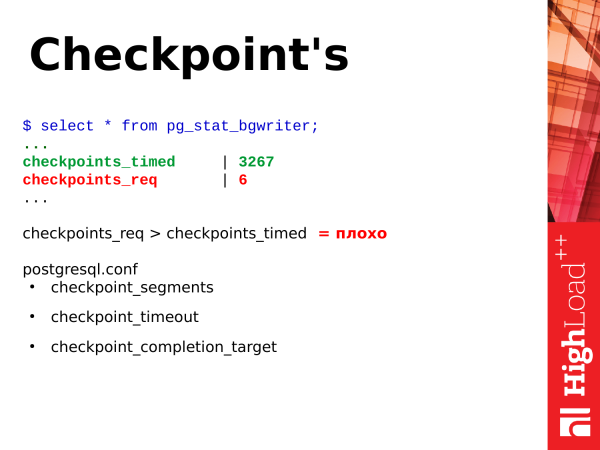
Za početak ćemo obraditi kontrolne tačke, tzv. checkpoints. Šta su kontrolne tačke? Kontrolna tačka je pozicija u dnevniku transakcija koja obaveštava da su sve promene podataka zabeležene u dnevniku uspešno sinhronizovane sa podacima na disku. Proces, u zavisnosti od opterećenja i podešavanja, može potrajati i većinom se sastoji od sinhronizacije prljavih stranica u shared buffers sa datotekama na disku. Zašto je to potrebno? Da je PostgreSQL stalno pristupao disku da bi preuzeo podatke ili zapisivao podatke pri svakom pristupu, to bi bilo sporo. Zato PostgreSQL ima segment memorije čija veličina zavisi od parametara u konfiguraciji. Postgres smešta u ovu memoriju operativne podatke za dalju obradu ili isporuku na zahteve. U slučaju zahteva za izmenom podataka dolazi do njihove promene. Tako dobijamo dve verzije podataka. Jedna je u memoriji, druga na disku. I povremeno treba sinhronizovati te podatke. Moramo ono što je izmenjeno u memoriji sinhronizovati na disk. Za to su potrebne kontrolne tačke.
Kontrolna tačka prolazi kroz shared buffers, označava prljave stranice kao potrebne za kontrolnu tačku. Zatim pokreće drugi prolaz kroz shared buffers. I stranice koje su označene za kontrolnu tačku, on ih već sinhronizuje. Tako se vrši sinhronizacija podataka sa diskom.
Postoje dva tipa kontrolnih tačaka. Jedna kontrolna tačka se izvršava na vremenskom intervalu. Ovo je korisna i dobra kontrolna tačka – checkpoint_timed. I postoje kontrolne tačke na zahtev – checkpoint required. Takva kontrolna tačka događa se kada imamo vrlo velika pisanja podataka. Zabeležili smo veoma mnogo dnevnika transakcija. I PostgreSQL smatra da je potrebno sve to što pre sinhronizovati, napraviti kontrolnu tačku i nastaviti dalje.
I ako ste pogledali statistiku pg_stat_bgwriter i videli da vam je checkpoint_req mnogo više od checkpoint_timed, to je loše. Zašto loše? To znači da se PostgreSQL nalazi u stalnoj stresnoj situaciji kada treba da zapisuje podatke na disk. Kontrolna tačka po vremenskom intervalu je manje stresna i izvršava se prema unutrašnjem rasporedu i kao da se proteže tokom vremena. PostgreSQL ima mogućnost da pravi pauze u radu i ne opterećuje diskovni sistem. Ovo je korisno za PostgreSQL. I zahtevi koji se izvršavaju tokom kontrolne tačke neće doživeti stres zbog toga što je diskovni sistem zauzet.
I za regulisanje checkpoint postoje tri parametra:
checkpoint_segments.checkpoint_timeout.checkpoint_completion_target.
Oni omogućavaju regulisanje rada kontrolnih tačaka. No, neću se na njima zadržavati. Njihov uticaj – to je već posebna tema.
Pažnja: Verzija o kojoj se raspravlja u izveštaju 9.4 više nije aktuelna. U savremenim verzijama PostgreSQL parametar checkpoint_segments zameniće parametri min_wal_size i max_wal_size.
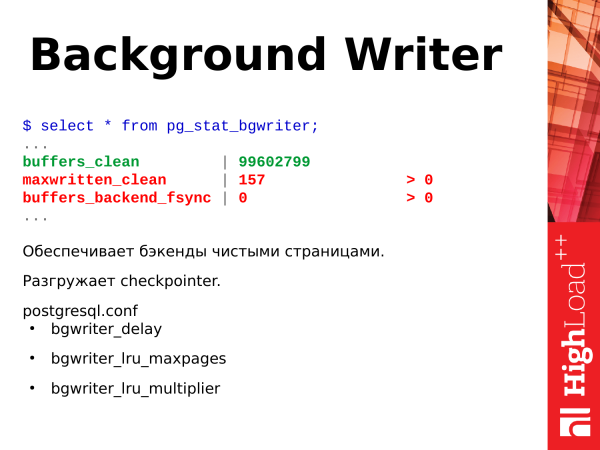
Sledeći podsistem je pozadinski pisac — background writer. Šta on radi? On neprekidno radi u beskonačnoj petlji. Skenira stranice u shared buffers i prljave stranice koje pronađeB, ispušta na disk. Tako pomaže checkpointer-u da obavi manje posla tokom izvršenja kontrolnih tačaka.
Za šta je još potreban? Obezbeđuje potrebu za čistim stranicama u shared buffers-u ako su one odjednom potrebne (u velikim količinama) za smeštaj podataka. Pretpostavimo da je nastala situacija kada su za izvršenje upita potrebne čiste stranice i one već postoje u shared buffers-u. Postgresov backend ih jednostavno uzima i koristi, ne mora ništa sam da čisti. No, ako takve stranice nisu dostupne, backend obustavlja rad i počinje potragu za stranicama koje će ispuštati na disk i koristiti za svoje potrebe — što negativno utiče na vreme izvršavanja trenutnog upita. Ako vidite da je vaš parametar maxwritten_clean veliki, to znači da background writer ne uspeva da obavi svoj posao i potrebno je povećati parametre bgwriter_lru_maxpages, kako bi mogao da uradi više posla u jednom ciklusu, da isprazni više stranica.
I još jedan veoma koristan pokazatelj – to je buffers_backend_fsync. Backendi ne izvode fsync, jer je to sporo. Oni prosljeđuju fsync višem u IO steku checkpointer-u. Checkpointer ima svoj red, periodično obrađuje fsync i usklađuje stranice u memoriji sa datotekama na disku. Ako je red checkpointer-a velik i popunjen, backend je primoran da sam izvrši fsync i to usporava rad backenda,tj. klijent će dobiti odgovor kasnije nego što bi mogao. Ako vidite da je ova vrednost veća od nule, to je već problem i treba obratiti pažnju na podešavanja background writer-a i takođe oceniti performanse disčnog podsistema.
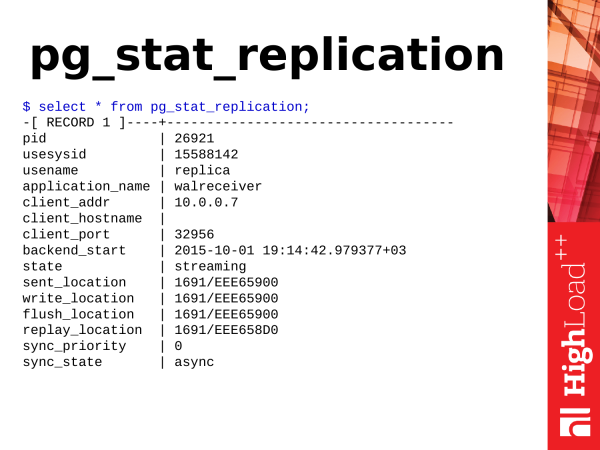
Pažnja: _Sljedeći tekst opisuje statističke prikaze povezane s replikacijom. Većina imena prikaza i funkcija preimenovana je u Postgres 10. Suština preimenovanja svodi se na zamjenu xlog na wal i lokacija na lsn u imenima funkcija/prikaza itd. Poseban primjer, funkcija pg_xlog_location_diff() preimenovana je u pg_wal_lsn_diff()._
Ovdje imamo mnogo informacija. Međutim, trebaju nam samo stavke povezane s lokacijom.
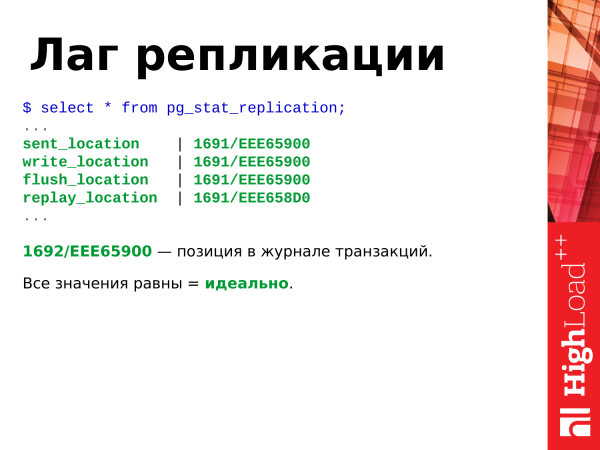
Ako vidimo da su sve vrijednosti jednake, tada je to idealan slučaj i replikacija ne zaostaje za masterom.
Ova heksadecimalna pozicija – to je pozicija u dnevniku transakcija. Ona se stalno povećava ako postoji neka aktivnost u bazi: umetanja, brisanja itd.
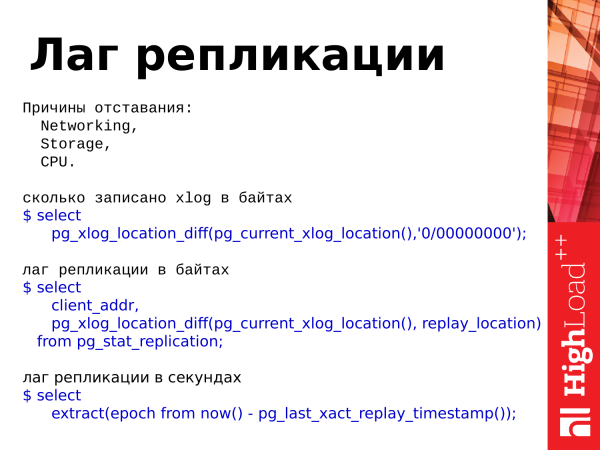
koliko je zapisano xlog u bajtovima
$ select
pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000');
zaostatak replikacije u bajtovima
$ select
client_addr,
pg_xlog_location_diff(pg_current_xlog_location(), replay_location)
from pg_stat_replication;
zaostatak replikacije u sekundama
$ select
extract(epoch from now() - pg_last_xact_replay_timestamp());
Ako se ove stvari razlikuju, to znači da postoji neki zaostatak. Zaostatak – to je zaostajanje replike za masterom, tj. podaci se razlikuju između servera.
Postoje tri razloga za zaostajanje:
- To je diskovni sistem koji ne može da izdrži zapisivanje sinkronizacije datoteka.
- To su moguće mrežne greške, ili preopterećenje mreže, kada podaci ne stignu do replike na vrijeme i ona ih ne može reprodukovati.
- I procesor. Procesor – to je vrlo rijedak slučaj. Vidio sam to dva ili tri puta, ali se i to može dogoditi.
I evo tri upita koja nam omogućavaju korištenje statistike. Možemo procijeniti koliko je zapisano u dnevniku transakcija. Postoji funkcija pg_xlog_location_diff i možemo procijeniti zaostatak replikacije u bajtovima i sekundama. Takođe, za ovo koristimo vrijednost iz ovog prikaza (VIEWs).
Napomena: _Umjesto pg_xlog_locationdiff() funkciju možemo koristiti operator oduzimanja da oduzmemo jednu lokaciju od druge. To je praktično.
Sa zaostatkom, koji je u sekundama, postoji jedan trenutak. Ako na masteru ne dođe do nikakve aktivnosti, transakcija se dogodila prije oko 15 minuta i nema nikakve aktivnosti, a ako pogledamo taj zaostatak na replici, vidjet ćemo zaostatak od 15 minuta. O tome treba imati na umu. I to može zbuniti kada pogledate taj zaostatak.
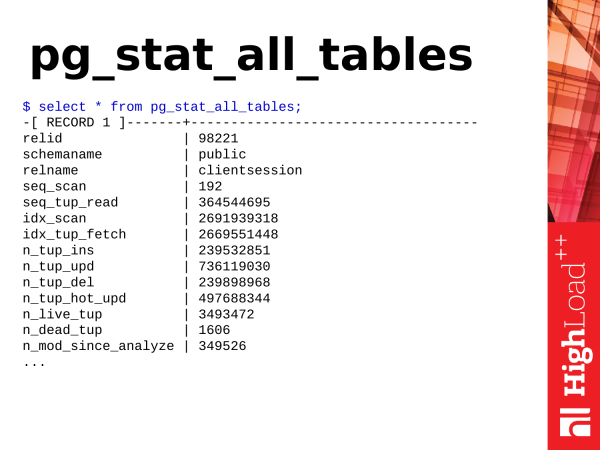
Pg_stat_all_tables – još jedan koristan prikaz. Prikazuje statistiku o tabelama. Kada imamo aktivnosti ili određene radnje na tabelama u bazi, te informacije možemo prikupiti iz ovog prikaza.
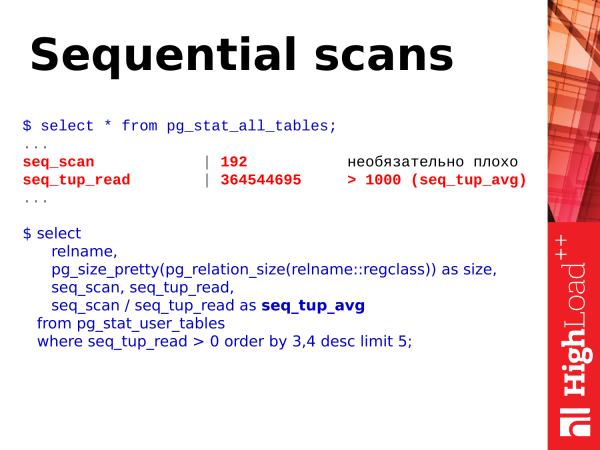
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3,4 desc limit 5;
Prvo što možemo pogledati su sekvencijalna skeniranja po tabeli. Sama brojka nakon ovih prolaza još ne znači da je to loše i nije pokazatelj da trebamo odmah nešto preduzeti.
Međutim, postoji druga metrika – seq_tup_read. To je broj redova vraćenih kao rezultat sekvencijalnog skeniranja. Ako prosečna vrednost premašuje 1.000, 10.000, 50.000, 100.000, to je već pokazatelj da možda treba izgraditi indeks negde, kako bi pristup bio po indeksu, ili možda optimizovati upite koji koriste takva sekvencijalna skeniranja, da se to ne dogodi.
Jednostavan primer – recimo da upit ima veliki OFFSET i LIMIT. Na primer, skanira 100.000 redova u tabeli, a nakon toga uzima 50.000 potrebnih redova, dok se prethodni skenirani redovi odbacuju. To je takođe loš slučaj. Takve upite treba optimizovati. I ovde je jednostavan SQL upit na kojem možemo to videti i proceniti dobijene cifre.
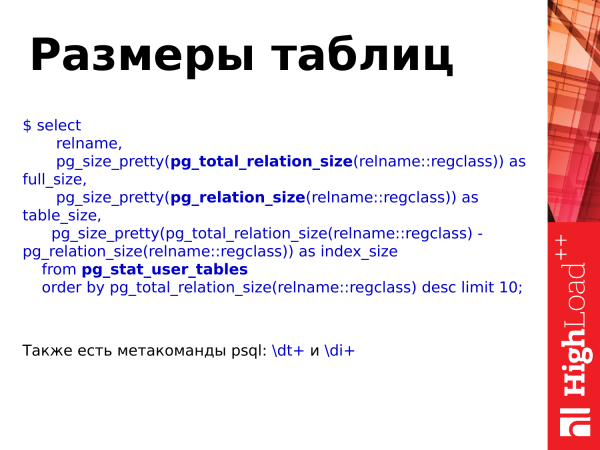
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
Veličine tabela takođe se mogu dobiti pomoću ove tabele i dodatnih funkcija pg_total_relation_size(), pg_relation_size().
Uopšte, postoje metakomande dt i di, koje se mogu koristiti u PSQL-u i takođe pogledati veličine tabela i indeksa.
Međutim, korišćenje funkcija nam pomaže da proverimo veličine tabela uzimajući u obzir indekse, ili bez uzimanja u obzir indeksa i da već pravimo neke procene na osnovu rasta baze podataka, tj. kako ona raste, kojom brzinom i da pravimo neke zaključke o optimizaciji veličina.
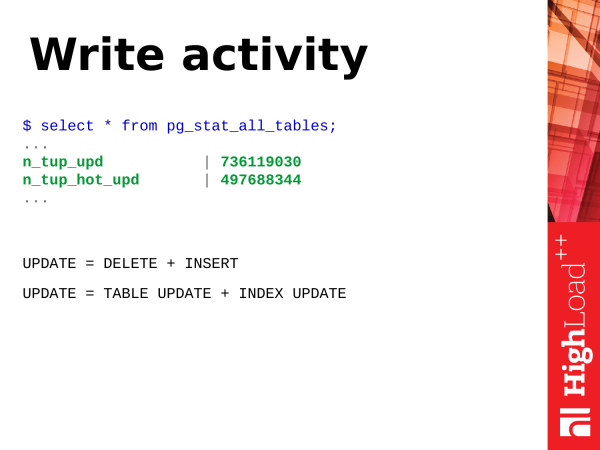
Aktivnost na upis. Šta je upis? Hajde da razmotrimo operaciju UPDATE – operacija ažuriranja redova u tabeli. U suštini, update je dve operacije (ili čak više). To je umetanje nove verzije reda i označavanje stare verzije reda kao zastarele. Kasnije dolazi autovakum koji će očistiti te zastarele verzije redova i označiti to mesto kao dostupno za ponovnu upotrebu.
Pored toga, update nije samo ažuriranje tabele. To je i ažuriranje indeksa. Ako na tabeli imate mnogo indeksa, prilikom update-a svi indeksi koji uključuju polja ažurirana u upitu takođe će morati biti ažurirani. U tim indeksima takođe će biti zastarele verzije redova koje treba očistiti.
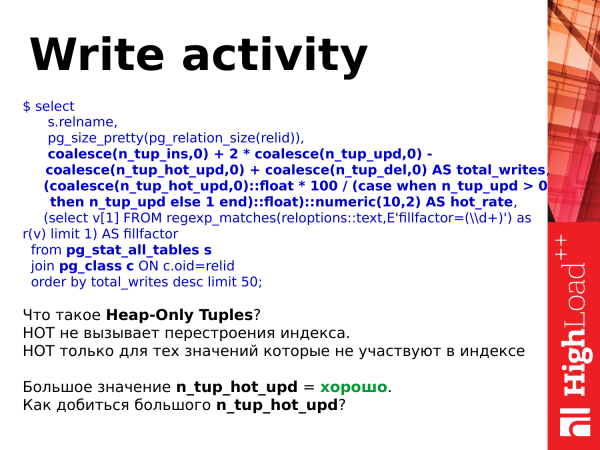
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
I zbog svog dizajna, UPDATE su teške operacije. Ali se mogu olakšati. Postoje hot updates. Pojavili su se u PostgreSQL verziji 8.3. I šta to znači? To je lagani update koji ne uzrokuje rekonstrukciju indeksa. Tj. ažurirali smo zapis, ali se samo zapis u stranici (koja pripada tabeli) ažurirao, dok indeksi i dalje upućuju na isti zapis u stranici. Tu postoji zanimljiva logika rada, kada dođe vakum, on rekonstruiše te lance hot i sve nastavlja raditi bez ažuriranja indeksa, a sve se dešava uz manju potrošnju resursa.
I kada imate n_tup_hot_upd veliko, to je veoma dobro. To znači da lagani updates preovlađuju i da je to manje skupo u pogledu resursa i sve je odlično.
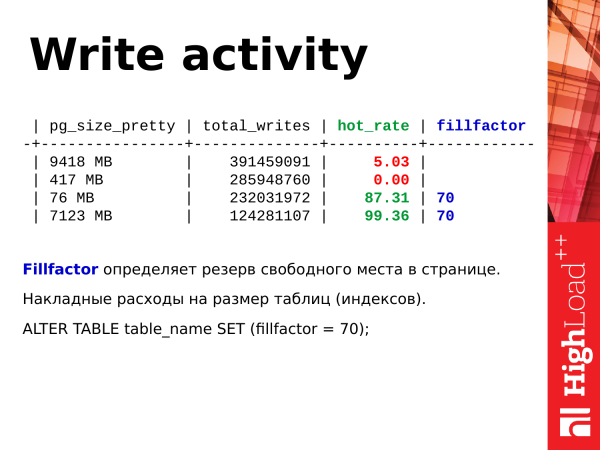
ALTER TABLE table_name SET (fillfactor = 70);Kako povećati obim hot updatea? Možemo koristiti fillfactor. On definiše veličinu rezervisanog slobodnog prostora prilikom popunjavanja stranice u tabeli pomoću INSERT-ova. Kada u tabelu dolaze inserts, oni potpuno popunjavaju stranicu, ne ostavljajući praznog mesta. Zatim se dodeljuje nova stranica. Ponovo se podaci popunjavaju. Ovo ponašanje je podrazumevano, fillfactor = 100%.
Možemo postaviti fillfactor na 70 %. To znači da se prilikom umetanja stvorila nova stranica, ali je popunjeno samo 70 % stranice. I 30 % nam je ostavljeno kao rezervi. Kada bude potrebno da izvršimo ažuriranje, postoje velike šanse da će se ono desiti na istoj stranici, i nova verzija reda će se smestiti na tu istu stranicu. I biće izvršeno hot_update. Na taj način se olakšava zapisivanje unutar tabela.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
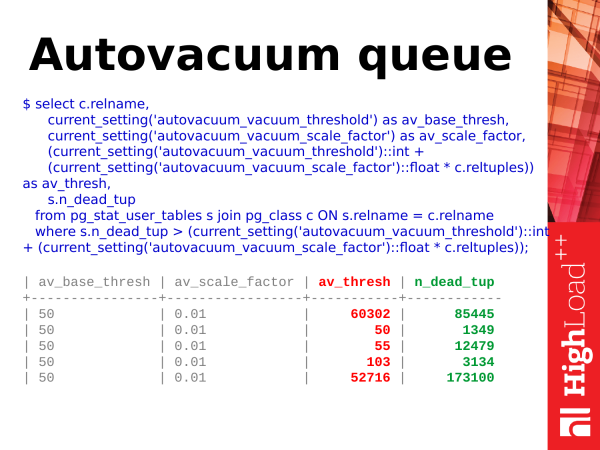
Red avotovakuma. Avotovakum je podsistem za koji statistika u PostgreSQL gotovo da ne postoji. U tabelama možemo samo u pg_stat_activity videti koliko nam trenutno traje avotovakum. Ipak, vrlo je teško shvatiti koliko je tabela u redu za njega.
Napomena: _Počevši od verzije Postgres 10, situacija sa praćenjem avotovakuma se značajno poboljšala — pojavilo se prikazivanje pg_stat_progressvacuum, što značajno pojednostavljuje pitanje monitoringa avotovakuma.
Možemo koristiti ovakav pojednostavljeni upit. I možemo pogledati kada bi trebalo izvršiti avotovakum. Ali, kako i kada bi trebao biti pokrenut avotovakum? To su one zastarele verzije redova o kojima sam ranije govorio. Došlo je do ažuriranja, nova verzija reda je umetnuta. Pojavila se zastarela verzija reda. U tabeli pg_stat_user_tables ima takav parametar n_dead_tup. On prikazuje broj "mrtvih" redova. I čim broj mrtvih redova postane veći od određenog praga, do tabele će doći avotovakum.
A kako se taj prag računa? To je prilično konkretan procentualni odnos od ukupnog broja redova u tabeli. Tu je parametar autovacuum_vacuum_scale_factor. On određuje procentualni odnos. Recimo, 10 % + dodatni osnovni prag od 50 redova. I šta dobijamo? Kada imamo mrtvih redova više nego što je "10 % + 50" od svih redova u tabeli, onda postavljamo tabelu na avotovakum.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
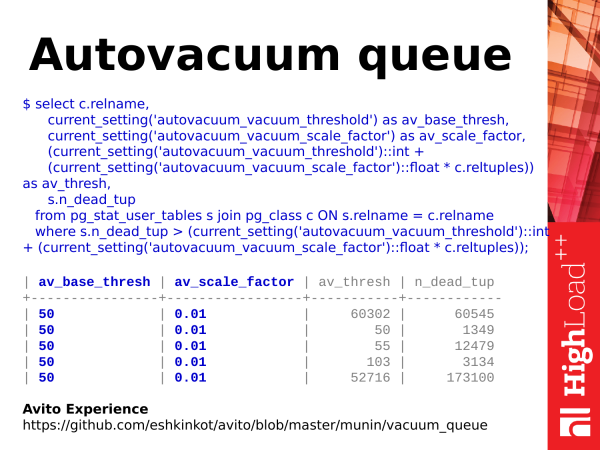
Međutim, ovde postoji jedan trenutak. Osnovni pragovi kod parametara av_base_thresh i av_scale_factor mogu se dodijeliti pojedinačno. Shodno tome, prag neće biti globalan, već individualan za tabelu. Da bismo izračunali, potrebno je koristiti razne trikove i varke. Ako vas zanima, možete pogledati iskustvo naših kolega iz Avito (link na slajdu je nevažeći i ažuriran je u tekstu).
Oni su napisali za , koji uzima u obzir ove stvari. Postoji dokument od dva lista. No, izračunava ispravno i prilično efikasno omogućava procjenu gdje nam je potrebno puno vakuuma za tabele, a gdje malo.
Šta možemo s tim učiniti? Ako imamo veliki red i autovakuum se ne snalazi, možemo povećati broj radnika vakuuma, ili jednostavno učiniti vakuum agresivnijim, kako bi se aktivirao ranije, obrađivao tabelu u manjim komadima. Tako će se red smanjivati. — Glavno je pratiti opterećenje na diskovima, jer je vakuum akcija koja košta, iako je sa pojavom SSD/NVMe uređaja problem postao manje uočljiv.
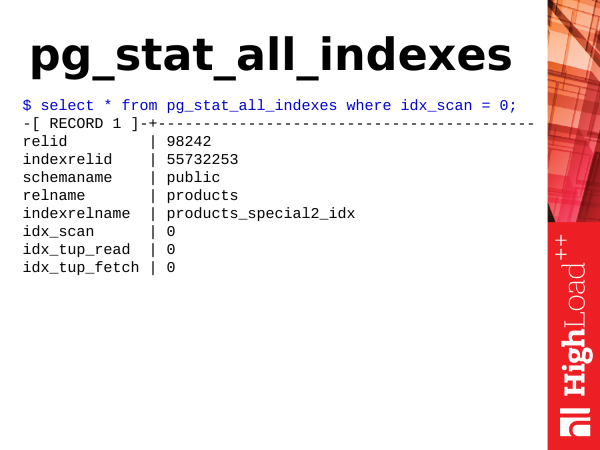
Pg_stat_all_indexes – to je statistika po indeksima. Ona je mala. I možemo je koristiti za dobijanje informacija o korišćenju indeksa. Na primjer, možemo odrediti koji su indeksi suvišni.
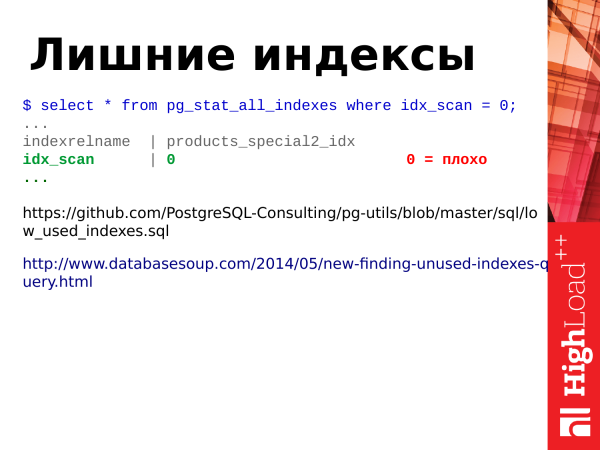
Kao što sam već rekao, update – to nije samo ažuriranje tabela, već i ažuriranje indeksa. Shodno tome, ako imamo mnogo indeksa na tabeli, prilikom ažuriranja redova u tabeli, indeksi polja koja su indeksirana takođe moraju biti ažurirani, i ako imamo neiskorišćene indekse, za koje nema indeksnih skeniranja, onda oni predstavljaju balast. I njih se treba osloboditi. Za to nam treba polje idx_scan. Jednostavno gledamo broj indeksnih skeniranja. Ako indeksi nemaju skeniranja tokom relativno dugog perioda čuvanja statistike (ne manje od 2-3 nedelje), verovatno su loši indeksi, potrebno ih je eliminisati.
Napomena: Prilikom pretraživanja neiskorišćenih indeksa u slučaju klastera tokom replikacije potrebno je proveriti sve čvorove klastera, jer statistika nije globalna, i ako indeks nije korišćen na masteru, može se koristiti na replikama (ako ima opterećenja).
Dva linka:
Ovo su napredniji primeri upita za to kako tražiti neiskorišćene indekse.
Druga poveznica predstavlja prilično zanimljiv zahtjev. U njoj je ugrađena vrlo netrivijalna logika. Preporučujem je za upoznavanje.
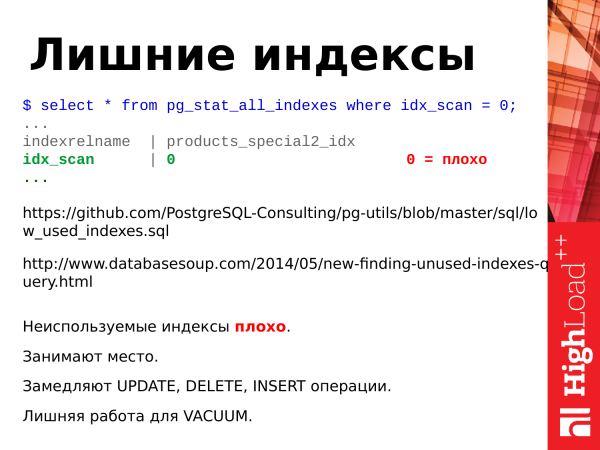
Šta još treba sumirati o indeksima?
Neiskorišteni indeksi su loši.
Zauzimaju prostor.
Usporavaju operacije ažuriranja.
Dodatni posao za vakuum.
Ako uklonimo neiskorištene indekse, poboljšat ćemo bazu.
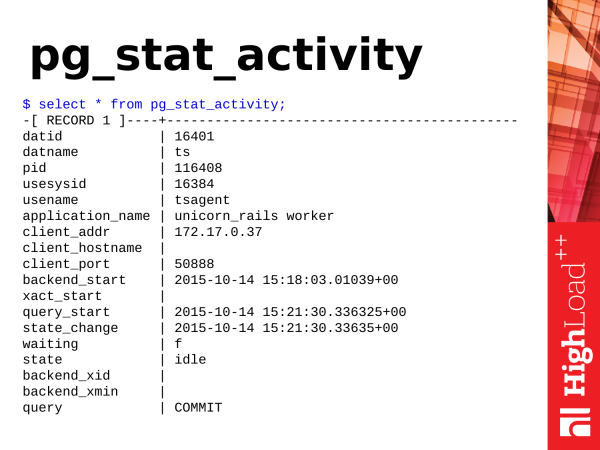
Sljedeće prikazivanje je pg_stat_activity. Ovo je ekvivalent alatu ps, samo u PostgreSQL. Ako psgledate procese u operativnom sistemu, to će pg_stat_activity prikazati aktivnost unutar PostgreSQL-a.
Šta korisnog možemo dobiti odatle?
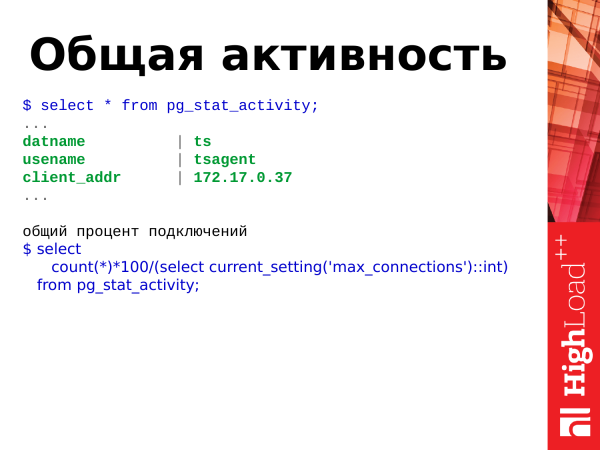
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
Možemo pogledati ukupnu aktivnost i vidjeti šta se dešava u bazi. Možemo uraditi novi deploy. Sve nam je tamo eksplodiralo, novi konekcije se ne primaju, greške padaju u aplikaciji.
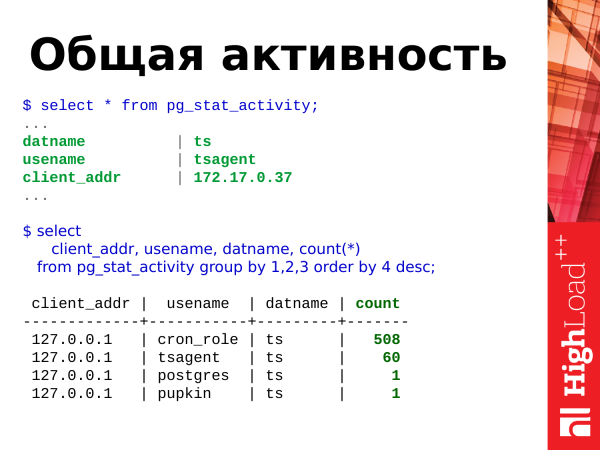
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
Možemo izvršiti ovakav zahtjev i vidjeti ukupni procenat konekcija u odnosu na maksimalni limit konekcija i proveriti ko najviše koristi konekcije. U datom slučaju vidimo da je korisnik cron_role otvorio 508 konekcija. I nešto se desilo s njim. Treba istražiti i pogledati. Veoma je moguće da je to neka anomalija u broju konekcija.
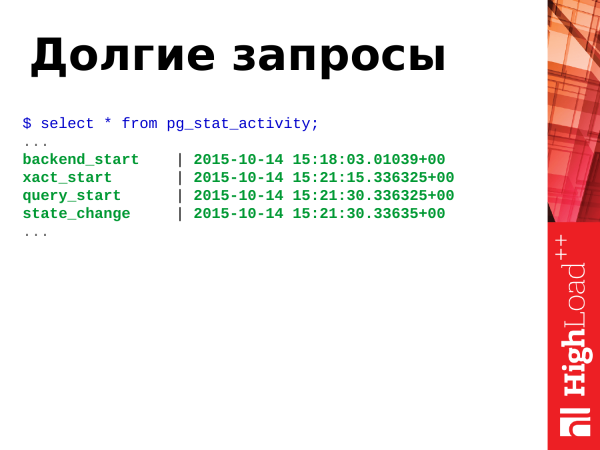
Ako imamo OLTP opterećenje, zahtjevi treba da se izvršavaju brzo, vrlo brzo i ne smije biti dugih zahtjeva. Ipak, ako se pojave dugi zahtjevi, na kratkorčnom planu ništa strašno, ali na dugoročnom planu dugi zahtjevi štete bazi, povećavaju bloat efekat tabela, što uzrokuje fragmentaciju tabela. Treba se osloboditi i bloat-a i dugih zahtjeva.
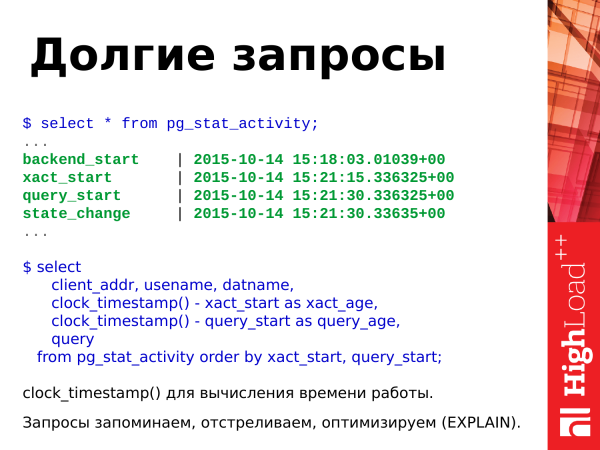
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Obratite pažnju: ovim zahtjevom možemo odrediti duge zahtjeve i transakcije. Koristimo funkciju clock_timestamp() za određivanje vremena rada. Duge zahtjeve koje pronađemo možemo zapamtiti, izvršiti explain, pregledati planove i optimizovati ih. Trenutne duge zahtjeve eliminišemo i nastavljamo dalje.
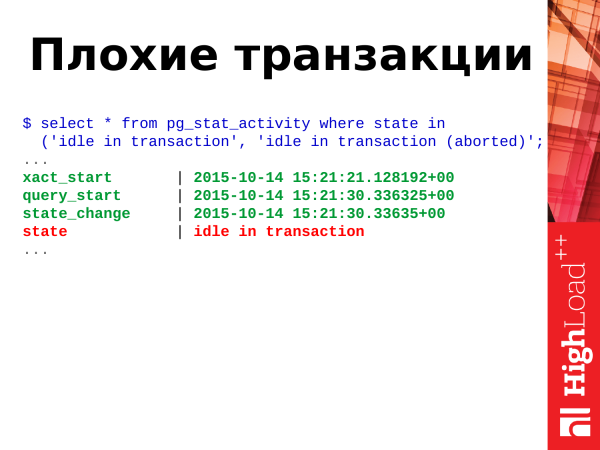
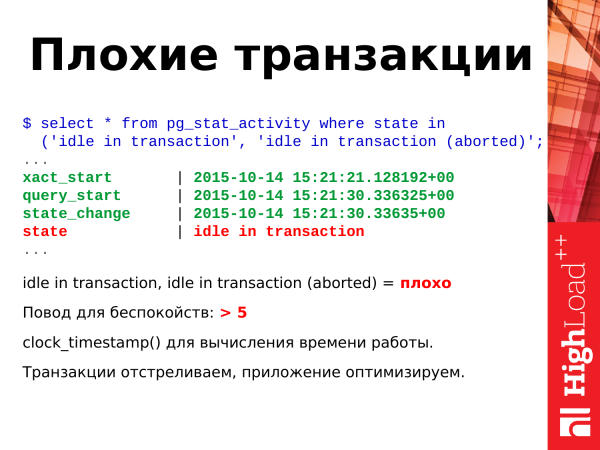
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Loše transakcije su ono što se nalazi u stanju idle in transaction i idle in transaction (aborted).
Šta to znači? Transakcije imaju nekoliko stanja. I jedno od tih stanja može imati u bilo kojem trenutku. Za određivanje stanja postoji polje state u ovoj predstavi. I koristimo ga za određivanje stanja.
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
I, kao što sam već rekao, ova dva stanja idle in transaction i idle in transaction (aborted) – to je loše. Šta to znači? To je kada aplikacija otvori transakciju, izvrši neke radnje i ode svojim poslom. Transakcija ostaje otvorena. Ona visi, u njoj se ništa ne događa, zauzima konekciju, blokira izmijenjene redove i potencijalno povećava bloat drugih tabela, zbog arhitekture transakcijskog motora Postgresa. I takve transakcije također treba isključiti, jer su na štetu u svakom slučaju.
Ako primijetite da ih imate u bazi više od 5-10-20, onda treba da se zabrinete i da počnete nešto poduzimati.
Ovde također za vreme računanja koristimo clock_timestamp(). Transakcije isključujemo, aplikaciju optimizujemo.
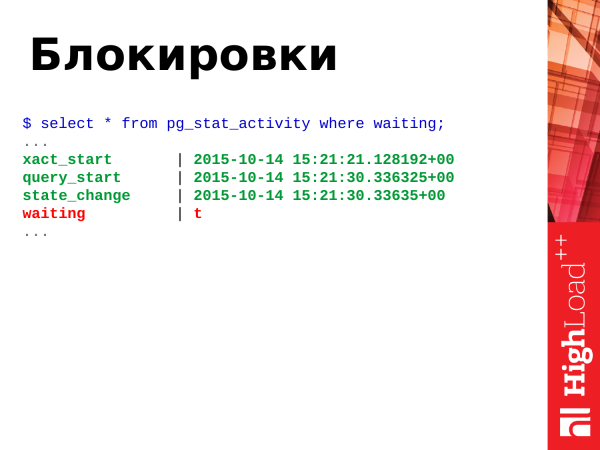
Kao što sam već rekao, blokade – to su kada dvije ili više transakcija bore za jedan ili grupu resursa. Za to imamo polje waiting sa boolean vrednošću true ili false.
True – to znači da je proces u čekanju, treba nešto učiniti. Kada je proces u čekanju, to znači da i klijent koji je inicirao ovaj proces takođe čeka. Klijent u pretraživaču sedi i takođe čeka.
Pažnja: _Počevši od verzije Postgres 9.6 polje waiting je uklonjeno, a umesto njega su dodana dva informativnija polja wait_event_type i wait_event._
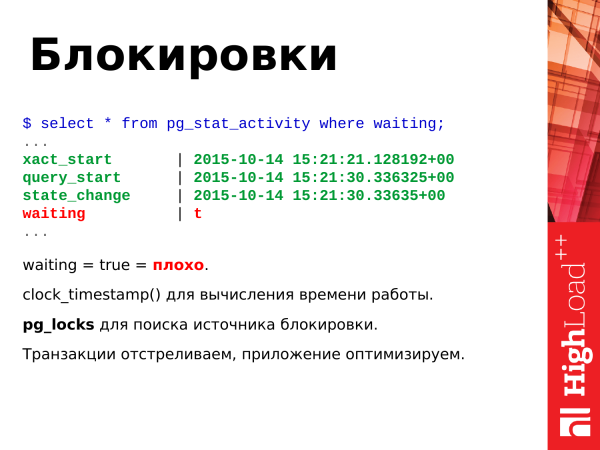
Šta uraditi? Ako vidite true, tokom dužeg vremena to znači da se takvih zahteva treba osloboditi. Mi jednostavno isključujemo takve transakcije. Programerima pišemo da treba nekako optimizovati, kako ne bi bilo trke za resursima. I potom programeri optimizuju aplikaciju kako to ne bi nastajalo.
I kraj, ali potencijalno ne fatalan slučaj – to je pojava deadlocks. Dve transakcije su ažurirale dva resursa, a zatim im se ponovo obraćaju, već suprotnih resursa. PostgreSQL u ovom slučaju uzima i sam isključuje transakciju, da bi druga mogla nastaviti rad. To je patna situacija i sama se ne razrešava. Zato PostgreSQL mora preduzeti drastične mere.
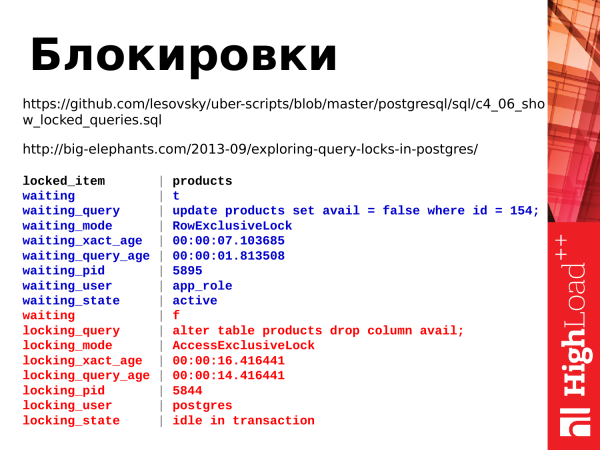
I evo dva zahteva koja omogućavaju praćenje blokada. Koristimo predstavu pg_locks, koja omogućava praćenje teških blokada.
I prva veza je tekst zahteva. On je prilično dug.
A druga veza je članak o blokadama. Korisno je pročitati ga, vrlo je zanimljiv.
Dakle, šta vidimo? Vidimo dva zahteva. Transakcija sa ALTER TABLE – to je blokirajuća transakcija. Pokrenuta je, ali nije završena, a aplikacija koja je pokrenula ovu transakciju se negde bavi drugim stvarima. A drugi zahtev – update. Čeka da se završi alter table, kako bi mogla da nastavi sa svojom funkcijom.
Ovako možemo da utvrdimo ko koga blokira, ko drži i možemo da se bavimo tim dalje.
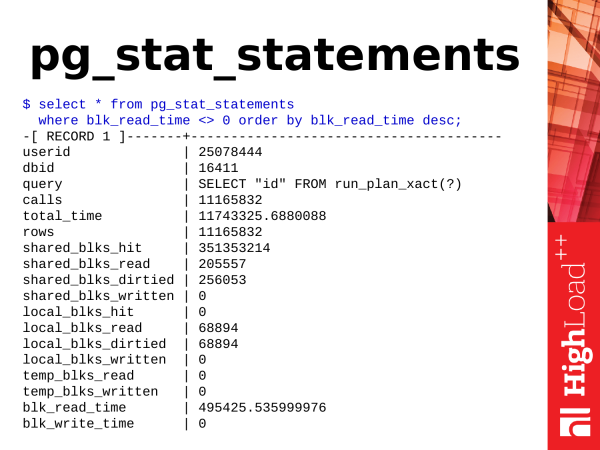
Sledeći modul – to je pg_stat_statements. Kao što sam već rekao, to je modul. Da bismo ga koristili, potrebno je da učitamo njegovu biblioteku u konfiguraciji, restartujemo PostgreSQL, instaliramo modul (jednom komandom) i zatim ćemo dobiti novi prikaz.
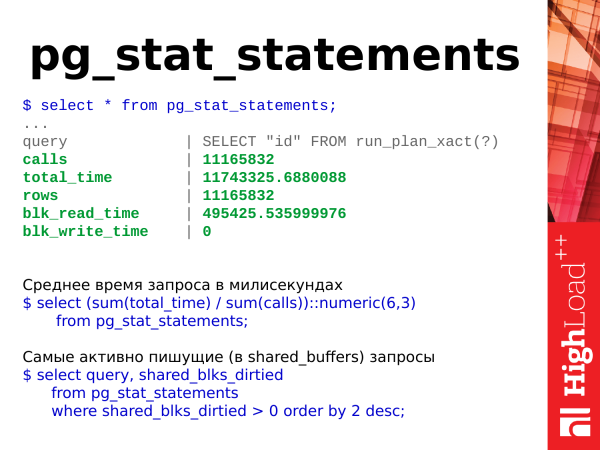
Prosečno vreme zahteva u milisekundama
$ select (sum(total_time) / sum(calls))::numeric(6,3)
from pg_stat_statements;

Najaktivniji upiti koji zapisuju (u shared_buffers)
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
Šta možemo odatle uzeti? Ako govorimo o jednostavnim stvarima, možemo uzeti prosečno vreme izvršavanja zahteva. Vreme raste, znači, naš PostgreSQL odgovara sporo i nešto treba preduzeti.
Možemo pogledati najaktivnije pisane transakcije u bazi podataka, koje menjaju podatke u shared buffers. Da vidimo ko ovde ažurira ili briše podatke.
I možemo jednostavno pogledati razne statistike o ovim zahtevima.
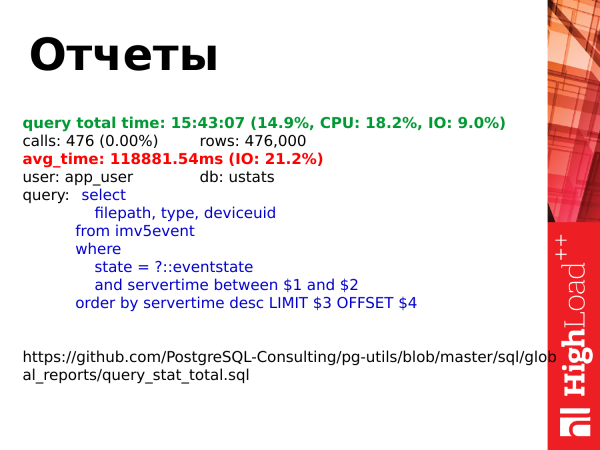
Mi pg_stat_statements za kreiranje izveštaja. Jednom dnevno brišemo statistiku. Akumuliramo je. Pre nego što ponovo obrišemo statistiku, pravimo izveštaj. Evo linka na izveštaj. Možete ga pogledati.
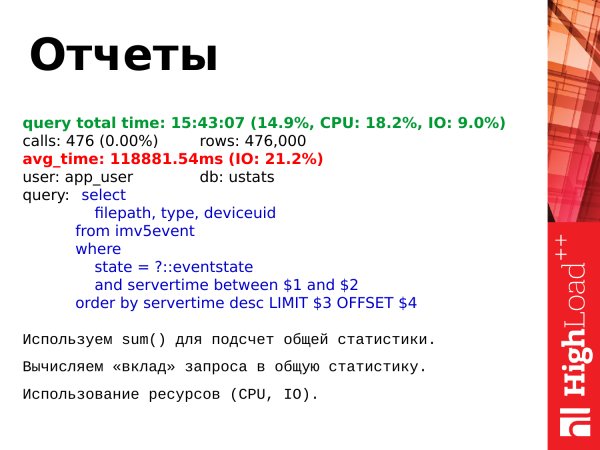
Šta radimo? Brojimo ukupnu statistiku svih zahteva. Zatim za svaki zahtev izračunavamo njegov pojedinačni doprinos toj ukupnoj statistici.
I šta možemo pogledati? Možemo pogledati ukupno vreme izvršavanja svih zahteva konkretnog tipa u odnosu na sve ostale zahteve. Možemo pogledati korišćenje resursa procesora i ulazno-izlazne operacije u odnosu na ukupnu sliku. I već optimizovati te zahteve. Kreiramo top zahteva po ovom izveštaju i dobijamo materijal za razmišljanje o tome šta optimizovati.
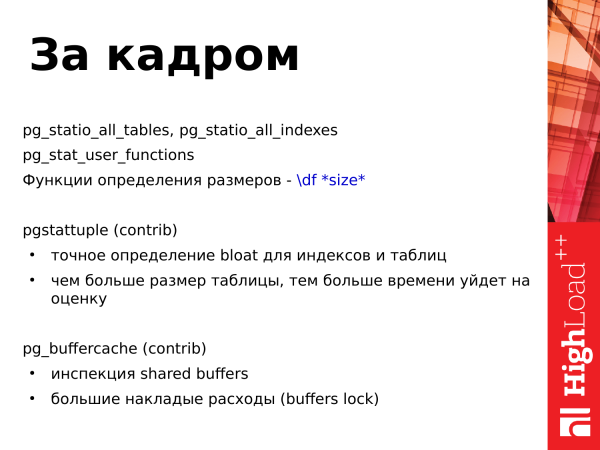
Šta smo ostavili iza scene? Ostalo je još nekoliko predstava koje nisam razmatrao, jer je vreme ograničeno.
Postoji pgstattuple – to je takođe dodatni modul iz standardnog paketa contribs. Omogućava procenu bloat tabele, tzv. fragmentaciju tabele. Ako je fragmentacija velika, treba je ukloniti, koristiti razne alate. A funkcija pgstattuple traje dugo. I što je više tabela, to će duže trajati.
Sledeći contrib – to je pg_buffercache. Omogućava inspekciju shared buffers: koliko intenzivno i pod koje tabele se koriste stranične stranice. Takođe omogućava da zavirimo u shared buffers i procenimo šta se dešava tamo.
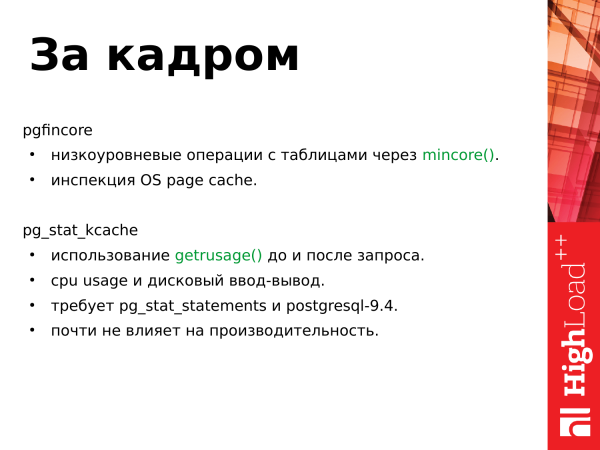
Sledeći modul – to je pgfincore. Omogućava nizak nivo operacija sa tabelama putem sistemskog poziva mincore(), tj. omogućava da se tabela učita u shared bufer ili da se iz njega izvuče. Takođe, omogućava inspekciju stranog keša operativnog sistema, tj. koliko prostora tabela zauzima u page cache-u, u shared buffers i jednostavno omogućava procenu opterećenja tabele.
Sledeći modul – pg_stat_kcache. Takođe koristi sistemski poziv getrusage(). Izvršava ga pre i posle izvršavanja upita. A u dobijenoj statistici omogućava procenu koliko je naš upit potrošio na diskovni ulaz-izlaz, tj. operacije sa datotečnim sistemom i gleda korišćenje procesora. Međutim, modul je mlad (hm-hm) i za rad mu je potreban PostgreSQL 9.4 i pg_stat_statements, o kojima sam ranije govorio.
Sposobnost korišćenja statistike je korisna. Ne trebaju vam spoljni programi. Možete sami zaviriti, pogledati, nešto uraditi, izvršiti.
Korišćenje statistike nije teško, to je običan SQL. Prikupili ste upit, sastavili, poslali, pogledali.
Statistika pomaže da se odgovori na pitanja. Ako imate pitanja, obraćate se statistici – gledate, donosite zaključke, analizirate rezultate.
I eksperimentisite. Ima mnogo upita, ima mnogo podataka. Uvek možete optimizovati neki već postojeći upit. Možete napraviti svoju verziju upita koja vam više odgovara od originala i koristiti ga.
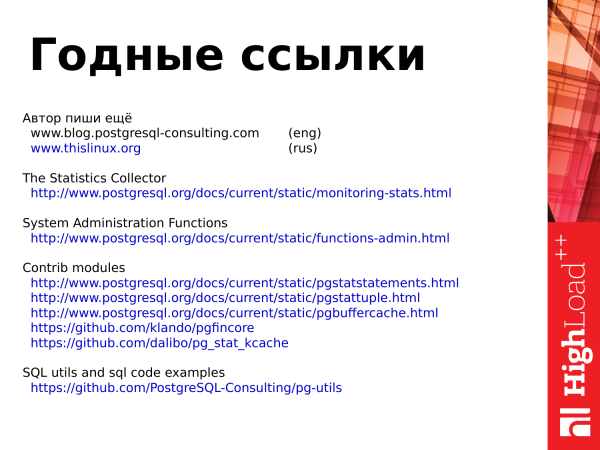
Linkovi
Koristi linkove koji su se pojavili u članku, na osnovu kojih su podaci bili u izlaganju.
Autor piše još
(eng)
Kolektor statistike
Funkcije sistemske administracije
Contrib moduli
SQL alati i primeri SQL koda
Hvala svima na pažnji!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish