

Zdravo svima! Moje ime je Pavel Agaletski. Radim kao tim lider u ekipi koja razvija sistem isporuke za Lamodu. Godine 2018. govorio sam na konferenciji HighLoad++, a danas želim predstaviti transkript svog predavanja.
Moja tema se fokusira na iskustva naše kompanije u vezi sa deployom sistema i servisa u različitim okruženjima. Počevši od naših praistorijskih vremena, kada smo sve sisteme deployovali na obične virtuelne servere, do postepenog prelaska sa Nomad-a na deploy u Kubernetes. Pričaću o tome zašto smo to uradili i koje smo probleme imali tokom procesa.

Deploy aplikacija na VM
Da počnemo, pre 3 godine svi sistemi i servisi naše kompanije deployovali su se na obične virtuelne servere. Tehnički, organizovano je tako da je sav kod naših sistema bio pohranjen i sastavljen putem automatizovanog sastavljanja, uz pomoć Jenkins-a. Pomoću Ansible-a, kod je iz našeg sistema kontrole verzija razrađivan na virtuelne servere. Pri tome je svaki sistem koji je bio u našoj kompaniji deployovan na najmanje 2 servera: jedan je bio head, a drugi tail. Ova dva sistema su bila apsolutno identična po svim svojim podešavanjima, snagama, konfiguracijama i ostalom. Razlika između njih bila je jedino u tome što je head primao korisnički saobraćaj, dok tail nikada nije primao korisnički saobraćaj.
Zašto je to urađeno?
Kada smo deployovali nove verzije naše aplikacije, želeli smo obezbediti mogućnost bešavne raspodele, bez primetnih posledica za korisnike. To je postignuto tako što je sledeća sastavljena verzija putem Ansible-a implementirana na tail. Tamo su ljudi koji su se bavili deployem mogli proveriti i uveriti se da je sve u redu: svi metrički podaci, odeljci i aplikacije rade; pokreću se potrebni skripti. Tek nakon što su se uverili da je sve u redu, saobraćaj je preusmeren. Počeo je ići na onaj server koji je do tada bio tail. A onaj koji je pre toga bio head ostao je bez korisničkog saobraćaja, ali sa prethodnom verzijom naše aplikacije.
Na taj način, korisnicima je to bilo besprijekorno. Jer je prebacivanje trenutna stvar, kao što je jednostavno prebacivanje balansera. Lako se može vratiti na prethodnu verziju jednostavnim prebacivanjem balansera nazad. Također smo mogli provjeriti sposobnost aplikacije na produkciji prije nego što korisnički promet krene, što je bilo vrlo praktično.
Koje smo prednosti vidjeli u svemu ovome?
- Prije svega, to je dovoljno jednostavno funkcionira. Svima je jasno kako funkcioniše ovakav način implementacije, jer su većina ljudi ikada implementirali na običnim virtualnim serverima.
- To je dovoljno pouzdano, jer je tehnologija implementacije jednostavna, isprobana od strane hiljada kompanija. Milioni servera se upravo tako implementiraju. Teško je nešto pokvariti.
- I konačno, mogli smo dobiti atomarne implementacije. Implementacije koje se za korisnike događaju u trenutku, bez vidljive faze prelaska između stare i nove verzije.
Ali smo u svemu ovome također vidjeli nekoliko nedostataka:
- Pored produkcijskog okruženja, postoji i razvojno okruženje, kao i druga okruženja. Na primjer, QA i preprodukcija. U to vrijeme imali smo mnogo servera i oko 60 servisa. Zbog toga je bilo potrebno održavati aktuelnu verziju virtuelne mašine za svaki servis. Osim toga, ako želite ažurirati biblioteke ili postaviti nove zavisnosti, to morate učiniti u svim okruženjima. Također je bilo potrebno uskladiti vrijeme kada namjeravate implementirati novu verziju vaše aplikacije s vremenom kada će devops izvršiti potrebne postavke okruženja. U tom slučaju lako možete doći u situaciju u kojoj će naše okruženje malo varirati između svih okruženja. Na primjer, u QA okruženju će biti jedne verzije biblioteka, a u produkciji druge, što će dovesti do problema.
- Kompleksnost u ažuriranju zavisnosti vaše aplikacije. To ne zavisi od vas, već od drugog tima. Naime, od tima devops, koji održava servere. Morate im postaviti odgovarajući zadatak i dati opis onoga što želite učiniti.
- U to vreme smo takođe želeli da podelimo velike monolite koje smo imali na male usluge, jer smo shvatili da će ih biti sve više i više. Već tada smo imali više od 100 njih. Bilo je potrebno za svaku novu uslugu kreirati novu virtuelnu mašinu, koju je takođe bilo potrebno održavati i implementirati. Pored toga, potrebna su barem dva servera. Sve to dodatno zahteva i QA okruženje. To izaziva probleme i otežava vam kreiranje i pokretanje novih sistema. Ovo čini proces složenijim, skupljim i dužim.
Zato smo odlučili da će biti lakše preći sa implementacije običnih virtuelnih mašina na implementaciju naših aplikacija u Docker kontejneru. Uz Docker vam je potreban sistem koji može da pokrene aplikaciju u klasteru, jer ne možete jednostavno podići kontejner. Obično želite da pratite koliko je kontejnera podignuto, kako bi se automatski pokretali. Iz tog razloga, morali smo da izaberemo upravljački sistem.
Dugo smo razmišljali o tome koju od njih da uzmemo. Problem je bio što je tada naš stek za implementaciju na običnim virtuelnim serverima bio donekle zastareo, jer su tamo bile starije verzije operativnih sistema. U nekom trenutku je čak bio i FreeBSD, koji je bilo nezgodno održavati. Shvatili smo da moramo što pre migrirati na Docker. Naš DevOps tim je pregledao svoje postojeće iskustvo sa raznim rešenjima i izabrao sistem kao što je Nomad.
Prelazak na Nomad
Nomad je proizvod kompanije “HashiCorp”. Poznati su i po drugim rešenjima:
«Consul» — to je sredstvo za otkrivanje servisa.
«Terraform» — sistem za upravljanje serverima koji vam omogućava da ih konfigurišete kroz infrastrukturu kao kod.
«Vagrant» omogućava vam da pokrećete virtuelne mašine lokalno ili u oblaku putem određenih datoteka konfiguriacije.
Nomad nam se tada učinio kao dovoljno jednostavno rešenje na koje možemo brzo preći bez promene cele infrastrukture. Takođe, vrlo je lako savladati. Zato smo ga izabrali kao sistem za filtriranje našeg kontejnera.
Šta je potrebno da biste uopšte implementirali vaš sistem u Nomad?
- Pre svega, potreban vam je docker image aplikacije. Potrebno je da se sakupi i smesti u skladište slika docker. U našem slučaju, to je artifactory — sistem koji omogućava da se razni artefakti različitih tipova postave u njega. Može čuvati arhive, docker slike, PHP composer pakete, NPM pakete i tako dalje.
- Takođe je potrebno konfiguracijski fajl, koji će reći Nomadu šta, gde i u kojoj količini želite da deploy-ujete.
Kada govorimo o Nomadu, kao format informativnog fajla, koristi HCL jezik, što se dešava kao HashiCorp Configuration Language. To je nadmnožak nad Yaml-om, koji vam omogućava da opišete svoj servis u terminima Nomada.
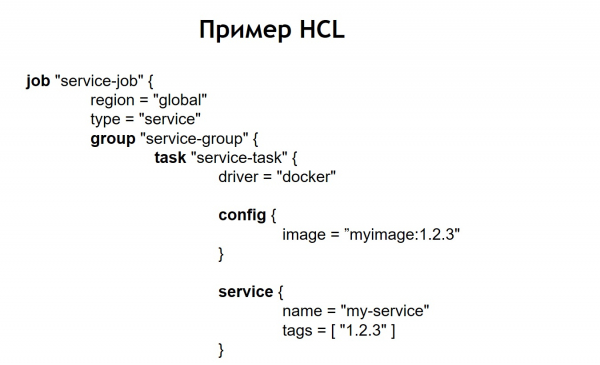
Omogućava da kažete koliko kontejnera želite da deploy-ujete, iz kojih slika da im prosledite razne parametre prilikom deploy-a. Tako, vi hranite ovaj fajl Nomadu, a on pokreće kontejnere prema njemu u produkciji.
U našem slučaju, shvatili smo da bi pisanje potpuno identičnih HCL fajlova za svaki servis bilo nepraktično, jer servisa ima mnogo i ponekad ih želimo ažurirati. Dešava se da jedan servis nije deploy-ovan u jednom instanci, već u raznim. Na primer, jedan od sistema koji imamo u produkciji ima više od 100 instanci u produkciji. Pokreću se iz istih slika, ali se razlikuju po konfiguracionim postavkama i konfiguracionim fajlovima.
Zbog toga smo odlučili da nam je zgodno da sve naše konfiguracione fajlove za deploy čuvamo u jednom zajedničkom repozitorijumu. Tako postaju pregledni: lako ih je održavati i može se videti koje sisteme imamo. U slučaju potrebe, jednostavno je nešto ažurirati ili promeniti. Dodavanje novog sistema takođe neće biti teško — dovoljno je samo da napravite konfiguracijski fajl unutar nove direktorije. Unutar nje se nalaze fajlovi: service.hcl, koji sadrži opis našeg servisa, i neki env-fajlovi koji omogućavaju da taj servis, nakon deploy-a u produkciju, bude podešen.
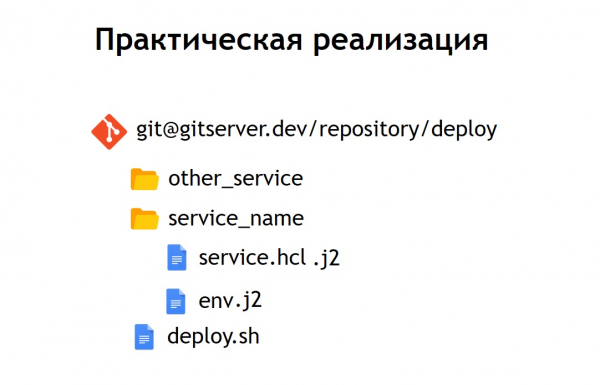
Međutim, neki naši sistemi nisu deploy-ovani u produkciji u jednoj instanci, već odjednom u nekoliko. Zbog toga smo odlučili da nam bude zgodno da čuvamo ne čiste konfiguracije, već njihov templaterizovani oblik. Kao jezik za templaterizaciju izabrali smo jinja 2. U ovom formatu skladištimo kako konfiguracije samog servisa, tako i env datoteke potrebne za njega.
Pored toga, stavili smo u repozitorij zajednički skript za deployment koji omogućava pokretanje i implementaciju vašeg servisa u produkciji, u potrebnom okruženju i cilju. U slučaju da smo naš HCL konfiguracijski fajl pretvorili u šablon, taj HCL fajl, koji je pre bio običan konfiguracija Nomad-a, sada izgleda potpuno drugačije.
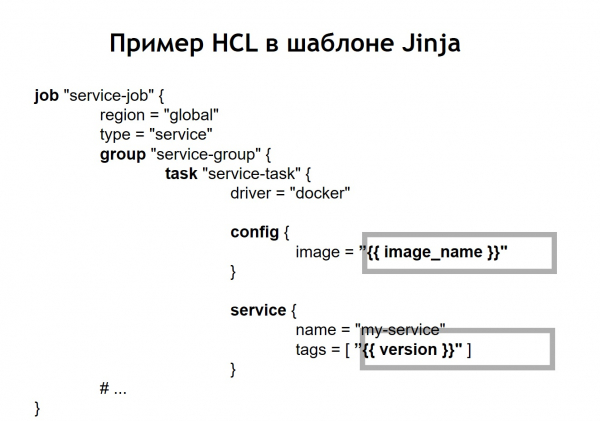
To jest, zamenili smo neka varijantna mesta konfiguracije uložcima varijabli koje se uzimaju iz env datoteka ili iz drugih izvora. Pored toga, dobili smo mogućnost dinamičkog sastavljanja HCL fajlova, što znači da možemo primeniti ne samo obične varijabilne uloške. Pošto jinja podržava petlje i uslove, takođe možemo kreirati konfiguracijske fajlove koji se menjaju u zavisnosti od toga gde tačno implementirate svoje aplikacije.
Na primer, želite da implementirate vaš servis u pre-produkciju i u produkciju. Recimo, da u pre-produkciji ne želite da pokrećete cron skripte, nego jednostavno želite da vidite servis na posebnoj domeni kako biste se uverili da funkcioniše. Za svakoga ko implementira servis, ovaj proces izgleda veoma jednostavno i prozirno. Dovoljno je izvršiti fajl deploy.sh, navesti koji servis želite da implementirate i u koji cilj. Na primer, želite da implementirate neki sistem u Rusiju, Belorusiju ili Kazahstan. Za to je dovoljno samo promeniti jedan od parametara i dobićete ispravan konfiguracijski fajl.
Kada je servis Nomad već implementiran u vaš klaster, izgleda ovako.
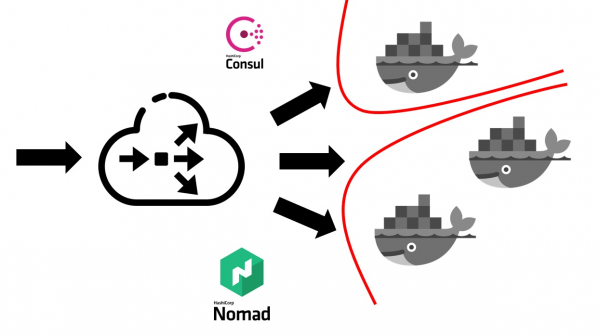
Prvo vam je potreban neki vanjski balansirnik koji će primati sav korisnički saobraćaj. On će raditi zajedno sa Consul-om i saznati od njega gde, na kojoj nodu, po kojem IP-adresu se nalazi konkretan servis koji odgovara određenom imenu domena. Servisi u Consul-u dolaze direktno iz Nomad-a. Pošto su to proizvodi iste kompanije, oni su dobro međusobno povezani. Može se reći da Nomad od samog početka može registrovati sve servise koje pokreće unutar Consul-a.
Nakon što vaš spoljašnji balansirnik saobraćaja sazna na koju uslugu treba da usmeri saobraćaj, preusmerava ga u odgovarajući kontejner ili u više kontejnera koji odgovaraju vašoj aplikaciji. Naravno, pritom se mora razmišljati i o bezbednosti. Iako se sve usluge pokreću na istim virtuelnim mašinama u kontejnerima, obično je potrebno zabraniti slobodan pristup iz bilo koje usluge ka bilo kojoj drugoj. To smo postigli segmentacijom. Svaka usluga pokretana je u svojoj virtuelnoj mreži, na kojoj su postavljena pravila usmeravanja i pravila o odobrenju/zabrani pristupa drugim sistemima i uslugama. Mogle su se nalaziti kako unutar tog klastera, tako i van njega. Na primer, ako želite da zabranite usluzi da se poveže sa određenom bazom podataka, to možete učiniti putem segmentacije na nivou mreže. To znači da čak ni greškom ne možete slučajno povezati iz testnog okruženja sa vašom produkcijskom bazom.
Koliko nas je koštao proces prelaska u smislu ljudskih resursa?
Prelazak cele kompanije na Nomad trajao je otprilike 5-6 meseci. Prelazili smo uslugu po uslugu, ali u dovoljno brzom tempu. Svaki tim morao je da kreira svoje vlastite kontejnere za usluge.
Imamo pristup u kojem svaka ekipa sama odgovara za docker slike svojih sistema. DevOps timovi pružaju zajedničku infrastrukturu potrebnu za implementaciju, to jest podršku samom klasteru, podršku CI sistemu itd. I u tom trenutku više od 60 sistema je prešlo na Nomad, što čini oko 2.000 kontejnera.
DevOps tim je odgovoran za ukupnu infrastrukturu svega što je povezano sa implementacijom, sa serverima. Svaka razvojna ekipa, s druge strane, odgovara za implementaciju kontejnera za svoj konkretan sistem, jer upravo ekipa zna šta joj je potrebno u tom ili onom kontejneru.
Razlozi za odustajanje od Nomada
Koje smo prednosti ostvarili prelaskom na implementaciju pomoću Nomada, uključujući i docker?
- Mi obezbedili jednake uslove za sve okruženja. U razvoju, QA okruženju, preprodukciji i produkciji koriste se isti kontejnerski imidži, sa istim zavisnostima. Tako da praktično imate minimalne šanse da u produkciju završi nešto što ste prethodno testirali lokalno ili na testnom okruženju.
- Također smo otkrili da je dovoljno lako dodati novu uslugu. Sve nove sisteme u smislu implementacije možete pokrenuti vrlo jednostavno. Samo idite u repozitorij koji sadrži konfiguracije, dodajte tu još jednu konfiguraciju za vaš sistem, i sve je spremno. Možete implementirati vaš sistem u produkciju bez dodatnog truda od DevOps-a.
- Sve konfiguracijske datoteke u jednom zajedničkom repozitoriju su se pokazali preglednima. U trenutku kada smo implementirali naše sisteme pomoću virtualnih servera, koristili smo Ansible, u kojem su se konfiguracije nalazile u istom repozitoriju. Međutim, za većinu programera to je bilo malo složenije. Tu je obim konfiguracija i koda koji trebate dodati da bi ste implementirali uslugu postao mnogo manji. Pored toga, za DevOps je vrlo lako prilagoditi ili promeniti to. U slučaju prelaza, na primer, na novu verziju Nomad-a, mogu uzeti i masovno ažurirati sve operativne datoteke koje se nalaze na istom mestu.
Ali smo takođe naišli na nekoliko nedostataka:
Ispostavilo se da nismo mogli postići neprekidnost implementacija u slučaju Nomad-a. Prilikom puštanja kontejnera iz različitih uslova moglo se desiti da je bio aktivan, a Nomad ga je prepoznavao kao spremnog za prihvat saobraćaja. To se dešavalo pre nego što je aplikacija unutar njega uspela da se pokrene. Iz tog razloga, sistem je na kratak vremenski period počeo da izbacuje 500 greške, jer je saobraćaj počinjao da ide na kontejner koji još nije bio spreman da ga prihvati.
Naišli smo na neke greške. Najveći problem je što Nomad ne reaguje najbolje na velike klastere kada imate mnogo sistema i kontejnera. Kada želite da stavite jedan od servera koji je uključen u Nomad klaster u održavanje, postoji prilično velika verovatnoća da će klaster funkcionisati loše i raspasti se. Deo kontejnera može, na primer, pasti i ne podići se — to će vas kasnije veoma koštati ako su svi vaši sistemi u produkciji upravo u klasteru koji upravlja Nomad.
Zato smo odlučili da razmislimo o tome kuda želimo ići dalje. U to vreme smo postali mnogo svesniji onoga što želimo da postignemo. Naime: tražimo pouzdanost, malo više funkcija nego što nudi Nomad, i zreliji, stabilniji sistem.
U tom smislu, naš izbor je pao na Kubernetes kao najpopularniju platformu za pokretanje klastera. Posebno s obzirom na to da je veličina i broj naših kontejnera bio dovoljno veliki. Za te svrhe, Kubernetes je delovao kao najprikladniji sistem od onoga što smo mogli razmotriti.
Migracija na Kubernetes
Malo ću reći o tome koja su osnovna pojma u Kubernetesu i kako se razlikuju od Nomad.
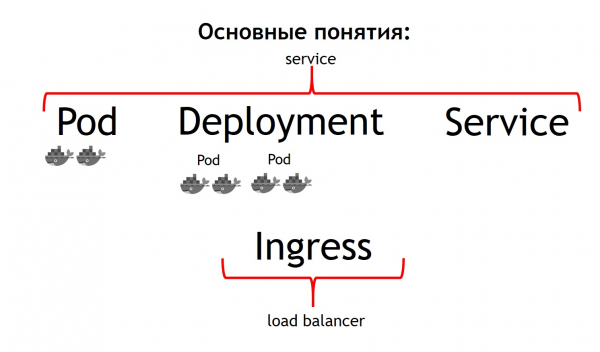
Prvo i osnovno pojmove u Kubernetesu je pojam pod. Pod — to je grupa jednog ili više kontejnera koja se uvek pokreće zajedno. Oni rade kao da su uvek striktno na jednoj virtuelnoj mašini. Dostupni su jedni drugima putem IP adrese 127.0.0.1 na različitim portovima.
Pretpostavimo da imate PHP aplikaciju koja se sastoji od nginx i php-fpm – klasična šema. Verovatno ćete želeti da i nginx i php-fpm kontejneri uvek budu zajedno. Kubernetes to omogućava tako što ih opisuje kao jedan zajednički pod. To je ono što nismo mogli postići pomoću Nomada.
Drugi pojam je deployment. U stvari, pod je sam po sebi efemerna stvar, ona se pokreće i nestaje. Da li želite prvo da ubijete sve vaše prethodne kontejnere, a zatim odmah pokrenete nove verzije ili želite da ih postepeno uvodite – upravo za taj proces je odgovoran pojam deployment. On opisuje kako postavljate vaše podele, u kojem broju i kako ih ažurirati.
Treći pojam je service. Vaš service je zapravo vaš sistem koji prima određeni promet, a zatim ga usmjerava na jedan ili više podova koji odgovaraju vašem servisu. To znači da omogućava da se sav dolazni promet za određeni servis s određenim imenom šalje na konkretno te podove. Pri tom vam osigurava balansiranje prometa. Dakle, možete pokrenuti dva poda vaše aplikacije, a sav dolazni promet bit će ravnomjerno raspoređen između povezanih podova ovog servisa.
I četvrta osnovna pojam — Ingress. To je servis koji se pokreće u Kubernetes klasteru. On djeluje kao vanjski balansirnik opterećenja koji preuzima sve zahtjeve. Zahvaljujući API-ju Kubernetes Ingress može odrediti kamo te zahtjeve treba poslati. A to radi vrlo fleksibilno. Možete reći da sve zahtjeve za ovu domenu i određeni URL šaljemo na ovaj servis. A ove zahtjeve, koji dolaze na ovu domenu i na drugi URL šaljemo na drugi servis.
Najbolje iz perspektive onoga tko razvija aplikaciju — je to što možete tim svime upravljati samostalno. Postavljajući konfiguraciju Ingress, možete sav promet koji dolazi na određeni API slati na odvojene kontejnere, napisane, na primjer, na Go. A ovaj promet, koji dolazi na istu domenu, ali na drugi URL, slati na kontejnere napisane u PHP, gdje ima puno logike, ali nisu baš brzi.
Ako usporedite sve te pojmove s Nomadom, može se reći da su prva tri pojma zajedno Service. A posljednji pojam u samom Nomadu ne postoji. Umjesto toga koristili smo vanjski balansirnik: to može biti haproxy, nginx, nginx+ i tako dalje. U slučaju kuberneta ne trebate posebno uvoditi ovaj dodatni pojam. Međutim, ako pogledate Ingress iznutra, to je ili nginx, ili haproxy, ili traefik, ali kao ugrađeni u Kubernetes.
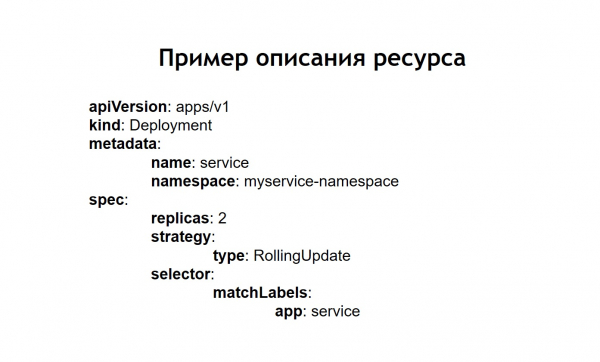
Sva opisana pojmova su, u suštini, resursi koji postoje unutar Kubernetes klastera. Za njihovo opisivanje u kubernetesu koristi se yaml-format, koji je čitljiviji i poznatiji nego HCL-fajlovi u slučaju Nomada. Ali strukturno opisuju u slučaju, na primjer, poda isto. Kažu — želim implementirati takve podove ovamo, s takvim imadžima, u takvom broju.
Osim toga, shvatili smo da ne želimo ručno kreirati svaki pojedinačni resurs: deployment, servise, Ingress i slično. Umjesto toga, željeli smo prilikom implementacije opisivati svaki naš sistem koristeći terminologiju Kubernetes-a, kako ne bismo morali ručno ponovno kreirati sve potrebne zavisnosti resursa u pravom redoslijedu. Kao takav sistem, koji nam je omogućio ovo, izabran je Helm.
Osnovni pojmovi u Helmu
Helm je menadžer paketa za Kubernetes. Veoma je sličan onome kako rade menadžeri paketa u programskim jezicima. Omogućava vam da pohranite servis koji se sastoji, na primjer, od deployment-a nginx, deployment-a php-fpm, konfiguracije za Ingress, configmaps (to je entitet koji vam omogućava da postavite env i druge parametre za vaš sistem) u obliku takozvanih chartova. Pri tome Helm radi iznad Kubernetesa. Dakle, to nije neka sistem vani, već jednostavno još jedan servis koji se pokreće unutar klastera. Sa njim komunicirate preko njegovog API-ja putem komandne linije. Njegova pogodnost i draž sastoji se u tome što, čak i ako Helm ne uspe ili ga obrišete iz klastera, vaši servisi neće nestati, jer Helm zapravo služi samo za pokretanje sistema. Za funkcionalnost i stanje servisa dalje odgovara sam Kubernetes.
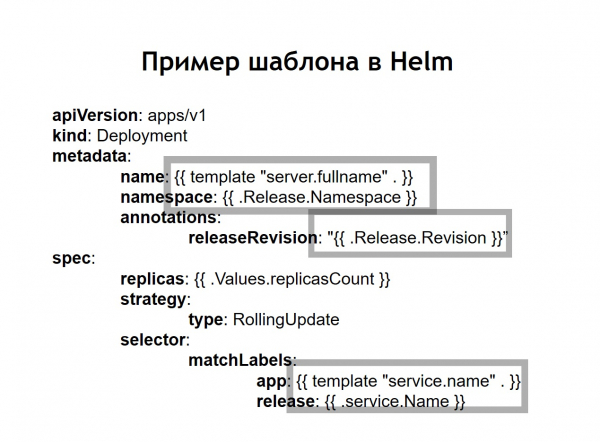
Takođe smo shvatili da šablonizacija, koju smo ranije morali raditi sami kroz uvođenje jinja u naše konfiguracije, jeste jedna od osnovnih funkcionalnosti Helma. Svi konfiguracijski fajlovi koje kreirate za vaše sisteme, čuvaju se u Helmu u obliku šablona, koji su pomalo slični jinja, ali zapravo koriste šablonizaciju jezika Go, na kojem je Helm napisan, kao i Kubernetes.
Helm nam dodaje još nekoliko dodatnih pojmova.
Chart je opis vašeg servisa. U drugim menadžerima paketa nazvali bi to paket, bundle ili nešto slično. Ovde se to naziva chart.
Values su varijable koje želite koristiti za sastavljanje vaših konfiguracija iz šablona.
Release. Svaki put kada se servis koji se implementira putem helma dobije inkrementalnu verziju izdanja. Helm pamti koji je bio konfiguracija servisa prilikom prethodnog, pretprethodnog izdanja i tako dalje. Dakle, ako je potrebno vratiti se, dovoljno je izvršiti komandu helm callback, navodeći prethodnu verziju izdanja. Čak i ako u trenutku vraćanja odgovarajuća konfiguracija u vašem repozitoriju nije dostupna, helm i dalje pamti kakva je bila i vratiće vaš sistem u stanje u kojem je bio tokom prethodnog izdanja.
U slučaju kada koristimo helm, obične konfiguracije za Kubernetes takođe se pretvaraju u šablone, u kojima postoji mogućnost korišćenja promenljivih, funkcija, primene uslovnih operatora. Na taj način, možete sastaviti konfiguraciju vašeg servisa u zavisnosti od okruženja.
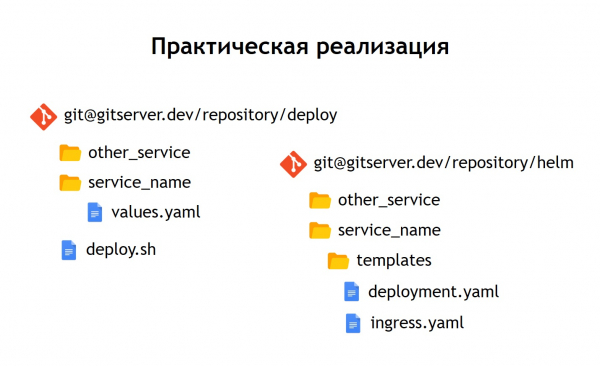
U praksi smo odlučili da postupimo malo drugačije nego što smo radili u slučaju sa Nomadom. Ako su u Nomadu u jednom repozitoriju bile pohranjene i konfiguracije za implementaciju, i n-promene potrebne za implementaciju našeg servisa, ovde smo odlučili da ih podelimo na dva odvojena repozitorija. U repozitorijumu „deploy“ čuvaju se samo n-promene potrebne za implementaciju, dok u repozitorijumu „helm“ stoje konfiguracije ili chartovi.
Šta nam to daje?
Iako u samim konfiguracionim datotekama ne čuvamo stvarno osetljive podatke. Na primer, lozinke za baze podataka. One se čuvaju u obliku tajni u Kubernetes-u, ali i dalje postoje posebne stvari kojima ne želimo da daju pristup svima. Zato je pristup repozitorijumu „deploy“ ograničeniji, dok repozitorijum „helm“ sadrži samo opis servisa. Iz tog razloga, u njega se može bezbedno dati pristup većem broju lica.
Budući da imamo ne samo produkciju, već i druga okruženja, zahvaljujući ovom razdvajanju možemo ponovo koristiti naše helm-chartove za implementaciju servisa ne samo u produkciji, već i, na primer, u QA-okruženju. Čak i za to da ih postavimo lokalno, koristeći Minikube — to je stvar za lokalno pokretanje Kubernetesa.
Unutar svake repozitorije smo ostavili razdvojene direktorije za svaku uslugu. To znači da unutar svake direktorije postoje šabloni koji se odnose na odgovarajući grafikon i opisuju resurse koje je potrebno postaviti za pokretanje našeg sistema. U repozitoriju „deploy“ ostavili smo samo envs. U ovom slučaju nismo koristili šablonizaciju putem jinja, jer helm sam po sebi pruža šablonizaciju iz kutije - to je jedna od njegovih osnovnih funkcija.
Ostavili smo skriptu za postavljanje - deploy.sh, koja pojednostavljuje i standardizuje pokretanje za postavljanje putem helma. Tako, za nekoga ko želi da postavi, interfejs postavljanja izgleda jednako kao u slučaju postavljanja putem Nomada. Isti deploy.sh, naziv vaše usluge, i mesto gde želite da je postavite. To dovodi do toga da unutar pokretanja se pokreće helm. On zauzvrat prikuplja konfiguracije iz šablona, ubacuje potrebne values-fajlove, zatim postavlja, šaljući ih u Kubernetes.
Zaključci
Kubernetes usluga izgleda složenije od Nomada.
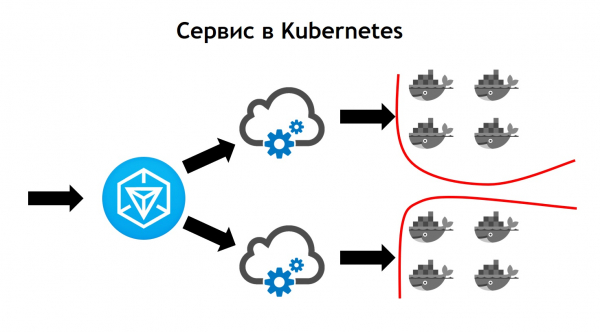
Ovde izlazni saobraćaj dolazi u Ingress. To je upravo front-kontroler koji preuzima sve zahteve i kasnije ih šalje odgovarajućim uslugama prema podacima zahteva. On ih određuje na osnovu konfiguracija koje su deo opisa vaše aplikacije u helmu i koje programeri sami definišu. Usluga zatim šalje zahteve ka svojim podovima, tj. konkretno kontejnerima, balansirajući ulazni saobraćaj između svih kontejnera koji pripadaju toj usluzi. I naravno, ne treba zaboraviti na to da na nivou mrežne sigurnosti ne smemo odustajati. Zato u Kubernetes klasteru funkcioniše segmentacija zasnovana na označavanju. Sve usluge imaju određene oznake, na koje su vezana prava pristupa usluga tim ili onim spoljnim/unutrašnjim resursima unutar ili van klastera.
Prilikom prelaska, uočili smo da Kubernetes ima sve mogućnosti koje je imao Nomad, koji smo ranije koristili, kao i mnoge nove mogućnosti. Može se proširiti putem dodataka, zapravo putem prilagođenih tipova resursa. To znači da imate mogućnost ne samo da koristite nešto što dolazi u Kubernetesu iz kutije, već i da kreirate vlastiti resurs i servis koji će čitati vaš resurs. To pruža dodatne mogućnosti za proširenje vašeg sistema bez potrebne ponovne instalacije Kubernetesa i bez potrebnih izmena.
Primer takve upotrebe je Prometheus, koji se pokreće unutar našeg Kubernetes klastera. Da bi počeo da prikuplja metrike sa određenog servisa, potrebno je dodati dodatni tip resursa u opis servisa, takozvani servis-monitor. Prometheus, zbog svoje sposobnosti da čita prilagođene tipove resursa kada je pokrenut u Kubernetesu, automatski počinje da prikuplja metrike iz novog sistema. To je prilično praktično.
Prvi deploy koji smo uradili u Kubernetesu bio je u martu 2018. godine. Tokom tog vremena nikada nismo imali problema sa njim. Dosta stabilno funkcioniše bez značajnih grešaka. Pored toga, možemo ga dalje proširivati. Do danas, dovoljno su nam mogućnosti koje imamo, a brzina razvoja Kubernetesa nam se veoma dopada. Trenutno se više od 3000 kontejnera nalazi u Kubernetessu. Klaster se sastoji od nekoliko Node-ova. Pri tome, to je servisiran, stabilan i veoma kontrolisan.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish