

Uvod
Informacijski sistem iz perspektive korisnika dobro se definiše prema GOST RV 51987 - „automatski sistem, njegov rezultat funkcionisanja jeste predstavljanje izlaznih informacija za kasniju upotrebu“. Kada se razmatra unutrašnja struktura, suštinski, svaki IS je sistem realizovanih kodiranih međuzavisnih algoritama. U širem smislu Tjuring-Čerčovog teze, algoritam (a samim tim i IS) vrši transformaciju skupa ulaznih podataka u skup izlaznih podataka.
Može se reći da je smisao postojanja informacionog sistema u transformaciji ulaznih podataka. Shodno tome, vrednost IS-a i celokupnog kompleksa IS-a definiše se kroz vrednost ulaznih i izlaznih podataka.
Iz ovoga, projektovanje treba da počne i temelji se na podacima, prilagođavajući arhitekturu i metode strukturi i značaju podataka.
Skladišteni podaci
Ključna faza pripreme za projektovanje je prikupljanje karakteristika svih skupova podataka koji se planiraju za obradu i skladištenje. Ove karakteristike uključuju:
— Obim podataka;
— Informacije o životnom ciklusu podataka (prirast novih podataka, vek trajanja, obrada zastarelih podataka);
— Klasifikacija podataka sa aspekta uticaja na osnovni biznis kompanije (u okviru triade poverljivost, celovitost, dostupnost) zajedno sa finansijskim pokazateljima (npr. trošak gubitka podataka u poslednjem satu);
— Geografija obrade podataka (fizička lokacija sistema obrade);
— Zahtevi regulatora za svaku klasu podataka (npr. FZ-152, PCI DSS).
Informacijski sistemi
Podaci ne samo da se skladište, već ih i obrađuju (transformišu) informacijski sistemi. Sledeći korak nakon prikupljanja karakteristika podataka je što potpunija inventarizacija informacionih sistema, njihovih arhitektonskih karakteristika, međuzavisnosti i zahteva za infrastrukturom u uslovnim jedinicama za četiri vrste resursa:
— Procesorska računska moć;
— Obim radne memorije;
— Zahtevi za obimom i performansama sistema za skladištenje podataka;
— Zahtevi za mrežu podataka (spoljni kanali, kanali između komponenti IS-a).
Zahtjevi moraju biti prisutni za svaku uslugu/mikroservis u okviru IS-a.
Posebno je potrebno naglasiti obavezu posjedovanja podataka o uticaju IS-a na osnovni biznis kompanije u obliku troškova zastoja IS-a (rubalja po satu).
Model prijetnji
Obavezno je imati formalni model prijetnji od kojih se planira zaštita podataka/usluga. Pri tome, model prijetnji obuhvata ne samo aspekte povjerljivosti, već i cjelovitosti i dostupnosti. Na primjer:
— Kvar fizičkog servera;
— Kvar top-of-the-rack prekidača;
— Prekid optičkog komunikacijskog kanala između data centara;
— Kvar radne SĊD u cijelosti.
U nekim slučajevima modeli prijetnji se pišu ne samo za infrastrukturne komponente, već i za konkretne IS ili njihove komponente, kao što je na primjer kvar DBMS-a sa logičkim uništenjem strukture podataka.
Sve odluke u okviru projekta zaštite od neophodno opisane prijetnje su suvišne.
Zahtjevi regulatora
Ako obrađeni podaci podliježu posebnim pravilima koje postavljaju regulatori, obavezno je imati informacije o skupovima podataka i pravilima obrade/pohrane.
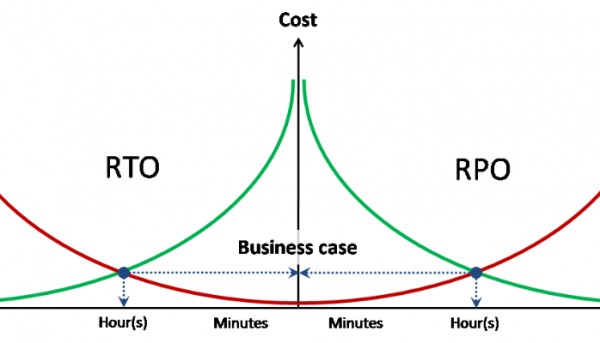
Ciljne vrijednosti RPO/RTO
Projektovanje bilo koje vrste zaštite zahtijeva prisustvo pokazatelja ciljnih gubitaka podataka i ciljnog vremena obnove usluge za svaku od opisanih prijetnji.
Pri tome, idealno bi RPO i RTO trebali imati pridružene troškove gubitka podataka i zastoja po jedinici vremena.
Podjela resursa
Nakon prikupljanja svih primarnih informacija, prvi korak je grupisanje skupova podataka i IS-a u grupe, na osnovu modela prijetnji i zahtjeva regulatora. Određuje se vrsta podjele različitih grupa – tehnički na nivou sistemskog softvera ili fizički.
Primjeri:
— Kontura koja obrađuje lične podatke je potpuno fizički odvojena od ostalih sistema;
— rezervne kopije se čuvaju na odvojenoj SĊD.
Pri tome, grupe mogu biti s nepotpunom nezavisnošću, na primjer, definišu se dvije grupe računarskih resursa (procesorska snaga + radna memorija), koje koriste jedinstvenu grupu za pohranu podataka i jedinstvenu grupu za resurse prenosa podataka.
Procesorska snaga
Apstraktne potrebe za procesorskom snagom virtualiziranog Data centra mjere se brojem virtualnih procesora (vCPU) i koeficijentom njihove konsolidacije na fizičkim procesorima (pCPU). U ovom konkretnom slučaju 1 pCPU = 1 fizičko jezgro procesora (bez uzimanja u obzir Hyper-Threading). Broj vCPU se sabira po svim definiranih grupama resursa (svaka od kojih može imati vlastiti koeficijent konsolidacije).
Koeficijent konsolidacije za opterećene sisteme dobija se empirijski, oslanjajući se na postojeću infrastrukturu, ili tokom pilotske instalacije i testiranja opterećenja. Za neopterećene sisteme primenjuju se "best practice". Posebno, VMware naziva prosječnim koeficijentom 8:1.
Radna memorija
Ukupna potreba za radnom memorijom dobija se jednostavnim sabiranjem. Korišćenje prepisivanja radne memorije se ne preporučuje.
Resursi za skladištenje
Zahtjevi za resursima za skladištenje dobijaju se jednostavnim sabiranjem svih grupa po volumenu i performansama.
Zahtjevi za performansama izražavaju se u IOPS-u u kombinaciji sa prosječnim odnosom čitanja/pisa i, po potrebi, maksimalnom latencijom odaziva.
Zasebno treba navesti zahtjeve za osiguranje kvaliteta usluge (QoS) za specifične grupe ili sisteme.
Resursi mreže za prijenos podataka
Zahtjevi za mrežom za prijenos podataka dobijaju se jednostavnim sabiranjem svih grupa propusnosti.
Zasebno treba navesti zahtjeve za osiguranje kvaliteta usluge (QoS) i latenciju (RTT) za specifične grupe ili sisteme.
U okviru zahtjeva za resursima mreže za prijenos podataka takođe se navode zahtjevi za izolaciju i/ili enkripciju mrežnog saobraćaja i preferiranim mehanizmima (802.1q, IPSec itd.)
Izbor arhitekture
U okviru ovog vodiča ne razmatra se drugi izbor osim arhitekture x86 i 100% virtualizacije servera. Stoga, izbor arhitekture računarske podsistem svodi se na izbor platforme serverne virtualizacije, faktora forme servera i opće zahtjeve po konfiguraciji servera.
Ključni trenutak izbora je odlučnost u korišćenju klasičnog pristupa sa podjelom funkcija obrade, skladištenja i prijenosa podataka ili konvergentnog.
Klasična arhitektura podrazumijeva korištenje inteligentnih vanjskih sustava za pohranu i prijenos podataka, dok poslužitelji donose u zajednički bazen fizičkih resursa samo procesorsku snagu i radnu memoriju. U ekstremnom slučaju, poslužitelji postaju potpuno anonimni, bez vlastitih diskova, pa čak i sistemskog identifikatora. U ovom slučaju koristi se pokretanje operativnog sustava ili hipervizora s ugrađenih flash uređaja ili s vanjskog sustava za pohranu podataka (boot from SAN).
U okviru klasične arhitekture, izbor između blade i rack sustava se vrši prvenstveno prema sljedećim principima:
— Ekonomičnost (u prosjeku rack poslužitelji su jeftiniji);
— Računalna gustoća (kod blade je veća);
— Potrošnja energije i isijavanje topline (kod blade je veća specifična po jedinici);
— Skalabilnost i upravljivost (blade u cjelini zahtijevaju manje napora prilikom većih instalacija);
— Korištenje ekspanzijskih kartica (za blade je vrlo ograničen izbor).
Konvergirana arhitektura (također poznata kao hiperkonvergirana) pretpostavlja spajanje funkcija obrade i pohrane podataka, što dovodi do korištenja lokalnih diskova poslužitelja i kao posljedicu odbacivanja form-faktora klasičnih blade. Za konvergentne sustave koriste se ili rack poslužitelji, ili klasterski sustavi koji kombiniraju u jednoj kućištu nekoliko blade poslužitelja i lokalnih diskova.
CPU / Memorija
Za ispravnu procjenu konfiguracije potrebno je razumjeti tip opterećenja za okruženje ili svaki od neovisnih klastera.
CPU bound – okruženje ograničeno procesorskom snagom. Dodavanje radne memorije neće promijeniti ništa s gledišta performansi (broja VM na poslužitelju).
Memory bound – okruženje ograničeno radnom memorijom. Veći broj radne memorije na poslužitelju omogućuje pokretanje većeg broja VM na poslužitelju.
GB / MHz (GB / pCPU) – prosječan omjer potrošnje ove specifične opterećenja radne memorije i procesorske snage. Može se koristiti za procjene potrebne količine memorije pri zadanoj performansi i obrnuto.
Procjena konfiguracije poslužitelja
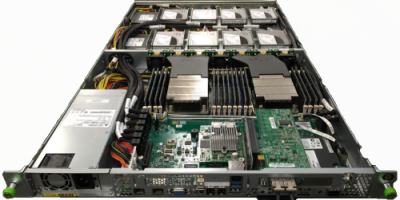
Prvo je potrebno odrediti sve vrste opterećenja i doneti odluku o kombinovanju ili deljenju različitih računalnih pulova po različitim klastraima.
Zatim, za svaki od definisanih klastera, određuje se odnos GB / MHz pri unapred poznatom opterećenju. Ako opterećenje nije poznato unapred, ali postoji približno razumevanje nivoa opterećenja procesorske snage, mogu se koristiti standardni koeficijenti vCPU:pCPU za prevođenje zahteva pulova u fizičke.
Za svaki klaster sumu zahteva pulova vCPU delimo sa koeficijentom:
vCPUsum / vCPU:pCPU = pCPUsum – zahtevano broj fizičkih jezgara
pCPUsum / 1.25 = pCPUht – broj jezgara sa korekcijom za Hyper-Threading
Pretpostavimo da je potrebno izračunati klaster sa 190 jezgara / 3.5TB RAM-a. Pri tome uzimamo ciljano opterećenje procesorske snage od 50% i 75% za radnu memoriju.
pCPU
190
CPU util
50%
Mem
3500
Mem util
75%
Socket
Core
Srv / CPU
Srv Mem
Srv / Mem
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
U ovom slučaju uvek koristimo zaokruživanje na najbliži ceo broj prema gore (=ROUNDUP(A1;0)).
Iz tabele je očigledno da su nekoliko konfiguracija servera uravnotežene prema ciljnim pokazateljima:
— 26 servera 2*6c / 192 GB
— 19 servera 2*10c / 256 GB
— 10 servera 2*18c / 512 GB
Izbor između ovih konfiguracija u budućnosti treba obaviti uzimajući u obzir dodatne faktore, kao što su toplotni paket i dostupno hlađenje, već korišćeni serveri ili troškovi.
Karakteristike izbora konfiguracije servera
Široke VM. U slučaju potrebe za postavljanjem širokih VM (uporedivih sa 1 čvorom NUMA i više) preporučuje se, gde god je to moguće, odabrati server sa konfiguracijom koja omogućava tim VM da ostanu unutar NUMA čvora. U prisustvu velikog broja širokih VM postoji opasnost od fragmentacije resursa klastera, te se biraju serveri koji omogućavaju postavljanje širokih VM što je moguće gušće.
Veličina domena jedinstvene greške.
Izbor veličine servera takođe se vrši prema principu minimizacije domena jedinstvene greške. Na primer, pri izboru između:
— 3 x 4*10c / 512 GB
— 6 x 2*10c / 256 GB
Kod istih uslova, potrebno je izabrati drugu opciju, jer kvarom jednog servera (ili održavanjem) ne gubimo 33% resursa klastera, već 17%. Takođe se prepolovljuje broj VM i IS na kojima se odrazila havarija.
Izračun klasične SSK po performansama
Klasična SSK se uvijek izračunava prema najgorem scenariju, isključujući utjecaj radnog keša i optimizacije operacija.
Kao osnovne pokazatelje performansi uzimamo mehaničku performansu s diska (IOPSdisk):
— 7.2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
Nakon toga, broj diskova u diskovnom skupu izračunava se prema sljedećoj formuli: = TotalIOPS * (RW + (1 – RW) * RAIDPen) / IOPSdisk. Gdje:
— TotalIOPS – ukupan potrebni kapacitet performansi u IOPS iz diskovnog skupa
— RW – postotak operacija čitanja
— RAIDpen – RAID kazna za odabranu razinu RAID-a
Više o RAID uređaju i RAID kazni možete pročitati ovdje — i i
Na osnovu dobivenog broja diskova izračunavaju se mogući varijante koje zadovoljavaju zahtjeve za kapacitetom pohrane, uključujući varijante s višeslojnim pohranama.
Izračun sistema koji koriste SSD kao nivo pohrane razmatra se odvojeno.
Specifičnosti izračuna sistema s Flash Cache
Flash Cache – opšti naziv za sve brendirane tehnologije korišćenja flash memorije kao keša drugog nivoa. Kada se koristi flash keš, SSK se obično izračunava za obezbeđivanje opterećenja sa magnetskih diskova, dok se vrhunskom usluži keš.
Pri tome, potrebno je razumjeti profil opterećenja i stepen lokalizacije pristupa blokovima skladišnog volumena. Flash keš je tehnologija pogodna za opterećenja s visokom lokalizacijom zahteva i praktično je neopravdana za ravnomerno opterećene volumene (kao, na primjer, za analitičke sisteme).
Izračun hibridnih sistema low-end / mid-range
Hibridni sistemi nižih i srednjih klasa koriste višeslojnu pohranu s premještanjem podataka između nivoa prema rasporedu. Pri tome, veličina bloka višeslojne pohrane kod najboljih modela iznosi 256 MB. Ove karakteristike ne dopuštaju da se tehnologija višeslojne pohrane smatra tehnologijom povećanja performansi, kako pogrešno misli mnogi. Višeslojna pohrana u sistemima nižih i srednjih klasa je tehnologija optimizacije troškova pohrane za sisteme s izraženom nejednakošću opterećenja.
Za višeslojno skladištenje, prvenstveno se izračunava performansa najgornjeg nivoa, dok se donji nivo skladištenja smatra samo kao dodatni kapacitet skladištenja. Za hibridni višeslojni sistem, obavezno je korišćenje tehnologije flash keša za višeslojni bazen kako bi se kompenzovao gubitak performansi za iznenada opterećene podatke iz donjeg nivoa.
Korišćenje SSD-a u višeslojnim diskovnim bazenima
Korišćenje SSD-a u višeslojnim diskovnim bazenima ima varijacije, u zavisnosti od specifičnosti implementacije algoritama flash keša kod određenog proizvođača.
Opšta praksa politike skladištenja za diskovni bazen sa SSD nivoom — SSD first.
Read Only Flash Cache. Za flash keš samo za čitanje, nivo skladištenja na SSD-u se pojavljuje uz značajnu lokalizaciju operacija pisanja van keša.
Read / Write Flash Cache. U slučaju flash keša za pisanje, prvo se postavlja maksimalni kapacitet keša, a nivo skladištenja na SSD-u se pojavljuje samo kada veličina keša nije dovoljna da podrži celu lokalizovanu opterećenost.
Izračunavanje performansi SSD-a i keša se vrši svaki put na osnovu preporuka proizvođača, ali uvek za najgori slučaj.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish