

Nastavljajući temu snimanja velikih tokova podataka, pokrenutu , u ovom ćemo razmotriti načine na koje se može smanjiti „fizička“ veličina pohranjenog u PostgreSQL-u, i njihov uticaj na performanse servera.
Govorićemo o TOAST podešavanjima i poravnanju podataka. „U proseku“, ove metode će omogućiti uštedu ne previše resursa, ali — ukupno bez modifikacije koda aplikacije.
Međutim, naše iskustvo se pokazalo veoma produktivnim u tom pogledu, jer su skladišta skoro svakog monitoringa po svojoj prirodi većinom append-only naročito u pogledu zapisivanih podataka. I ako vas zanima kako se može naučiti baza da piše na disk umesto 200MB/s dvostruko manje — molim vas, nastavite sa čitanjem.
Mali trikovi velikih podataka
Na profilu rada , redovno dobijamo iz logova tekstualne pakete.
A pošto , čije baze podataka pratimo, predstavlja višekomponentni proizvod sa složenim strukturama podataka, tako i upiti za postizanje maksimalne performanse se pokazali kao . Tako da i obim svakog pojedinačnog upita ili rezultantnog plana izvršenja u logu koji dobijamo ispostavlja se da je „u proseku“ prilično veliki.
Hajde da pogledamo strukturu jedne od tabela u koju unosimo „sirove“ podatke — to jest direktno originalni tekst iz zapisnika:
CREATE TABLE rawdata_orig(
  pack -- PK
    uuid NOT NULL
, recno -- PK
    smallint NOT NULL
, dt -- ključ sekcije
    date
, data -- najvažnija stvar
    text
, PRIMARY KEY(pack, recno)
);
Tipična takva tabelica (već particionisana, naravno, zato je ovo — šablon sekcije), gde je najvažnije — tekst. Ponekad prilično obiman.
Setimo se da „fizička“ veličina jednog zapisa u PG ne može zauzimati više od jedne stranice podataka, ali „logička“ veličina — to je sasvim druga stvar. Da bi se u funkciji zadržalo obimno vrednost (varchar/text/bytea) koristi se :
PostgreSQL koristi fiksnu veličinu stranice (obično 8 KB) i ne omogućava tuple-ima da zauzimaju više stranica. Stoga nije moguće direktno čuvati veoma velike vrednosti polja. Da bi se prevazišlo ovo ograničenje, velike vrednosti polja se kompresuju i/ili razbijaju na nekoliko fizičkih redova. Ovo se dešava neprimetno za korisnika i na veći deo koda servera utiče neznatno. Ova metoda je poznata kao TOAST …
U stvari, za svaku tabelu sa „potencijalno velikim“ poljima automatski svake „velike“ stavke u segmente od 2KB:
TOAST(
  chunk_id
    integer
, chunk_seq
    integer
, chunk_data
    bytea
, PRIMARY KEY(chunk_id, chunk_seq)
);
To jest, ukoliko moramo da zapečatimo red sa „velikom“ vrednošću data, stvarna zapisivanje će se dogoditi ne samo u glavnoj tabeli i njenom PK, već i u TOAST-u i njegovom PK.
Smanjivanje TOAST-uticaja
Ali većina zapisa kod nas ipak nije toliko velika, u 8KB bi se trebali uklapati — kako uštedeti na tome?..
Tada nam pomaže atribut u koloni tabele:
- EXTENDED omogućava kako kompresiju, tako i odvojeno skladištenje. Ovo je standardna opcija za većinu tipova podataka kompatibilnih sa TOAST-om. Prvo se pokušava izvršiti kompresija, zatim — čuvanje van tabele, ukoliko red još uvek bude prevelik.
- MAIN omogućava kompresiju, ali ne i odvojeno skladištenje. (U stvari, odvojeno skladištenje će se međutim izvršiti za takve kolone, ali samo kao krajnje sredstvo, kada nema drugog načina da se smanji red tako da stane na stranicu.)
U stvari, to je upravo ono što nam treba za tekst — maksimalno kompresovati, a ako baš ne može da stane — izneti u TOAST. Ovo se može uraditi direktno „u hodu“, jednom komandom:
ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;Kako proceniti efekat
Pošto se svaki dan tok podataka menja, ne možemo upoređivati apsolutne cifre, ali u relativnim uslovima što manji deo smo zabeležili u TOAST-u — to bolje. Ali ovde postoji opasnost — što je veći „fizički“ obim svake pojedinačne stavke, to se indeks „širi“, jer je potrebno pokriti veći broj stranica podataka.
Sekcija pre promena:
heap  = 37GB (39%)
TOAST = 54GB (57%)
PK    =  4GB ( 4%)
Sekcija posle promena:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
U stvari, mi počeli smo pisati u TOAST dvostruko ređe, što je rasteretilo ne samo disk, već i CPU:
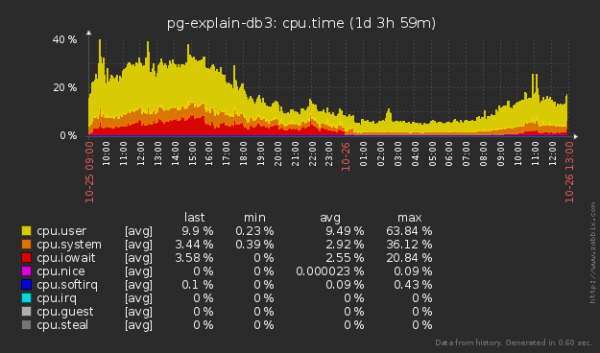
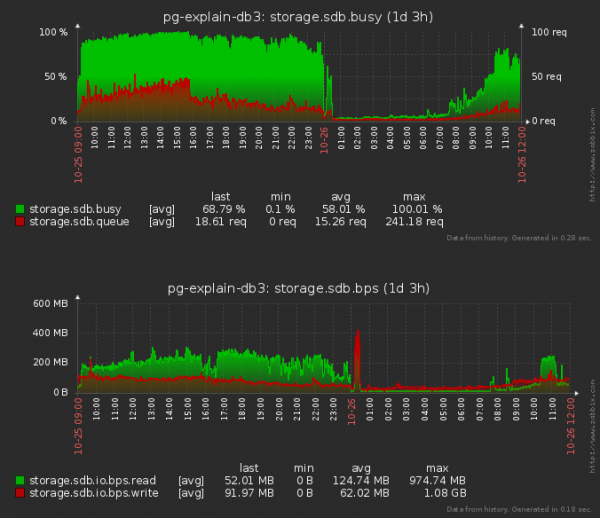
Napominjem da smo sada manje "čitajući" disk, ne samo "pišući" - jer prilikom umetanja zapisa u neku tabelu moramo "pročitati" i deo stabla svakog od indeksa kako bismo odredili njenu buduću poziciju u njima.
Kome je dobro živeti na PostgreSQL 11
Nakon ažuriranja na PG11, odlučili smo da nastavimo s "tuningom" TOAST-a i obratili smo pažnju da je od ove verzije postao dostupan za podešavanje parametar :
Kod obrade TOAST-a se aktivira samo kada je veličina niza koji treba sačuvati u tabeli veća od TOAST_TUPLE_THRESHOLD bajta (obično to iznosi 2 KB). TOAST kod će kompresovati i/ili izneti vrednosti polja izvan tabele sve dok vrednost niza ne postane manja od TOAST_TUPLE_TARGET bajta (varijabilna veličina, takođe obično 2 KB) ili neće biti moguće smanjiti obim.
Odlučili smo da su naši podaci obično ili "veoma kratki" ili odmah "veoma dugi", pa smo se odlučili ograničiti na minimalno moguću vrednost:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Hajde da vidimo kako su nove postavke uticale na opterećenje diska nakon ponovne konfiguracije:
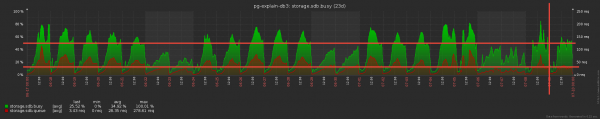
Nije loše! Prosečna čekanje na disk se smanjilo otprilike 1.5 puta, a "zauzetost" diska - za 20%! Ali možda je to nekako uticalo na CPU?
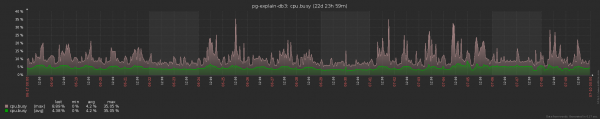
Bar, sigurno nije postalo gore. Iako, teško je suditi ako ni ovoliki obim ne može podići prosečno opterećenje CPU-a iznad 5%.
Promenom mesta zagrada suma... menja se!
Kao što je poznato, dinar čuva rubalja, i pri našim obimima skladištenja od 10TB/mesečno čak i mala optimizacija može doneti dobar profit. Zato smo obratili pažnju na fizičku strukturu svojih podataka - kako su konkretno "složena" polja unutar zapisa svake od tabela.
Zato što zbog to direktno :
Mnoge arhitekture predviđaju poravnavanje podataka prema granicama mašinskih reči. Na primer, na 32-bitnom sistemu x86, celobrojne vrednosti (tip integer, zauzima 4 bajta) biće poravnate prema granici 4-bajtnih reči, kao i brojevi sa pomičnom tačkom dvostruke preciznosti (tip double precision, 8 bajtova). A na 64-bitnom sistemu vrednosti double će biti poravnate prema granici 8-bajtnih reči. Ovo je još jedan razlog nespojivosti.
Zbog poravnanja, veličina redova u tabeli zavisi od redosleda polja. Obično ovaj efekat nije previše vidljiv, ali u nekim slučajevima može dovesti do značajnog povećanja veličine. Na primer, ako su polja tipova char(1) i integer pomešana, između njih će se obično izgubiti 3 bajta.
Hajde da počnemo sa sintetičkim modelima:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 bajtova

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 bajtova
Odakle dolaze ta dva viška bajta u prvom slučaju? Sve je prosto — 2-bajtni smallint se poravnava na 4-bajtnoj granici pre sledećeg polja, a kada je poslednji — nema gde da se poravna i nema potrebe.
U teoriji — sve je u redu i možemo da pomeramo polja kako god želimo. Hajde da proverimo na realnim podacima na primeru jedne od tabela, čija dnevna sekcija zauzima po 10-15GB.
Početna struktura:
CREATE TABLE public.plan_20190220
(
-- Nasleđeno iz tabele plan:  pack uuid NOT NULL,
-- Nasleđeno iz tabele plan:  recno smallint NOT NULL,
-- Nasleđeno iz tabele plan:  host uuid,
-- Nasleđeno iz tabele plan:  ts timestamp with time zone,
-- Nasleđeno iz tabele plan:  exectime numeric(32,3),
-- Nasleđeno iz tabele plan:  duration numeric(32,3),
-- Nasleđeno iz tabele plan:  bufint bigint,
-- Nasleđeno iz tabele plan:  bufmem bigint,
-- Nasleđeno iz tabele plan:  bufdsk bigint,
-- Nasleđeno iz tabele plan:  apn uuid,
-- Nasleđeno iz tabele plan:  ptr uuid,
-- Nasleđeno iz tabele plan:  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
Sekcija nakon promene reda kolona — točno isti polja, samo je redosled drugačiji:
CREATE TABLE public.plan_20190221
(
-- Nasleđeno iz tabele plan:  dt date NOT NULL,
-- Nasleđeno iz tabele plan:  ts timestamp with time zone,
-- Nasleđeno iz tabele plan:  pack uuid NOT NULL,
-- Nasleđeno iz tabele plan:  recno smallint NOT NULL,
-- Nasleđeno iz tabele plan:  host uuid,
-- Nasleđeno iz tabele plan:  apn uuid,
-- Nasleđeno iz tabele plan:  ptr uuid,
-- Nasleđeno iz tabele plan:  bufint bigint,
-- Nasleđeno iz tabele plan:  bufmem bigint,
-- Nasleđeno iz tabele plan:  bufdsk bigint,
-- Nasleđeno iz tabele plan:  exectime numeric(32,3),
-- Nasleđeno iz tabele plan:  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
Ukupna veličina sekcije određena je količinom „činjenica“ i zavisi samo od spoljnih procesa, tako da ćemo podeliti veličinu heap (pg_relation_size) o broju zapisa u njemu — dakle, dobijamo prosečnu veličinu stvarnog sačuvanog zapisa:
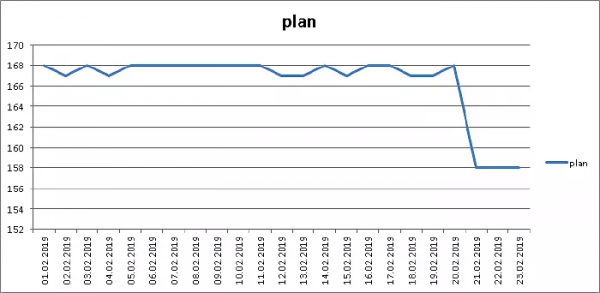
Minus 6% volumena, odlično!
Ali, naravno, nije sve tako ružičasto — jer ne možemo promeniti redosled polja u indeksima, pa stoga „u celini“ (pg_total_relation_size)…
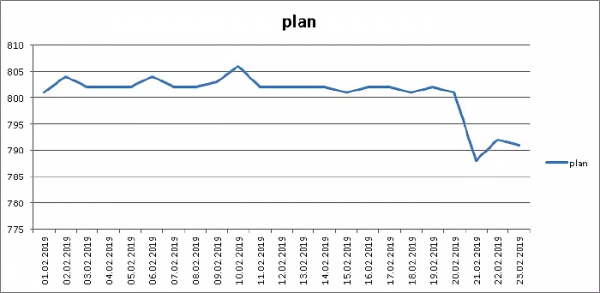
… ipak i tu ušteđena su 1.5%, ne menjajući ni jedan red koda. Tako je!
Napominjem da navedena raspodela polja nije sigurno najsavršenija. Jer neka polja ne želimo da „razdvajamo“ iz estetskih razloga — na primer, par (pack, recno), koji predstavlja PK za ovu tabelu.
U principu, definicija „minimalnog“ rasporeda polja je prilično jednostavna „izborna“ zadaća. Stoga možete na svojim podacima dobiti rezultate čak bolje nego mi — pokušajte!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish