

Transkript izlaganja Ilje Kosmodemjanskog iz 2015. "Tuning Linux za poboljšanje performansi PostgreSQL"
Odricanje odgovornosti: Napominjem da je ovo izlaganje datirano novembrom 2015. — prošlo je više od 4 godine i mnogo vremena. Verzija 9.4 koja se razmatra u izlaganju više nije podržana. Tokom protekle 4 godine objavljeno je 5 novih verzija PostgreSQL-a i 15 verzija Linux jezgra. Ako bismo prepisivali ta mesta, došli bismo do drugog izlaganja. Međutim, ovde je razmotrena fundamentalna optimizacija Linux-a za PostgreSQL koja je i danas relevantna.
Zovem se Ilja Kosmodemjanski. Radim u kompaniji PostgreSQL-Consulting. Sada ću govoriti o tome šta raditi sa Linux-om u kontekstu baza podataka uopšte, a posebno PostgreSQL-a, jer su principi prilično slični.
O čemu ćemo govoriti? Ako komunicirate sa PostgreSQL-om, do određenog nivoa potrebno je biti UNIX administrator. Šta to znači? Ako uporedimo Oracle i PostgreSQL, u Oracle-u morate biti 80 % DBA administrator baze podataka i 20 % Linux administrator.
Sa PostgreSQL-om je malo složenije. Sa PostgreSQL-om morate mnogo bolje razumeti kako Linux funkcioniše. Uz to, treba pomalo trčati za vremenom, jer se u poslednje vreme sve prilično brzo ažurira. I nova jezgra izlaze, i nova funkcionalnost se pojavljuje, performanse se poboljšavaju itd.
Zašto govorimo o Linux-u? Ne zato što smo na Linux konferenciji u Piteru, već zato što je u modernim uslovima jedan od najsrazmernijih operativnih sistema za upotrebu s bazama podataka uopšte, a posebno s PostgreSQL-om – to je Linux. Nažalost, FreeBSD se razvija u čudnom pravcu. Imaće problema i sa performansama, kao i sa mnogim drugim stvarima. Performanse PostgreSQL-a na Windows-u – to je zapravo posebna ozbiljna tema, jer Windows nema deljenu memoriju kao UNIX, a PostgreSQL je u velikoj meri na to vezan, budući da je višeporosna sistem.
I egzotika poput Solaris-a, mislim da manje zanima sve, pa idemo dalje.
Savremeni Linux distribucija ima više od 1.000 syctl opcija, u zavisnosti od toga kako se kompajlira jezgro. Pored toga, ako pogledamo različite parametre, postoji mnogo načina da se nešto dodatno konfiguriše. Postoje opcije za datotečne sisteme, kako montirati. Ako imate pitanja o tome kako pokrenuti: šta uključiti u BIOS, kako konfigurisati hardver itd.
To je veoma opširna tema o kojoj se može govoriti danima, a ne u jednom kratkom izlaganju, ali trenutno ću se fokusirati na važne aspekte, kako izbjeći zamke koje će vam sigurno otežati pravilno korišćenje baze podataka na Linuxu ako ih ne ispravite. Takođe, važno je napomenuti da mnoge opcije nisu podrazumevano postavljene na način koji je ispravan za bazu podataka. To jest, po defaultu će raditi loše ili uopšte neće raditi.
Koji su tradicionalni ciljevi podešavanja u Linuxu? Mislim da, pošto se svi bavite administracijom Linuxa, objašnjavanje šta su ciljevi nije potrebno.
Možete podešavati:
- CPU.
- Memorija.
- Skladište.
- Ostalo. O tome ćemo razgovarati na kraju. Čak i tako jednostavni parametri kao što su politike štednje energije mogu na vrlo nepredvidiv i neprijatan način uticati na performanse.
Koja je specifičnost PostgreSQL i baze podataka uopšte? Problem je u tome što nije moguće samo podešavati neku pojedinačnu opciju i očekivati drastično poboljšanje performansi.
Da, takve opcije postoje, ali baza podataka je kompleksna stvar. Ona interaguje sa svim resursima koji su dostupni na serveru i preferira potpunu interakciju. Ako pogledate savremene preporuke Oracle-a o korišćenju host operativnog sistema, to će biti kao vic o mongolskom astronautu – nahranite psa i ne dirajte ništa. Dajte bazi sve resurse, ona će sama sve usmeriti.
U suštini, situacija sa PostgreSQL je slična. Razlika je u tome što baza ne može sama da uzima sve resurse, tj. negde je potrebno sve to samostalno upravljati na nivou Linuxa.
Osnovna ideja nije odabrati neku pojedinačnu ciljanu metodu i početi je podešavati, kao što su memorija, CPU ili nešto slično, već analizirati opterećenje i pokušati maksimalno poboljšati propusnost, kako bi kroz našu bazu podataka ta opterećenja, koja su nam stvorili dobri programeri, uključujući naše korisnike, prolazila što efikasnije.
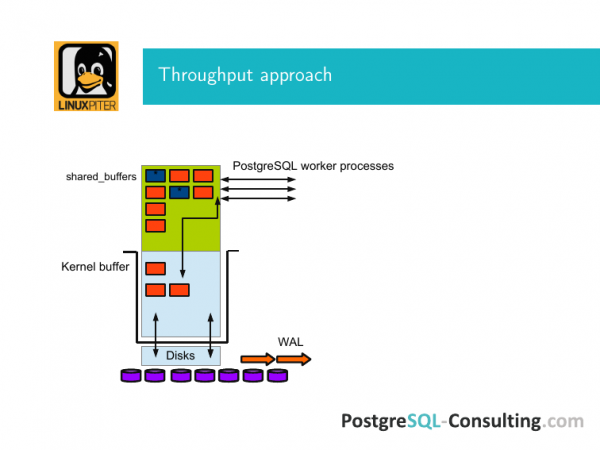
Evo ovakva slika za objašnjenje šta to predstavlja. Postoji OS Linux bafer, tu je zajednička memorija i tu su zajednički baferi PostgreSQL-a. PostgreSQL, za razliku od Oracle-a, deluje isključivo kroz bafer jezgra, tj. da bi stranica sa diska ušla u njegovu zajedničku memoriju, mora prvo proći kroz kernel bafer, a situacija je potpuno ista i na povratku.
I ispod ovog sistema se nalaze diskovi. Ove sam nacrtao kao diskove. U stvari, tu može biti RAID kontroler itd.
I ova ulazno-izlazna operacija se više ili manje odvija preko ovog sistema.
PostgreSQL je klasična baza podataka. Unutra se nalaze stranice. Sav ulaz i izlaz se odvija pomoću stranica. Stranicama dizzemo blokove u memoriju. Ako se ništa nije dogodilo, mi ih samo čitamo, a polako one iz ovog keša, iz zajedničkih bafera, postaju neaktualne i vraćaju se na disk.
Ako nešto zamenimo negde, cela stranica se označava kao prljava. Ove sam označio plavom bojom. To znači da se ta stranica mora sinhronizovati sa blokovnim skladištem. To jest, kada postane prljava, napravimo zapis u WAL-u. I u nekom trenutku dođe fenomen nazvan checkpoint. U tu evidenciju je zapisano obaveštenje o njegovom dolasku. To znači da su sve prljave stranice koje su tada bile u tim zajedničkim baferima sinhronizovane s diskom skladišta koristeći fsync kroz kernel bafer.
Zašto se to radi? Ako nam nestane napajanja, nećemo se suočiti sa situacijom da su nestali svi podaci. Persistetna memorija, o kojoj su nam svi pričali, trenutno je još uvek teorija bazoda – to je svetla budućnost kojoj težimo i koja nam se sviđa, ali za sada još živi u minusu od 20 godina. I, naravno, sve to treba pažljivo pratiti.
Cilj maksimizacije propusnosti je optimizovati sve faze kako bi stvari brže putovale naprijed-nazad. Šerovana memorija je uglavnom page cache. U PostgreSQL-u, kada pošaljemo upit select nešto, podaci se povlače sa diska. Oni dolaze u šerovane baferne memorije. Stoga, da bi to bolje radilo, potrebna je velika količina memorije.
Da bi sve to radilo dobro i brzo, potrebno je pravilno konfigurisati operativni sistem na svim nivoima. Također je važno izabrati izbalansiran hardver, jer ako postoji disbalans negdje, možete imati puno memorije, ali će se ona služiti nedovoljnom brzinom.
Proći ćemo kroz svaki od ovih tačaka.
Kako bi straničici putovali brže naprijed-nazad, potrebno je postići sljedeće:
- Prvo, potrebno je efikasnije upravljati memorijom.
- Drugo, mora biti efikasniji prijelaz kada straničici iz memorije prelaze na disk.
- I, treće, potrebni su dobri diskovi.
Ako imate 512 GB RAM-a u serveru i sve to na kraju završava na SATA tvrdome disku bez ikakvog keša, cjeli server baze podataka se pretvara ne samo u bundeva, nego u bundevu sa SATA interfejsom. Bićete direktno zaglavljeni u tome. Ništa vas neće spasiti.
Što se tiče prve tačke o memoriji, postoje tri stvari koje mogu znatno otežati život.
Prva je NUMA. NUMA je koncept razvijen za poboljšanje performansi. Ovisno o opterećenju, različite stvari se mogu optimizovati. U svom trenutnom obliku nije baš dobar za aplikacije poput baza podataka, koje intenzivno koriste page cache šerovane baferne memorije.
Ukratko. Kako prepoznati da nešto nije u redu sa NUMA-om? Imate nelagodan zvuk, iznenada neki CPU postaje preopterećen. Prilikom analize upita u PostgreSQL-u, vidite da nema ništa slično. Ovi upiti ne bi trebali toliko intenzivno koristiti CPU. Teško je uhvatiti to. Lakše je od samog početka primeniti pravilne preporuke za podešavanje NUMA-e za PostgreSQL.
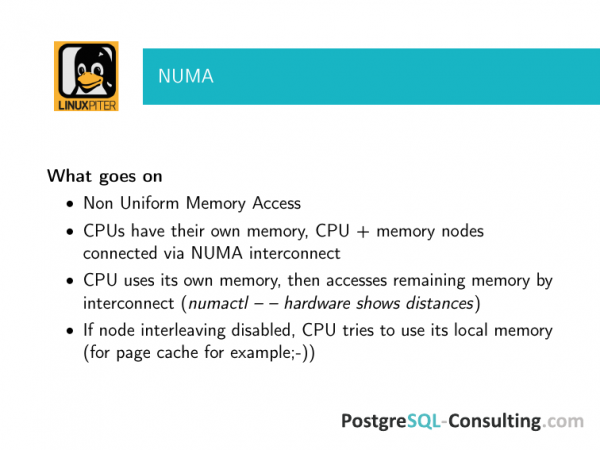
Šta se zapravo dešava? NUMA je Non-Uniform Memory Access. U čemu je stvar? Imate CPU, a pored njega je njegova lokalna memorija. A ova memorija može povlačiti memoriju sa drugih CPU-a putem interkonekcija.
Ako pokrenete numactl --hardware, tada ćete dobiti veliku kolekciju. Osim ostalog, tu će biti i polje distances. Biće tu brojke – 10-20, nešto slično tome. Te brojke su ništa drugo do količina hopova potrebnih da se povežete s tom udaljenom memorijom i koristite je lokalno. U principu, to je dobra ideja. To značajno povećava performanse pod određenim opterećenjima.
Sada zamislite da vaš jedan CPU prvo pokušava koristiti svoju lokalnu memoriju, a zatim pokušava povući drugu memoriju putem interkonekcije za nešto. I na tom CPU-u se nalaze svi vaši page cache podaci iz PostgreSQL-a – sve, koliko god gigabajta. Uvijek dobijate najgori slučaj, jer CPU zapravo ima malo memorije u ovom modulu. A svu memoriju koju upravlja, prolazi kroz te interkonekcije. Rezultat je spor i obeshrabrujuć. I imate procesor koji upravlja ovim čvorom, stalno preopterećen. A vrijeme pristupa ovoj memoriji je loše, sporo. Ova situacija je nešto što ne želite ako koristite ovo za bazu podataka.
Zato je ispravna opcija za bazu podataka da operativni sistem Linux uopšte ne zna šta se događa. Da se obraća memoriji kao što bi se obratio.
Zašto je tako? Činilo bi se da bi trebalo biti obrnuto. To se dešava iz jednog jednostavnog razloga, jer nam je za page cache potrebno mnogo memorije – desetine, stotine gigabajta.
I ako smo sve to odvojili i keširali naše podatke, dobitak od korišćenja keša biće znatno veći nego dobitak od tako pomnog pristupa memoriji. Na taj način ćemo postići neuporedive dobitke u odnosu na to da ćemo efikasnije pristupati memoriji koristeći NUMA.
Zato su trenutna dva pristupa, dok ne dođe svetla budućnosti i baza podataka ne nauči da razume na kojim CPU-ima radi i odakle treba nešto povući.
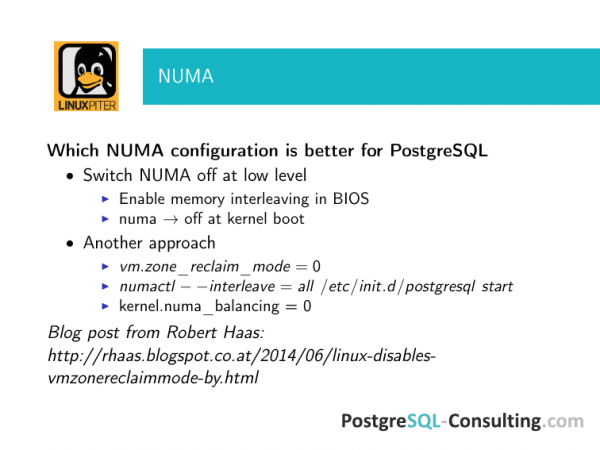
Zato je ispravan pristup – potpuno isključiti NUMA, na primer, prilikom ponovnog pokretanja. U većini slučajeva, dobitci su toliko veliki da se uopšte ne postavlja pitanje šta je bolje.
Postoji druga opcija. Često je koristimo više nego prvu, jer kada klijent dođe na podršku, restartovanje servera postaje pravi izazov. Njegov posao se odvija tamo. A problemi s NUMA su prisutni. Zato se trudimo da isključujemo na manje invazivne načine nego reboot, ali ovdje budite pažljivi i proverite da li je isključeno. Jer, kako iskustvo pokazuje, kada isključimo NUMA za roditeljski proces PostgreSQL, to je dobro, ali nije obavezno da će to raditi. Potrebno je proveriti i gledati da li je to stvarno isključeno.
Postoji dobar post od Roberta Haasa. To je jedan od commitera PostgreSQL-a. Jedan od ključnih developera svih niskonivoa. Ako pratite linkove iz ovog posta, opisuje se nekoliko zanimljivih priča o tome kako je ljudima NUMA otežavala život. Proučite, istražite checklist za sistemske administratore, šta sve treba podesiti na serveru da bi naša baza podataka radila dobro. Ove postavke je potrebno zabeležiti i proveriti, jer u suprotnom će rezultat biti nezadovoljavajući.
Napominjem da se ovo odnosi na sve postavke o kojima ću govoriti. Obično se baze podataka organizuju u master-slave režimu radi otpornosti na greške. Ne zaboravite da unesete ove postavke na slave, jer će se jednog dana možda desiti havarija, i preći ćete na slave, koji postaje master.
U hitnim situacijama, kada je sve veoma loše, vaš telefon ne prestaje da zvoni, a šef vam dolazi s velikom palicom, nećete imati vremena da razmišljate o proveri. A rezultati mogu biti veoma obeshrabrujući.
Sledeća stvar su huge pages. Teško je testirati huge pages odvojeno, a ni nema smisla, iako postoje benchmarkovi koji to mogu. Lako se mogu pronaći putem pretrage.
Koja je poenta? Imate ne baš skupi server s puno RAM-a, na primer, više od 30 GB. Ne koristite huge pages. To znači da imate nesumnjivo preopterećenje u korišćenju memorije. A to preopterećenje nije prijatno.
Zašto je to tako? Šta se dešava? Operativni sistem dodjeljuje memoriju u malim komadima. Tako je lakše, tako je istorijski određeno. A ako se upustimo u detalje, operativni sistem treba da prevodi virtualne adrese u fizičke. I ovaj proces nije najlakši, zbog čega operativni sistem kešira rezultat ove operacije u Translation Lookaside Buffer (TLB).
I pošto je TLB keš, u takvim situacijama javljaju se svi problemi koji su prisutni sa kešom. Prvo, ako imate veoma mnogo radne memorije koja je sve dodijeljena u malim komadima, ta intermedijarna memorija postaje vrlo velika. A ako je keš veliki, traženje postaje sporije. Preopterećenje je značajno i zauzima prostor, tj. radna memorija potrošena na nešto što nije u redu. To je jedna.
Drugo – što se više keš povećava u takvim situacijama, to je veća vjerovatnoća da će se pojaviti keš promašaji. Efikasnost ovog keša rapidno opada sa povećanjem njegove veličine. Zato su operativni sistemi osmislili jednostavan pristup. U Linuxu se koristi već dugo. U FreeBSD-u je nedavno uveden. Ali govorimo o Linuxu. To su huge pages.
Ovde treba napomenuti da su huge pages, kao ideja, prvobitno podržane od strane zajednica uključujući Oracle i IBM, tj. proizvođači baza podataka su ozbiljno razmišljali o tome da će to biti korisno, uključujući baze podataka.
Kako to uskladiti sa PostgreSQL-om? Prvo, na Linux jezgru moraju biti uključeni huge pages.
Drugo, moraju biti izričito navedeni sysctl parametrom – koliko ih ima. Brojevi ovde dolaze s nekog starog servera. Možete izračunati koliko otprilike imate shared buffers, kako bi huge pages mogle stati.
Ako je ceo server posvećen PostgreSQL-u, dobra početna tačka je da ili 25% radne memorije dodijelite shared buffers, ili 75%, ako ste sigurni da će vaša baza podataka sigurno stati u tih 75%. Prva polazna tačka. Izračunajte, ako imate 256 GB radne memorije, onda će vam, prema tome, 64 GB biti u shared buffers. Izračunajte otprilike sa nekim rezerva – na kakvu vrijednost treba postaviti ovu cifru.
Do verzije 9.2 (ako se ne varam, od verzije 8.2) moglo se pomoću treće strane povezati PostgreSQL s huge pages. A to je uvek potrebno uraditi. Pre svega, potrebno je da jezgro zna pravilno alocirati huge pages. A, s druge strane, da aplikacija koja s njima radi može da ih iskoristi. Ne može se to tek tako iskoristiti. Pošto je PostgreSQL alocirao memoriju na način system 5, to se moglo uraditi pomoću libhugetlbfs — to je puno naziv biblioteke.
U 9.3 poboljšana je performansa PostgreSQL-a pri radu s memorijom i odustalo se od system 5 metode alociranja memorije. Svi su se obradovali, jer inače, ako pokušate pokrenuti dva instanca PostgreSQL-a na jednoj mašini, on će vam reći da nema dovoljno deljene memorije. I kaže da treba da ispravite sysctl. A tamo takav sysctl da morate dodatno restartovati itd. U svakom slučaju, svi su se obradovali. Ali alociranje memorije mmap je pokvarilo korišćenje huge pages. Većina naših klijenata koristi velike deljene baferi. I snažno smo preporučili da ne pređu na 9.3, jer je overhead počinjao da se računa u dobrim procentima.
Ali su zato zajednice obratile pažnju na ovaj problem i u 9.4 su vrlo dobro preradili ovo pitanje. I u 9.4 se pojavio parametar u postgresql.conf, u kojem možete uključiti try, on ili off.
Try – najbezbedniji parametar. Kada se PostgreSQL pokrene, dok alocira deljenu memoriju, pokušava da uzme iz huge pages tu memoriju. I ako to ne uspe, vraća se na običnu alokaciju. I ako imate FreeBSD ili Solaris, možete staviti try, to je uvek bezbedno.
Ako je on, onda jednostavno neće startovati ako ne može da alocira iz huge pages. Tu već – kome i šta je draže. Ali ako imate try, onda proverite da li je ono što vam je zaista potrebno alocirano, jer prostor za grešku je tu veliki. Sada ova funkcionalnost radi samo na Linux-u.
Još jedna mala napomena pre nego što nastavimo. Transparent huge pages nisu trenutno primenljive na PostgreSQL. On ih ne može iskoristiti na pravi način. I kada su u pitanju Transparent huge pages, prednosti se javljaju samo pri veoma velikim količinama podataka, kada je potrebno mnogo zajedničke memorije. Ako imate terabajte memorije, onda to može imati značaj. Ako govorimo o svakodnevnim primenama, kada na mašini imate 32, 64, 128, 256 GB memorije, tada su obični huge pages u redu, a Transparent se jednostavno isključuje.
I poslednja stvar koja se tiče memorije nije direktno povezana sa propusnošću, ali može jako pokvariti situaciju. Cela propusnost će ozbiljno trpeti zbog toga što server stalno prelazi u swap.
I to će biti veoma neprijatno u više situacija. Glavna neprijatnost leži u tome što se ponašanje u savremenim kernelima pomalo razlikuje od starijih Linux kernela. I ovo je stvar na koju je prilično neprijatno naleteti, jer kada govorimo o radu sa swap-om, najčešće dovodi do neodgovarajućeg delovanja OOM-killera. A OOM-killer koji nije na vreme intervenisao i odjednom isključio PostgreSQL je veoma neprijatno. Svi će o tome znati, tj. sve do poslednjeg korisnika.
Šta se dešava? Imate puno оперативne memorije, sve dobro funkcioniše. Ali avaj, server se zaglavljuje u swap-u i usporava zbog toga. Činilo bi se da je memorije dovoljno, ali tako se događa.
Ranije smo savetovali da se vm.swappiness postavi na nulu, tj. da se swap isključi. Nekada se smatralo da je 32 GB оперативne memorije i odgovarajući zajednički baferi ogroman kapacitet. Osnovna svrha swap-a je da bude mesto gde se može odložiti proces ako naiđe na problem. A to više nije tako efikasno. I šta ćeš nakon toga raditi sa tim procesom? To je već zadatak gde nije baš jasno zašto je swap potreban, naročito u ovakvim količinama.
Međutim, u modernijim, tj. trećim verzijama jezgra, ponašanje se promenilo. Ako postavite swap na nulu, tj. isključite ga, pre ili kasnije, čak i uz preostalu količinu RAM-a, doći će vam OOM-killer da ubije najintenzivnije potrošače. Jer će smatrati da pri takvom opterećenju imamo još malo i da ćemo iskočiti, tj. da ne treba ubijati sistemski proces, već nešto manje važno. To manje važno biće intenzivni potrošač deljene memorije, a to je postmaster. Nakon toga, dobro će biti ako nećete morati da obnavljate bazu podataka.
Zato sada, koliko se sećam, većina distribucija podrazumevano postavlja na negde oko 6, tj. u kojem trenutku početi koristiti swap u zavisnosti od preostale memorije. Trenutno savetujemo da postavite vm.swappiness = 1, jer to praktično isključuje swap, ali ne donosi efekte kao kada iznenada dođe OOM-killer i sve to ubije.
Šta dalje? Kada govorimo o performansama baza podataka i postupno se približavamo diskovima, svi se hvataju za glavu. Jer istina da je disk spor a memorija brza poznata je svima od malih nogu. Svi znaju da će se u bazi podataka pojaviti problemi sa performansama diska.
Glavni problem sa performansama PostgreSQL-a, povezan sa spikes checkpoint-a, ne nastaje zbog sporog diska. To je više zbog neusaglašenosti propusnosti memorije i diska. Pri tome, oni mogu biti neusaglašeni na različitim mestima. PostgreSQL nije podešen, operativni sistem nije podešen, hardver nije podešen i hardver nije ispravan. Ovaj problem se ne javlja samo kada sve ide kako treba, tj. ili nema opterećenja, ili su podešavanja i hardver dobro odabrani.
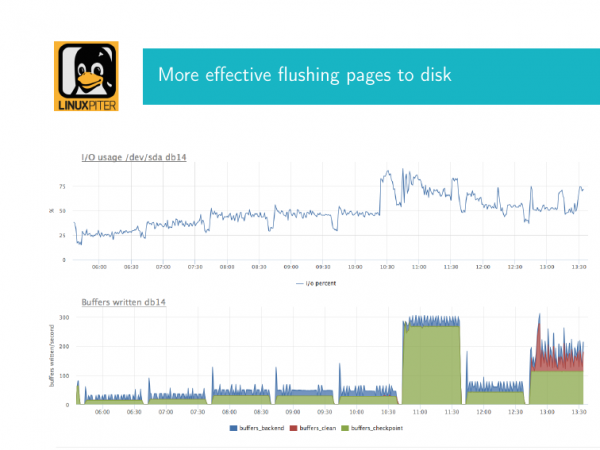
Šta je to i kako to izgleda? Obično ljudi koji rade sa PostgreSQL-om učestvuju u ovome više puta. Objasniću. Kao što sam rekao, PostgreSQL povremeno pravi checkpoints kako bi prljave stranice u zajedničkoj memoriji snimio na disk. Ako imamo veliki obim zajedničke memorije, checkpoint počinje intenzivno uticati na disk, jer snima te stranice pomoću fsync-a. One dolaze u kernel buffer i pišu se na disk koristeći fsync. I ako je ovaj obim veliki, možemo primetiti neprijatan efekat, posebno veoma veliku ugroženost diskova.
Ovde imam dve slike. Sada ću objasniti šta je to. To su dva vremenski korelirana grafikona. Prvi grafikon pokazuje iskorišćenost diska. Ovde dostiže gotovo 90% u ovom trenutku. Ako imate bazu podataka koja je vezana za fizičke diskove, a iskorišćenost RAID kontrolera je 90%, onda su to loše vesti. To znači da će uskoro doći do 100% i ulaz-izlaz će stati.
Ako imate diskovni niz, onda je priča malo drugačija. To zavisi od toga kako je podešen, koji je to niz itd.
A paralelno ovde je konfigurisana grafika iz unutrašnje postgres-vizije, koja prikazuje kako se dešava checkpoint. I ovde je zelenom bojom prikazano koliko je barem prljavih stranica u tom trenutku stiglo na ovaj checkpoint radi sinkronizacije. I to je glavno što ovde treba znati. Vidimo da je mnogo stranica stiglo i u nekom trenutku smo se suočili sa opterećenjem, tj. pisali-pisali, ovde je očigledno diskovni sistem veoma opterećen. I naš checkpoint snažno deluje na disk. U idealu, situacija bi trebala izgledati ovako, tj. da je ovde bilo manje zapisa. Podesivanjima možemo to popraviti da tako bude i dalje. Tj. iskorišćenje je malo, ali pišemo nešto ovde.
Šta treba da uradite da biste prevazišli ovaj problem? Ako vam je IO pod bazom podataka stalo, to znači da će svi korisnici koji dođu izvršavati svoje upite čekati.
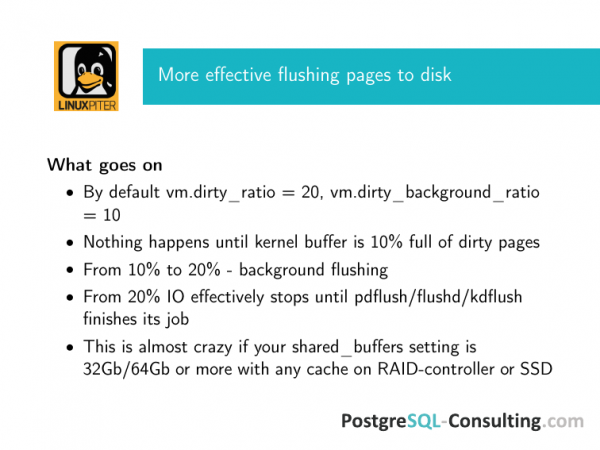
Ako pogledate iz perspektive Linuxa, ako ste uzeli dobar hardver, pravilno ga podesili, i normalno podesili PostgreSQL da rjeđe obavlja te checkpoint-ove, raspoređujući ih kroz vrijeme jedni između drugih, tada se vraćate na podrazumijevane parametre Debiana. Za većinu Linux distribucija slika izgleda ovako: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
Šta to znači? Sa jezgre 2.6 pojavio se jedan demon za pražnjenje. Pdglush, u zavisnosti od onoga ko koji koristi, se bavi pozadinskim pražnjenjem prljavih stranica iz kernel buffer-a i pražnjenjem kada god to treba, bez obzira na sve, prljavih stranica kada pozadinsko pražnjenje ne pomaže.
Kada počinje pozadina? Kada je 10 % od ukupne operativne memorije na serveru zauzeto prljavim stranicama u kernel buffer-u, poziva se posebna funkcija za pražnjenje u pozadini. Zašto je ona pozadinska? Ona kao parametar uzima koliko stranica da izbaci. I, na primjer, izbaci N stranica. I na neko vrijeme ta stvar zaspi. A onda se ponovo budi i izbaci još neki broj stranica.
To je izuzetno jednostavna priča. Ovdje je zadaća kao s bazenom, kada se u jednu cijev izlijeva, a u drugu ulijeva. Došao je checkpoint i ako je malo prljavih stranica poslao na pražnjenje, tada će se polako iz kernel buffer-a pgflush ovo sve uredno razliti.
Ako se nastavljaju gomilati te prljave stranice, oni se nakupljaju do 20 %, nakon čega je prioritet OS-a da ih izbaci na disk, jer će se struja isključiti i sve će biti loše. Izgubićemo te podatke, na primjer.
U čemu je trik? Trik je u tome što su ti parametri u savremenom svijetu 20 i 10 % od ukupne operativne memorije koja je dostupna na mašini, potpuno monstruozni sa stanovišta propusnosti bilo kojeg diska koji imate.
Zamislite da imate 128 GB operativne memorije. 12,8 GB dolazi do vašeg disk sistema. I kakav god keš da imate ili kakav god niz da imate, oni to neće izdržati.
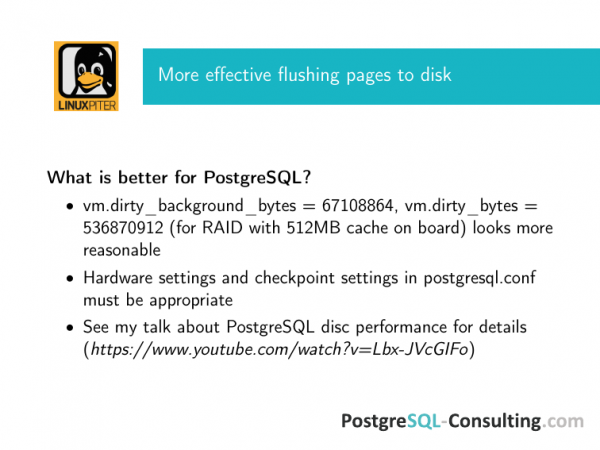
Zato preporučujemo da odmah podesite te brojke prema mogućnostima vašeg RAID kontrolera. Odmah ovdje dajem preporuku za kontroler koji ima 512 MB keša.
Sve to izgleda vrlo jednostavno. Možete postaviti vm.dirty_background u bajtima. Ove postavke poništavaju prethodne dve. Ili će raditi podrazumevani odnos, ili aktivirane one koje su u bajtima. Ali pošto sam DBA konsultant i radim sa raznim klijentima, trudim se da budem oprezan, pa ako se radi u bajtima, onda u bajtima. Niko nije dao nikakvu garanciju da dobar administrator ne će dodati RAM serveru, ne će ga restartovati, a brojka će ostati ista. Samo izračunajte ove brojke kako bi sa sigurnošću sve stalo.
Šta će se desiti ako ne stignete? Imam zapisano da se efikasno zaustavlja svaki flushing, ali zapravo je to figura govora. Operativni sistem ima veliki problem – mnogo prljavih stranica, zato se efikasno zaustavlja taj IO koji generišu vaši klijenti, tj. aplikacija šalje SQL upit bazi, ona čeka. Svaki unos-izlaz u nju ima najniži prioritet, jer je baza zauzeta checkpoint-om. A kada će ga završiti je potpuno nejasno. Kada dostignete ne pozadinsko, ne background flushing, to znači da je sav vaš IO njime zauzet. I sve dok to ne završi, ne možete ništa uraditi.
Ovde postoje još dva važna momenta koja nadilaze ovu prezentaciju. Ove postavke moraju da odgovaraju postavkama u postgresql.conf, tj. postavkama checkpoints. I vaš diskovni sistem treba biti adekvatno podešen. Ako imate keš na RAID-u, na njemu treba biti baterija. Ljudi kupuju RAID sa dobrim kešom bez baterije. Ako imate SSD u RAID-u, oni moraju biti serverski, tamo moraju biti kondenzatori. Ovde je detaljan kontrolni spisak. Na ovom linku možete pronaći moju prezentaciju o tome kako podesiti disk performanse u PostgreSQL-u. Sve ove kontrolne liste su navedene.
Šta još može u velikoj meri zakomplikovati život? To su dva parametra. Oni su relativno novi. Po defaultu mogu biti uključeni u raznim aplikacijama. I mogu zakomplikovati život ništa manje, ako su pogrešno uključeni.
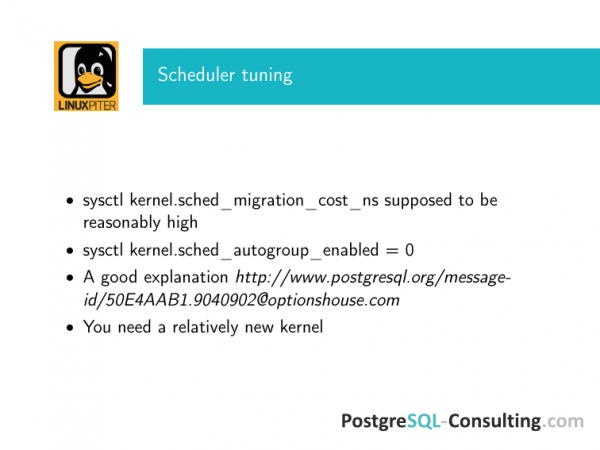
Postoje dve relativno nove stvari. One su se već pojavile u trećim jezgrom. To su sched_migration_cost u nanosekundama i sched_autogroup_enabled, koji je po defaultu uključen.
Kako oni kvare život? Šta je sched_migration_cost? Linux scheduler može migrirati proces s jednog CPU-a na drugi. Za PostgreSQL, koji izvršava upite, migracija na drugi CPU potpuno je nelogična. Sa stanovišta operativnog sistema, kada prebacujete prozore između openoffice-a i terminala, to može biti dobro, ali za bazu podataka - to je veoma loše. Stoga je razborita politika postaviti migration_cost na neku visoku vrednost, barem nekoliko hiljada nanosekundi.
Šta će to značiti za scheduler? Smatrat će da je tokom ovog vremena taj proces još uvek vruć. Tj. ako imate neku dugu transakciju koja se nečim dugo bavi, scheduler će to razumeti. Tako će smatrati da dok ne prođe ovaj tajmer, migracija ovog procesa nije potrebna. Ako proces radi nešto, neće biti migriran, već će mirno završiti na CPU-u koji mu je dodeljen. I rezultat je odličan.
Druga stvar - to je autogroup. Dobra ideja za specifične workload-e koji nemaju veze sa savremenim bazama podataka je grupisanje procesa prema virtualnom terminalu sa kojeg su pokrenuti. To je zgodno za neke zadatke. U praksi, PostgreSQL je višekorisnička sistema sa prefork-om, koja se pokreće iz jednog terminala. Imate lock writer, checkpoint i svi vaši klijentski upiti grupisaće se na jednog scheduler-a, na jedan CPU. I čekat će da se oslobodi, da ne ometaju jedni druge i da zauzmu duže vreme na njemu. Ova priča apsolutno nije potrebna sa ovakvim opterećenjem i stoga to treba isključiti.
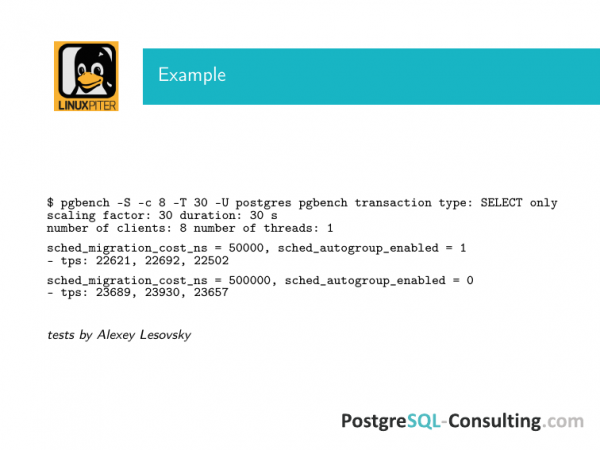
Moj kolega Aleksej Lesovski je radio testove sa jednostavnim pgbench-om, gde je povećavao migration_cost za red veličine i isključivao autogroup. Razlika na lošem hardveru bila je skoro 10 %. Postoji diskusija na postgres-ovoj mailing listi, gde ljudi daju rezultate kako su takve promene uticale na brzinu upita za 50 %. Takvih priča ima mnogo.
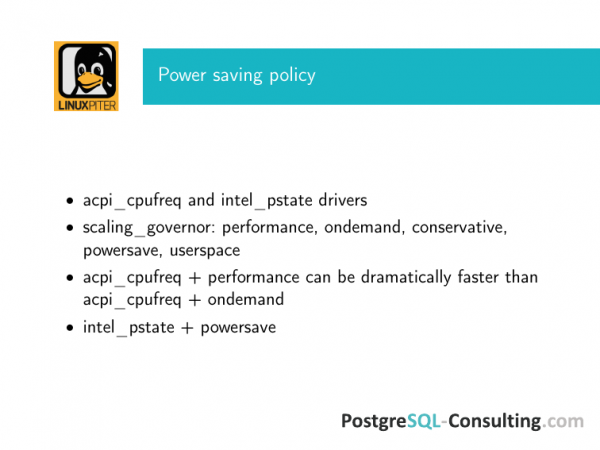
I na kraju, o politici uštede energije. Dobro je što sada Linux može da se koristi na laptopu. I navodno će dobro trošiti bateriju. Ali iznenada se otkriva da to može da bude slučaj i na serveru.
Štaviše, ako iznajmljujete servere od nekog hosting provajdera, onda su "dobri" hosting provajderi ne brinu se o tome da vam pruže bolju performansu. Njihov zadatak je da maksimalno efikasno iskoriste svoje hardverske resurse. Stoga, mogu prema zadanim postavkama uključiti režim štednje energije za laptop na operativnom sistemu.
Ako koristite ovo čudo na serveru sa bazom podataka pod intenzivnim opterećenjem, onda je vaš izbor acpi_cpufreq + performance. Čak i sa ondemandom će već biti problema.
Intel_pstate je već malo drugačiji drajver. I sada se daje prednost ovom, jer je noviji i bolje funkcioniše.
I, shodno tome, governor bi trebao biti samo performance. Ondemand, powersave i sve ostalo – to nije za vas.
Rezultati iz explain analyze PostgreSQL mogu se razlikovati za nekoliko redova veličine ako uključite powersave, jer će CPU pod vašom bazom raditi na potpuno nepredvidiv način.
Ove stvari mogu biti uključene prema zadanim postavkama. Pažljivo pogledajte – da li su slučajno uključene po zadatku. Ovo može predstavljati veliki problem.
Na kraju, želeo bih da se zahvalim momcima iz našeg DBA tima PosgreSQL-Consulting, posebno Maksu Boguiku i Alekseju Lesovskom, koji se svakog dana suočavaju s izazovima. Trudimo se da za naše klijente obezbedimo najbolju moguću funkcionalnost. Ovdje je kao sa uputstvima za avio bezbednost. Sve je napisano krvlju. Svaka od ovih vijaka otkrivena je tokom nekog problema. Rado ih delim s vama.
Pitanja:
Hvala! Ako, na primer, kompanija želi da štedi i postavi bazu podataka i aplikacionu logiku na jednom serveru, ili ako kompanija prati modernu tendenciju mikroservisnih arhitektura gde se PostgreSQL pokreće u kontejneru. U čemu je stvar? Sysctl globalno utiče na sve jezgri. Nisa čuo da se sysctl na neki način virtuelizuje, da radi odvojeno u kontejneru. Postoji samo cgroup i tamo samo prema delu postoji kontrola. Kako sa tim može da se živi? Ili ako želite performansu, pokrenite PostgreSQL na odvojenom hardverskom serveru i optimizujte ga?
Odgovorili smo na vaše pitanje na prilike tri načina. Ako se ne radi o fizičkom serveru koji možete tune-ovati itd., opustite se, sve će raditi dobro bez tih podešavanja. Ako imate opterećenje zbog kojeg bi trebalo napraviti ova podešavanja, do fizičkog servera ćete doći pre nego što se upustite u ova podešavanja.
Koji je problem? Ako je ovo virtuelni server, verovatno ćete se suočavati sa mnogim problemima, na primer, s time što većina virtuelnih servera ima prilično nekonzistentne latencije diska. Čak i ako je propusnost diskova dobra, jedna neispravna transakcija operacija ulaza-izlaza, koja ne utiče mnogo na prosečnu propusnost, koja se dogodila u trenutku checkpoint-a ili pri zapisivanju u WAL, može značajno uticati na bazu podataka. I to ćete primetiti pre nego što upadnete u ove probleme.
Ako imate NGINX na istom serveru, također ćete imati isti problem. Borit će se za deljenu memoriju. I do problematike opisanih ovde nećete doći.
S druge strane, neki od ovih parametara će vam i dalje biti relevantni. Na primer, sa sysctl postavite dirty_ratio da ne bude tako ekstreman – to će, u svakom slučaju, pomoći. U svakom slučaju, imaćete interakciju s diskom. I ona će biti po pogrešnom obrascu. To su zapravo zadani parametri koje sam pokazao. I u svakom slučaju, bolje ih je promeniti.
S NUMA mogu biti problemi. VmWare, na primer, dobro radi s NUMA sa potpuno suprotnim podešavanjima. I ovde treba birati – fizički server ili ne.
Imam pitanje vezano za Amazon AWS. Imaju unapred podešene slike. Jedna od njih se zove Amazon RDS. Da li postoje neka prilagođena podešavanja za njihov operativni sistem?
Postoje podešavanja, ali to su druga podešavanja. Ovde podešavamo operativni sistem iz perspektive kako će ga baza podataka koristiti. A tamo postoje parametri koji određuju naš trenutni pravac, ovakvo oblikovanje. Odnosno, potrebni su nam resursi i sada ćemo ih trošiti. Nakon toga, Amazon RDS ove resurse priključuje, i tamo performanse opadaju. Ima posebno priča kako ljudi počinju sa tim da eksperimentišu. Ponekad čak i vrlo uspešno. No, to nema veze s podešavanjima OS-a. To je zapravo hakovanje oblaka. To je druga priča.
Zašto Transparent huge pages ne daju efekta u poređenju sa Huge TLB?
Ne daju. Ovo se može objasniti na mnogo načina. Ali, u suštini, jednostavno ne daju efekat. Kakva je priča sa PostgreSQL? On prilikom pokretanja dodeljuje veliki deo shared memory. Da li su Transparent ili ne-transparent – to uopšte nije važno. Činjenica da se dodeljuju prilikom pokretanja objašnjava sve. Ako ima mnogo memorije i potrebno je ponovo konstruisati shared_memory segment, onda će Transparent huge pages biti relevantni. U PostgreSQL-u je jednostavno na početku dodeljen ogroman deo i to je to; kasnije se ništa posebno ne dešava. Naravno, može se koristiti, ali postoji šansa da dođe do curruption shared_memory kada bude ponovo dodeljivao nešto. PostgreSQL zapravo nije upoznat s tim.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish