

Godine 2018. u profesionalnim krugovima i na tematskim konferencijama posvećenim AI-u, pojam MLOps je postao sve prisutniji i brzo se učvrstio u industriji, a sada se razvija kao samostalna disciplina. U budućnosti bi MLOps mogao postati jedno od najtraženijih područja u IT-u. Šta je to zapravo i kako se koristi, razjasnićemo ispod.
Šta je MLOps
MLOps (spajanje tehnologija i procesa mašinskog učenja i pristupa uvođenju razvijenih modela u poslovne procese) je novi način saradnje između predstavnika biznisa, naučnika, matematičara, stručnjaka za mašinsko učenje i IT inženjera u stvaranju sistema veštačke inteligencije.
Drugim rečima, to je način pretvaranja metoda i tehnologija mašinskog učenja u korisni alat za rešavanje poslovnih zadataka.
Treba shvatiti da lanac produktivizacije počinje mnogo pre nego što se model razvije. Prvi korak je definisanje poslovnog zadatka, hipoteza o vrednosti koju je moguće izvući iz podataka, i poslovne ideje o njenoj primeni.
Sam pojam MLOps je nastao kao analogija pojmu DevOps u vezi sa modelima i tehnologijama mašinskog učenja. DevOps je pristup razvoju softvera koji omogućava povećanje brzine implementacije pojedinačnih izmena uz očuvanje fleksibilnosti i pouzdanosti kroz niz pristupa, među kojima su kontinuirani razvoj, deljenje funkcionalnosti na niz nezavisnih mikroservisa, automatizovano testiranje i implementacija pojedinačnih izmena, globalno praćenje funkcionalnosti, sistem hitnog reagovanja na uočene greške i drugi.
DevOps je definisao životni ciklus softvera i u zajednici stručnjaka je naišla ideja da se ista metodologija primeni na velike podatke. DataOps je pokušaj da se metodologija adaptira i proširi uzimajući u obzir karakteristike skladištenja, prenosa i obrade velikih količina podataka na raznolikim, međusobno povezanim platformama.
S pojavom određene kritične mase modela mašinskog učenja implementiranih u poslovne procese preduzeća, primjećena su jaka sličnost između životnog ciklusa matematičkih modela mašinskog učenja i životnog ciklusa softvera. Razlika leži samo u tome da se algoritmi modela stvaraju koristeći alate i metode mašinskog učenja. Stoga je prirodno došla ideja da se primijene i prilagode već poznati pristupi razvoju softvera za modele mašinskog učenja. Tako se u životnom ciklusu modela mašinskog učenja mogu izdvojiti sljedeće ključne faze:
- definisanje poslovne ideje;
- obuka modela;
- testiranje i implementacija modela u poslovni proces;
- upotreba modela.
Kada se tokom upotrebe pojavi potreba za promenom ili dotreningom modela na novim podacima, ciklus se ponovo pokreće — model se dopunjuje, testira, i implementira nova verzija.
Odstupanje. Zašto dopuniti, a ne re-obučiti? Termin „re-obuka modela“ ima dvostruko značenje: među stručnjacima označava defekt modela, kada model dobro predviđa, zapravo ponavlja predviđeni parametar na obučavanju uzorku, ali mnogo lošije funkcioniše na eksternom uzorku podataka. Prirodno, takav model je manjkav, pošto ta greška ne omogućava njegovu upotrebu.
U ovom životnom ciklusu izgleda logično koristiti DevOps alate: automatizovano testiranje, implementaciju i monitoring, formalizaciju izračunavanja modela u obliku pojedinačnih mikroservisa. No, postoje i određene karakteristike koje sprečavaju direktnu primenu ovih alata bez dodatne ML infrastrukture.
Kako natjerati modele da rade i donose profit
Kao primer na kojem ćemo demonstrirati primenu pristupa MLOps, uzmimo klasičan zadatak robotizacije četa podrške za bankarski (ili neki drugi) proizvod. Obično poslovni proces podrške putem četa izgleda ovako: klijent unosi poruku sa pitanjem u četu i dobija odgovor stručnjaka u okviru unapred definisanog stabla dijaloga. Automatsko rešavanje ovog četa obično se postiže putem ekspertski definiranih setova pravila, što je veoma zahtevno za razvoj i održavanje. Efikasnost takve automatizacije, u zavisnosti od složenosti zadatka, može biti 20–30%. Naravno, javlja se ideja da je profitabilnije implementirati modul veštačke inteligencije — model razvijen uz pomoć mašinskog učenja koji:
- može obraditi veći broj zahteva bez učešća operatera (u zavisnosti od teme, u nekim slučajevima efikasnost može dostizati 70–80%);
- bolje se prilagođava nestandardnim formulacijama u dijalogu — ume da odredi nameru, stvarnu želju korisnika prema neprecizno postavljenom zahtevu;
- može da odredi kada je odgovor modela adekvatan, a kada postoje sumnje u „svesnost“ tog odgovora i potrebno je postaviti dodatno pojašnjavajuće pitanje ili prebaciti se na operatera;
- može biti dodatno obučena automatizovano (umesto grupe programera koja stalno prilagođava i ispravlja scenarije odgovora, model dodatno obučava stručnjak za Data Science koristeći odgovarajuće biblioteke mašinskog učenja).
Kako učiniti da ovakav napredni model radi?
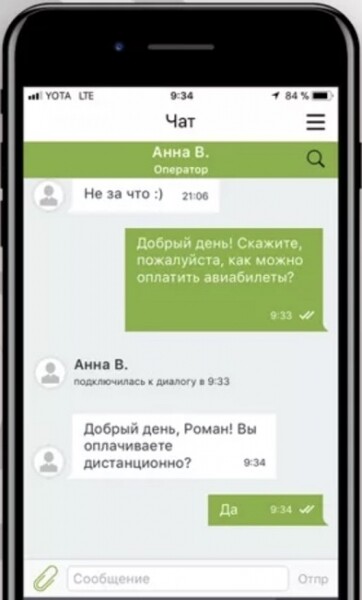
Kao i pri rešavanju bilo kojeg drugog zadatka, pre nego što razvijemo takav modul, potrebno je definisati poslovni proces i formalno opisati konkretan zadatak koji ćemo rešavati primenom metoda mašinskog učenja. Na ovoj tački počinje proces operativizacije, označen akronimom Ops.
Sljedeći korak stručnjaka za Data science u suradnji s inženjerom podataka je provjera dostupnosti i dovoljne količine podataka, kao i poslovne hipoteze o održivosti poslovne ideje. Oni razvijaju prototip modela i testiraju njegovu stvarnu učinkovitost. Tek nakon potvrde od strane poslovanja može početi prelaženje s razvoja modela na njegovu integraciju u sustave koji izvode konkretne poslovne procese. Planiranje implementacije, duboko razumijevanje kako će se model koristiti na svakom koraku i koji će ekonomski učinak donijeti, ključni su u procesima implementacije MLOps-a u tehnološki pejzaž tvrtke.
S razvojem tehnologije umjetne inteligencije, broj i raznolikost zadataka koji se mogu riješiti putem strojno učenja dramatično se povećava. Svaki takav poslovni proces predstavlja uštedu za tvrtku kroz automatizaciju rada zaposlenika na masovnim pozicijama (call centar, provjera i sortiranje dokumenata itd.), širenje baze klijenata dodavanjem novih atraktivnih i praktičnih funkcija, uštedu sredstava optimalnom raspodjelom resursa i još mnogo toga. Na kraju, svaki proces ima cilj stvaranje vrijednosti i, posljedično, treba donositi određeni ekonomski učinak. Ovdje je jako važno jasno formulirati poslovnu ideju i izračunati očekivanu dobit od implementacije modela unutar ukupne strukture stvaranja vrijednosti tvrtke. Događaju se situacije kada implementacija modela ne opravdava očekivanja, a vrijeme koje su stručnjaci za strojno učenje proveli na tome košta značajno više od radnog mjesta operatera koji obavlja tu zadaću. Zbog toga je važno takve slučajeve pokušati uočiti već u ranim fazama stvaranja sustava umjetne inteligencije.
Stoga, profit modela počinje se ostvarivati tek kada je u procesu MLOps-a ispravno definirana poslovna zadaća, postavljeni prioriteti i na ranim fazama razvoja formuliran proces implementacije modela u sustav.
Novi proces - novi izazovi
Sveobuhvatan odgovor na suštinsko pitanje poslovanja o tome koliko su ML modeli primjenjivi za rješavanje zadataka i opštenito pitanje povjerenja u AI — jedan je od ključnih izazova u procesu razvoja i implementacije MLOps pristupa. Na početku, poslovanje skeptično gleda na uvođenje mašinskog učenja u procese — teško je osloniti se na modele u područjima gdje su ranije obično radili ljudi. Za poslovanje, programi se prikazuju kao 'crna kutija', čija relevantnost odgovora još treba biti dokazana. Pored toga, u bankarskom sektoru, sektoru telekomunikacija i drugim, postoje strogi zahtjevi državnih regulatora. Svi sistemi i algoritmi koji su implementirani u bankarske procese podliježu reviziji. Da bi se riješio ovaj problem i dokazali poslovanju i regulatorima opravdanost i tačnost odgovora veštačke inteligencije, zajedno s modelom implementiraju se alati za monitoring. Pored toga, postoji procedura nezavisne validacije, obavezna za regulatorne modele, koja ispunjava zahtjeve Centralne banke. Nezavisna ekspertska grupa vrši reviziju rezultata dobijenih modelom uzimajući u obzir ulazne podatke.
Drugi izazov — procjena i upravljanje modelnim rizicima prilikom implementacije modela mašinskog učenja. Ako čak ni ljudi ne mogu sa stopostotnom sigurnošću odgovoriti na pitanje da li je haljina bila bela ili plava, onda veštačka inteligencija takođe ima pravo na grešku. Takođe treba uzeti u obzir da se podaci tokom vremena mogu menjati, a modelima je potrebno dodatno učenje kako bi davali dovoljno tačne rezultate. Da bi poslovni proces ostao neometan, potrebno je upravljati modelnim rizicima i pratiti rad modela, redovno ga dodatno obučavajući na novim podacima.
No, nakon prve faze nepovjerenja počinje se javljati suprotan efekat. Što više modela uspešno integriše u procese, to više raste apetit poslovanja za korišćenje veštačke inteligencije — pojavljuju se novi i novi zadaci koji se mogu rešavati metodama mašinskog učenja. Svaki zadatak pokreće ceo proces koji zahteva određene kompetencije:
- data inženjeri pripremaju i obrađuju podatke;
- data naučnici primenjuju alate mašinskog učenja i razvijaju model;
- IT implementira model u sistem;
- ML inženjer definira kako pravilno integrirati ovaj model u proces, koji IT alati koristiti u zavisnosti od zahtjeva za režim primjene modela, uzimajući u obzir broj zahtjeva, vrijeme odgovora itd.
- ML arhitekta projektuje kako fizički realizovati softverski proizvod u industrijskom sistemu.
Cijeli ciklus zahtijeva veliki broj visoko kvalifikovanih stručnjaka. U određenoj tački razvoja i stepen penetracije ML modela u poslovne procese, postaje jasno da linearno povećavanje broja stručnjaka proporcionalno rastu broja zadataka postaje skupo i neefikasno. Stoga se postavlja pitanje automatizacije procesa MLOps — definiranje nekoliko standardnih klasa zadataka mašinskog učenja, razvoj tipičnih pipeline-ova za obradu podataka i dodatno obučavanje modela. U idealnoj situaciji za rješavanje takvih zadataka potrebni su stručnjaci koji podjednako dobro posjeduju kompetencije na sjecištu Big Data, Data Science-a, DevOps-a i IT-a. Stoga je najveći problem u sektoru Data Science i najveći izazov pri organizaciji procesa MLOps — nedostatak takvih kompetencija na postojećem tržištu rada. Stručnjaci koji ispunjavaju takve zahtjeve trenutno su rijetkost na tržištu rada i cijene se kao zlato.
O pitanjima kompetencija
U teoriji, sve MLOps zadatke moguće je rješavati klasičnim DevOps alatima, bez potrebe za specijalizovanim proširenjem uloge. Kao što smo već spomenuli, data scientist ne smije biti samo matematičar i stručnjak za analitiku podataka, već i guru čitavog pipeline-a — na njemu leži odgovornost za razvoj arhitekture, programiranje modela na više jezika u zavisnosti od arhitekture, pripremu izlog podataka i implementaciju same aplikacije. Međutim, kreiranje tehnološke infrastrukture koja se realizuje u i kroz proces MLOps, zauzima do 80% radnog vremena, što znači da kvalifikovani matematičar, koji je kvalitetan Data Scientist, provodi samo 20% svog vremena posvećenog svojoj specijalnosti. Stoga postaje neophodno razdvojiti uloge stručnjaka koji sprovode proces implementacije modela mašinskog učenja.
Koliko detaljno treba da budu razdvojene uloge zavisi od razmera preduzeća. Jedna je stvar kada u startup-u postoji jedan stručnjak, radnik sa rezervom energije, koji je ujedno i inženjer, arhitekta i DevOps. Sasvim je druga stvar kada su u velikom preduzeću svi procesi razvoja modela koncentrisani na nekoliko visoko kvalifikovanih stručnjaka za Data Science, dok programer ili stručnjak za baze podataka - mnogo je prisutnija i jeftinija kompetencija na tržištu rada - može preuzeti veći deo rutinskih zadataka.
Dakle, gde prelazi granica u izboru stručnjaka za obezbeđivanje procesa MLOps i kako je organizovan proces operacionalizacije razvijenih modela, direktno utiče na brzinu i kvalitet razvijenih modela, produktivnost tima i mikroklimat u njemu.
Šta je već sada urađeno od naše strane
Nedavno smo počeli da gradimo strukturu kompetencija i procese MLOps. Ali već se u fazi testiranja MVP nalaze naši projekti za upravljanje životnim ciklusom modela i primenu modela kao usluge.
Takođe smo odredili optimalnu strukturu kompetencija i organizacionu strukturu interakcije između svih učesnika procesa za veliko preduzeće. Organizovane su Agile ekipe koje rešavaju zadatke za ceo spektar poslovnih klijenata, kao i uspostavljen je proces interakcije sa projektnim timovima za izgradnju platformi i infrastrukture koja čini temelj izgrađenog MLOps sistema.
Pitanja za budućnost
MLOps je razvijajući se pravac koji pati od nedostatka kompetencija i u budućnosti će dobiti na zamahu. A za sada je najbolje osloniti se na rad i prakse DevOps. Osnovni cilj MLOps je efikasnije korišćenje ML modela za rešavanje poslovnih zadataka. Međutim, javljaju se mnogobrojna pitanja:
- Kako skratiti vreme potrebno za pokretanje modela u proizvodnju?
- Kako smanjiti birokratske otpore između timova različitih kompetencija i povećati fokus na saradnju?
- Kako pratiti modele, upravljati verzijama i organizovati efikasan monitoring?
- Kako stvoriti zaista ciklični životni ciklus za savremeni ML model?
- Kako standardizovati proces mašinskog učenja?
Od odgovora na ova pitanja u velikoj meri zavisi koliko brzo će MLOps ostvariti svoj pun potencijal.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish