

Analitička OLAP baza podataka ClickHouse obrađuje mnoge različite stringove, trošeći resurse. Kako bi se ubrzao rad sistema, neprekidno se dodaju nove optimizacije. Razvijač ClickHouse-a Nikolaj Kočetov objašnjava o string tipovima podataka, uključujući novi tip, LowCardinality, i kako se može ubrzati rad sa stringovima.
— Prvo, hajde da razjasnimo kako možemo skladištiti stringove.
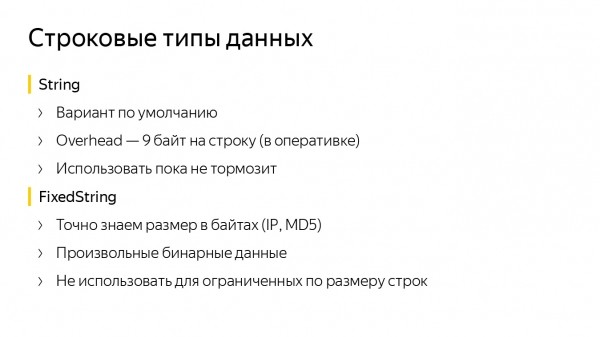
Imamo string tipove podataka. String je dobar izbor po defaultu, trebali bismo ga koristiti skoro uvijek. Ima mali overhead — 9 bajtova po stringu. Ako želimo da veličina stringova bude fiksna i unaprijed poznata, bolje je koristiti FixedString. U njemu možemo odrediti željeni broj bajtova, što je praktično za podatke tipa IP adrese ili hash funkcije.
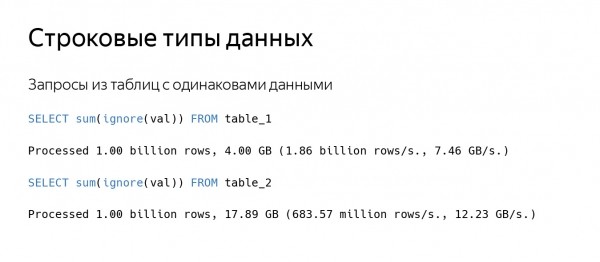
Naravno, ponekad nešto usporava. Recimo, pravite upit prema tabeli. ClickHouse čita prilično veliku količinu podataka, recimo, brzinom od 100 GB/s, dok se obradjuje malo stringova. Imamo dve tabele koje čuvaju skoro iste podatke. Iz druge tabele ClickHouse čita podatke većom brzinom, ali se brojevi stringova čitaju tri puta sporije.
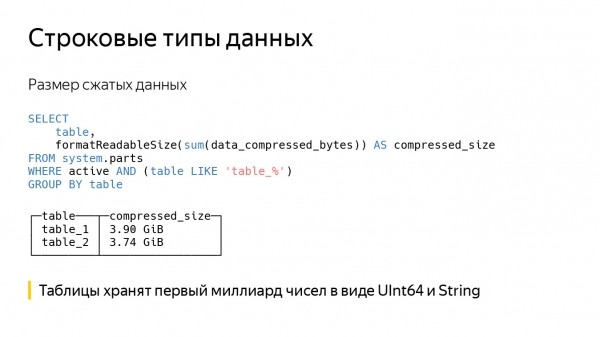
Ako pogledamo veličinu komprimovanih podataka, otkrićemo da je skoro jednaka. U stvari su u tabelama zapisani isti podaci — prvi milijard brojeva — samo su u prvom stubcu zapisani kao UInt64, dok su u drugom kao String. Zbog toga drugi upit duže čita podatke sa diska i dekompresuje ih.
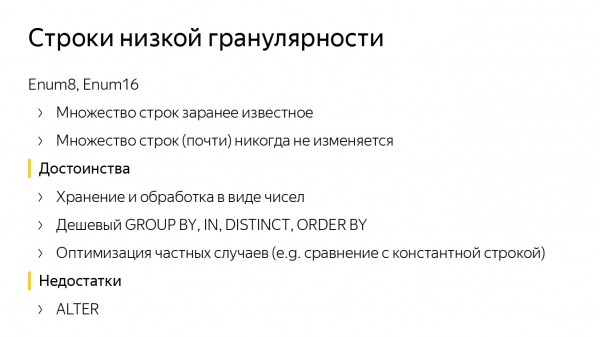
Evo još jednog primera. Pretpostavimo da postoji unaprijed poznati skup stringova, koji je ograničen konstantom od 1000 ili 10 000 i praktično se nikada ne menja. U ovom slučaju nam odgovara tip podataka Enum, u ClickHouse-u postoje dva — Enum8 i Enum16. Zbog skladištenja u Enum-u brzo obrađujemo upite.
U ClickHouse-u postoje optimizacije za GROUP BY, IN, DISTINCT i optimizacije za neke funkcije, kao na primjer za poređenje sa konstantnim stringom. Naravno, brojevi u stringu se ne konvertuju, već se konstantni string pretvara u Enum vrednost. Nakon toga se sve brzo upoređuje.
Ali postoje i nedostaci. Čak i ako znamo tačan skup stringova, ponekad ga treba dopunjavati. Kada stigne novi string — moramo izvršiti ALTER.
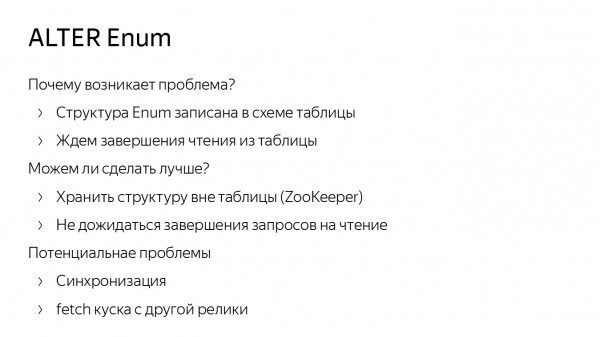
ALTER za Enum u ClickHouse implementiran je optimalno. Ne prepisujemo podatke na disku, ali ALTER može usporavati zbog toga što se strukture Enum čuvaju u šemi same tabele. Stoga moramo čekati na upite za čitanje iz tabele, na primer.
Postavlja se pitanje, može li to biti bolje? Verovatno, da. Može se sačuvati struktura Enum ne u šemi tabele, već u ZooKeeper-u. Međutim, mogu nastati problemi vezani za sinhronizaciju. Na primer, jedna replikacija je dobila podatke, druga nije, i ako ona ima stari Enum, nešto će prestati da funkcioniše. (U ClickHouse skoro smo završili neblokirajuće ALTER upite. Kada ih potpuno završimo, neće biti potrebno čekati na upite za čitanje.)
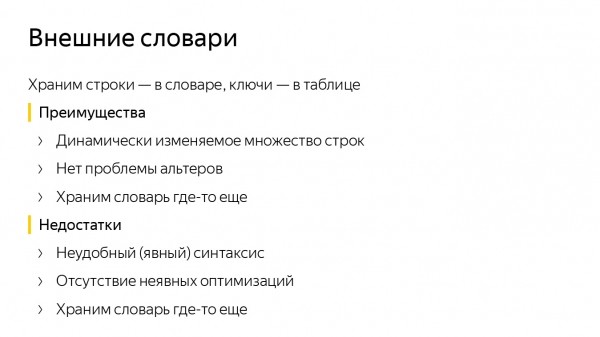
Da bismo izbegli komplikacije sa ALTER Enum, možemo koristiti spoljne rečnike ClickHouse. Podsećam, to je key-value struktura podataka unutar ClickHouse, pomoću koje možemo dobijati podatke iz spoljašnjih izvora, kao što su MySQL tabele.
U rečniku ClickHouse čuvamo mnoštvo različitih stringova, a u tabeli su njihovi identifikatori u obliku brojeva. Ako trebamo dobiti string, pozivamo funkciju dictGet i radimo s njom. Nakon toga ne moramo praviti ALTER. Da bismo nešto dodali u Enum, umetnemo to u istu MySQL tabelu.
Ali tu se javljaju drugi problemi. Prvo, nezgrapan sintaksis. Ako želimo dobiti string, moramo pozvati dictGet. Drugo, nedostatak nekih optimizacija. Upoređivanje sa konstantnim stringom za rečnike ne može se obaviti tako brzo.
Još mogu biti problemi sa ažuriranjem. Pretpostavimo, zatražili smo string u keš-rečniku, a taj string nije stigao u keš. Tada moramo čekati dok se podaci učitaju iz spoljnog izvora.
Opšti nedostatak oba metoda — čuvamo sve ključeve na jednom mestu i sinhronizujemo ih. Zašto ne bismo čuvali rečnike lokalno? Nema sinhronizacije — nema problema. Rečnik se može čuvati lokalno u delu na disku. To jest, napravili smo Insert, zapisali rečnik. Ako radimo sa podacima u memoriji, možemo zapisati rečnik ili u blok podataka, ili u deo kolone, ili u neki keš, kako bismo ubrzali izračunavanja.
Kodiranje stringova u rečnicima
Tako smo došli do stvaranja novog tipa podataka u ClickHouse — LowCardinality. To je format čuvanja podataka: kako se pišu na disk i kako se čitaju, kako su predstavljeni u memoriji i šema njihove obrade.
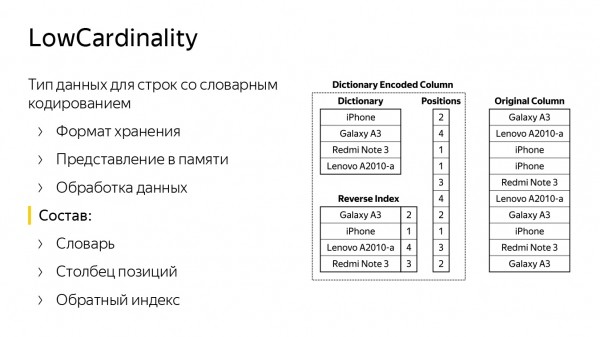
Na slajdu postoje dvije kolone. S desne strane, redovi su sačuvani standardno, kao tip String. Očigledno je da su to neki modeli mobilnih telefona. S lijeve strane postoji identična kolona, samo kao LowCardinality. Sastoji se od rečnika s brojnim različitim redovima (redovi iz kolone s desne strane) i liste pozicija (brojeva redova).
Uz pomoć ovih dviju struktura možemo obnoviti izvorni stubac. Takođe postoji obratni indeks—hash tabela koja pomaže da se po redu nađe pozicija u rečniku. Potrebna je za ubrzanje određenih upita. Na primjer, ako želimo da uporedimo, pretražimo red u našem stubcu ili ih spojimo.
LowCardinality je parametrijski tip podataka. Može biti ili broj, ili nešto što se čuva kao broj, ili string, ili Nullable od njih.
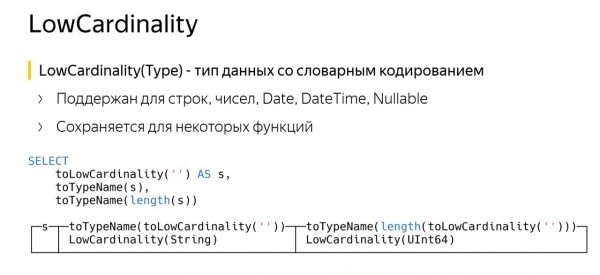
Osobina LowCardinality je ta što se može sačuvati za neke funkcije. Na slajdu je prikazan primer upita. U prvom redu sam kreirao kolonu tipa LowCardinality od String, nazvao je S. Zatim sam pitao njeno ime—ClickHouse je rekao da je to LowCardinality od String. Sve je tačno.
Treći red je gotovo isti, samo smo pozvali funkciju length. U ClickHouse funkcija length vraća tip podataka UInt64. Međutim, kod nas je postao LowCardinality od UInt64. U čemu je poenta?
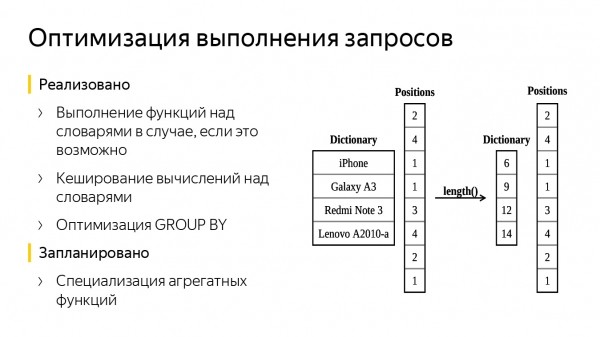
U rečniku su se čuvala imena mobilnih telefona, primenili smo funkciju length. Sada imamo sličan rečnik, koji se sastoji samo od brojeva—to su dužine redova. Stubac s pozicijama se nije promenio. U konačnici smo obradili manje podataka, uštedeli na vremenu upita.
Mogu postojati i druge optimizacije, na primjer dodatak jednostavnog keša. Prilikom izračunavanja vrednosti funkcije, možemo je zapamtiti i sastaviti istu, ne izračunavati ponovo.
Takođe može doći do optimizacije GROUP BY, jer je naš stubac s rečnikom već delimično agregiran—brže se mogu izračunati vrednosti hash funkcija i približno pronaći bucket u koji će se smestiti naredni red. Takođe se mogu specijalizovati neke agregatne funkcije, kao što je uniq, jer u nju možemo poslati samo rečnik, dok pozicije ostavimo netaknute—tako će sve raditi brže. Prve dvije optimizacije smo već dodali u ClickHouse.
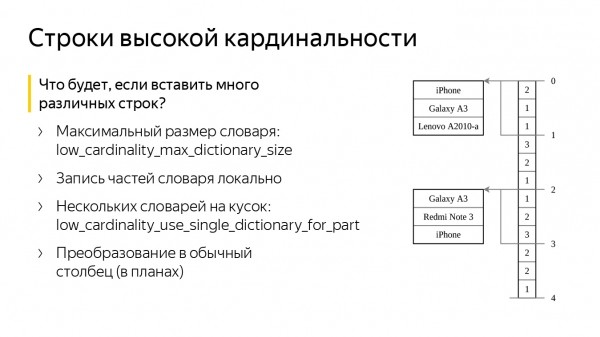
Šta ako stvorimo kolonu s našim tipom podataka i umetnemo u nju mnogo različitih loših redova? Hoće li nam se memorija prepuniti? Ne, za to ClickHouse ima dva posebna podešavanja. Prvo je low_cardinality_max_dictionary_size. To je maksimalna veličina rečnika koja može biti zapisano na disk. Umetanje se odvija ovako: kada umetnemo podatke, dolazi nam tok redova, od kojih formiramo veliki zajednički rečnik. Ako rečnik postane veći od vrednosti podešavanja, zapisujemo trenutni rečnik na disk, a ostale redove - negde „sa strane“, pored indeksa. Na kraju, nikada nećemo prebrojati veliki rečnik i nećemo imati problema s memorijom.
Drugo podešavanje se zove low_cardinality_use_single_dictionary_for_part. Zamislite da smo u prošloj shemi, kada smo umetnuli podatke, naš rečnik prepunio, i zapisali smo ga na disk. Postavlja se pitanje, zašto onda ne bismo formirali još jedan potpuno isti rečnik?
Kada se on preplavi, ponovo ćemo ga zapisati na disk i početi formirati treći. Ovo podešavanje zapravo isključuje tu mogućnost prema zadanim postavkama.
U stvari, mnogo rečnika može biti korisno ako želimo umetnuti neki skup redova, ali slučajno smo umetnuli 'otpatke'. Recimo, prvo smo umetnuli loše redove, a zatim dobre. Tada će se rečnik podeliti na mnogo malih rečnika. Deo njih će biti s 'otpatcima', ali poslednji će biti s dobrim redovima. I ako pročitamo, recimo, samo poslednju granulu, sve će i dalje brzo raditi.
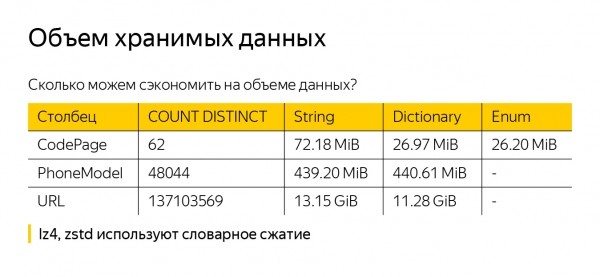
Pre nego što pričamo o prednostima LowCardinality, odmah ću reći da verovatno nećemo postići smanjenje podataka na disku (iako se to može desiti), jer ClickHouse kompresuje podatke. Postoji podrazumevani način - LZ4. Takođe se može napraviti kompresija pomoću ZSTD. Ali oba algoritma već implementiraju rečničku kompresiju, tako da naš spoljni rečnik ClickHouse nije od velike pomoći.
Da ne bih bio neosnovan, uzeo sam neke podatke iz metrike — String, LowCardinality(String) i Enum — i sačuvao ih u različitim tipovima podataka. Dobio sam tri kolone, gde je zabeleženo jedan milijard redova. U prvoj koloni, CodePage, ima ukupno 62 vrednosti. I jasno je da je u LowCardinality(String) pritisak bolji. String je malo gori, ali to je verovatno zbog kratkih stringova, čuvamo njihove dužine, a one zauzimaju mnogo prostora, slabo se kompresuju.
Ako uzmemo PhoneModel, ima ih 48 hiljada — to je već više, a razlike između String i LowCardinality(String) gotovo da ni nema. Za URL takođe smo uštedeli samo 2 GB — mislim da na to ne treba oslanjati.
Procena brzine rada
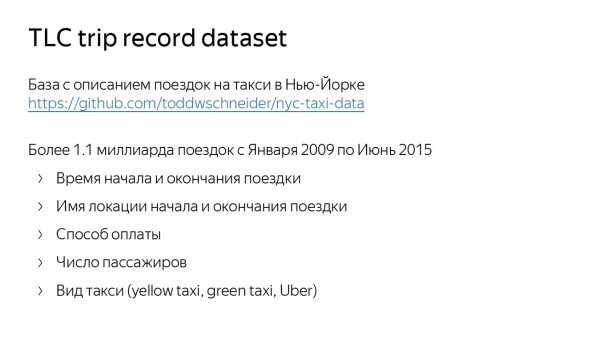
Sada ćemo proceniti brzinu rada. Da bismo je procenili, koristio sam skup podataka sa opisom vožnji taksijem u Njujorku. On je na GitHub-u. U njemu je nešto više od milijard vožnji. Tamo su prikaza lokacija, vreme početka i završetka vožnje, način plaćanja, broj putnika i čak vrsta taksija — zeleni, žuti i Uber.
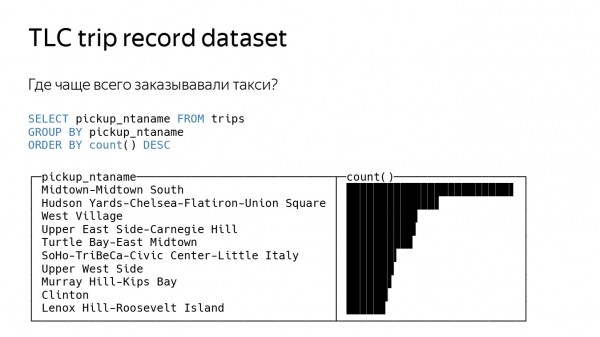
Prvi zahtev sam postavio prilično jednostavno — pitao sam gde se najčešće naručuje taksi. Za to treba uzeti lokaciju, odakle se naručivalo, grupisati po njoj i prebrojati funkciju count. ClickHouse daje nešto na to.
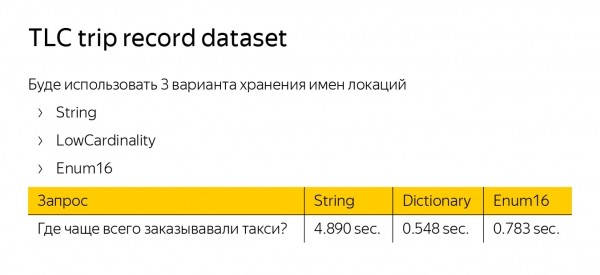
Da bismo izmerili brzinu obrade zahteva, napravio sam tri tabele sa istim podacima, ali sam koristio tri različita tipa podataka za našu početnu lokaciju — String, LowCardinality i Enum. LowCardinality i Enum su se pokazali pet puta bržim od String. Enum je brži jer radi sa brojevima. LowCardinality — zato što je implementirana optimizacija GROUP BY.
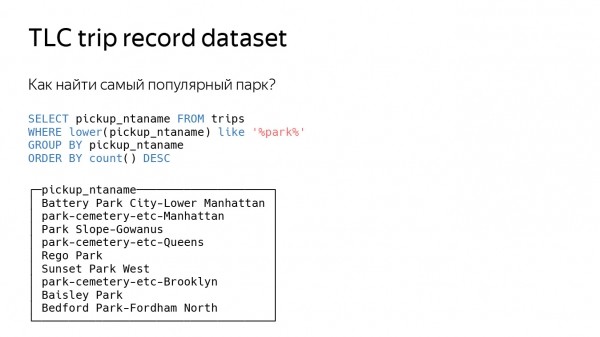
Pogledajmo da dodatno zakomplikujemo zahtev — pitamo gde se nalazi najpopularniji park u Njujorku. Ponovo ćemo to meriti prema tome gde se najčešće naručuje taksi, ali ćemo filtrirati samo one lokacije koje sadrže reč „park“. Takođe, dodajemo funkciju like.
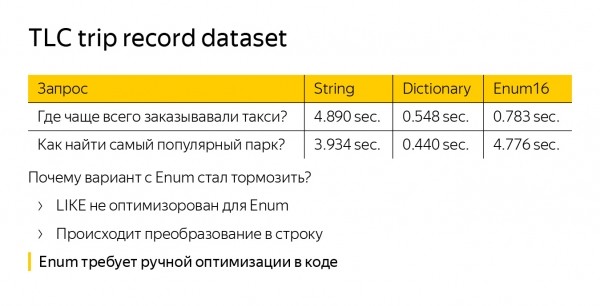
Gledamo vreme — vidimo da je Enum odjednom počeo usporavati. Štaviše, radi još sporije od standardnog tipa podataka String. To se dešava jer funkcija like nije uopšte optimizovana za Enum. Moramo pretvoriti naše stringove iz Enum-a u obične stringove — radimo više posla. LowCardinality(String) takođe nije optimizovan po default-u, ali tamo like radi nad rečnikom, pa se zahtev ubrzava u poređenju sa String.
Kada radimo s Enum-om, postoji jedan veći problem. Ako želimo da ga optimizujemo, to moramo učiniti na svakom mestu u kodu. Recimo da smo napisali novu funkciju — obavezno moramo smisliti optimizaciju za Enum. A kod LowCardinality je sve optimizovano po defaultu.
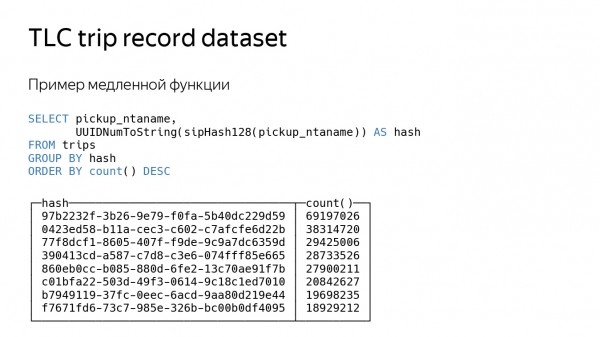
Pogledajmo poslednji upit, koji je više veštački. Jednostavno ćemo izračunati hash funkciju naše lokacije. Hash funkcija — prilično je spor upit, napreduje sporo, tako da će sve biti sporije otprilike tri puta.
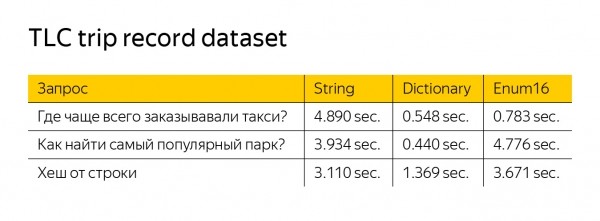
LowCardinality i dalje radi brže, iako ovde nema filtriranja. To se dešava zato što naše funkcije rade samo nad rečnikom. Funkcija za izračunavanje hasha ima jedan argument — može obraditi manje podataka i takođe može vratiti LowCardinality.
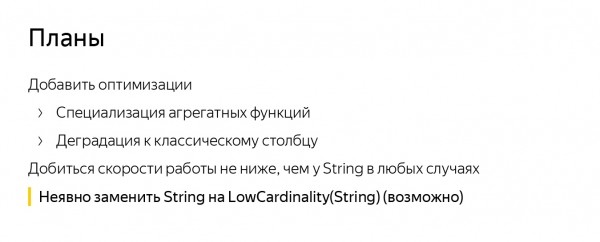
Naš globalni plan je postići brzinu rada koja nije niža od String u svim slučajevima, i zadržati ubrzanja. I, možda, nekad ćemo zameniti String sa LowCardinality, vi ažurirate ClickHouse, i sve će raditi malo brže.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish