

U Linuxu postoji mnogo alata za debagovanje jezgra i aplikacija. Većina njih negativno utiče na performanse aplikacija i ne može se koristiti u produkciji.
Prije nekoliko godina — eBPF. Omogućava praćenje jezgra i korisničkih aplikacija s malim preusmjeravanjem i bez potrebe za ponovnim sastavljanjem programa i učitavanjem vanjskih modula u jezgro.
Danas već postoji mnogo aplikativnih alata koji koriste eBPF, a u ovom članku ćemo razmotriti kako napisati vlastiti alat za profiliranje na osnovu biblioteke . Članak se temelji na stvarnim događajima. Proći ćemo kroz put od pojave problema do njegovog rješavanja, kako bismo pokazali kako se postojeći alati mogu iskoristiti u konkretnim situacijama.
Ceph je spor
U Ceph klaster je dodan novi host. Nakon migracije dijela podataka na njega, primijetili smo da je brzina obrade zahtjeva za zapisom na njemu znatno niža nego na drugim serverima.
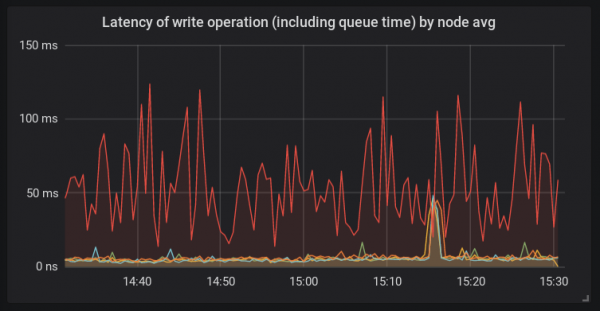
Za razliku od drugih platformi, na ovom hostu je korišten bcache i novo jezgro linux 4.15. Ova konfiguracija hosta korištena je ovdje prvi put. I tada je bilo jasno da bi korijen problema teoretski mogao biti bilo šta.
Istraživanje hosta
Počnimo s time da pogledamo šta se događa unutar procesa ceph-osd. Da bismo to uradili, iskoristit ćemo i (više o tome možete pročitati ):
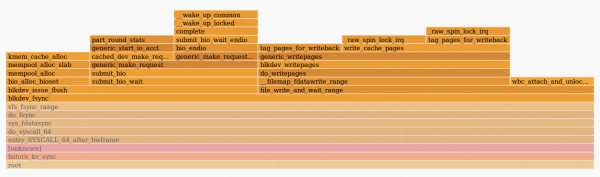
Slika nam govori da je funkcija fdatasync() provela mnogo vremena šaljući zahtjev u funkciji generic_make_request(). To znači da je razlog problema vjerovatno negdje izvan samog osd demona. To može biti ili jezgro ili diskovi. Izvještaj iostat pokazivao je visoku latenciju obrade zahtjeva bcache diskovima.
Tokom provjere hosta otkrili smo da demon systemd-udevd troši veliko količinu CPU vremena — oko 20% na nekoliko jezgara. Ovo čudno ponašanje zahtijeva istraživanje uzroka. Budući da systemd-udevd radi sa uevent'ima, odlučili smo ih provjeriti putem udevadm monitor. Ispostavilo se da je generisano mnogo change događaja za svaki blok uređaj u sistemu. Ovo je prilično neobično, pa ćemo morati vidjeti šta generiše sve te događaje.
Koristeći BCC alat
Kao što smo već ustanovili, jezgro (i ceph demon tokom sistemskog poziva) troši mnogo vremena u generic_make_request(). Pokušajmo izmjeriti brzinu rada ove funkcije. U već postoji izvrstan alat — funclatency. Prat ćemo pratiti demon po njegovom PID-u sa intervalom od jedne sekunde između ispisa informacija i prikazivati rezultate u milisekundama.
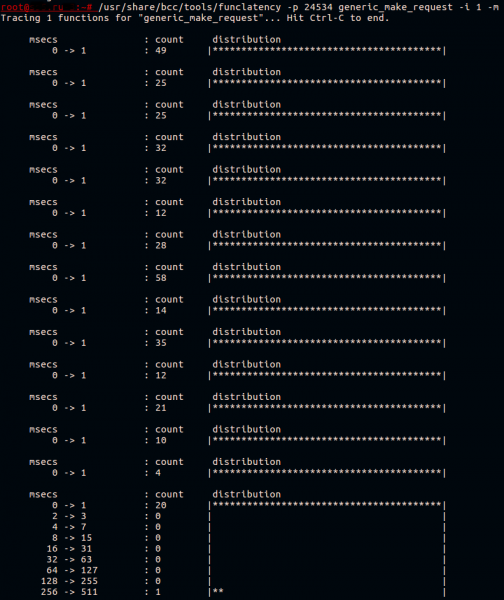
Obično ova funkcija radi brzo. Sve što radi je da prenosi zahtev u red drajvera uređaja.
Bcache je složen uređaj koji se zapravo sastoji od tri diska:
- backing device (keširani disk), u ovom slučaju to je spor HDD;
- caching device (keširajući disk), ovde je to jedna particija NVMe uređaja;
- virtuelni uređaj bcache, s kojim radi aplikacija.
Znamo da prenos zahteva usporava, ali za koji od ovih uređaja? Razjasnićemo to malo kasnije.
Sada znamo da uevent-ovi verovatno uzrokuju probleme. Nije lako pronaći šta tačno pokreće njihovu generaciju. Pretpostavimo da je to neki softver koji se pokreće povremeno. Pogledaćemo koji se softver pokreće u sistemu, koristeći skript execsnoop iz istog . Pokrenućemo ga i usmeriti izlaz u fajl.
Na primer ovako:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Nećemo ovde davati puni izlaz execsnoop-a, ali jedan interesantan red je izgledao ovako:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
Treća kolona je PPID (roditeljski PID) procesa. Proces sa PID 5802 se pokazao kao jedan od niti našeg sistema monitoringa. Tokom provere konfiguracije sistema monitoringa pronađeni su pogrešno postavljeni parametri. Temperatura HBA-adaptera se merenja svake 30 sekundi, što je mnogo češće nego što je potrebno. Nakon promene intervala provere na duži, otkrili smo da je kašnjenje obrade zahteva na ovom hostu prestalo da se ističe u odnosu na druge hostove.
Ali još uvek nije jasno zašto je bcache uređaj toliko usporavao. Pripremili smo testnu platformu sa identičnom konfiguracijom i pokušali smo da reprodukujemo problem, pokrećući fio na bcache, povremeno pokrećući udevadm trigger za generisanje uevents.
Pisanje alata zasnovanih na BCC
Pokušaćemo da napišemo jednostavnu alatku za praćenje i ispis na ekran najsporijih poziva generic_make_request(). Takođe nas zanima ime diska za koji je ova funkcija pozvana.
Plan je jednostavan:
- Registrujemo kprobe na generic_make_request():
- Čuvamo u memoriji ime diska, dostupno kroz argument funkcije;
- Čuvamo oznaku vremena.
- Registrujemo kretprobe na povratku iz generic_make_request():
- Dobijamo trenutnu oznaku vremena;
- Tražimo sačuvanu oznaku vremena i upoređujemo sa trenutnom;
- Ako je rezultat veći od zadanog, pronalazimo spremljeno ime diska i ispisujemo na terminal.
Kprobes i kretprobes koriste mehanizam tačaka prekida za promenu koda funkcija u hodu. Možete pročitati i članak o ovoj temi. Ako pogledate kod raznih alata u , možete primetiti da imaju identičnu strukturu. Tako da ćemo u ovom članku izostaviti parsenje argumenata skripta i preći na samu BPF program.
Tekst eBPF unutar python skripta izgleda ovako:
bpf_text = """ # Ovdje će biti kod bpf programa """
Za razmenu podataka između funkcija, eBPF programi koriste . Tako ćemo i mi. Kao ključ ćemo koristiti PID procesa, a kao vrednost odrediti strukturu:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Ovde registrujemo haš-tabelu koja se zove p, sa ključem tipa u64 i vrednošću tipa struct data_t. Tabla će biti dostupna u kontekstu naše BPF programa. Makro BPF_PERF_OUTPUT registruje drugu tabelu, koja se zove events, koja se koristi za u prostor korisnika.
Pri merenju latencija između poziva funkcije i povratka iz nje, ili između poziva različitih funkcija, potrebno je imati na umu da dobijeni podaci treba da pripadaju jednom kontekstu. Drugim rečima, treba se setiti mogućeg paralelnog pokretanja funkcija. Imamo mogućnost merenja latencije između poziva funkcije u kontekstu jednog procesa i povratka iz te funkcije u kontekstu drugog procesa, ali to će verovatno biti beskorisno. Dobar primer ovde može biti , gde se kao ključ haš-tabele postavlja pokazivač na struct request, koja odražava jedan zahtev ka disku.
Sledeće što treba da uradimo je da napišemo kod koji će se pokretati prilikom poziva istražene funkcije:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Ovde će se drugi argument zameniti prvim argumentom pozvane funkcije . Nakon toga dobijamo PID procesa, u kontekstu kojeg radimo, i trenutnu vremensku oznaku u nanosekundama. Sve to zapisujemo u sveže dodeljenu struct data_t dataIme diska dobijamo iz strukture bio, koja se prenosi prilikom poziva generic_make_request(), i čuvamo ga u istu strukturu data. Poslednji korak je dodavanje unosa u heš tabelu, o kojoj je prethodno bilo reči.
Sledeća funkcija će biti pozvana prilikom povratka iz generic_make_request():
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts)/1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Ova funkcija je slična prethodnoj: saznajemo PID procesa i vremensku oznaku, ali ne alociramo memoriju za novu strukturu podataka. Umesto toga, tražimo u heš tabeli već postojeću strukturu po ključu == trenutni PID. Ako pronađemo strukturu, dobijamo ime pokrenutog procesa i dodajemo ga.
Binarno pomeranje koje ovde koristimo je potrebno za dobijanje GID-a niti, tj. PID glavnog procesa koji je pokrenuo nit u kontekstu u kojem radimo. Pozivamo funkciju koja vraća i GID niti i njen PID u jednoj 64-bitnoj vrednosti.
Pri ispisu u terminal nas trenutno ne interesuje nit, već glavni proces. Nakon upoređivanja dobijene latencije sa zadatim pragom, prosledićemo našu strukturu data u korisnički prostor preko tabele events, nakon čega brisemo unos iz p.
U Python skripti koja će učitati ovaj kod, potrebno je zameniti MIN_US i FACTOR sa pragovima latencije i jedinicom vremena koje ćemo proslediti kroz argumente:
bpf_text = bpf_text.replace('MIN_US', str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR', 'data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR', '')
	label = "usec"
Sada treba da pripremimo BPF program koristeći i registrovati probe:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request", fn_name="start")
b.attach_kretprobe(event="generic_make_request", fn_name="stop")
Takođe ćemo morati da definišemo struct data_t u našoj skripti, inače neće biti moguće ništa pročitati:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk", ct.c_char * DISK_NAME_LEN)]
Poslednji korak je ispis podataka na terminal:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# format output
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Sam skript je dostupan na . Pokušaćemo ga pokrenuti na testnoj platformi, gdje se pokreće fio, koji piše na bcache, i pozvati udevadm monitor:
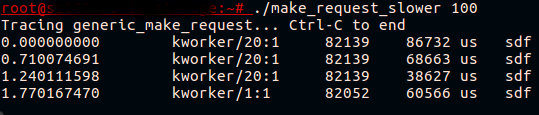
Napokon! Sada vidimo da ono što je izgledalo kao usporavajući bcache uređaj, zapravo je usporavajući poziv generic_make_request() za keširani disk.
Zaronite u Kernel
Šta tačno usporava tokom transfera zahteva? Vidimo da kašnjenje nastaje čak i pre nego što započnemo kontabilizaciju zahteva, tj. obeležavanje konkretnog zahteva za dalju statistiku ( /proc/diskstats ili iostat) još nije počelo. Ovo je lako proveriti pokretanjem iostat tokom reprodukcije problema, ili , koja se oslanja na početak i kraj kontabilizacije zahteva. Nijedna od ovih alatki neće pokazati probleme za zahteve ka keširanom disku.
Ako pogledamo funkciju generic_make_request(), videćemo da se pre početka kontabilizacije zahteva pozivaju još dve funkcije. Prva — generic_make_request_checks(), vrši provere legitimnosti zahteva u vezi sa podešavanjima diska. Druga — , u kojoj se nalazi zanimljiv poziv :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
U njoj kernel čeka otpuštanje reda. Izmerimo kašnjenje blk_queue_enter():
~# /usr/share/bcc/tools/funclatency  blk_queue_enter -i 1 -m
Tracing 1 functions for "blk_queue_enter"... Hit Ctrl-C to end.

 	msecs           	: count 	distribution
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Izgleda da smo blizu rešenja. Funkcije koje se koriste za "zamrzavanje/otpuštanje" reda su i . Koriste se kada je potrebno promeniti podešavanja reda zahteva, potencijalno opasna za zahteve koji se nalaze u tom redu. Kada se pozove blk_mq_freeze_queue() funkcijom inkrementira se brojač q->mq_freeze_depth. Nakon toga, jezgro čeka ispraznjenje reda u .
Vreme čekanja na ispraznjenje ovog reda ekvivalentno je kašnjenju diska, jer jezgro čeka završetak svih naređenih operacija. Kada red postane prazan, primenjuju se podešavanja. Nakon toga se poziva , koji smanjuje broj freeze_depth.
Sada znamo dovoljno da ispravimo situaciju. Komanda udevadm trigger rezultira primenom podešavanja za blok uređaj. Ova podešavanja su opisana u udev pravilima. Možemo pronaći koja konkretna podešavanja "smrzavaju" red tako što ćemo pokušati da ih promijenimo putem sysfs ili pregledanjem izvornih kodova jezgra. Takođe možemo isprobati BCC alat , koji će ispisati na terminalu tragove steka jezgra i korisničkog prostora za svaku poziv blk_freeze_queue, na primer:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Udev pravila se prilično retko menjaju i obično se to dešava pod kontrolom. Tako da vidimo da čak i primena već postavljenih vrednosti izaziva porast kašnjenja u prenosu zahteva od aplikacije do diska. Naravno, generisanje udev događaja kada nema promena u konfiguraciji diskova (na primer, uređaj se ne povezuje/odvaja) nije baš dobra praksa. Ipak, možemo pomoći jezgru da ne obavlja besposleni posao i ne "smrzava" red zahteva, ako za to nema potrebe. ispravljaju situaciju.
Zaključak
eBPF je vrlo fleksibilan i moćan alat. U ovom članku smo razmotrili jedan praktičan slučaj i demonstrirali malu deo onoga što je moguće uraditi. Ako vas zanima razvoj BCC alata, vredi pogledati , koji dobro opisuje osnove rada.
Postoje i drugi zanimljivi alati za debagiranje i profilisanje koji se oslanjaju na eBPF. Jedan od njih je , koji omogućava pisanje moćnih jednostavnih komandi i malih programa na jeziku sličnom awk-u. Drugi je , koji omogućava prikupljanje niskonivioskih metričkih podataka visoke rezolucije direktno na vaš prometheus server, s mogućnošću da kasnije dobijete lepu vizualizaciju i čak upozorenja.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish