

Zdravo, Habr!
Podsećamo vas da je objavljena još jedna izuzetno zanimljiva i korisna o obrascima Kubernetes-a. Sve je počelo još sa "" Brendana Bernsa, a, uostalom, rad u ovom segmentu kod nas . Danas vam nudimo da pročitate članak iz MinIO bloga koji ukratko izlaže trendove i specifičnosti obrazaca skladištenja podataka u Kubernetes-u.
Kubernetes je fundamentalno promenio tradicionalne obrasce razvoja i deploy-anja aplikacija. Sada timu može biti potrebno samo nekoliko dana za razvoj, testiranje i implementaciju aplikacije – u različitim okruženjima, i sve to unutar Kubernetes klastera. Takav rad sa tehnologijama prethodnih generacija obično je zahtevao cele nedelje, ako ne i mesece.
Ovo ubrzanje postalo je moguće zahvaljujući apstrakciji koju pruža Kubernetes — to jest, zahvaljujući tome što Kubernetes sam obavlja interakcije sa niskonivo detaljima fizičkih ili virtuelnih mašina, omogućavajući korisnicima da definišu, između ostalog, potrebni procesor, potrebnu količinu memorije, broj instanci kontejnera. S obzirom na to da ogromna zajednica radi na podršci Kubernetes-u, a obim upotrebe Kubernetes-a se kontinuirano širi, on daleko prednjači među svim platformama za orkestraciju kontejnera.
Kako se upotreba Kubernetes-a širi, raste i zbunjenost oko obrazaca skladištenja podataka koji se primenjuju u njemu..
Uopšteno, u konkurenciji za deo kolača Kubernetes (tj. za skladištenje podataka), kada se radi o skladištenju podataka, signal se gubi u jaku buku.
Kubernetes predstavlja savremeni model razvoja i implementacije aplikacija, kao i njihovog upravljanja. Ovaj savremeni model odvaja skladištenje podataka od izračunavanja. Da biste potpuno razumeli ovo odvajanje u kontekstu Kubernetes-a, takođe je potrebno razumeti kakve su aplikacije koje rade sa stanjem i bez stanja, kao i kako se to uklapa u skladištenje podataka. Upravo ovde REST API pristup koji primenjuje S3 ima jasne prednosti u poređenju sa POSIX/CSI pristupom koji je karakterističan za druga rešenja.
U ovom članku ćemo razgovarati o obrascima skladištenja podataka u Kubernetesu i posebno ćemo se osvrnuti na raspravu o aplikacijama koje rade s očuvanjem stanja i onima bez očuvanja stanja, kako bismo dobro razumeli koja je razlika između njih i zašto je važna. U daljem tekstu biće razmotrene aplikacije i korišćeni obrasci skladištenja podataka u svetlu najboljih praksi rada s kontejnerima i Kubernetesom.
Kontejneri bez očuvanja stanja
Kontejneri su po prirodi laki i efemerni. Mogu se lako zaustaviti, obrisati ili rasporediti na drugom čvoru – na sve to odlazi samo nekoliko sekundi. U velikom sistemu orkestracije kontejnera takve operacije se neprekidno dešavaju, a korisnici ih čak ne primete. Ipak, premestiti kontejnerje moguće je samo ako nemaju nikakve zavisnosti od čvora na kojem se nalaze. O takvim kontejnerima kaže se da rade bez očuvanja stanja.
Kontejneri s očuvanjem stanja
Ako kontejner skladišti podatke na lokalno povezanim uređajima (ili na blok uređaju), skladište podataka na kojem je lociran moraće da se premesti na novi čvor zajedno s samim kontejnerom — u slučaju kvara. To je važno jer u suprotnom aplikacija koja se pokreće u kontejneru neće moći ispravno da funkcioniše, jer joj je potrebno da pristupa podacima pohranjenim na lokalnim uređajima. O takvim kontejnerima kaže se da rade s očuvanjem stanja.
Sa čistotehničke tačke gledišta, kontejneri s očuvanjem stanja se takođe mogu premeštati na druge čvorove. To se obično omogućava pomoću distribuiranih fajlskih sistema ili blok mrežnih skladišta podataka, koji su povezani sa svim čvorovima na kojima su kontejneri. Tako kontejneri dobijaju pristup volumenima za trajno skladištenje podataka, a informacije se čuvaju na diskovima koji se nalaze širom mreže. Ovu metodu ću nazvatikontejnerskim pristupom s očuvanjem stanjai u ostatku članka ću je tako označavati radi doslednosti.
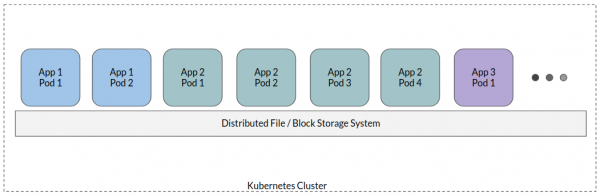
U tipičnom pristupu kontejnerima sa očuvanjem stanja, svi podovi aplikacija su povezani sa jednim distribuiranim sistemom datoteka – što predstavlja neku vrstu deljenog skladišta, gde se čuvaju svi podaci aplikacija. Iako su moguće određene varijacije, ovo je visoko nivo pristup.
Sada, hajde da razjasnimo zašto je pristup kontejnerima sa očuvanjem stanja u svetu orijentisanom ka oblaku antipattern.
Oblaščno-orijentisano projektovanje aplikacija
Tradicionalno, aplikacije su koristile baze podataka za strukturirano skladištenje informacija i lokalne diskove ili distribuirane sisteme datoteka za skladištenje svih nestrukturiranih ili čak polustrukturiranih podataka. Kako je obim nestrukturiranih podataka rastao, programeri su shvatili da je POSIX previše 'pričljiv', povezan sa značajnim troškovima i, na kraju, ometa rad aplikacije kada se prelazi na stvarno velike razmere.
To je uglavnom doprinelo pojavi novog standarda za skladištenje podataka, odnosno oblačno-orijentisanih skladišta, koja su prvenstveno zasnovana na REST API-ju i oslobađaju aplikaciju od opterećujuće brige o lokalnom skladištu podataka. U tom slučaju, aplikacija zapravo prelazi u režim rada bez očuvanja stanja (pošto je stanje smešteno u udaljenom skladištu). Savremene aplikacije se već od samog početka grade uzimajući u obzir ovu činjenicu. Obično, svaka savremena aplikacija koja obrađuje podatke razne vrste (logovi, metapodaci, blobovi itd.) konstruisana je prema oblačno-orijentisanoj paradigmi, gde se stanje prebacuje u posebno odvojen softverski sistem za njegovo skladištenje.
Pristup kontejnerima sa očuvanjem stanja vraća celu ovu paradigmu tačno nazad do početka!
Korištenjem POSIX sučelja za pohranu podataka, aplikacije funkcioniraju kao da pohranjuju stanje, što ih odvaja od najvažnijih postulata dizajniranja orijentiranog na oblak, odnosno od mogućnosti variranja veličine radnih tokova aplikacije u skladu s ulaznim opterećenjem, preseljenja na novi čvor čim trenutni čvor otkaže, i tako dalje.
Pogledajući ovu situaciju pažljivije, otkrivamo da se pri odabiru pohrane podataka iznova i iznova suočavamo s dilemama "POSIX naspram REST API", ali uz dodatno pogoršanje problema s POSIX-om, uzrokovano distribuiranom prirodom Kubernetes okruženja. Konkretno,
- POSIX je usmjeren na raspravu: semantika POSIX-a zahtijeva povezivanje metapodataka i deskriptora datoteka s svakom operacijom, što pomaže održavanju stanja operacije. To rezultira značajnim troškovima koji nemaju stvarnu vrijednost. API-ji za pohranu objekata, posebno S3 API, oslobodili su se ovih zahtjeva, dopuštajući aplikaciji da izvrši radnju i zatim "zaboravi" na poziv. Odgovor sustava za pohranu podataka označava je li ova radnja uspješno provedena ili nije. U slučaju neuspjeha, aplikacija može ponovo pokušati.
- Mrežna ograničenja: U distribuiranom sustavu podrazumijeva se da može postojati više aplikacija koje pokušavaju zapisivati podatke na isti pridruženi medij. Stoga, osim što će se aplikacije natjecati jedna s drugom za propusnost (kako bi poslale podatke na medij), sam sustav za pohranu podataka će se natjecati za tu propusnost, raspoređujući podatke po fizičkim diskovima. Zbog rasprave oko POSIX-a, broj mrežnih poziva višestruko se povećava. S druge strane, S3 API pruža jasnu podjelu mrežnih poziva između onih koje šalje klijent na server i onih koji se odvijaju unutar servera.
- Sigurnost: Model sigurnosti POSIX oslanja se na aktivno učešće ljudi: administratori konfigurišu konkretne nivoe pristupa za svakog korisnika ili grupu. Ova paradigma se teško prilagođava oblaku orijentisanom svetu. Savremene aplikacije zavise od modela sigurnosti vezanih za API, gde se prava pristupa definišu kao skup politika, dodeljuju se servisni nalozi, privremeni kredencijali itd.
- Upravljivost: Kontejneri koji zadržavaju stanje donose određene troškove povezane s upravljanjem. Ovdje se radi o sinhronizaciji paralelnog pristupa podacima, osiguranju konzistentnosti podataka; to sve zahteva pažljivo razmatranje koje uzorke pristupa podacima koristiti. Mora se postaviti, kontrolisati i konfigurirati dodatne programe, da ne govorimo o dodatnim naporima koji se troše na razvoj.
Kontejnerski interfejs skladišta podataka
Dok je interfejs kontejnerskog skladišta podataka (CSI) odličan za širenje nivoa volumena Kubernetes-a, delimično predajući ga trećim dobavljačima skladišta podataka, istovremeno je slučajno doprineo ubeđenju da je pristup kontejnerima koji zadržavaju stanje preporučena metoda za skladištenje podataka u Kubernetes-u.
CSI je razvijen kao standard za pružanje proizvoljnih sistema blokovnog i fajlskog skladišta podataka nasleđenim aplikacijama prilikom rada s Kubernetes-om. I, kako je pokazano u ovom članku, jedina situacija u kojoj je kontejnerski pristup s očuvanjem stanja (i CSI u svom trenutnom obliku) razuman jest kada je sama aplikacija nasleđeni sistem u koji nije moguće dodati podršku za API objektno skladište podataka.
Važno je razumeti da, koristeći CSI u njegovom trenutnom obliku, to jest, montirajući volumene prilikom rada sa savremenim aplikacijama, suočićemo se s otprilike istim problemima koji su se pojavili i u sistemima gde je skladištenje podataka organizovano u stilu POSIX.
Kvalitetniji pristup
U ovom slučaju važno je razumeti da većina aplikacija po svojoj suštini nije prilagođena za rad sa stanjem ili bez stanja. Takvo ponašanje zavisi od opšte arhitekture sistema i od konkretnih opcija odabranih tokom projektovanja. Razgovaraćemo malo o aplikacijama koje čuvaju stanje.
U principu, svi podaci aplikacija mogu se klasifikovati u nekoliko širokih tipova:
- Podaci o dnevnicima
- Podaci o vremenskim oznakama
- Podaci o transakcijama
- Metapodaci
- Obrazi kontejnera
- Podaci blobova (velikih binarnih objekata)
Svi ovi tipovi podataka se vrlo dobro podržavaju na modernim platformama za skladištenje podataka, i postoji nekoliko platformi orijentisanih na oblak koje su prilagođene za isporuku podataka u svakom od ovih specifičnih formata. Na primer, podaci o transakcijama i metapodaci mogu se nalaziti u modernoj bazi podataka orijentisanoj na oblak, kao što su CockroachDB, YugaByte itd. Obrazi kontejnera ili podaci blobova mogu se skladištiti u docker registru zasnovanom na MinIO. Podaci o vremenskim oznakama mogu se čuvati u bazi podataka vremenskih serija, kao što je InfluxDB itd. Nećemo ovde ulaziti u detalje svakog tipa podataka i odgovarajućih aplikacija, ali osnovna ideja je da se izbegne trajno skladištenje podataka zasnovano na lokalnoj montaži diskova.
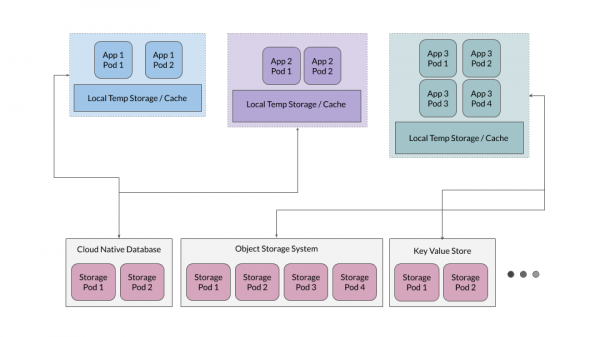
Pored toga, često se pokazuje da je efikasno obezbediti nivo privremenog keširanja, koji služi aplikacijama kao svojevrsno skladište privremenih datoteka, ali aplikacije ne bi trebale zavisiti od ovog nivoa kao od izvora istine.
Skladište za aplikacije sa stanjem
Dok je u većini slučajeva korisno zadržati aplikacije bez stanja, one aplikacije koje su namenjene za čuvanje podataka – kao što su baze podataka, objektna skladišta, skladišta ključeva i vrednosti – treba da čuvaju stanje. Poglećemo zašto se ove aplikacije implementiraju na Kubernetes-u. Kao primer, uzmimo MinIO, ali slični principi se mogu primeniti i na sve druge velike oblake orijentisane sisteme za skladištenje podataka.
Aplikacije zasnovane na oblaku projektuju se sa ciljem da maksimalno iskoriste fleksibilnost svojstvenu kontejnerima. To znači da se ne prave nikakva pretpostavke o okruženju u kojem će biti implementirane. Na primer, MinIO koristi unutrašnji mehanizam za erazijsko kodiranje koji obezbeđuje dovoljnu otpornost sistema da ostane operativan čak i kada polovinu diskova otkaže. Takođe, MinIO upravlja integritetom i bezbednošću podataka koristeći vlastitu heš funkciju i enkripciju na strani servera.
Za takve aplikacije zasnovane na oblaku, kao rezervna skladišta najpogodniji su lokalni persistentni volumeni (PV). Lokalni PV omogućava skladištenje sirovih podataka, dok aplikacije koje rade na ovim PV-ima samostalno prikupljaju informacije potrebne za skaliranje podataka i upravljanje rastućim zahtevima za podacima.
Ovaj pristup je mnogo jednostavniji i znatno bolje se skalira u poređenju sa PV-ima zasnovanim na CSI, koji donose svoje nivoe upravljanja podacima i redundancije; problem je u tome što ovi nivoi obično dolaze u sukob sa aplikacijama koje su dizajnirane prema principu očuvanja stanja.
Siguran korak ka odvajanju podataka od proračuna.
U ovom članku smo razgovarali o tome kako se aplikacije preorijentišu ka radu bez očuvanja stanja, ili, drugim rečima, kako se skladištenje podataka odvaja od proračuna. Na kraju ćemo razmotriti nekoliko stvarnih primera ovog trenda.
, poznata platforma za analizu podataka, tradicionalno se koristila uz očuvanje stanja i sa implementacijom u HDFS datotečkom sistemu. Međutim, kako Spark prelazi u cloud-orijentisani svet, ova platforma se sve više koristi bez očuvanja stanja uz korišćenje `s3a`. Spark koristi s3a za prenos stanja u druge sisteme, dok same Spark kontejnere rade potpuno bez očuvanja stanja. Drugi veliki igrači u oblasti analitike velikih podataka, posebno, , , takođe prelaze na rad sa odvojenim skladištem podataka i proračunima.
Slični obrasci se također mogu primijetiti na drugim velikim analitičkim platformama, uključujući Presto, Tensorflow to R, Jupyter. Izdavanjem stanja u udaljene oblake za pohranu podataka, mnogo je lakše upravljati vašom aplikacijom i skalirati je. Osim toga, to doprinosi prenosivosti aplikacije u raznolike okoline.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish