

Efekat bloat-a tabela i indeksa je široko poznat i prisutan nije samo u Postgres-u. Postoje načini za borbu protiv njega 'iz kutije', poput VACUUM FULL ili CLUSTER, ali oni blokiraju tabele tokom rada i stoga se ne mogu uvek koristiti.
U ovom članku ćemo obraditi malo teorije o tome kako nastaje bloat, kako se njime može upravljati, o deferred constraints i o problemima koje donose prilikom korišćenja ekstenzije pg_repack.
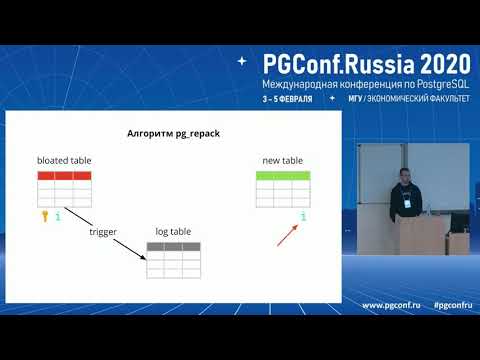
Ovaj članak je napisan na osnovu na PgConf.Russia 2020.
Zašto nastaje bloat
Osnova Postgres-a se zasniva na modelu višestrukih verzija (). Njegova suština je da svaka stringa u tabeli može imati više verzija, pri čemu transakcije vide samo jednu od tih verzija, ali ne nužno istu. To omogućava da više transakcija radi istovremeno i gotovo bez međusobnog uticaja.
Očigledno je da sve te verzije treba čuvati. Postgres radi sa memorijom po stranicama, a stranica je minimalna količina podataka koja se može čitati sa diska ili zapisivati. Razmotrimo mali primer kako bi to izgledalo.
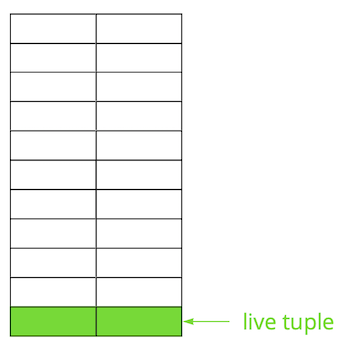
Pretpostavimo da imamo tabelu u koju smo dodali nekoliko zapisa. Na prvoj stranici datoteke u kojoj se čuva tabela, pojavili su se novi podaci. To su aktivne verzije redova, koje su dostupne drugim transakcijama nakon komitovanja (radi jednostavnosti, pretpostavićemo da je nivo izolacije Read Committed).
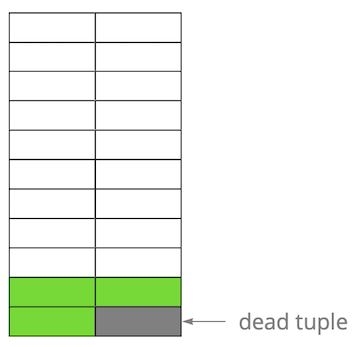
Zatim smo ažurirali jedan od zapisa, čime smo označili staru verziju kao zastarelu.
Korak po korak, ažurirajući i brišući verzije redova, dobili smo stranicu na kojoj je približno polovina podataka 'smeće'. Ti podaci nisu vidljivi nijednoj transakciji.
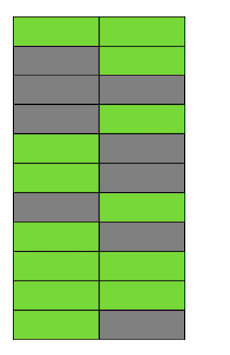
U Postgres-u postoji mehanizam , koji briše zastarele verzije i oslobađa prostor za nove podatke. Međutim, ako nije podešen dovoljno agresivno ili je zauzet radom na drugim tabelama, 'smešni podaci' ostaju, i moraćemo da koristimo dodatne stranice za nove podatke.
Tako će u našem primeru u određenom trenutku tabela biti sastavljena od četiri stranice, ali aktivnih podataka u njoj će biti samo polovina. Kao rezultat, prilikom pristupanja tabeli čitaćemo mnogo više podataka nego što je potrebno.
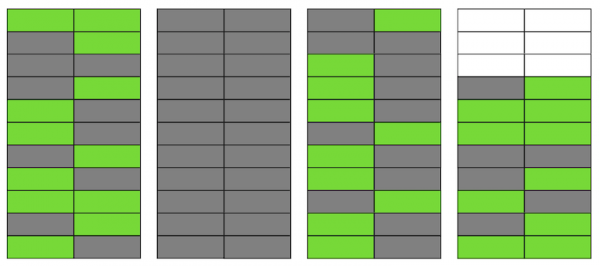
Čak i ako VACUUM sada ukloni sve zastarjele verzije redova, situacija se neće značajno poboljšati. Imaćemo slobodnog mesta na stranicama ili čak cele stranice za nove redove, ali ćemo i dalje čitati više podataka nego što je potrebno.
Usput, da je potpuno prazna stranica (druga u našem primeru) završila na kraju datoteke, VACUUM bi je mogao skratiti. Međutim, ona je trenutno na sredini, pa se ne može ništa učiniti s njom.
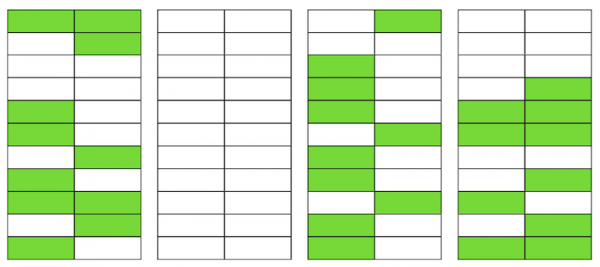
Kada broj takvih praznih ili jako razređenih stranica postane veliki, što se naziva bloat, to počinje da utiče na performanse.
Sve što je opisano iznad - mehanika pojave bloat-a u tabelama. U indeksima se to dešava približno na sličan način.
Da li ja imam bloat?
Postoji nekoliko načina da se utvrdi da li imate bloat. Ideja prvog - korišćenje interne statistike Postgres-a, koja sadrži približne informacije o broju redova u tabelama, broju "živih" redova itd. Na internetu možete pronaći mnoge varijante već gotovih skripti. Mi smo uzeli kao osnovu od PostgreSQL Experts, koja može oceniti bloat tabela zajedno sa toast-om i bloat btree-indeksima. Prema našem iskustvu, njegova greška iznosi 10-20%.
Drugi način - koristiti ekstenziju , koja omogućava da zavirite unutra stranica i dobijete kako procenjenu, tako i tačnu vrednost bloat-a. Međutim, u drugom slučaju biće potrebno skenirati celu tabelu.
Mala vrednost bloat-a, do 20%, smatramo prihvatljivom. Može se smatrati kao analog fillfactor-u za i . Pri 50% i više mogu početi problemi sa performansama.
Načini borbe protiv bloat-a
U Postgres-u postoji nekoliko načina borbe protiv bloat-a "iz kutije", međutim, oni nisu uvek i ne odgovaraju svima.
Podesiti AUTOVACUUM kako bloat ne bi nastajaoA kada preciznije, da zadrži na razumnom nivou za vas. Čini se da je to „kapetanski” savet, ali u stvarnosti to nije uvek lako postići. Na primer, ako vršite aktivan razvoj uz redovne promene u šemi podataka ili se odvija neka migracija podataka. Kao rezultat, vaš profil opterećenja može se često menjati i obično se razlikuje za različite tabele. To znači da stalno morate raditi malo unapred i prilagoditi AUTOVACUUM promenljivom profilu svake tabele. Ali očigledno je da to nije jednostavno.
Drugi uobičajeni razlog zašto AUTOVACUUM ne uspeva da obrađuje tabele jeste postojanje dugotrajnih transakcija koje mu ne omogućavaju da očisti podatke jer su dostupne tim transakcijama. Preporuka ovde je takođe očigledna – osloboditi se „visećih” transakcija i minimizovati vreme aktivnih transakcija. Ali ako je opterećenje vašeg aplikacije hibrid OLAP i OLTP, onda možete imati istovremeno mnogo čestih ažuriranja i kratkih upita, kao i dugotrajne operacije – na primer, izradu nekog izveštaja. U takvoj situaciji razmislite o raspodeli opterećenja na različite baze, što će omogućiti finu podešavanje svake od njih.
Još jedan primer – čak i ako je profil homogeni, ali DB se nalazi pod veoma visokim opterećenjem, čak i najagresivniji AUTOVACUUM može ne uspeti i bloat će se pojaviti. Skaliranje (vertikalno ili horizontalno) je jedino rešenje.
Šta raditi u situaciji kada ste podesili AUTOVACUUM, ali bloat nastavlja da raste.
Tim VACUUM FULL rekonstruiše sadržaj tabela i indeksa i ostavlja samo aktuelne podatke. Za uklanjanje bloat-a idealno funkcioniše, ali tokom njene primene dobija se ekskluzivna blokada na tabeli (AccessExclusiveLock), koja ne dozvoljava izvršavanje upita na ovoj tabeli, čak ni SELECT upita. Ako možete da priuštite zaustavljanje vašeg servisa ili njegovog dela na neko vreme (od desetina minuta do nekoliko sati u zavisnosti od veličine baze podataka i vaše opreme), onda je ova opcija najbolja. Nažalost, ne stignemo da pokrenemo VACUUM FULL u vremenu planiranog održavanja, tako da nam ova metoda ne odgovara.
Tim CLUSTER također preoblikuje sadržaj tablica, kao i VACUUM FULL, a pritom omogućuje da se naznači indeks prema kojem će podaci fizički biti poredani na disku (no u budućnosti redoslijed za nove redove nije garantirano). U određenim situacijama ovo je dobra optimizacija za niz upita – prilikom čitanja više zapisa prema indeksu. Nedostatak ovog komandnog alata je isti kao i kod VACUUM FULL – ona blokira tablicu tokom rada.
Tim REINDEX slična je prethodne dvije, ali izvršava rekonstrukciju određenog indeksa ili svih indeksa tablice. Blokade su nešto slabije: ShareLock na tablicu (ometa modifikacije, ali omogućava izvršavanje select) i AccessExclusiveLock na rekonstruirani indeks (blokira upite koji koriste taj indeks). Međutim, u 12. verziji Postgresa pojavio se parametar , koji omogućava rekonstrukciju indeksa bez blokiranja paralelnog dodavanja, izmjene ili brisanja zapisa.
U ranijim verzijama Postgresa isti rezultat, sličan REINDEX CONCURRENTLY, može se postići pomoću . Ovaj pristup omogućava stvaranje indeksa bez stroge blokade (ShareUpdateExclusiveLock, koja ne ometa paralelne upite), a zatim se stari indeks zamjenjuje novim i stari indeks se briše. Ovo omogućava uklanjanje bloat indeksa bez ometanja rada vaše aplikacije. Važno je napomenuti da prilikom rekonstrukcije indeksa dolazi do dodatnog opterećenja na diskovnom podsustavu.
Dakle, ako za indekse postoje alati za uklanjanje bloat „na vruće”, za tablice ih nema. Ovdje intervencije dolaze raznih vanjskih proširenja: (ranije pg_reorg), , i druge. U okviru ovog članka neću ih uspoređivati i govoriću samo o pg_repack, koji nakon određenih dorada koristimo kod nas.
Kako radi pg_repack
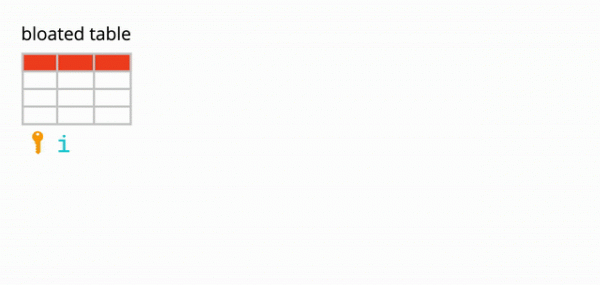
Pretpostavimo da imamo posve običnu tablicu – s indeksima, ograničenjima i, nažalost, s bloatom. Prvi korak pg_repack stvara log-tablicu za pohranu podataka o svim promjenama tokom rada. Okidač će replicirati te promjene na svaki insert, update i delete. Zatim se stvara tablica, slična izvornoj po strukturi, ali bez indeksa i ograničenja, kako bi se ubrzao proces umetanja podataka.
Zatim pg_repack premješta podatke iz starih u novu tabelu, automatski filtrirajući sve neaktualne redove, a zatim stvara indekse za novu tabelu. Tokom izvođenja svih ovih operacija, u log-tabeli se akumuliraju promjene.
Sljedeći korak je premještanje promjena u novu tabelu. Premještanje se izvršava u nekoliko iteracija, i kada u log-tabeli ostane manje od 20 zapisa, pg_repack uzima strogu blokadu, premješta posljednje podatke i zamjenjuje staru tabelu novom u sistemskim tabelama Postgres. To je jedini i veoma kratki trenutak kada nećete moći raditi sa tabelom. Nakon toga, stara tabela i tabela sa logovima se brišu, a u datotečnom sistemu se oslobađa prostor. Proces je završen.
U teoriji sve izgleda odlično, ali šta je sa praksom? Testirali smo pg_repack bez i sa opterećenjem, provjerili njegovo ponašanje u slučaju prijevremene intervencije (jednostavno rečeno, putem Ctrl+C). Svi testovi su bili uspješni.
Pojavili smo se u produkciji – i tada je sve krenulo naopako, kao što smo očekivali.
Prvi pokušaj u produkciji
Na prvom klasteru dobili smo grešku o kršenju jedinstvenog ograničenja:
$ ./pg_repack -t tablename -o id
INFO: ponovo pakovanje tabele "tablename"
ERROR: upit je neuspješan:
    ERROR: dupli ključ vrijednost krši jedinstveno ograničenje "index_16508"
DETAIL: Ključ (id, index)=(100500, 42) već postoji.
Ovo ograničenje je imalo automatski generisano ime index_16508 – stvorio ga je pg_repack. Prema atributima koji su uključeni, identifikovali smo "naše" ograničenje koje mu odgovara. Problem je bio u tome što to nije uobičajeno ograničenje, već odloženo (), tj. njegovo provjeravanje se vrši kasnije nego sql komanda, što dovodi do neočekivanih posljedica.
Odložena ograničenja: zašto su potrebna i kako funkcionišu
Malo teorije o odloženim ograničenjima.
Razmotrimo jednostavan primjer: imamo referentnu tabelu automobila sa dva atributa – nazivom i rednim brojem automobila u referenci.
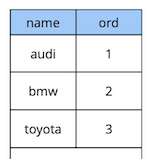
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Pretpostavimo da nam je bilo potrebno da zamijenimo prva i druga automobila. Rješenje "na hrst" – ažurirati prvu vrijednost na drugu, a drugu na prvu:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Ali prilikom izvršenja ovog koda očekujemo da dobijemo kršenje ograničenja, jer je redoslijed vrijednosti u tabeli jedinstven:
[23305] GREŠKA: duplicirani ključ vrednosti krši jedinstveno ograničenje “uk_cars”
Detalji: Ključ (ord)=(2) već postoji.
Kako da se uradi drugačije? Prva opcija: dodavati dodatnu zamenu vrednosti za redosled koji garantirano ne postoji u tabeli, na primer “-1”. U programiranju se to naziva “razmena vrednosti dve promenljive kroz treću”. Jedini nedostatak ove metode je dodatni update.
Druga opcija: redizajnirati tabelu da koristi tip podataka sa pomičnom tačkom za vrednost redosleda umesto celih brojeva. Tako, prilikom ažuriranja vrednosti sa 1, na primer, na 2.5 prva stavka automatski će se “postaviti” između druge i treće. Ovo rešenje funkcioniše, ali ima dva ograničenja. Prvo, neće vam odgovarati ako se vrednost koristi negde u interfejsu. Drugo, u zavisnosti od preciznosti tipa podataka, imaćete ograničen broj mogućih umetanja pre nego što sprovedete ponovni obračun vrednosti svih stavki.
Treća opcija: napraviti ograničenje odloženim, tako da se proverava samo prilikom komitovanja:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Pošto logika našeg inicijalnog zahteva garantuje da su u trenutku komitovanja sve vrednosti jedinstvene, izvešće se uspešno.
Razmatrani primer iznad, naravno, je vrlo sintetički, ali otkriva ideju. U našoj aplikaciji koristimo odložena ograničenja za realizaciju logike koja se bavi rešavanje konflikata prilikom simultanog rada korisnika sa zajedničkim objektima-vidgetima na tabli. Korišćenje takvih ograničenja omogućava nam da učinimo aplikativni kod malo jednostavnijim.
U suštini, u zavisnosti od tipa ograničenja u Postgresu postoje tri nivoa granularnosti njihove provere: nivo reda, transakcije i izraza.
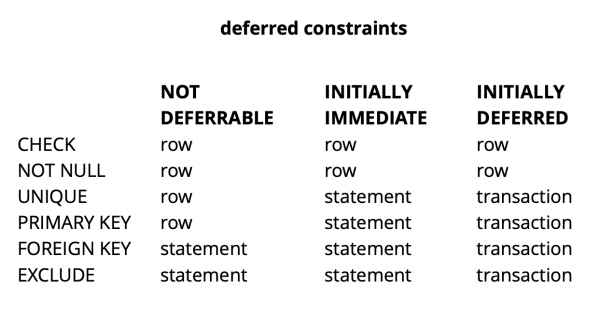
Izvor:
CHECK i NOT NULL se uvek proveravaju na nivou reda, dok za ostala ograničenja, kao što je prikazano u tabeli, postoje različite opcije. Više informacija možete pročitati .
Ukratko rečeno, odložena ograničenja u određenim situacijama omogućavaju čitljiviji kod i manje komandā. Međutim, to dolazi s komplikacijom u procesu debagovanja, jer su trenutak pojavljivanja greške i trenutak kada saznate za nju vremenski razdvojeni. Još jedan mogući problem je u tome što planer ne može uvek izraditi optimalan plan ako u upitu učestvuje odloženo ograničenje.
Dorada pg_repack
Razjasnili smo šta su odložena ograničenja, ali kako su ona povezana s našim problemom? Podsetimo se greške koju smo ranije dobili:
$ ./pg_repack -t tablename -o id
INFO: ponovo pakovanje tabele "tablename"
ERROR: upit je neuspješan:
    ERROR: dupli ključ vrijednost krši jedinstveno ograničenje "index_16508"
DETAIL: Ključ (id, index)=(100500, 42) već postoji.
Greška se javlja u trenutku kopiranja podataka iz log-tabele u novu tabelu. To izgleda čudno, jer se podaci u log-tabeli potvrđuju zajedno s podacima iz izvorne tabele. Ako zadovoljavaju ograničenja izvorne tabele, kako mogu kršiti ista ta ograničenja u novoj?
Ispostavilo se da je koren problema u prethodnom koraku rada pg_repack, na kojem se kreiraju samo indeksi, ali ne i ograničenja: u staroj tabeli je bilo jedinstveno ograničenje, a u novoj se umesto njega stvorio jedinstveni indeks.
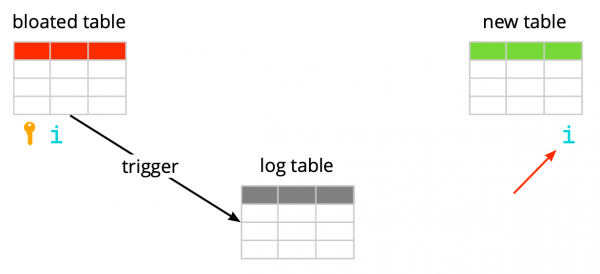
Važno je napomenuti da, ako je ograničenje obično, a ne odloženo, tada je stvoreni jedinstveni indeks ekvivalentan tom ograničenju, jer se jedinstvena ograničenja u Postgresu ostvaruju stvaranjem jedinstvenog indeksa. No, u slučaju odloženog ograničenja ponašanje nije isto, jer indeks ne može biti odložen i uvek se proverava u trenutku izvršenja sql komande.
Dakle, suština problema leži u "odloženosti" provere: u izvornoj tabeli ona se vrši u trenutku potvrde, a u novoj – u trenutku izvršenja sql komande. To znači da treba da postignemo da se provere vrše na isti način u oba slučaja: ili uvek odloženo, ili uvek odmah.
Šta smo onda razmatrali?
Kreirati indeks, sličan deferred
Prva ideja je izvršiti oba pregleda u neposrednom režimu. To može izazvati nekoliko lažnih pozitivnih reakcija ograničenja, ali ako ih bude malo, to ne bi trebalo uticati na rad korisnika, jer su takvi konflikti za njih normalna situacija. Događaju se, na primer, kada dva korisnika počnu istovremeno uređivati isti vidžet, a klijent drugog korisnika ne stigne da primi informaciju da je vidžet već blokiran za uređivanje od strane prvog korisnika. U takvoj situaciji server odgovara drugom korisniku odbijanjem, a njegov klijent vraća promene i blokira vidžet. Malo kasnije, kada prvi korisnik završi uređivanje, drugi će dobiti informaciju da vidžet više nije blokiran i moći će ponovo da izvrši svoju akciju.
Da bi provere uvek bile u hitnom režimu, kreirali smo novi indeks, sličan originalnom odloženom ograničenju:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- run pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
Na testnom okruženju smo dobili samo nekoliko očekivanih grešaka. Uspeh! Ponovo smo pokrenuli pg_repack na produkciji i dobili 5 grešaka na prvom klasteru za sat rada. To je prihvatljiv rezultat. Međutim, već na drugom klasteru broj grešaka se povećao nekoliko puta i morali smo da zaustavimo pg_repack.
Zašto se to dogodilo? Verovatnoća nastanka greške zavisi od broja korisnika koji istovremeno rade sa istim vidžetima. Naizgled, u tom trenutku sa podacima koji se nalaze na prvom klasteru bilo je znatno manje konkurentnih promena nego na ostalima, tj. jednostavno smo imali "sreće".
Ideja nije uspela. U tom trenutku smo videli dva druga rešenja: da prepravimo naš aplikativni kod kako bismo se odrekli odloženih ograničenja, ili da "naučimo" pg_repack da radi s njima. Izabrali smo drugo.
Zameniti indekse u novoj tabeli sa odloženim ograničenjima iz izvorne tabele
Cilj dorade je bio očigledan – ako izvorna tabela ima odloženo ograničenje, nova treba da ima takvo ograničenje, a ne indeks.
Da bismo proverili naše promene, napisali smo jednostavan test:
- tabela sa odloženim ograničenjem i jednim unosom;
- ubacujemo u petlji podatke koji se sukobljavaju sa postojećim unosom;
- izvode update – podaci više ne konfliktišu;
- komitujemo izmene.
create table test_table
(
  id serial,
  val int,
  constraint uk_test_table__val unique (val) deferrable initially deferred
);
INSERT INTO test_table (val) VALUES (0);
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (0) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    COMMIT;
  END;
END LOOP;
Izvorna verzija pg_repack uvek je padala na prvom insertu, doradjena verzija radila je bez grešaka. Odlično.
Idemo na prod i ponovo dobijamo grešku u istoj fazi kopiranja podataka iz log-tabele u novu:
$ ./pg_repack -t tablename -o id
INFO: ponovo pakovanje tabele "tablename"
ERROR: upit je neuspješan:
    ERROR: dupli ključ vrijednost krši jedinstveno ograničenje "index_16508"
DETAIL: Ključ (id, index)=(100500, 42) već postoji.
Klasična situacija: na testnim okruženjima sve radi, a na produkciji — ne?!
APPLY_COUNT i spoj dva batch-a
Počeli smo da analiziramo kod bukvalno liniju po liniju i otkrili važnu stavku: prelivanje podataka iz log-tabele u novu dešava se u batch-evima, konstanta APPLY_COUNT je ukazivala na veličinu batch-a:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;
/* možda još uvek ima nekih tupla, ponovi. */
...
}
Problem je u tome što podaci izvorne transakcije, u kojoj nekoliko operacija može potencijalno prekršiti ograničenje, prilikom prenosa mogu da dospeju na spoj dva batch-a – polovina komandi će biti komitovana u prvom batch-u, a druga polovina — u drugom. I ovde kako bude: ako komande u prvom batch-u ništa ne krše, onda je sve u redu, a ako krše — dolazi do greške.
APPLY_COUNT je 1000 zapisa, što objašnjava zašto su naši testovi prolazili uspešno – nisu pokrivali slučaj “spoj batch-eva”. Koristili smo dve komande – insert i update, tako da su tačno 500 transakcija po dve komande uvek bile smeštene u batch i nismo imali problema. Nakon dodavanja drugog update-a, naš ispravak je prestao da funkcioniše:
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (1) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    UPDATE test_table set val = i where id = v_id; -- još jedan update
    COMMIT;
  END;
END LOOP;
Dakle, sledeći zadatak – učiniti tako da podaci iz izvorne tabele, koji su se menjali u jednoj transakciji, dospeju u novu tabelu takođe unutar jedne transakcije.
Odustajanje od batch-ovanja
I ponovo smo imali dva rešenja. Prvo: hajde da se uopšte odrekнемo razbijanja u serije i da prenosimo podatke jednom transakcijom. U prilog ovom rešenju govorila je njegova jednostavnost – potrebne izmene koda su minimalne (inache, u starijim verzijama je tada pg_reorg radio upravo tako). Ali postoji problem – kreiramo dugu transakciju, a to je, kao što je ranije rečeno, pretnja za pojačano bloat.
Drugo rešenje — složenije, ali verovatno ispravnije: kreirati u log-tabeli kolonu sa identifikatorom transakcije koja je dodala podatke u tabelu. Tada prilikom kopiranja podataka možemo grupisati ih po ovoj atibutu i garantovati da će povezane izmene biti prenete zajedno. Serija će se formirati od više transakcija (ili jedne velike) i njena veličina će se menjati u zavisnosti od toga koliko podataka je promenjeno u ovim transakcijama. Važno je napomenuti da pošto podaci različitih transakcija ulaze u log-tabelu nasumičnim redosledom, više nećemo moći da je čitamo sekvencijalno, kao što je to bilo ranije. seqscan pri svakoj upitu sa filtriranjem po tx_id – to je preskupo, potreban je indeks, ali će i on usporiti izvršenje metode zbog troškova njegovog ažuriranja. U suštini, kao i uvek, nešto se mora žrtvovati.
Dakle, odlučili smo da krenemo sa prvim rešenjem, kao jednostavnijim. Prvo je bilo potrebno razumeti da li će duga transakcija biti stvarni problem. Pošto je glavni prenos podataka iz stare tabele u novu takođe u jednoj dugoj transakciji, pitanje se preoblikovalo u “koliko ćemo povećati ovu transakciju?” Trajanje prve transakcije zavisi pretežno od veličine tabele. Trajanje nove – od toga koliko će promena akumulirati u tabeli tokom prenosa podataka, tj. od intenziteta opterećenja. Provođenje pg_repack obavilo se tokom minimalnog opterećenja na servis, a obim promena je bio nesrazmerno mali u poređenju sa početnim obimom tabele. Odlčili smo da možemo zanemariti vreme nove transakcije (u poređenju, u proseku to traje 1 sat i 2-3 minuta).
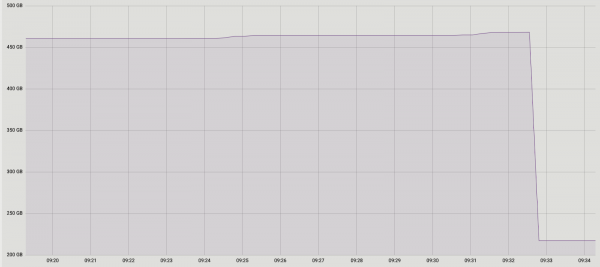
Eksperimenti su bili pozitivni. Pokretanje na produkciji takođe. Za ilustraciju – slika sa veličinom jedne od baza nakon procesa:
Budući da nas je ovo rješenje potpuno zadovoljilo, nismo se odlučili probati implementirati drugo, ali razmatramo mogućnost rasprave o tome s razvijačima ekstenzije. Naša trenutna dorada, nažalost, još nije spremna za objavljivanje, jer smo riješili problem samo s jedinstvenim odgođenim ograničenjima, a za potpuni ispravak potrebno je osigurati podršku i za druge tipove. Nadamo se da ćemo to moći ostvariti u budućnosti.
Moguće je da se pitate zašto smo se uopće upustili u ovu priču s doradom pg_repack, a ne koristimo njegove analoge? U nekom trenutku smo i mi o tome razmišljali, ali pozitivno iskustvo korištenja ranije, na tablicama bez odgođenih ograničenja, motiviralo nas je da pokušamo shvatiti suštinu problema i ispraviti ga. Osim toga, za korištenje drugih rješenja također je potrebno vrijeme za provođenje testova, pa smo odlučili prvo pokušati ispraviti problem u njemu, a ako shvatimo da to ne možemo učiniti u razumnom vremenu, onda ćemo početi razmatrati analoge.
Zaključci
Što možemo preporučiti na temelju vlastitog iskustva:
- Pratite svoj bloat. Na temelju podataka o monitoringu moći ćete razumjeti koliko dobro je podešen autovacuum.
- Podešavajte AUTOVACUUM da zadržite bloat na prihvatljivom nivou.
- Ako bloat i dalje raste i ne možete ga kontrolirati sredstvima 'iz kutije', ne bojte se koristiti vanjske ekstenzije. Najvažnije je dobro testirati sve.
- Ne bojte se doraditi vanjska rješenja prema svojim potrebama - ponekad ovo može biti učinkovitije i čak jednostavnije od promjene vašeg vlastitog koda.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish