

U okviru svoje delatnosti, susrećemo situacije u kojima programer piše upit i misli "baza je pametna, sama će se snaći!«
U nekim slučajevima (delimično zbog neznanja mogućnosti Baze podataka, delimično zbog preuranjene optimizacije), takav pristup dovodi do stvaranja 'frankenštajnov'.
Prvo ću dati primer takvog upita:
-- za svaku ključnu paru pronalazimo povezane vrednosti polja
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- pronalazimo min/max vrednosti za svaku prvu ključnu vrednost
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- povezujemo po prvom ključu ključne parove i min/max vrednosti
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
Da bismo konkretno procenili kvalitet upita, hajde da kreiramo neku proizvoljnu skup podataka:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
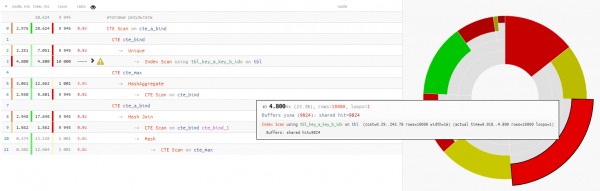
Ispostavlja se da je samo čitanje podataka trajalo manje od četvrtine ukupnog vremena izvršavanja upita:
Razmotrimo detaljno
Pažljivo ćemo pogledati upit i zapitati se:
- Zašto ovde WITH RECURSIVE, kada nema rekursivnih CTE-a?
- Zašto grupisati min/max vrednosti u posebnom CTE-u, kada se kasnije ionako povezuju sa originalnim izborom?
+25% vremena - Zašto koristiti ponovnu čitanje iz prethodnog CTE-a kroz bezuslovni 'SELECT * FROM' na kraju?
+14% vremena
U ovom slučaju smo imali sreće što je za spajanje izabran Hash Join, a ne Nested Loop, jer bismo tada dobili ne jedan jedini prolaz CTE Scan-a, već 10K!
malo o CTE Scan-uOvde treba podsjetiti da CTE Scan predstavlja analog Seq Scan-u — dakle, bez ikakve indeksacije, već samo potpuni premet, koji bi zahtevao 10K x 0.3ms = 3000ms tokom ciklusa po cte_max ili 1K x 1.5ms = 1500ms tokom ciklusa po cte_bind!
U stvari, šta smo želeli da dobijemo kao rezultat? Aha, obično upravo ovo pitanje navrati negde na 5. minutu analize 'trokatnih' upita.
Želeli smo da za svaku jedinstvenu ključnu paru prikazujemo min/max iz grupe po key_a.
Zato ćemo koristiti :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 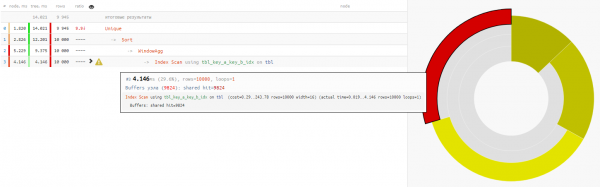
Budući da čitanje podataka u oba slučaja traje otprilike 4-5 ms, naša ukupna dobit po vremenu -32% — to je u čistom obliku opterećenje skinuto s CPU baze, ako se takav upit izvodi dovoljno često.
U suštini, ne bi trebalo teretiti bazu s 'okruglim — nositi, kvadratnim — kotrljati'.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish