

Ponekad programer ima potrebu proslijediti skup parametara ili čak cijeli odabir „na ulazu“. Ponekad se nađu vrlo čudna rješenja ovog problema.
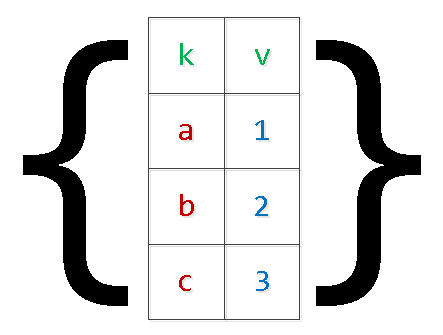
Idemo „od obrnuto“ i pogledajmo kako ne treba raditi, zašto i kako to može biti bolje.
Direktna „injekcija“ vrijednosti u tijelo upita
Obično izgleda otprilike ovako:
query = "SELECT * FROM tbl WHERE id = " + value… ili ovako:
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)O ovom načinu je rečeno, napisano i dovoljno:
Gotovo uvijek to je — direktan put do SQL injekcija i dodatnog opterećenja poslovne logike, koja mora "lijepiti" string vašeg upita.
Ovaj pristup može biti donekle opravdan samo u slučaju potrebe korištenja particioniranja u verzijama PostgreSQL 10 i ranije za postizanje efikasnijeg plana. U tim verzijama popis skeniranih particija se određuje još bez uzimanja u obzir proslijeđenih parametara, samo na osnovu tijela upita.
$n-argumenti
Korišćenje parametara — to je dobro, omogućava korištenje , smanjujući opterećenje kako na poslovnu logiku (string upita se formira i proslijeđuje samo jednom), tako i na DB server (ne zahtijeva ponovnu analizu i planiranje za svaki primjer upita).
Varijabilni broj argumenata
Problemi nas očekuju kada želimo proslijediti unaprijed nepoznat broj argumenata:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Ako ostavimo upit u ovom obliku, to će nas, iako će nas zaštititi od potencijalnih injekcija, i dalje primorati na sklapanje/analizu upita za svaku varijantu broja argumenata. Već je bolje, nego to raditi svaki put, ali se može izbjeći i bez toga.
Dovoljno je proslijediti samo jedan parametar koji sadrži serijaliziranu prezentaciju niza:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'Jedina razlika je potreba da se argument eksplicitno konvertuje u odgovarajući tip niza. No, to ne predstavlja problem, budući da već unaprijed znamo kamo se obraćamo.
Prosljeđivanje odabira (matrice)
Obično se radi o raznim načinima prosljeđivanja skupova podataka za umetanje u bazu "s jednim upitom":
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...Osim gore navedenih problema s "preklapanjem" zahtjeva, to nas može dovesti još i do nedostatka memorije i pada poslužitelja. Razlog je jednostavan — argumenti PG rezerviraju dodatnu memoriju, a broj zapisa u skupu ograničen je samo poslovnim željama logike. U posebno kliničkim slučajevima bilo je moguće vidjeti "numeričke" argumente veće od 9000 — nemojte tako.
Preformirajmo zahtjev primjenom "dvostepene" serijalizacije:
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Da, u slučaju "složenih" vrijednosti unutar niza, one se moraju obaviti navodnicima.
Jasno je da se na ovaj način može "proširiti" odabir s proizvoljnim brojem polja.
unnest, unnest, …
Povremeno se nalaze varijante prijenosa umjesto "niza nizova" nekoliko "nizova kolona", o kojima sam spomenuo :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Ovom metodom, greškom pri generiranju listi vrijednosti za različite kolone, vrlo je lako dobiti potpuno nepredviđene rezultate, koji zavise i od verzije poslužitelja:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
Počevši od verzije 9.3, PostgreSQL je uveo pune funkcije za rad s json tipom. Stoga, ako definicija ulaznih parametara kod vas prolazi kroz preglednik, možete direktno tamo formirati json-objekt za SQL upit:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
Za prethodne verzije isti način se može koristiti za each(hstore), ali ispravna "svrha" s escape-ovanjem složenih objekata u hstore može izazvati probleme.
json_populate_recordset
Ako unaprijed znate da će podaci iz "ulaznog" json-niza ići za popunjavanje neke tabele, možete značajno uštedjeti na "dereferenciranju" polja i prevođenju u potrebne tipove, koristeći funkciju json_populate_recordset:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
A ova funkcija jednostavno "proširuje" proslijeđeni niz objekata u odabir, ne oslanjajući se na format tabele:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
TEMPORARY TABLE
Ali ako je volumen podataka u prenosnom uzorku veoma velik, onda je teško ili čak nemoguće sve to staviti u jedan serializovani parametar, jer to zahteva jednokratno izdvajanje velikog volumena memorije. Na primer, potrebno je dugo sakupljati veliki paket podataka o događajima iz spoljnog sistema, a zatim želite da ga obradite jednom na strani Baze Podataka.
U tom slučaju, najbolje rešenje bi bilo korišćenje :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- ponoviti mnogo, mnogo puta
...
-- ovde radimo nešto korisno sa celom ovom tabelom
Ova metoda je dobra posebno za retku prenos velikih volumena podataka.
Sa stanovišta opisa strukture vlastitih podataka, privremena tabela se od "obične" razlikuje samo po jednom svojstvu u sistemskoj tabeli pg_class, a u pg_type, pg_depend, pg_attribute, pg_attrdef, … — jednostavno ne razlikuje ni po čemu.
Zato će u web sistemima sa velikim brojem kratkotrajnih konekcija, svaka od njih generisati nove sistemske zapise svaki put, koji se brišu zatvaranjem konekcije sa BDP-om. Kao rezultat, nekontrolisana upotreba TEMP TABLE dovodi do "proširenja" tabela u pg_catalog i usporava mnoge operacije koje ih koriste.
Naravno, možete se boriti protiv ovoga uz pomoć periodičnog prolaska VACUUM FULL kroz tabele sistemskog kataloga.
Session Variables
Pretpostavimo da je obrada podataka iz prethodnog slučaja dovoljno složena za jedan SQL upit, ali želimo to raditi često. Dakle, želimo koristiti proceduralnu obradu u , ali bi korišćenje prenos podataka preko privremenih tabela bilo previše kostantno.
Takođe ne možemo koristiti $n-parametre za prenos u anonimni blok. Rešenje će nam pružiti sesijske promenljive i funkcija current_setting.
Do verzije 9.2 bilo je potrebno unapred konfigurisati custom_variable_classes za "svoje" sesijske promenljive. U aktuelnim verzijama možete napisati otprilike ovako:
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- NOTICE:  id : 1
-- NOTICE:  id : 2
-- NOTICE:  id : 3
Na drugim podržanim proceduralnim jezicima možete pronaći i druga rešenja.
Znate li još načine? Podelite u komentarima!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish