

Postavio sam na Github .
Ovo je jednostavna hash tabela za GPU koja može obraditi stotine miliona umetanja u sekundi. Na mom laptopu sa NVIDIA GTX 1060, kod umetne 64 miliona nasumično generisanih parova ključ-vrednost za otprilike 210 ms i uklanja 32 miliona parova za otprilike 64 ms.
Dakle, brzina na laptopu iznosi otprilike 300 miliona umetanja/sek i 500 miliona brisanja/sek.
Tabela je napisana u CUDA-i, iako se ista metoda može primeniti na HLSL ili GLSL. Implementacija ima nekoliko ograničenja koja obezbeđuju visoke performanse na grafičkoj kartici:
- Obrađuju se samo 32-bitni ključevi i iste takve vrednosti.
- Hash tabela ima fiksnu veličinu.
- I ta veličina mora biti jednaka stepenima dva.
Za ključeve i vrednosti potrebno je rezervisati jednostavni razdvojni marker (u datom kodu to je 0xffffffff).
Hash tabela bez zaključavanja
U hash tabeli se koristi otvorena adresacija sa , to jest to je jednostavno niz parova ključ-vrednost koji se čuva u memoriji i ima izvanrednu keš performansu. To se ne može reći za povezivanje u lance (chaining), što podrazumeva pretragu pokazivača u povezanoj listi. Hash tabela je jednostavni niz koji čuva elemente KeyValue:
struct KeyValue
{
    uint32_t key;
    uint32_t value;
};
Veličina tabele je moć u stepenu, a ne prosto broj, jer za primenu pow2/AND-maske treba samo jedna brza instrukcija, dok operator modula radi mnogo sporije. Ovo je važno u slučaju linearnih sondiranja, jer pri linearnom pretraživanju po tabeli indeks slota mora biti obavijen u svaki slot. A kao rezultat dodaje se trošak operacije modula u svakom slotu.
Tabela čuva samo ključ i vrednost za svaki element, a ne haš ključa. Pošto tabela čuva samo 32-bitne ključeve, haš se izračunava veoma brzo. U datom kodu koristi se Murmur3 haš koji izvodi samo nekoliko pomeranja, XOR-ova i množenja.
U hash-tabeli se koristi metod zaštite od blokada koji ne zavisi od redosleda u smeštaju u memoriji. Čak i ako neke operacije zapisivanja narušavaju redosled drugih takvih operacija, hash-tabela će i dalje zadržati ispravno stanje. O tome ćemo govoriti u nastavku. Ova metoda se odlično pokazuje sa grafičkim karticama gde se konkurentno izvršava hiljade tokova.
Ključevi i vrednosti u hash-tabeli se inicijalizuju kao prazni.
Kod se može modifikovati kako bi mogao obraditi i 64-bitne ključeve i vrednosti. Za ključeve su potrebne atomske operacije čitanja, zapisivanja i poređenja sa zamenom (compare-and-swap). A za vrednosti su potrebne atomske operacije čitanja i zapisivanja. Srećom, u CUDA operacije čitanja-zapisivanja za 32- i 64-bitne vrednosti su atomske sve dok su pravilno poravnate (vidi ), a savremene grafičke kartice podržavaju 64-bitne atomske operacije poređenja sa zamenom. Naravno, prelazak na 64 bita donekle smanjuje performanse.
Stanje hash-tabele
Svaka par ključeva i vrednosti u hash-tabeli može imati jedno od četiri stanja:
- Ključ i vrednost su prazni. U tom stanju hash-tabela se inicijalizuje.
- Ključ je zapisan, a vrednost još nije. Ako drugi tok izvršavanja u tom trenutku čita podatke, onda vraća praznu vrednost. To je u redu, isto bi se desilo da je drugi tok izvršavanja završio malo ranije, a govorimo o konkurentnoj strukturi podataka.
- I ključ i vrednost su zapisani.
- Vrednost je dostupna za druge tokove izvršavanja, dok ključ još nije. To se može desiti jer model programiranja u CUDA podrazumeva slabo uredjen model memorije. To je normalno, u svakom slučaju ključ je još uvek prazan, čak iako vrednost više nije.
Bitna napomena je da, čim je ključ upisan u slot, ostaje na tom mestu — čak i ako je ključ obrisan, o tome ćemo razgovarati u nastavku.
Kod hash-tabele funkcioniše čak i sa slabije uređenim modelima memorije, gde redosled čitanja i pisanja u memoriju nije poznat. Kada budemo razmatrali umetanje, pretraživanje i brisanje u hash-tabeli, imajte na umu da se svaka par ključeva i vrednosti nalazi u jednom od četiri prethodno opisane stanja.
Umetanje u hash-tabelu
CUDA funkcija koja umetne parove ključ-vrijednost u hash tablicu izgleda ovako:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
Za umetanje ključa, kod iterira kroz niz hash tablice počinjući od hash-a umetnutog ključa. U svakoj poziciji niza vrši se atomska operacija poređenja s zamjenom, pri čemu se ključ u toj poziciji poredi s praznim. Ako se otkrije nesukladnost, ključ u poziciji se ažurira na umetnuti ključ, a zatim se vraća originalni ključ pozicije. Ako je taj originalni ključ bio prazan ili odgovarao umetnutom ključu, to znači da je kod pronašao odgovarajuću poziciju za umetanje i unosi umetnutu vrijednost.
Ako u jednom pozivu jezgre gpu_hashtable_insert() ima više elemenata sa istim ključem, tada može biti zapisano bilo koja od tih vrijednosti u slot ključa. To se smatra normalnim: jedna od operacija zapisa ključ-vrijednost tokom poziva biće uspješna, ali pošto se sve to dešava paralelno u okviru nekoliko izvršnih nitova, ne možemo predvidjeti koja operacija zapisa u memoriju će biti posljednja.
Pretraga u hash tablici
Kod za pretragu ključeva:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key)
{
        uint32_t slot = hash(key);

        while (true)
        {
            if (hashtable[slot].key == key)
            {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty)
            {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
Da bismo pronašli vrijednost ključa koja se čuva u tablici, iteriramo kroz niz počinjući od hash-a traženog ključa. U svakoj poziciji provjeravamo da li je ključ taj koji tražimo, i ako jeste, vraćamo njegovu vrijednost. Također provjeravamo da li je ključ prazan, i ako jeste, prekidamo pretragu.
Ako ne uspijemo pronaći ključ, kod vraća praznu vrijednost.
Sve te operacije pretrage mogu se izvoditi konkurentno tokom umetanja i brisanja. Svaki par u tablici će imati za nit jedan od četiri prethodno opisane statusa.
Brisanje u hash tablici
Kod za brisanje ključeva:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
Brisanje ključa se vrši na neobičan način: ostavljamo ključ u tabeli i označavamo njegovu vrednost (ne ključ sam) kao praznu. Ovaj kod je vrlo sličan lookup(), osim što pri otkrivanju podudaranja po ključu postavlja njegovu vrednost na praznu.
Kao što je ranije pomenuto, nakon što je ključ zabeležen u slotu, on se više ne pomera. Čak i prilikom brisanja elementa iz tabele, ključ ostaje na svom mestu, samo njegova vrednost postaje prazna. To znači da nam nije potrebna atomarna operacija pisanja vrednosti slota, jer nije važno da li je trenutna vrednost prazna ili ne — ona će svakako postati prazna.
Promena veličine hesh tabele
Veličinu hesh tabele možemo promeniti kreiranjem veće tabele i ubacivanjem nepraznih elemenata iz stare tabele. Ovu funkcionalnost nisam implementirao jer sam hteo da zadržim uzorak koda jednostavnim. Štaviše, u CUDA programima, alokacija memorije se često vrši u kodu domaćina, a ne u CUDA jezgru.
U članku opisuje kako menjati takvu strukturu podataka zaštićenu od blokada.
Konkurentnost
U gorenavedenim delovima koda funkcije gpu_hashtable_insert(), _lookup() i _delete() obrađuju po jedan par ključ-vrednost odjednom. A ispod gpu_hashtable_insert(), _lookup() i _delete() obrađuju niz parova paralelno, svaki par u zasebnom GPU niti izvršenja:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
Hesh tabela sa zaštitom od blokada podržava konkurentne umetanja, pretrage i brisanja. Pošto su parovi ključ-vrednost uvek u jednom od četiri stanja, a ključevi se ne pomeraju, tabela garantuje tačnost čak i pri istovremenom korišćenju operacija različitih vrsta.
Međutim, ako paralelno obrađujemo paket umetanja i brisanja, i ako u ulaznom nizu parova postoje duplirani ključevi, nećemo moći da predvidimo koji parovi će "pobediti" — biti zapisana u hesh tabelu poslednji. Recimo da smo pozvali kod umetanja sa ulaznim nizom parova A/0 B/1 A/2 C/3 A/4. Kada se kod završi, parovi B/1 i C/3 garantovano će biti prisutni u tabeli, ali će se u njoj nalaziti bilo koji od parova A/0, A/2 ili A/4To je može biti problem, a može i ne biti — zavisi od primene. Možete unapred znati da u ulaznom nizu nema duplih ključeva, ili vam možda nije važno koje je vrednost poslednja.
Ako je to za vas problem, treba podeliti duple parove po različitim sistemskim CUDA pozivima. U CUDA, svaka operacija sa pozivom jezgra uvek se završava pre sledećeg poziva jezgra (barem unutar jednog toka. U različitim tokovima, jezgra se izvršavaju paralelno). Ako u gornjem primeru pozovete jedno jezgro sa A/0 B/1 A/2 C/3, a drugo sa A/4, tada ključ A će dobiti vrednost 4.
Sada ćemo razgovarati o tome da li funkcije lookup() i delete() treba da koriste običan (plain) ili promenljivi (volatile) pokazivač na niz parova u heš tabeli. navodi da:
Kompajler može po svom nahođenju optimizovati operacije čitanja i pisanja u globalnu ili zajedničku memoriju… Ove optimizacije se mogu onemogućiti pomoću ključne reči
volatile: … bilo koja referenca na ovu promenljivu kompilira se u pravu instrukciju čitanja ili pisanja u memoriju.
Razmatranja o ispravnosti ne zahtevaju primenu volatile. Ako izvršni tok koristi keširanu vrednost iz ranije operacije čitanja, to znači da će koristiti malo zastarelu informaciju. Ali to je svejedno informacija iz ispravnog stanja heš tabele u određenom trenutku poziva jezgra. Ako vam je potrebna najsvežija informacija, možete koristiti pokazivač volatile, ali tada će se malo smanjiti performanse: po mojim testovima — pri brisanju 32 miliona elemenata, brzina je opala sa 500 miliona brisanja/sek na 450 miliona brisanja/sek.
Performanse
U testu umetanja 64 miliona elemenata i brisanja 32 miliona od njih, konkurencija između std::unordered_map i heš tabele za GPU zapravo ne postoji:
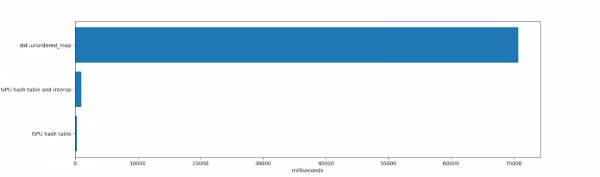
std::unordered_map potrošila je 70.691 ms na umetanje i brisanje elemenata sa daljim oslobađanjem unordered_map (oslobađanje od miliona elemenata traje dugo, jer unutar unordered_map se izvršavaju brojne alokacije memorije). Iskreno, kod std:unordered_map sasvim drugačija ograničenja. Ovo je jedinstveni CPU tok izvršavanja, koji podržava ključ-vrednosti bilo koje veličine, dobro funkcioniše pri visokim koeficijentima korišćenja i pokazuje stabilne performanse nakon brojnih brisanja.
Trajanje rada hash tabele za GPU i međuprogramsko komuniciranje iznosilo je 984 ms. Ovo uključuje vreme provedeno na smeštanju tabele u memoriji i njenom brisanju (jednokratno dodeljivanje 1 GB memorije, što u CUDA-u traje neko vreme), umetanje i brisanje elemenata, kao i iteraciju kroz njih. Takođe se uzimaju u obzir sve kopije u memoriju i iz memorije grafičke kartice.
Rad same hash tabele je trajao 271 ms. Ovo uključuje vreme koje grafička kartica troši na umetanje i brisanje elemenata, i ne uzima u obzir vreme za kopiranje u memoriju i iteraciju kroz dobijenu tabelu. Ako GPU tabela postoji duže vreme, ili ako se hash tabela u potpunosti čuva u memoriji grafičke kartice (na primer, za kreiranje hash tabele koja će se koristiti drugim GPU kodom, a ne centralnim procesorom), tada su rezultati testiranja relevantni.
Hash tabela za grafičke kartice pokazuje visoke performanse zahvaljujući velikoj propusnosti i aktivnom paralelizmu.
Nedostaci
Arhitektura hash tabela ima nekoliko problema na koje treba obratiti pažnju:
- Linearno soniranje ometa klasterizacija, zbog koje se ključevi u tabeli raspoređuju prilično daleko od idealnog.
- Ključevi se ne brišu pomoću funkcije
izbrisatii vremenom zagušuju tabelu.
Kao rezultat, performanse hash tabele mogu postupno opadati, posebno ako postoji duže vreme i u njoj se vrši mnoštvo umetanja i brisanja. Jedan od načina da se ublaže ovi nedostaci je prehashiranje u novu tabelu sa dovoljno niskim koeficijentom korišćenja i filtriranje obrisanih ključeva prilikom prehashiranja.
Da ilustrujem opisane probleme, koristiću gornji kod za kreiranje tabele od 128 miliona elemenata, ciklično ću umetati 4 miliona elemenata dok ne popunim 124 miliona mesta (koeficijent korišćenja oko 0,96). Ovo su rezultati, svaka linija predstavlja poziv CUDA jezgri za umetanje 4 miliona novih elemenata u jednu hash tabelu:
Koeficijent korišćenja
Trajanje umetanja 4 194 304 elemenata
0,00
11,608448 ms (361,314798 miliona ključeva/sek.)
0,03
11,751424 ms (356,918799 miliona ključeva/sek.)
0,06
11,942592 ms (351,205515 miliona ključeva/sek.)
0,09
12,081120 ms (347,178429 miliona ključeva/sek.)
0,12
12,242560 ms (342,600233 miliona ključeva/sek.)
0,16
12,396448 ms (338,347235 miliona ključeva/sek.)
0,19
12,533024 ms (334,660176 miliona ključeva/sek.)
0,22
12,703328 ms (330,173626 miliona ključeva/sek.)
0,25
12,884512 ms (325,530693 miliona ključeva/sek.)
0,28
13,033472 ms (321,810182 miliona ključeva/sek.)
0,31
13,239296 ms (316,807174 miliona ključeva/sek.)
0,34
13,392448 ms (313,184256 miliona ključeva/sek.)
0,37
13,624000 ms (307,861434 miliona ključeva/sek.)
0,41
13,875520 ms (302,280855 miliona ključeva/sek.)
0,44
14,126528 ms (296,909756 miliona ključeva/sek.)
0,47
14,399328 ms (291,284699 miliona ključeva/sek.)
0,50
14,690304 ms (285,515123 miliona ključeva/sek.)
0,53
15,039136 ms (278,892623 miliona ključeva/sek.)
0,56
15,478656 ms (270,973402 miliona ključeva/sek.)
0,59
15,985664 ms (262,379092 miliona ključeva/sek.)
0,62
16,668673 ms (251,627968 miliona ključeva/sek.)
0,66
17,587200 ms (238,486174 miliona ključeva/sek.)
0,69
18,690048 ms (224,413765 miliona ključeva/sek.)
0,72
20,278816 ms (206,831789 miliona ključeva/sek.)
0,75
22,545408 ms (186,038058 miliona ključeva/sek.)
0,78
26,053312 ms (160,989275 miliona ključeva/sek.)
0,81
31,895008 ms (131,503463 miliona ključeva/sek.)
0,84
42,103294 ms (99,619378 miliona ključeva/sek.)
0,87
61,849056 ms (67,815164 miliona ključeva/sek.)
0,90
105,695999 ms (39,682713 miliona ključeva/sek.)
0,94
240,204636 ms (17,461378 miliona ključeva/sek.)
Kako se koeficijent iskorišćenosti povećava, performanse opadaju. To je nepoželjno u većini slučajeva. Ako aplikacija umetne elemente u tabelu, a potom ih izbaci (na primer, prilikom brojanja reči u knjizi), to nije problem. Ali ako aplikacija koristi dugotrajnu heš tabelu (na primer, u grafičkom editoru za čuvanje ne-praznih delova slika, kada korisnik često umetne i uklanja informacije), takvo ponašanje može stvoriti probleme.
Izmerio sam dubinu sondiranja heš tabele nakon 64 miliona umetanja (koeficijent iskorišćenosti 0,5). Prosečna dubina iznosila je 0,4774, tako da su se većina ključeva nalazili u najbolje moguće slotove, ili u jednom slotu od najbolje pozicije. Maksimalna dubina sondiranja iznosila je 60.
Zatim sam izmerio dubinu sondiranja u tabeli sa 124 miliona umetanja (koeficijent iskorišćenosti 0,97). Prosečna dubina je sada bila 10,1757, a maksimalna - 6474 (!!). Performanse linearne sondiranja značajno opadaju pri visokim koeficijentima iskorišćenosti.
Najbolje je održavati niski koeficijent iskorišćenja ove heš tablice. Ali tada povećavamo performanse na račun potrošnje memorije. Na sreću, u slučaju sa 32-bitnim ključevima i vrednostima, to može biti opravdano. Ako u gornjem primeru, u tabeli sa 128 miliona elemenata, održimo koeficijent iskorišćenja 0,25, moći ćemo smestiti najviše 32 miliona elemenata, dok će preostalih 96 miliona slotova biti izgubljeno — po 8 bajtova po paru, 768 MB izgubljene memorije.
Imajte na umu da se ovde radi o gubitku memorije grafičke kartice, koja je vredniji resurs od sistemske memorije. Iako većina modernih desktop grafičkih kartica koje podržavaju CUDA imaju bar 4 GB memorije (u vreme pisanja, NVIDIA 2080 Ti ima 11 GB), i dalje neće biti mudro gubiti takve količine.
Kasnije ću detaljnije pisati o kreiranju heš tablica za grafičke kartice koje nemaju problema sa dubinom sondiranja, kao i o načinima ponovnog korišćenja uklonjenih slotova.
Merenje dubine sondiranja
Da bismo odredili dubinu sondiranja ključa, možemo izvući heš ključa (njegov idealni indeks u tabeli) iz njegovog stvarnog tabličnog indeksa:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
Zbog magije dva binarna broja u dodatnom kodu i činjenice da je kapacitet heš tablice jednak stepenima dvojke, ovaj pristup će raditi čak i kada se indeks ključa premesti na početak tabele. Uzmimo ključ koji se hešira u 1, ali je umetnut u slot 3. Tada za tabelu sa kapacitetom 4 dobijamo (3 — 1) & 3, što je ekvivalentno 2.
Zaključak
Ako imate pitanja ili komentare, javite mi na ili otvorite novu temu u.
Ovaj kod je napisan pod inspiracijom divnih članaka:
U budućnosti ću nastaviti da pišem o implementacijama heš tablica za grafičke kartice i analiziraću njihove performanse. U planu su mi vezivanje u lanac, Robin Hood heširanje i kukavice heširanje uz korišćenje atomskih operacija u strukturama podataka koje su pogodne za grafičke kartice.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish