

Imali smo 2 vreće trave, 75 tableta meskalina, unix okruženje, docker repozitorij i zadatak da implementiramo komande docker pull i docker push bez docker klijenta.
UPD:
Pitanje: Zašto sve ovo?
Odgovor: Opterećenje testiranja proizvoda (NE pomoću basha, skripte su date u obrazovne svrhe). Odlučeno je da se ne koristi docker klijent kako bi se smanjile dodatne slojeve (u razumnim granicama) i tako emulirala veća opterećenja. Kao rezultat, uklonili smo sve sistemske kašnjenja docker klijenta. Dobijeno je relativno čisto opterećenje direktno na proizvod.
U članku su korišteni GNU alati.
Prvo ćemo razjasniti šta rade ove komande.
Dakle, čemu služi docker pull? Prema :
"Pull an image or a repository from a registry."
Tu nalazimo vezu na .
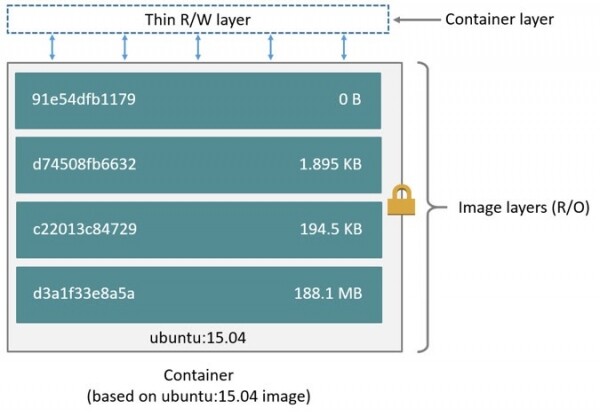
Odavde možemo shvatiti da je docker image skup određenih slojeva koji sadrže informacije o poslednjim promenama u imidžu, koje su nam očigledno potrebne. Dalje gledamo u .
Ovde se kaže sledeće:
"An 'image' is a combination of a JSON manifest and individual layer files. The process of pulling an > image centers around retrieving these two components."
Dakle, prvi korak prema dokumentaciji je “Pulling an Image Manifest”.
Negaćemo ga povući, ali su nam podaci iz njega potrebni. Dalje sledi primer zahteva: GET /v2/{name}/manifests/{reference}
"The name and reference parameter identify the image and are required. The reference may include a tag or digest."
Naš docker repozitorij je postavljen lokalno, pokušajmo izvršiti zahtev:
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/manifests/1.1.1" -H "header_if_needed"
U odgovoru dobijamo json iz kojeg su nam trenutno zanimljive samo slojevi, tačnije njihovi heševi. Kada ih dobijemo, možemo proći kroz svaki i izvršiti sledeći zahtev: "GET /v2/{name}/blobs/{digest}"
“Access to a layer will be gated by the name of the repository but is identified uniquely in the registry by digest.”
digest u ovom slučaju je heš koji smo dobili.
Pokušavamo
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/blobs/sha256:f972d139738dfcd1519fd2461815651336ee25a8b54c358834c50af094bb262f" -H "header_if_needed" --output firstLayer
pogledajmo kakav smo fajl konačno dobili kao prvi sloj.
file firstLayer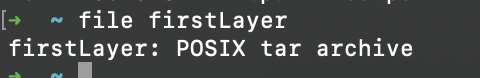
tj. slojevi predstavljaju tar arhive, a raspakovanjem u odgovarajućem redosledu dobijamo sadržaj imidža.
Napišimo mali bash skript kako bismo sve ovo mogli automatizovati.
#!/bin/bash -eu

downloadDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
imageName=$3
tag=$4

# array of layers
layers=($(curl -s -X GET "$url/v2/$imageName/manifests/$tag" | grep -oP '(?<=blobSum" : ").+(?=")'))

# download each layer from array
for layer in "${layers[@]}"; do
    echo "Downloading ${layer}"
    curl -v -X GET "$url/v2/$imageName/blobs/$layer" --output "$downloadDir/$layer.tar"
done

# find all layers, untar them and remove source .tar files
cd "$downloadDir" && find . -name "sha256:*" -exec tar xvf {} ;
rm sha256:*.tar
exit 0
Sada možemo pokrenuti s željenim parametrima i dobiti sadržaj potrebnog imidža
.\/script.sh dirName "http:\/\/localhost:8081\/link\/to\/docker\/registry" myAwesomeImage 1.0Deo 2 — docker push
Tu će biti malo složenije.
Ponovo ćemo početi s . Dakle, treba da učitamo svaki sloj, skupimo odgovarajući manifest i učitamo ga takođe. Na prvi pogled izgleda jednostavno.
Istražujući dokumentaciju, možemo podeliti proces učitavanja na nekoliko koraka:
- Inicijalizacija procesa — "POST \/v2\/{repoName}\/blobs\/uploads\/")
- Učitavanje sloja (koristićemo monolitno učitavanje, tj. svaki sloj šaljemo u celini) — "PUT \/v2\/{repoName}\/blobs\/uploads\/{uuid}?digest\={digest}
Content-Length: {size of layer}
Content-Type: application\/octet-stream
Layer Binary Data". - Učitavanje manifesta — "PUT \/v2\/{repoName}\/manifests\/{reference}".
Ali u dokumentaciji je izostavljen jedan korak, bez kojeg ništa neće funkcionisati. Za monolitno učitavanje, kao i za delimično (chunked), pre nego što učitate sloj, potrebno je izvršiti PATCH zahtev:
"PATCH \/v2\/{repoName}\/blobs\/uploads\/{uuid}
Content-Length: {size of chunk}
Content-Type: application\/octet-stream
{Layer Chunk Binary Data}".
U suprotnom, nećete moći da napredujete dalje od prve tačke, jer umesto očekivanog koda odgovora 202 dobićete 4xx.
Sada algoritam izgleda ovako:
- Inicijalizacija
- Patch sloja
- Učitavanje sloja
- Učitavanje manifesta
Tačke 2 i 3 će se ponavljati onoliko puta koliko je potrebno učitati slojeva.
Za početak će nam biti potreban bilo koji imidž. Koristiću archlinux:latest
docker pull archlinux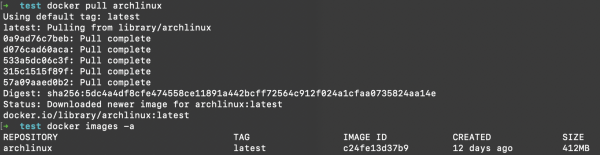
Sada ćemo ga sačuvati lokalno za dalju obradu
docker save c24fe13d37b9 -o savedArch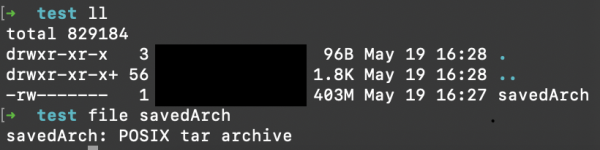
Raspakovaćemo dobijeni arhiv u trenutnu direktoriju
tar xvf savedArch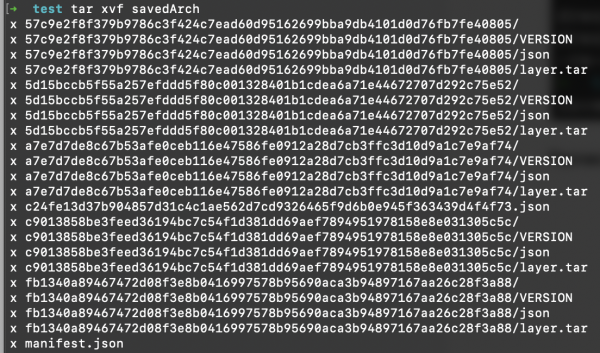
Kao što vidimo, svaki sloj se nalazi u posebnoj fascikli. Sada ćemo pogledati strukturu manifesta koji smo dobili
cat manifest.json | json_pp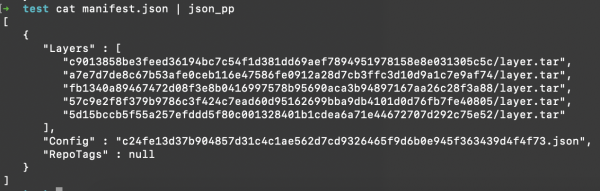
Nije bogato. Pogledaćemo koji manifest je potreban za učitavanje, prema .
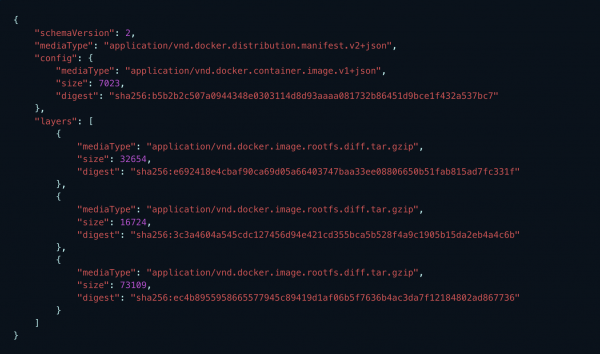
Očigledno postojeći manifest nam ne odgovara, pa ćemo napraviti svoj s crnim ženom i kurvama slojevima i konfiguracijama.
Uvek će imati minimum jedan config fajl i niz slojeva. Verzija sheme 2 (aktuelna u trenutku pisanja članka), mediaType ostavljamo nepromenjenim:
echo ‘{
   "schemaVersion": 2,
   "mediaType": "application/vnd.docker.distribution.manifest.v2+json",
   "config": {
      "mediaType": "application/vnd.docker.container.image.v1+json",
      "size": config_size,
      "digest": "config_hash"
   },
   "layers": [
      ’ > manifest.json
Nakon kreiranja osnovnog manifesta, potrebno je napuniti ga validnim podacima. Za to ćemo koristiti šablon json objekta sloja:
{
         "mediaType": "application\/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      },
to ćemo dodavati u manifest za svaki sloj.
Dalje, trebamo saznati veličinu konfiguracijske datoteke i zamijeniti oznake u manifestu s stvarnim podacima.
sed -i "s/config_size/$configSize/g; s/config_hash/$configName/g" $manifestFileSada možemo pokrenuti proces učitavanja i sačuvati uuid koji prati sve naredne zahtjeve.
Potpuni skript izgleda otprilike ovako:
#!/bin/bash -eux

imageDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
repoName=$3
tag=$4
manifestFile=$(readlink -f ${imageDir}/manifestCopy)
configFile=$(readlink -f $(find $imageDir -name "*.json" ! -name "manifest.json"))

# calc layers sha 256 sum, rename them accordingly, and add info about each to manifest file
function prepareLayersForUpload() {
  info_file=$imageDir/info
  # lets calculate layers sha256 and use it as layers names further
  layersNames=($(find $imageDir -name "layer.tar" -exec shasum -a 256 {} ; | cut -d" " -f1))

  # rename layers according to shasums. !!!Set required amount of fields for cut command!!!
  # this part definitely can be done easier but i didn't found another way, sry
  find $imageDir -name "layer.tar" -exec bash -c 'mv {} "$(echo {} | cut -d"/" -f1,2)/$(shasum -a 256 {} | cut -d" " -f1)"' ;

  layersSizes=($(find $imageDir -name "*.tar" -exec ls -l {} ; | awk '{print $5}'))

  for i in "${!layersNames[@]}"; do
    echo "{
         "mediaType": "application/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      }," >> $manifestFile
  done
  # remove last ','
  truncate -s-2 $manifestFile
  # add closing brakets to keep json consistent
  printf "nt]n}" >> $manifestFile
}

# calc config sha 256 sum and add info about it to manifest
function setConfigProps() {
  configSize=$(ls -l $configFile | awk '{print $5}')
  configName=$(basename $configFile | cut -d"." -f1)

  sed -i "s/config_size/$configSize/g; s/config_hash/$configName/g" $manifestFile
}

#prepare manifest file
prepareLayersForUpload
setConfigProps
cat $manifestFile

# initiate upload and get uuid
uuid=$(curl -s -X POST -I "$url/v2/$repoName/blobs/uploads/" | grep -oP "(?<=Docker-Upload-Uuid: ).+")

# patch layers
# in data-binary we're getting absolute path to layer file
for l in "${!layersNames[@]}"; do
  pathToLayer=$(find $imageDir -name ${layersNames[$l]} -exec readlink -f {} ;)
    curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: ${layersSizes[$i]}"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$pathToLayer"

# put layer
  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:${layersNames[$i]}"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: ${layersSizes[$i]}"
  --data-binary "@$pathToLayer"
done

# patch and put config after all layers
curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: $configSize"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$configFile"

  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:$configName"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: $configSize"
  --data-binary "@$configFile"

# put manifest
curl -v -X PUT "$url/v2/$repoName/manifests/$tag"
  -H 'Content-Type: application/vnd.docker.distribution.manifest.v2+json'
  --data-binary "@$manifestFile"

exit 0
možemo koristiti gotov skript:
./uploadImage.sh "~\/path\/to\/saved\/image" "http:\/\/localhost:8081\/link\/to\/docker\/registry" myRepoName 1.0UPD:
Što smo dobili kao rezultat?
Prvo, stvarne podatke za analizu, s obzirom na to da se testovi pokreću u blazemeteru i podaci o zahtjevima Docker klijenta nisu baš informativni u usporedbi s čistim HTTP zahtjevima.
Drugo, prijelaz nam je omogućio da povećamo broj virtualnih korisnika za Docker upload za otprilike 150% i da postignemo vrijeme odgovora prosječno 20-25% brže. Za Docker download uspjeli smo povećati broj korisnika za 500%, dok je prosječno vrijeme odgovora smanjeno za otprilike 60%.
Hvala na pažnji.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish