

Prije nekoliko mjeseci — javni za PostgreSQL.
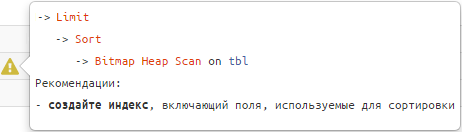
Tokom ovog vremena, već ste ga koristili više od 6000 puta, ali jedna od korisnih funkcija mogla je ostati neprimećena — to je strukturna uputstva, koja izgledaju otprilike ovako:
Slušajte ih, i vaši upiti će „postati glatki i svilenkasti“. 🙂
A ozbiljno, mnoge situacije koje čine upit sporim i „resursno intenzivnim“ su tipične i mogu se prepoznati po strukturi i podacima plana.
U tom slučaju, svakom pojedinačnom programeru neće biti potrebno da samostalno pronađe opciju optimizacije, oslanjajući se isključivo na svoje iskustvo — možemo mu dati naznaku šta se dešava, u čemu može biti uzrok, i kako se može prići rešenju. Što smo i učinili.
Hajde da malo detaljnije razmotrimo ove slučajeve — kako se definišu i kakvim preporukama vode.
Za bolje uranjanje u temu, prvo možete poslušati odgovarajući blok iz , a zatim preći na detaljnu analizu svakog primera:
#1: индексная «недосортировка»
Kada se pojavljuje
Prikazati poslednji račun za klijenta „OOO Kolokoličak“.
Kako prepoznati
-> Limit
   -> Sort
      -> Index [Samo] Skener [Unazad] | Bitmap Heap Skener
Preporuke
Korišćeni indeks proširiti poljima sortiranja.
Primer:
KREIRAJ TABELU tbl AS
SELEKTUJ
  generiši_niz(1, 100000) pk  -- 100K "činjenica"
, (random() * 1000)::integer fk_cli; -- 1K različitih stranih ključeva

KREIRAJ INDEX NA tbl(fk_cli); -- indeks za strani ključ

SELEKTUJ
  *
IZ
  tbl
GDE
  fk_cli = 1 -- filtriranje po konkretnoj vezi
ORDER BY
  pk DESC -- želimo samo jedan „poslednji“ zapis
LIMIT 1; 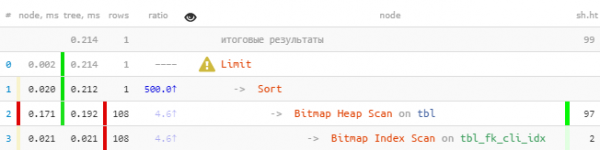
Odmah se može primetiti da je iz indeksa pročitano više od 100 zapisa, koji su zatim svi sortirani, a nakon toga ostavljen je jedini.
Ispravke:
OBRIŠI INDEX tbl_fk_cli_idx;
KREIRAJ INDEX NA tbl(fk_cli, pk DESC); -- dodali smo ključ sortiranja
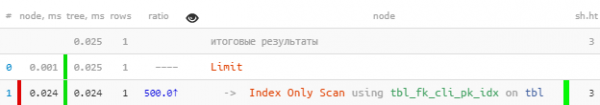
Čak i za tako primitivnu selekciju — 8.5 puta brže i 33 puta manji čitanja. Efekat će biti očigledniji što više „činjenica“ imate za svaku vrednost fk.
Primetiću da će takav indeks raditi kao „prefiksni“ ne lošije od prethodnog i za druge upite sa fk, gde sortiranja po pk nije bilo i nema (detaljnije o tome možete pročitati ). Uostalom, obezbediće i normalnu podršku za jasan strani ključ po ovom polju.
#2: пересечение индексов (BitmapAnd)
Kada se pojavljuje
Prikazati sve ugovore po klijentu „OOO Kolokoličak“, zaključene u ime „NAO Ljutik“.
Kako prepoznati
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Preporuke
Kreirati složeni indeks po poljima iz oba izvora ili proširiti jedan od postojećih polja iz drugog.
Primer:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "faktora"
, (random() *  100)::integer fk_org  -- 100 različitih stranih ključeva
, (random() * 1000)::integer fk_cli; -- 1K različitih stranih ključeva

CREATE INDEX ON tbl(fk_org); -- indeks za strani ključ
CREATE INDEX ON tbl(fk_cli); -- indeks za strani ključ

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- filtriranje po konkretnom paru 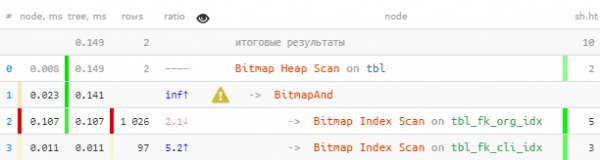
Ispravke:
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
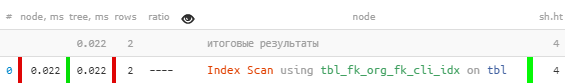
Ovdje je dobitak manji, budući da je Bitmap Heap Scan dovoljno efikasan sam po sebi. Ipak 7 puta brže i 2,5 puta manje čitanja.
#3: объединение индексов (BitmapOr)
Kada se pojavljuje
Prikazati prvih 20 najstarijih "svojih" ili nenih zahtjeva za obradu, s tim da su "svi" prioritet.
Kako prepoznati
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Preporuke
Koristiti UNION [ALL] za spajanje podupita po svakom od OR-blokova uslova.
Primer:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "faktora"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- sa verovatnoćom 1:16 zapis "neriješen"
    ELSE (random() * 100)::integer -- 100 različitih stranih ključeva
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- indeks sa "gotovo odgovarajućom" sortiranjem

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- svoji
  fk_own IS NULL -- ... ili "neriješeni"
ORDER BY
  pk
, (fk_own = 1) DESC -- prvo "svoji"
LIMIT 20;
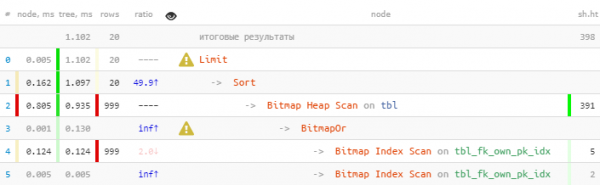
Ispravke:
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- prvo "svoji" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- zatim "neriješeni" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- ali ukupno - 20, više i nije potrebno 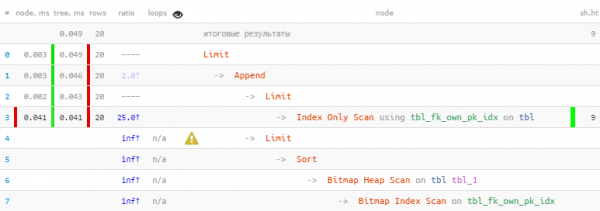
Iskoristili smo to što je svih 20 potrebnih zapisa već odmah dobijeno u prvom bloku, stoga drugi, s "skupljim" Bitmap Heap Scan, čak nije niti izvršen - na kraju 22 puta brže, 44 puta manje čitanja!
Detaljnije objašnjenje ove metode optimizacije na konkretnim primjerima može se pročitati u člancima i .
Generalizovana varijanta uređivanja filtriranja po više ključeva (a ne samo po paru const/NULL) obrađena je u članku .
#4: читаем много лишнего
Kada se pojavljuje
Obično se javlja kada želimo "dodati još jedan filter" postojećem upitu.
"A da li imate nešto slično, ali s bisernim dugmadima?» x/f "Biserna ruka"
Na primjer, modifikujući gornji zadatak, prikazati prvih 20 najstarijih "kritičnih" zahtjeva za obradu, bez obzira na njihovu namjenu.
Kako prepoznati
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && 5 × rows < RRbF -- filtrirano >80% pročitano
   && loops × RRbF > 100 -- i pritom više od 100 zapisa ukupno
Preporuke
Kreirati [specijalizovaniji] indeks s WHERE uslovom ili uključiti u indeks dodatna polja.
Ako je uslov filtriranja „statičan“ za vaše zadatke — dakle, ne podrazumijeva proširenje popisa vrijednosti u budućnosti — bolje je koristiti WHERE indeks. U ovu kategoriju dobro padaju različiti boolean/enum statusi.
Ako pak uslov filtriranja može imati različite vrijednosti,, onda je bolje proširiti indeks tim poljima — kao u situaciji sa BitmapAnd iznad.
Primer:
KREIRAJ TABELU tbl AS
SELECT
  generate_series(1, 100000) pk -- 100K "faktora"
, CASE
    KADA random() < 1::real/16 THEN NULL
    DRUGAČIJE (random() * 100)::integer -- 100 različitih stranih ključeva
  KRAJ fk_own
, (random() < 1::real/50) critical; -- 1:50, da li je zahtev "kritičan"

KREIRAJ INDeks NA tbl(pk);
KREIRAJ INDeks NA tbl(fk_own, pk);

SELECT
  *
FROM
  tbl
GDE
  critical
REDOSLEDOM PO
  pk
OGRANIČI 20; 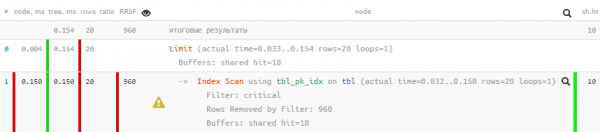
Ispravke:
KREIRAJ INDeks NA tbl(pk)
  GDE critical; -- dodali smo "statično" uslov filtriranja
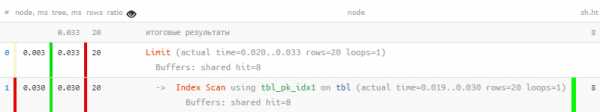
Kao što vidimo, filtracija iz plana je potpuno nestala, a upit je postao 5 puta brži.
#5: разреженная таблица
Kada se pojavljuje
Različiti pokušaji da se napravi vlastita redosled obrade zadataka, kada veliki broj ažuriranja/brisanja zapisa u tabeli dovode do situacije velikog broja "mrtvih" zapisa.
Kako prepoznati
-> Seq Scan | Bitmap Heap Scan | Index [Samo] Scan [Unazad]
   && petlje × (redovi + RRbF) < (deljeno hit + deljena čitanja) × 8
      -- pročitano više od 1KB po svakom zapisu
   && deljeno hit + deljena čitanja > 64
Preporuke
Redovno ručno sprovoditi VACUUM [PUN] ili osigurati dovoljnu učestalost rada pomoću fine podele njegovih parametara, uključujući .
U većini slučajeva ovakvi problemi su uzrokovani lošom kompozicijom upita pri pozivima iz poslovne logike poput onih koje smo razmatrali u .
Ali treba razumeti da čak i VACUUM FULL ne može uvek pomoći. Za takve slučajeve, važno je upoznati se sa algoritmom iz članka .
#6: чтение с «середины» индекса
Kada se pojavljuje
Izgleda da smo malo pročitali, i sve prema indeksu, i nismo filtrirali nikoga suvišnog — a ipak je pročitano značajno više stranica nego što bismo želeli.
Kako prepoznati
-> Index [Samo] Scan [Unazad]
   && petlje × (redovi + RRbF) < (deljeno hit + deljena čitanja) × 8
      -- pročitano više od 1KB po svakom zapisu
   && deljeno hit + deljena čitanja > 64
Preporuke
Pažljivo obratite pažnju na strukturu korišćenog indeksa i ključnih polja postavljenih u upitu — najverovatnije, deo indeksa nije zadat. Najverovatnije, moraćete da kreirate sličan indeks, ali bez prefiksnih polja ili .
Primer:
KREIRAJ TABELU tbl KAO
ODABRATI
  generiši_niz(1, 100000) pk      -- 100K "činjenica"
, (random() *  100)::integer fk_org  -- 100 različitih stranih ključeva
, (random() * 1000)::integer fk_cli; -- 1K različitih stranih ključeva

KREIRAJ INDEKS NA tbl(fk_org, fk_cli); -- sve skoro kao u #2
-- samo je dodatni indeks po fk_cli već smatran suvišnim i obrisan

ODABRATI
  *
IZ
  tbl
GDE
  fk_cli = 999 -- a fk_org nije postavljen, iako je ranije u indeksu
LIMIT 20; 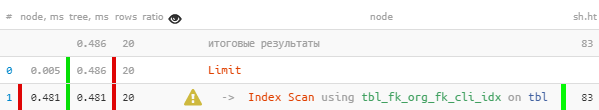
Izgleda da je sve u redu, čak i prema indeksu, ali deluje sumnjivo — za svaku od 20 pročitani zapisa trebalo je pročitati 4 stranice podataka, 32KB po zapisu — nije li to previše? I ime indeksa tbl_fk_org_fk_cli_idx navodi na razmišljanje.
Ispravke:
KREIRAJ INDEKS NA tbl(fk_cli); 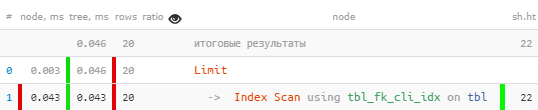
Iznenada — 10 puta brže, i 4 puta manje čitati!
Ostale primere situacija neefikasne upotrebe indeksa možete videti u članku .
#7: CTE × CTE
Kada se pojavljuje
U upitu započeli smo „debeli“ CTE iz različitih tabela, a zatim smo odlučili da napravimo između njih JOIN.
Slučaj je aktuelan za verzije ispod v12 ili upite sa WITH MATERIALIZOVANIM.
Kako prepoznati
-> CTE Skener
   && petlje > 10
   && petlje × (redovi + RRbF) > 10000
      -- preveliki kartezijanski proizvod CTE
Preporuke
Pažljivo analizirati upit — da li su potrebni ovde uopšte CTE ? Если все-таки да, то prema modelu opisanim u PostgreSQL Antipatterns: udarimo rečnikom po teškom JOIN-u .
#8: swap на диск (temp written)
Kada se pojavljuje
-> * && privremeno napisano > 0
Kako prepoznati
Ako korišćena operacija memorije ne prelazi značajno postavljenu vrednost parametraPreporuke
work_mem SET [LOCAL] za konkretan upit/transakciju. PODACI work_mem; -- "16MB"ODABRATI random() IZ generiši_niz(1, 1000000) REDOSLED 1;
Primer:
SET work_mem = '128MB'; -- pre izvršavanja upita 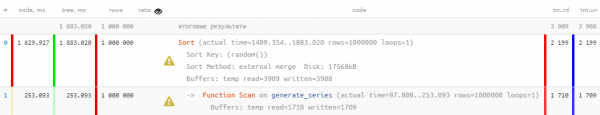
Ispravke:
Iz razumljivih razloga, ako se koristi samo memorija, a ne disk, upit će se izvršavati mnogo brže. Uz to, deo opterećenja sa HDD-a se sklanja. 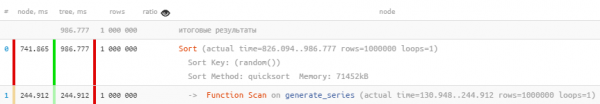
Ali treba razumeti da se uvek ne može dodeliti puno-puno memorije — jednostavno je neće biti dovoljno za sve.
U bazu je ubačeno odjednom puno, ali nije se uspelo proći
#9: неактуальная статистика
Kada se pojavljuje
ANALIZE -> Sekvencijalno skeniranje | Bitmap Heap Scan | Indeks [Samo] Skeniranje [Unazad] && odnos >> 10.
Kako prepoznati
Obaviti toPreporuke
Detaljnije je ova situacija opisana u -> Sekvencijalno skeniranje | Bitmap Heap Scan | Indeks [Samo] Skeniranje [Unazad] && odnos >> 10.
PostgreSQL Antipatterns: statistika je ključna .
#10: «что-то пошло не так»
Kada se pojavljuje
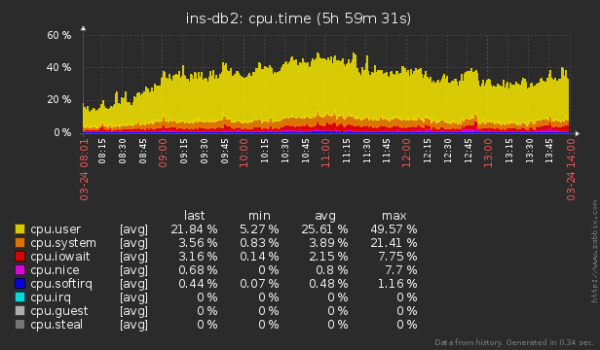
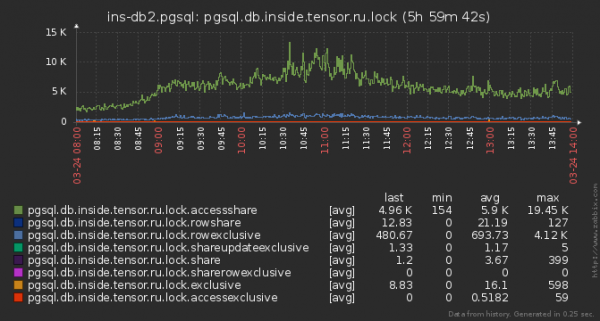
Došlo je do čekanja na zaključavanje, koje je nametnuto konkurentskim upitom, ili su nedostajali hardverski resursi CPU/hypervizora.
Kako prepoznati
-> *
   && (shared hit / 8K) + (shared read / 1K) < time / 1000
      -- RAM hit = 64MB/s, HDD read = 8MB/s
   && time > 100ms -- malo smo čitali, ali je to trajalo predugo
Preporuke
Iskoristite eksterni sistem za praćenje servera radi provere blokada ili nepravilne potrošnje resursa. O našem načinu organizacije ovog procesa za stotine servera već smo govorili i .
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish