

Zdravo, Habr!
U svjetlu trenutnih događaja uzrokovanih koronavirusom, niz internetskih servisa počeo je primati povećano opterećenje. Na primjer, , jer nije bilo dovoljno resursa. A nije uvijek moguće ubrzati server jednostavno dodavanjem snažnije opreme, međutim, zahtjeve kupaca treba obraditi (ili će otići konkurentima).
U ovom članku ću ukratko govoriti o popularnim praksama koje će omogućiti izradu brzog i otporog servisa. Međutim, od mogućih razvojnih shema, izabrao sam samo one koje se sada lako mogu iskoristiti.Za svaku tačku već imate gotove biblioteke ili postoji mogućnost rješavanja zadatka putem oblaka.
Horizontalno skaliranje
Najjednostavnija i svima poznata tačka. Uslovno, najčešće se susreću dva pristupa raspodjeli opterećenja — horizontalno i vertikalno skaliranje. dopuštate servisima da rade paralelno, tako raspodjeljujući opterećenje među njima. naručujete snažnije servere ili optimizujete kod.
Za primjer ću uzeti apstraktno oblačno skladište datoteka, dakle neki analog OwnClouda, OneDrivea i slično.
Standardna slika slične sheme je ispod, međutim, ona samo prikazuje složenost sistema. Jer moramo nekako sinkronizovati servise. Šta će se desiti ako korisnik sa tableta sačuva datoteku, a zatim želi da je pogleda na telefonu?
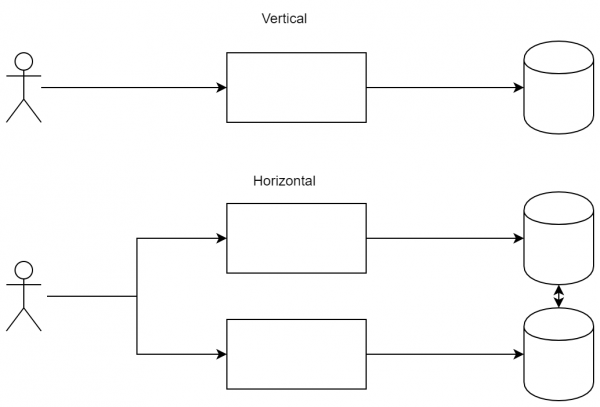
Razlika između pristupa: kod vertikalnog skaliranja spremni smo povećavati snagu čvorova, dok kod horizontalnog — dodajemo nove čvorove kako bismo raspodijelili opterećenje.
CQRS
je prilično važan obrazac, jer omogućava različitim klijentima ne samo povezivanje s različitim servisima, već i dobijanje istih tokova događaja. Njegove prednosti nisu tako očite za jednostavnu aplikaciju, međutim, on je izuzetno važan (i jednostavan) za opterećeni servis. Njegova suština: ulazni i izlazni tokovi podataka ne smiju se preklapati. Dakle, ne možete poslati zahtjev i čekati odgovor, umjesto toga šaljete zahtjev u servis A, ali dobijate odgovor u servisu B.
Prvi bonus ovog pristupa je mogućnost prekida veze (u širokom smislu te reči) tokom izvršavanja dugog zahteva. Na primer, uzmimo više-manje standardnu sekvencu:
- Klijent je poslao zahtev serveru.
- Server je pokrenuo dugotrajnu obradu.
- Server je odgovorio klijentu rezultatom.
Zamislimo da se u tački 2 desio prekid veze (ili se mreža ponovo povezala, ili je korisnik prešao na drugu stranicu, prekinuvši vezu). U ovom slučaju, serveru će biti teško da pošalje odgovor korisniku sa informacijom šta je tačno obrađeno. Primenom CQRS, sekvenca će biti malo drugačija:
- Klijent se prijavio za ažuriranja.
- Klijent je poslao zahtev serveru.
- Server je odgovorio 'zahtev prihvaćen'.
- Server je odgovorio rezultatom kroz kanal iz tačke '1'.
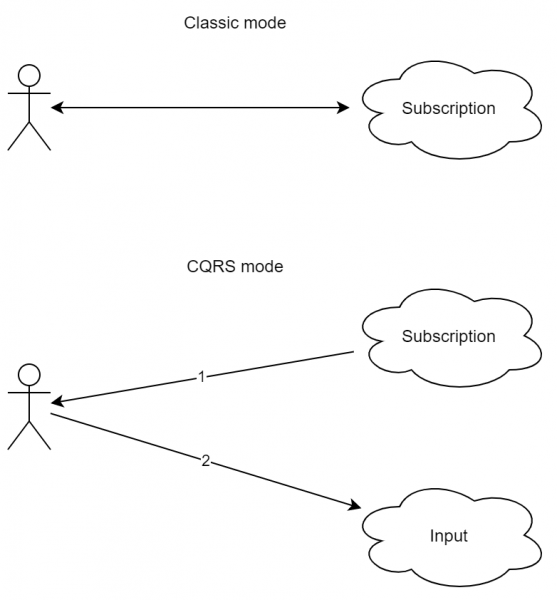
Kao što se vidi, šema je malo složenija. Štaviše, intuitivni pristup request-response ovde ne postoji. Međutim, kao što se može primetiti, prekid veze tokom obrade zahteva neće dovesti do greške. Štaviše, ako se korisnik zapravo povezuje na uslugu sa više uređaja (na primer, sa mobilnog telefona i sa tableta), može se omogućiti da odgovor dolazi na oba uređaja.
Što je zanimljivo, kod obrade dolaznih poruka postaje sličan (ne 100%) za događaje na koje je uticao sam klijent, kao i za ostale događaje, uključujući one od drugih klijenata.
Međutim, u stvarnosti dobijamo dodatne bonuse zbog toga što se jednostrani tok može obraditi na funkcionalni način (koristeći RX i analoge). A to je već ozbiljna prednost, jer se u suštini aplikacija može potpuno učiniti reaktivnom, uz primenu funkcionalnog pristupa. Za velike programe to može značajno uštedeti resurse na razvoju i održavanju.
Ako spojimo ovaj pristup sa horizontalnim skaliranjem, bonus je da možemo slati zahteve jednom serveru, a primati odgovore od drugog. Na taj način, klijent može sam izabrati uslugu koja mu odgovara, a sistem unutar može ispravno obraditi događaje.
Event Sourcing
Kao što znate, jedna od glavnih karakteristika distribuiranog sistema je nedostatak zajedničkog vremena i zajedničke kritične sekcije. Za jedan proces možete implementirati sinhronizaciju (na istim mutex-ima), unutar koje ste sigurni da niko drugi ne izvršava taj kod. Međutim, za distribuirani sistem ovo je opasno, jer će to zahtevati prevelike troškove, a takođe će ubiti svu lepotu skalabilnosti — svi komponente će čekati jedan na drugog.
Odatle dolazi važna činjenica — brzi distribuirani sistem se ne može sinhronizovati, jer bismo time smanjili performanse. S druge strane, često nam je potrebna određena doslednost komponenti. I za to se može koristiti pristup sa , gde je garantovano da će u odsustvu promena podataka kroz određeni vremenski period nakon poslednjeg ažuriranja („na kraju“) svi zahtevi vraćati poslednju ažuriranu vrednost.
Važno je razumeti da se za klasične baze podataka često primenjuje , gde svaki čvor poseduje identične informacije (ovo se često postiže kada se transakcija smatra uspostavljenom tek nakon odgovora drugog servera). Ovdje postoje određena olakšanja zbog nivoa izolacije, ali osnovna suština ostaje ista — možete živeti u potpuno usklađenom svetu.
Međutim, vratimo se na prvobitni zadatak. Ako deo sistema može biti izgrađen sa , onda se može izgraditi sledeća shema.
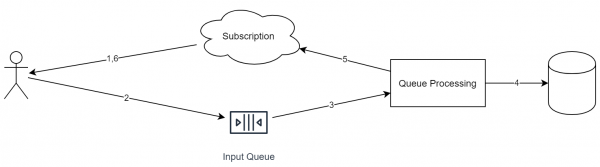
Važne karakteristike ovog pristupa:
- Svaki dolazni zahtev se stavlja u jedan red.
- Tokom obrade zahteva, servis može takođe stavljati zadatke u druge redove.
- Svaka dolazna događaj ima identifikator (koji je potreban za deduplikaciju).
- Red ideološki funkcioniše na osnovu "samo dodavanje". Iz njega nije moguće brisati elemente ili ih preuređivati.
- Red funkcioniše po FIFO sistemu (oprosti na tautologiji). Ako je potrebno izvršiti paralelno izvajanje, treba u jednom od koraka prebaciti objekte u različite redove.
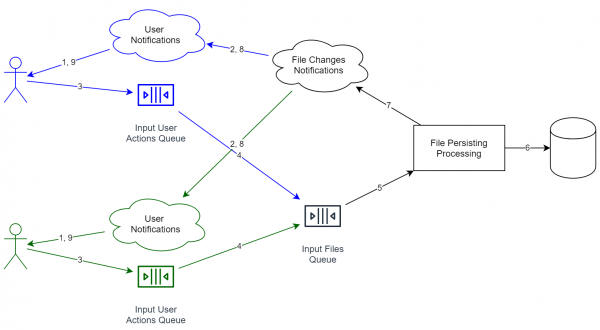
Podsećam, razmatramo slučaj online skladišta datoteka. U tom slučaju, sistem će izgledati otprilike ovako:
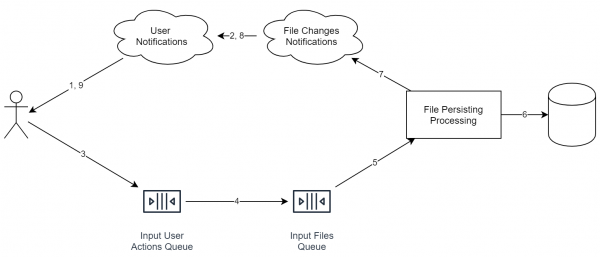
Važno je da usluge na dijagramu ne znače nužno zaseban server. Čak i proces može biti isti. Važno je drugo: ideološki su ove stvari odvojene na način koji omogućava lako primenljivo horizontalno skaliranje.
A za dva korisnika shema će izgledati ovako (usluge namenjene različitim korisnicima obeležene su različitim bojama):
Benefiti od ovakve kombinacije:
- Usmerivači su odvojeni. Redovi su takođe odvojeni. Ako nam bude potrebno povećati propusnost sistema, potrebno je samo pokrenuti više usluga na većem broju servera.
- Kada dobijemo informacije od korisnika, ne moramo nužno čekati potpuno čuvanje podataka. Naprotiv, dovoljno je da odgovorimo "ok", a zatim postepeno počnemo rad. Pritom red ublažava pikove, jer se dodavanje novog objekta odvija brzo, a korisnik ne mora čekati cela ciklus.
- Na primer, dodao sam servis deduplikacije, koji pokušava da spoji iste datoteke. Ako se sporo obrađuje u 1% slučajeva, klijent to praktično neće primetiti (vidi gore), što je velika prednost, jer od nas više nije potrebna stoprocentna brzina i pouzdanost.
Međutim, odmah postaju vidljivi i nedostaci:
- Našem sistemu nedostaje stroga doslednost. To znači da, ako se, na primer, pretplatite na različite usluge, teoretski možete dobiti različito stanje (jer jedna od usluga možda neće uspeti da primi obaveštenje iz unutrašnjeg reda). Kao još jedna posledica, sistem sada nema zajedničko vreme. To jest, ne možete, na primer, sortirati sve događaje samo po vremenu dolaska, jer satovi između servera možda nisu sinkronizovani (više od toga, isto vreme na dva servera je utopija).
- Nijedni događaji sada ne mogu jednostavno da se vrate (kao što bi se to moglo uraditi sa bazom podataka). Umesto toga, potrebno je dodati novi događaj — , koji će menjati poslednje stanje na potrebno. Kao primer iz sličnog područja: bez prepisivanja istorije (što je loše u nekim slučajevima) u git-u nije moguće vratiti commit, ali je moguće napraviti poseban , koji u suštini samo vraća staro stanje. Ipak, u istoriji će ostati i grešni commit i rollback.
- Shema podataka može se menjati od izdanja do izdanja, međutim, stari događaji sada se ne mogu ažurirati na novi standard (pošto se događaji u principu ne mogu menjati).
Kao što se može videti, Event Sourcing se odlično uklapa sa CQRS. Štaviše, implementirati sistem sa efikasnim i praktičnim redovima, ali bez deljenja tokova podataka, već samo po sebi je složeno, jer će biti potrebno dodati tačke sinhronizacije, koje će neutralisati ceo pozitivan efekat redova. Primena oba pristupa odjednom zahteva neznatno podešavanje koda rada programa. U našem slučaju, prilikom slanja fajla na server, u odgovoru dolazi samo „ok“, što znači da je „operacija dodavanja fajla sačuvana“. Formalno, to ne znači da su podaci već dostupni na drugim uređajima (na primer, servis deduplikacije može rekonstruisati indeks). Međutim, nakon nekog vremena, klijent će primiti obaveštenje u stilu „fajl X sačuvan“.
Kao rezultat:
- Broj statusa slanja fajlova se povećava: umesto klasičnog „fajl je poslat“ dobijamo dva: „fajl je dodat u red na serveru“ i „fajl je sačuvan u skladištu“. Potonje znači da drugi uređaji već mogu početi da primaju fajl (uzimajući u obzir da redovi rade različitim brzinama).
- Zbog toga što informacije o slanju sada dolaze kroz različite kanale, potrebno je smisliti rešenja za dobijanje statusa obrade fajla. Kao posledica toga: za razliku od klasičnog request-response, klijent može biti ponovo pokrenut tokom obrade fajla, ali status te obrade će biti tačan. Ovaj deo funkcioniše, u suštini, iz kutije. Kao rezultat: sada smo tolerantniji prema otkazivanju.
Sharding
Kao što je već pomenuto, u sistemima sa event sourcing-om nema stroge usklađenosti. To znači da možemo koristiti više skladišta bez bilo kakve sinhronizacije između njih. Približavajući se našem zadatku, možemo:
- Razdvajati fajlove po tipovima. Na primer, slike/video možemo dekodirati i birati efikasniji format.
- Razdvajanje računa po zemljama. Zbog mnogih zakona, ovo može biti potrebno, međutim, ovaj arhitektonski pristup omogućava sličnu mogućnost automatski.
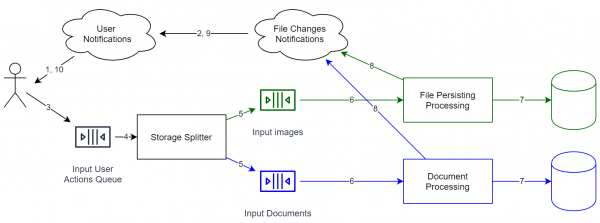
Ako želite prenijeti podatke iz jednog skladišta u drugo, standardna sredstva ovdje nisu dovoljna. Nažalost, u tom slučaju potrebno je zaustaviti red, obaviti migraciju, a zatim ga ponovo pokrenuti. Generalno, podaci se ne mogu prenijeti 'u hodu', međutim, ako se red događaja potpuno pohranjuje i imate kopije prethodnih stanja skladišta, možemo ponovno odigrati događaje na sljedeći način:
- U Event Source, svaki događaj ima svoj identifikator (idealan — ne opadajući). To znači da možemo dodati polje u skladište — id posljednjeg obrađenog elementa.
- Dupliramo red kako bi se svi događaji mogli obrađivati za nekoliko nezavisnih skladišta (prvo je ono u kojem su već pohranjeni podaci, a drugo je novo, međutim još prazno). Drugi red, naravno, za sada nije obrađivan.
- Pokrećemo drugi red (tj. počinjemo ponovo odigravanje događaja).
- Kada novi red bude relativno prazan (tj. prosječna razlika u vremenu između dodavanja elementa i njegovog vađenja biće prihvatljiva), možemo početi prebacivati čitatelje na novo skladište.
Kao što se može vidjeti, u našem sistemu nikada nije bilo stroge dosljednosti. Postoji samo eventualna konzistentnost, tj. garancija da se događaji obrađuju u istom redu (međutim, moguće je da kasne). I koristeći ovo, možemo relativno lako prenijeti podatke bez zaustavljanja sistema do drugog kraja svijeta.
Dakle, nastavljajući naš primjer o online skladištu za datoteke, ova arhitektura nam već daje niz prednosti:
- Možemo premještati objekte bliže korisnicima, na dinamičan način. Na taj način se može poboljšati kvalitet usluge.
- Možemo pohraniti dio podataka unutar kompanija. Na primjer, korisnici Enterprise često zahtijevaju da njihovi podaci budu pohranjeni u kontroliranim data centrima (kako bi se izbjegle curenja podataka). Uz pomoć sharding-a to možemo lako podržati. I zadatak je još pojednostavljen ako kupac ima kompatibilno oblak (na primjer, ).
- A najvažnije je — ne moramo to raditi. Na početku bi nam odgovaralo jedno skladište za sve račune (kako bismo brže počeli raditi). Ključna karakteristika ovog sistema je što je, unatoč svojoj ekspanzivnosti, u početnoj fazi dovoljno jednostavan. Samo ne treba odmah pisati kod koji radi s milionom posebnih nezavisnih redova itd. Ako zatreba, to se može učiniti u budućnosti.
Hosting statičkog sadržaja
Ova tačka se može činiti potpuno očiglednom, ali je ipak potrebna za donekle standardnu aplikaciju sa opterećenjem. Njena suština je jednostavna: sav statički sadržaj se ne deli sa istog servera na kojem se nalazi aplikacija, već sa posebnih servera koji su posebno namenjeni za to. Kao posledica, ove operacije se izvode brže (standardni nginx isporučuje fajlove brže i jeftinije nego Java server). Plus, arhitektura CDN () omogućava da se naši fajlovi nalaze bliže krajnjim korisnicima, što pozitivno utiče na udobnost rada sa uslugom.
Najjednostavniji i standardni primer statičkog sadržaja je skup skripti i slika za sajt. Sa njima je sve jednostavno — unapred su poznate, zatim se arhivira i prebacuje na CDN servere, odakle se isporučuju krajnjim korisnicima.
Međutim, u praksi se za statički sadržaj može primeniti pristup koji podseća na lambda arhitekturu. Vratimo se našoj zadatku (online skladište fajlova), gde je potrebno deliti fajlove korisnicima. Najjednostavnije rešenje je napraviti servis koji za svaki zahtev korisnika vrši sve potrebne provere (autentifikacija itd.), a zatim preuzima fajl direktno sa našeg skladišta. Glavni nedostatak ovog pristupa je to što se statički sadržaj (a fajl sa određenom revizijom, u suštini, i jeste statički sadržaj) deli sa istim serverom koji sadrži poslovnu logiku. Umesto toga, može se napraviti sledeća shema:
- Server generiše URL za preuzimanje. On može imati oblik file_id + key, gde je key — mini-digitalni potpis koji daje pravo na pristup resursu narednih 24 sata.
- Isporukom fajla se bavi jednostavni nginx sa sledećim opcijama:
- Keširanje sadržaja. Pošto se ova usluga može nalaziti na zasebnom serveru, ostavili smo sebi prostora za budućnost sa mogućnošću da čuvamo sve poslednje preuzete datoteke na disku.
- Provera ključa u trenutku kreiranja veze
- Opcionalno: strimovanje sadržaja. Na primer, ako kompresujemo sve datoteke u servisu, možemo izvršiti dekompresiju direktno u ovom modu. Kao rezultat toga: IO operacije se obavljaju tamo gde im je mesto. Kompresor na Javi lako može zahtevati veliku količinu memorije, međutim, prepisivanje usluge sa poslovnom logikom na jezik poput Rust/C++ takođe može biti neefikasno. U našem slučaju koriste se različiti procesi (ili čak usluge), pa je moguće efikasno razdvojiti poslovnu logiku i IO operacije.
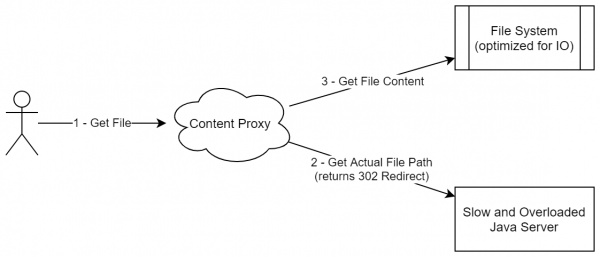
Slična shema nije baš kao deljenje statičkog sadržaja (pošto ne prenosimo ceo paket statičkih datoteka negde), međutim, u stvarnosti takav pristup se zaista bavi isporukom nepromenljivih podataka. Štaviše, ovu shemu je moguće generalizovati i na druge slučajeve kada sadržaj nije samo statičan, već može biti predstavljen kao skup nepromenljivih i neizbrisivih blokova (iako se mogu dodavati).
Još jedan primer (za učvršćivanje): ako ste radili sa Jenkins/TeamCity, znate da su oba rešenja napisana na Javi. Oba predstavljaju Java proces koji se bavi kako orkestracijom buildova, tako i upravljanjem sadržajem. Konkretno, oba imaju zadatke poput "prenesi datoteku/folder sa servera". Kao primer: isporuka artefakata, prenos izvornog koda (kada agent ne preuzima kod direktno iz repozitorijuma, već to radi server), pristup logovima. Svi ovi zadaci se razlikuju po opterećenju na IO. Dakle, server koji je odgovoran za složenu poslovnu logiku, takođe mora efikasno da prenosi velike količine podataka. I što je najzanimljivije, takvu operaciju je moguće delegirati istom nginx-u na isti način (s tim da u zahtev treba dodati ključ podataka).
Međutim, ako se vratimo na naš sistem, dolazimo do ove sheme:
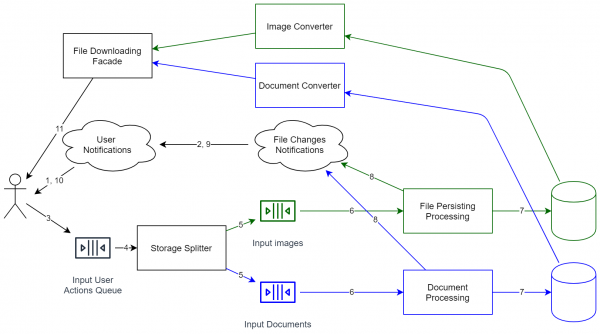
Kao što možete vidjeti, sistem je radikalno zakomplikovan. Sada to nije samo mini-proces koji lokalno skladišti datoteke. Sada je potrebna kompleksnija podrška, kontrola verzija API-a itd. Stoga, nakon što su svi dijagrami nacrtani, najbolje je detaljno procijeniti da li su troškovi proširivosti opravdani. Međutim, ako želite imati mogućnost proširivanja sistema (uključujući rad s još većim brojem korisnika), morat ćete se odlučiti za slična rešenja. S druge strane, kao rezultat, arhitektura sistema je spremna za povećanje opterećenja (praktično svaki komponenta se može klonirati za horizontalno skaliranje). Sistem se može ažurirati bez njegovog zaustavljanja (samo će neke operacije blago usporiti).
Kao što sam već spomenuo na početku, sada je niz internet usluga počeo dobijati povećano opterećenje. I neki od njih jednostavno su prestali ispravno funkcionirati. U suštini, sistemi su otkazali upravo u trenutku kada bi biznis trebao generisati prihod. To jest, umesto odložene isporuke, umesto da klijentima kaže "planirajte isporuku za naredne mesece", sistem je jednostavno rekao "idite kod konkurenata". U suštini, to je cena niske produktivnosti: gubici nastaju upravo u trenucima kada bi profit bio najviši.
Zaključak
Sve ove pristupe su već ranije poznavali. Isto tako, VK već dugo koristi ideju Static Content Hosting za isporuku slika. Mnoge online igre koristi shemu Sharding za razdvajanje igrača po regionima ili za razdvajanje igrališnih lokacija (ako je svet jedinstven). Event Sourcing pristup se aktivno koristi u elektronskoj pošti. Većina aplikacija za trgovce, gde kontinuirano dolaze podaci, zapravo je izgrađena na CQRS pristupu, kako bi imali mogućnost filtriranja primljenih podataka. Pa i horizontalno skaliranje se već dugo primenjuje u mnogim servisima.
Međutim, što je najvažnije, svi ovi obrasci su postali vrlo lako primenjivi u savremenim aplikacijama (ako su, naravno, relevantni). Cloud platforme nude šardiranje i horizontalno skaliranje odmah, što je mnogo lakše nego naručivanje različitih posvećenih servera u različitim data centrima. CQRS je postao mnogo lakši, barem zbog razvoja biblioteka kao što je RX. Pre deset godina, retki web sajtovi bi mogli da podrže tako nešto. Event Sourcing se takođe konfiguriše neverovatno lako zahvaljujući već pripremljenim kontejnerima sa Apache Kafka. Pre deset godina to bi bila inovacija, sada je to uobičajeno. Slično je i sa hostingom statičkog sadržaja: zbog pogodnijih tehnologija (uključujući i zbog toga što postoji detaljna dokumentacija i velika baza odgovora), takav pristup je postao još jednostavniji.
Kao rezultat, implementacija niza prilično složenih arhitektonskih obrazaca sada je postala mnogo lakša, a to znači da im se bolje može prethodno posvetiti. Ako je u desetogodišnjoj aplikaciji odbačeno jedno od navedenih rešenja zbog visoke cene implementacije i eksploatacije, sada, u novoj aplikaciji ili nakon refaktorisanja, može se napraviti servis koji će arhitektonski biti i skalabilan (sa stanovišta performansi) i spreman za nove zahteve od klijenata (na primer, za lokalizaciju ličnih podataka).
I što je najvažnije: molimo vas, ne koristite ove pristupe ako imate jednostavnu aplikaciju. Da, oni su lepi i zanimljivi, ali za sajt sa vrhunskim posetama od 100 ljudi često se može koristiti klasični monolit (barem spolja, iznutra se sve može podeliti na module itd.).
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish