

Članak se sastoji od dva dela:
- Kratak opis nekih arhitektura mreža za prepoznavanje objekata na slikama i segmentaciju slika sa najjasnijim resursima za mene. Pokušao sam da izaberem video objašnjenja, po mogućstvu na ruskom jeziku.
- Drugi deo se sastoji u pokušaju da se razume smer razvoja arhitektura neuronskih mreža i tehnologija zasnovanih na njima.
Slika 1 – Razumevanje arhitektura neuronskih mreža nije lako
Sve je počelo kada sam napravio dva demonstraciona aplikacija za klasifikaciju i prepoznavanje objekata na Android telefonu:
- , kada se podaci obrađuju na serveru i šalju na telefon. Klasifikacija slika (image classification) tri tipa medveda: smešnog, crnog i plišanog.
- , kada se podaci obrađuju na samom telefonu. Prepoznavanje objekata (object detection) tri tipa: lešnik, smokva i urme.
Postoji razlika između zadataka klasifikacije slika, prepoznavanja objekata na slici i . Stoga se pojavila potreba da saznam koje arhitekture neuronskih mreža prepoznaju objekte na slikama i koje mogu segmenitirati. Pronašao sam sledeće primere arhitektura sa najjasnijim resursima za mene:
- Serija arhitektura zasnovanih na R-CNN (Regions with Convolution Neural Networks features): R-CNN, Fast R-CNN, , . Za prepoznavanje objekta na slici koristi se mehanizam Region Proposal Network (RPN) za izdvajanje ograničenih regiona (bounding boxes). Prvobitno je umesto RPN korišćen sporiji mehanizam Selective Search. Zatim se izdvojeni ograničeni regioni šalju kao ulaz običnoj neuronskoj mreži za klasifikaciju. U arhitekturi R-CNN postoje očigledne „for“ petlje za prolaz kroz ograničene regione, ukupno do 2000 prolaza kroz unutrašnju mrežu AlexNet. Zbog očiglednih „for“ petlji usporava se brzina obrade slika. Broj očiglednih petlji i prolaza kroz unutrašnju neuronsku mrežu smanjuje se sa svakom novom verzijom arhitekture, a takođe se sprovode desetine drugih promena radi povećanja brzine i zamene zadatka prepoznavanja objekata sa segmentacijom objekata u Mask R-CNN.
- (You Only Look Once) – prva neuronska mreža koja prepoznaje objekte u realnom vremenu na mobilnim uređajima. Odlikuje se sposobnošću prepoznavanja objekata u jednom prolazu (samo jedan pogled je dovoljan). Tako da u arhitekturi YOLO nema očiglednih "for" petlji, zbog čega mreža radi brzo. Na primer, analogija: u NumPy-u pri operacijama sa matricama takođe nema očiglednih "for" petlji, koje se u NumPy-u realizuju na nižim nivoima arhitekture kroz programski jezik C. YOLO koristi mrežu unapred definiranih prozora. Da isti objekat ne bi bio više puta prepoznat, koristi se koeficijent preklapanja prozora (IoU, Intersection over Union). Ova arhitektura funkcioniše u širokom opsegu i karakteriše je visoka : model može biti obučen na fotografijama, ali dobro funkcioniše i na crtežima.
- (Single Shot MultiBox Detector) – koriste se najbolji "hackovi" arhitekture YOLO (na primer, non-maximum suppression) i dodaju se novi, kako bi neuronska mreža brže i preciznije radila. Odlikuje se sposobnošću prepoznavanja objekata u jednom prolazu uz pomoć unapred definisane mreže prozora (default box) na piramidama slika. Piramida slika je kodirana u konvolucijskim tenzorima tokom sekvencijalnih operacija konvolucije i puliinga (prilikom operacije max-pooling prostorna dimenzija opada). Tako se prepoznaju i veliki i mali objekti u jednom prolazu mreže.
- MobileSSD (MobilniNetV2 + SSD) – kombinacija dve arhitekture neuronskih mreža. Prva mreža radi brzo i povećava tačnost prepoznavanja. MobileNetV2 se koristi umesto VGG-16, koja je prvobitno korišćena u . Druga mreža SSD određuje lokaciju objekata na slici.
- – veoma mala, ali precizna neuronska mreža. Sama po sebi ne rešava zadatak prepoznavanja objekata. Ipak, može se koristiti u kombinaciji različitih arhitektura. Može se koristiti na mobilnim uređajima. Njena posebna karakteristika je to što se podaci najpre kompresuju na četiri 1×1 konvolucijska filtera, a zatim šire na četiri 1×1 i četiri 3×3 konvolucijska filtera. Jedna takva iteracija kompresije-širenja podataka naziva se „Fire Module“.
- (Semantička Segmentacija Slika uz Duboke Konvolucijske Mreže) – segmentacija objekata na slici. Karakteristika arhitekture je razređena (dilated convolution) konvolucija, koja zadržava prostornu rezoluciju. Potom slijedi faza postprocesiranja rezultata korištenjem grafičkog probabilističkog modela (conditional random field), što omogućava uklanjanje malih šumova u segmentaciji i poboljšanje kvaliteta segmentirane slike. Iza zastrašujućeg naziva „grafički probabilistički model“ krije se obični Gaussov filtar, koji je aproksimiran na pet tačaka.
- Pokušavao sam da shvatim uređaj (Jednokratno Refinement Neural Network for Object Detekciju), ali nisam puno shvatio.
- Takođe sam pogledao kako funkcioniše tehnologija „pažnja“ (attention): , , . Karakteristika arhitekture „pažnja“ je automatsko isticanje područja povećane pažnje na slici (RoI, Rregije of Iinteresa) pomoću neuronske mreže nazvane Attention Unit. Područja povećane pažnje slična su ograničenim regionima (bounding boxes), ali za razliku od njih nisu fiksna na slici i mogu imati nejasne granice. Iz područja povećane pažnje izdvajaju se osobine (features) koje se „šalju“ rekurentnim neuronskim mrežama s arhitekturama . Rekurentne neuronske mreže mogu analizirati međuzavisnost osobina u sekvenci. Rekurentne neuronske mreže su prvobitno korišćene za prevođenje teksta na druge jezike, a sada i za prevođenje i .
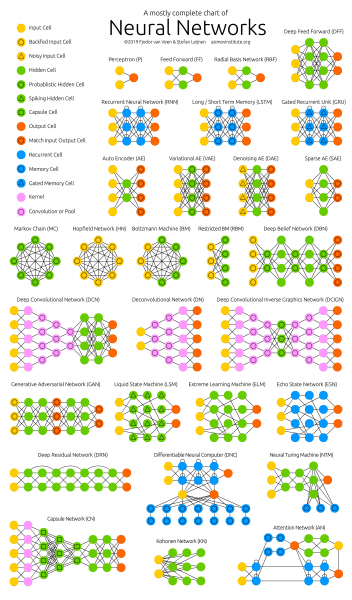
Kako sam istraživao ove arhitekture shvatio sam da ništa ne razumem.. I nije stvar u tome da moja neuronska mreža ima problema s mehanizmom pažnje. Izrada svih ovih arhitektura liči na neki ogroman hackathon, gde se autori takmiče u hakovima. Hack je brzo rešenje teške programske zadaće. To jest, između svih ovih arhitektura ne postoji vidljiva i jasna logička povezanost. Sve što ih spaja je skup najuspešnijih hakova koje preuzimaju jedni od drugih, plus zajednička za sve (povratno razprostranjivanje greške, backpropagation). Nema ! Nije jasno šta menjati i kako optimizovati postojeće dostignuće.
Kao rezultat nedostatka logičke povezanosti između hakova, izuzetno je teško zapamtiti ih i primeniti u praksi. To su fragmentisana znanja. U najboljem slučaju, zapamti se nekoliko zanimljivih i neočekivanih momenata, ali većina shvaćenog i neshaćenog nestaje iz pamćenja već nakon nekoliko dana. Dobro bi bilo ako se nakon nedelje ipak seti barem naziva arhitekture. A zar nije potrošeno nekoliko sati i čak dana radnog vremena na čitanje članaka i gledanje preglednih video snimaka!
Slika 2 –
Većina autora naučnih članaka, po mom ličnom mišljenju, čini sve što je moguće da čak i ova fragmentisana znanja ne budu shvaćena od strane čitaoca. No, dezinformacije u deset rečenica sa formulama koje su preuzete „s plafona“ – to je tema za poseban članak (problem ).
Iz tog razloga pojavila se potreba za sistematizacijom informacija o neuronskim mrežama i, tako, povećanjem kvaliteta razumevanja i pamćenja. Stoga je glavna tema analize pojedinih tehnologija i arhitektura veštačkih neuronskih mreža postala sledeća: saznati kamo sve ovo ide, a ne struktura neke konkretne neuronske mreže posebno.
Kamo sve ovo ide. Glavni rezultati:
- Broj startupa u oblasti mašinskog učenja u poslednje dve godine . Mogući razlog: „neuronske mreže su prestale biti nešto novo“.
- Svako će moći da kreira radnu neuronsku mrežu za rešavanje jednostavnog zadatka. Za to će uzeti gotov model iz „zoo modela“ (model zoo) i obučiti poslednji sloj neuronske mreže () na gotovim podacima iz ili sa u besplatnom .
- Veliki proizvođači neuronskih mreža počeli su da kreiraju „zoo modele“ (model zoo). Uz njih se može brzo napraviti komercijalna aplikacija: za TensorFlow, za PyTorch, za Caffe2, za Chainer i .
- Neuronske mreže koje rade u realnom vremenu na mobilnim uređajima. Od 10 do 50 frejmova u sekundi.
- Primena neuronskih mreža na telefonima (TF Lite), u pretraživačima (TF.js) i u (IoT, Iinternet of Tstvari). Posebno na telefonima, koji već podržavaju neuronske mreže na nivou „hardvera“ (neuronski akceleratori).
- Svako uređaj, komadi odjeće i, možda, čak i hrana će imati IP-v6 adresu i komunikovati jedni s drugima" – .
- Rast broja publikacija o mašinskom učenju počeo je (udvostručenje svakih dvije godine) od 2015. godine. Očigledno su potrebne neuronske mreže za analizu članaka.
- Sledeće tehnologije stiču popularnost:
- PyTorch – popularnost raste brzo i, izgleda, nadmašuje TensorFlow.
- Automatsko podešavanje hiperparametara AutoML – popularnost raste postepeno.
- Postepeno smanjenje tačnosti i povećanje brzine proračuna: , algoritmi , aproksimativni (približni) proračuni, kvantizacija (kada se težine neuronske mreže prevode u cele brojeve i kvantizuju), neuroakseleratori.
- Prevod i .
- Kreiranje , sada već u realnom vremenu.
- Osnovno u DL – to su velike količine podataka, ali prikupljanje i označavanje nije lako. Zato se razvija automatizacija označavanja () za neuronske mreže pomoću neuronskih mreža.
- Sa neuronskim mrežama, Računarske nauke su iznenada postale eksperimentalna nauka i došlo je do .
- IT-novac i popularnost neuronskih mreža su se pojavili istovremeno, kada su proračuni postali tržišna vrednost. Ekonomija iz zlato-valutne postaje zlato-valutno-proračunska. Poglejte moj članak o i uzroku pojave IT-novca.
Postepeno se pojavljuje nova (Mašinsko Učenje & Duboko Učenje), koja se temelji na predstavi programa kao skupa obučenih modela neuronskih mreža.
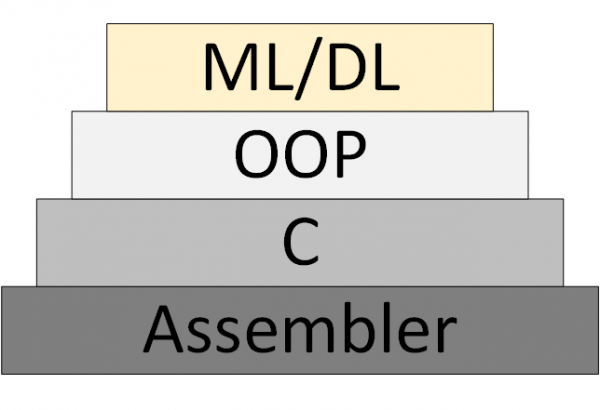
Slika 3 – ML/DL kao nova metodologija programiranja
Međutim, još uvek nije postojala "teorija neuronskih mreža", u okviru koje se može razmišljati i raditi sistematski. Ono što se sada naziva "teorijom" u stvari su eksperimentalni, heuristički algoritmi.
Reference na moje i druge resurse:
- Newsletter o Data Science. Uglavnom, o obradi slika. Ko želi da prima, neka pošalje e-mail (foobar167<gaff-gaff>gmail<dot>com). Linkove na članke i video šaljem kako se materijal skuplja.
- Opšti , koje sam prošao i koje bih želeo da prođem.
- , sa kojima treba početi učiti o neuronskim mrežama. Plus brošura .
- , gdje svako može pronaći nešto zanimljivo za sebe.
- Iznimno korisni su bili video kanali koji razlažu naučne članke o Data Science. Pronađite ih, pretplatite se i podijelite linkove s kolegama i sa mnom također. Primjeri:
- poznat kao s korak-po-korak uputama i otvorenim kodom.
Hvala na pažnji!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish