

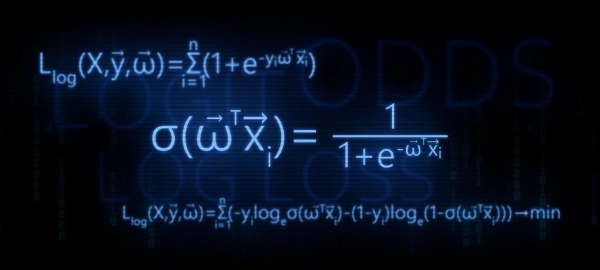
U ovom članku ćemo analizirati teoretske osnove transformacije funkcija linearne regresije u funkciju obratne logit-transformacije (takođe se naziva funkcija logističke reakcije). Zatim, iskoristićemo arsenal metode maksimalne verodostojnosti, u skladu sa modelom logističke regresije, izvešćemo funkciju gubitka Logistic Loss, ili drugim rečima, odredićemo funkciju koja se koristi za optimizaciju parametara vektora težina u modelu logističke regresije.  .
Plan članka:
- Ponovićemo o linearnom zavisnosti između dve varijable
- Utvrdićemo potrebu za transformacijom funkcija linearne regresije
 u funkciju logističke reakcije
- Sprovedemo transformacije i izvešćemo funkciju logističke reakcije
- Pokušaćemo da shvatimo zašto je metoda najmanjih kvadrata nedovoljna prilikom optimizacije parametara funkcija Logistic Loss
- Koristimo metoda maksimalne verodostojnosti za određivanje funkcije optimizacije parametara :
5.1. Slučaj 1: funkcija Logistic Loss za objekte sa oznakama klasa 0 i 1:
5.2. Slučaj 2: funkcija Logistic Loss za objekte sa oznakama klasa -1 i +1:
 u funkciju logističke reakcije

 funkcija Logistic Loss
 :


Članak obiluje jednostavnim primerima u kojima se svi proračuni lako mogu izvršiti verbalno ili na papiru, dok u nekim slučajevima može biti potreban kalkulator. Pripremite se 🙂
Ovaj članak je pretežno namenjen data scientistima sa osnovnim znanjem o mašinskom učenju.
U članku će takođe biti dat kod za crtanje grafikona i proračune. Sav kod je napisan na jeziku python 2.7. U napred, objasniću o "novosti" korišćene verzije — to je jedan od uslova za prolazak poznatog kursa od Yandexa na ne manje poznatoj internet platformi za online obrazovanje Coursera, i, kao što se može pretpostaviti, materijal je pripremljen na osnovu ovog kursa.
01. Linearna zavisnost
Sasvim je razumno postaviti pitanje — kakve veze ima linearna zavisnost sa logističkom regresijom?
Sve je jednostavno! Logistička regresija je jedan od modela koji pripadaju linearnim klasifikatorima. Drugim rečima, zadatak linearnih klasifikatora je predikcija ciljnih vrednosti  na osnovu varijabli (regresora)
 . Pri tom se smatra da je zavisnost između karakteristika
 i ciljnih vrednosti
 linearno. Odatle dolazi i naziv klasifikatora — linearni. Ako bismo veoma grubo generalizovali, u osnovi modela logističke regresije leži pretpostavka o postojanju linearne zavisnosti između karakteristika.
 i ciljnih vrednosti
 . Evo je — povezanost.
U studiji je prvi primer, i to, kako treba, o direktnoj zavisnosti istraživanih veličina. Tokom pripreme članka naišao sam na primer koji je već postao pomalo zasićen mnogima — zavisnost struje od napona. («Primjenjena regresiona analiza», N.Drejper, G.Smit). Ovdje ćemo ga također razmotriti.
U skladu s Ohmovim zakonom:
 , gde
 — struja,
 — napon,
 — otpor.
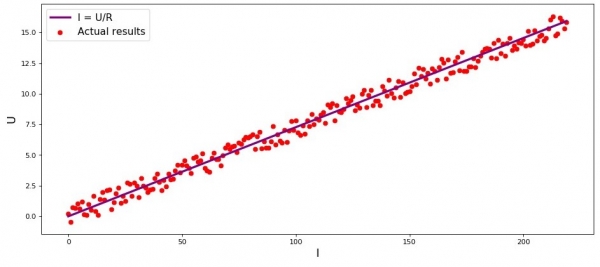
Da nismo znali Ohmov zakon, mogli bismo empirijski pronaći zavisnost, menjajući  i mereći
 , održavajući pritom
 fiksnim. Tada bismo videli da grafikon zavisnosti
 od
 daje više ili manje pravu liniju koja prolazi kroz početak koordinatnog sistema. Rekli smo „više ili manje“, jer, iako je zavisnost zapravo tačna, naše merenja mogu sadržavati male greške, i stoga tačke na grafiku možda neće biti strogo na liniji, već će biti nasumično rasute oko nje.
Grafikon 1 „Zavisnost  od
 »
Kod za crtanje grafikona
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i+random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(x_line,y_line,color = 'purple',lw = 3, label = 'I = U/R')
plt.scatter(x_line,y_dot,color = 'red', label = 'Stvarni rezultati')
plt.xlabel('I', size = 16)
plt.ylabel('U', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
02. Potrebnost transformacija u jednačini linearne regresije
Razmotrićemo još jedan primer. Pretpostavimo da radimo u banci i pred nama je zadatak da odredimo verovatnoću vraćanja kredita od strane dužnika u zavisnosti od nekih faktora. Da bismo pojednostavili zadatak, razmotrićemo samo dva faktora: mesečna plata dužnika i mesečna suma otplate kredita.
Zadatak je veoma uslovan, ali na ovom primeru ćemo moći razumeti zašto za njegovo rešenje nije dovoljno primeniti funkcija linearne regresije, kao i saznati koje transformacije funkcije je potrebno sprovesti.
Vraćamo se na primjer. Jasan je stav da što je veća plata, to će više zajmoprimac moći mjesečno usmjeriti na otplatu kredita. Pri tome, za određeni raspone plata, ova zavisnost će biti prilično linearna. Na primjer, uzmimo raspone plata od 60.000 R do 200.000 R i pretpostavimo da je u tom rasponu plata zavisnost između visine mjesečne rate i visine plate - linearna. Pretpostavimo da je utvrđeno da odnos plate prema rati ne može biti manji od 3 i da zajmoprimcu mora ostati 5.000 R. Samo u tom slučaju smatramo da će zajmoprimac vratiti kredit banci. U tom slučaju, jednadžba linearne regresije će imati oblik:

gde  ,
 ,
 ,
 — plata
 -og zajmoprimca,
 — mjesečna rata
 -og zajmoprimca.
Zamjenom plate i mjesečne rate u jednadžbu sa fiksnim parametrima  može se donijeti odluka o odobravanju ili odbijanju kredita.
Ispred, napominjemo da će, pri zadatim parametrima,  funkcija linearne regresije, primijenjena u funkciji logističke regresije davati velike vrijednosti, što će otežati izračune za određivanje vjerojatnosti otplate kredita. Zato se predlaže smanjiti naše koeficijente, recimo, za 25.000 puta. Od ove transformacije u koeficijentima, odluka o odobravanju kredita se neće promijeniti. Zapamtimo ovaj trenutak za buduće, a sada da bi bilo još jasnije o čemu se radi, razmotrit ćemo situaciju s tri potencijalna zajmoprimca.
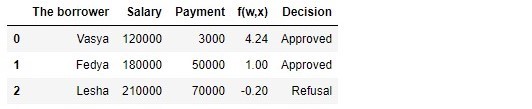
Tabela 1 „Potencijalni zajmoprimci“
Kod za formiranje tabele
import pandas as pd

r = 25000.0
w_0 = -5000.0/r
w_1 = 1.0/r
w_2 = -3.0/r

data = {'Zajmoprimac':np.array(['Vasya', 'Fedya', 'Lesha']),
        'Plata':np.array([120000,180000,210000]),
       'Rata':np.array([3000,50000,70000])}

df = pd.DataFrame(data)

df['f(w,x)'] = w_0 + df['Plata']*w_1 + df['Rata']*w_2

decision = []
for i in df['f(w,x)']:
    if i > 0:
        dec = 'Odobreno'
        decision.append(dec)
    else:
        dec = 'Odbijeno'
        decision.append(dec)

df['Odluka'] = decision

df[['Zajmoprimac', 'Plata', 'Rata', 'f(w,x)', 'Odluka']]
Prema podacima iz tabele, Vasja sa platom od 120.000 R želi dobiti kredit, kako bi mjesečno otplaćivao 3.000 R. Utvrdili smo da da bi kredit bio odobren, njegova plata mora prelaziti tri puta visinu rate, a da još ostane 5.000 R. Ovom zahtjevu Vasja udovoljava:  . Ostaje čak 106.000R. Iako smo prilikom obračuna
 smanjili koeficijente
 na 25.000 puta, rezultat je ostao isti — kredit može biti odobren. Fedya će takođe dobiti kredit, dok će Alexey, iako zarađuje najviše, morati da umanji svoje apetite.
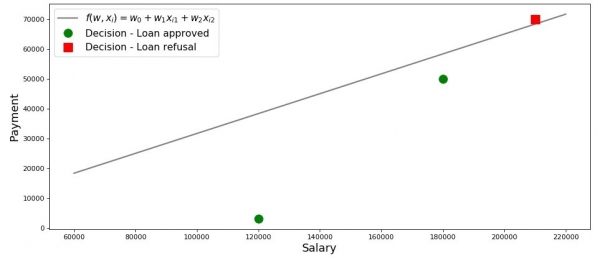
Nacrtajmo grafikon u ovom slučaju.
Grafikon 2 „Klasifikacija zajmoprimaca“
Kod za crtanje grafikona
salary = np.arange(60000,240000,20000)
payment = (-w_0-w_1*salary)/w_2


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$')
plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'],
         'o', color ='green', markersize = 12, label = 'Odlučeno - Kredit odobren')
plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'],
         's', color = 'red', markersize = 12, label = 'Odlučeno - Kredit odbijen')
plt.xlabel('Plata', size = 16)
plt.ylabel('Plaćanje', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
Dakle, naša prava, izgrađena prema funkciji  , deli „loše“ zajmoprimce od „dobrih“. Oni zajmoprimci čija se želja ne poklapa sa mogućnostima su iznad prave (Alexey), dok su oni koji su sposobni da vrate kredit prema parametrima našeg modela ispod prave (Vasya i Fedya). Drugim rečima, naša prava deli zajmoprimce na dve klase. Obeležićemo ih na sledeći način: klasu
 pripada onim zajmoprimcima koji će verovatno vratiti kredit, dok klasa
 ili
 pripada onim zajmoprimcima koji verovatno neće moći da vrate kredit.
Generalizovaćemo zaključke iz ovog jednostavnog primera. Uzećemo tačku  i, zamenjujući koordinate tačke u odgovarajuću jednačinu prave
 , razmotrićemo tri varijante:
- Ako se tačka nalazi ispod prave, i mi je pripisujemo klasi , vrednost funkcije biće pozitivna od do . Tako možemo smatrati da je verovatnoća vraćanja kredita u okviru . Što je veća vrednost funkcije, to je veća verovatnoća.
- Ako se tačka nalazi iznad prave i mi je pripisujemo klasi ili , vrednost funkcije će biti negativna od do . Tada ćemo smatrati da se verovatnoća vraćanja duga nalazi u okviru i, što je veća po apsolutnoj veličini vrednost funkcije, to je veće naše poverenje.
- Tačka se nalazi na pravoj, na granici između dve klase. U tom slučaju, vrednost funkcije će biti jednaka i verovatnoća vraćanja kredita je jednaka .
 , vrednost funkcije
 biće pozitivna od
 do
 . Tako možemo smatrati da je verovatnoća vraćanja kredita u okviru
 . Što je veća vrednost funkcije, to je veća verovatnoća.
 ili
 , vrednost funkcije će biti negativna od
 do
 . Tada ćemo smatrati da se verovatnoća vraćanja duga nalazi u okviru
 i, što je veća po apsolutnoj veličini vrednost funkcije, to je veće naše poverenje.
 će biti jednaka
 i verovatnoća vraćanja kredita je jednaka
 .
Sada, zamislimo da imamo ne dva faktora, već desetina, a ne tri zajmoprimca, već hiljade. Tada umesto prave imamo m-mera ravnina i koeficijenti  mi ćemo uzeti ne s neba, već će biti izračunati prema svim pravilima, na osnovu prikupljenih podataka o zajmoprimcima, koji su vraćali ili nisu vraćali kredite. I zaista, obratite pažnju, sada biramo zajmoprimce prema već poznatim koeficijentima
 . U stvarnosti, zadatak modela logističke regresije upravo je da odredi parametre
 , pri čemu vrednost funkcije gubitaka Logistic Loss teži ka minimalnom. Ali o tome kako se izračunava vektor
 , saznaćemo u petom poglavlju članka. A sada se vraćamo na obećanu zemlju — našem bankaru i trojici njegovih klijenata.
zahvaljujući funkciji  znamo kome možemo odobriti kredit, a kome se treba odbiti. Ali sa takvim informacijama ne možemo kod direktora, jer od nas su želeli da dobiju verovatnoću povrata kredita za svakog zajmoprimca. Šta raditi? Odgovor je jednostavan — moramo nekako transformisati funkciju
 , čije vrednosti se nalaze u opsegu
 na funkciju, čije će vrednosti biti u opsegu
 . I takva funkcija postoji, zove se funkcija logističkog odgovora ili inverzno-logit transformacija. Upoznajte se:

Pogledajmo korake kako dolazimo do funkcije logističkog odgovora. Obratite pažnju, da ćemo ići unazad, tj. pretpostavićemo da znamo vrednost verovatnoće, koja se nalazi između  do
 i zatim ćemo "raspetljati" ovu vrednost na celu oblast brojeva od
 do
 .
03. Izvucimo funkciju logističkog odgovora
Korak 1. Pretvorimo vrednosti verovatnoće u opseg

Tokom transformacije funkcije  u funkciju logističke reakcije
 ostavićemo našeg kreditnog analitičara na miru, a umesto toga proći ćemo kroz kladionice. Ne, naravno, nećemo se kladiti, sve što nas tamo zanima je smisao izraza, na primer, šansa 4 prema 1. Šanse, poznate svima koji se klade, predstavljaju odnos "uspeha" i "neuspeha". Sa stanovišta verovatnoća, šanse — to je verovatnoća događaja podeljena verovatnoćom neostvarenja događaja. Zapišimo formulu šanse za ostvarenje događaja
 :

, gde  — verovatnoća ostvarivanja događaja,
 — verovatnoća NE ostvarivanja događaja
Na primjer, ako je vjerovatnost da mladi, snažni i brzi konj po imenu «Vjetar» pobijedi staru i slabu staricu po imenu «Matilda»  , tada su šanse za uspjeh «Vjetra»
 u

 i obrnuto, znajući šanse, lako ćemo izračunati vjerovatnost
 :

Na taj način smo naučili da «prevodimo» vjerovatnost u šanse, koje mogu biti u rasponu od  do
 . Učinićemo još jedan korak i naučiti da «prevodimo» vjerovatnost na cijeli brojčani pravac od
 do
 .
Korak 2. Prevešćemo vrijednosti vjerovatnosti u opseg

Ovaj korak je vrlo jednostavan — prologaritmiraćemo šanse po osnovi broja Eulerskog  i dobijamo:

Sada znamo da ako  , tada će izračunavanje vrijednosti
 biti veoma jednostavno i, više od toga, ona bi trebala biti pozitivna:
 . Tako i jeste.
Iz radoznalosti provjerimo, šta ako  , tada očekujemo da ćemo vidjeti negativnu vrijednost
 . Provjeravamo:
 . Sve je tačno.
Sada znamo kako prevesti vrijednost vjerovatnosti od  do
 na cijeli brojčani pravac od
 do
 . U sljedećem koraku uradićemo sve obrnuto.
A do tada, zabilježimo da prema pravilima logaritmizacije, znajući vrijednost funkcije  , možemo izračunati šanse:

Ova metoda određivanja šansi će nam zatrebati u sljedećem koraku.
Korak 3. Izvešćemo formulu za određivanje

Dakle, naučili smo, znajući  , pronaći vrijednosti funkcije
 . Međutim, zapravo nam treba sve tačno obrnuto — znajući vrijednost
 pronaći
 . Za to ćemo se obratiti pojmu kao što je obrnuta funkcija šansi, prema kojoj:

U članku nećemo izvoditi pomenutu formulu, ali ćemo provjeriti na brojkama iz gornjeg primjera. Znamo da su pri šansama od 4 prema 1 ( ), vjerovatnost nastanka događaja jednaka 0.8 (
 ). Napravimo substituciju:
 . To se poklapa sa našim ranijim izračunavanjima. Idemo dalje.
Na prethodnom koraku smo izveli da  , a to znači da možemo izvršiti zamjenu u obrnutoj funkciji šansi. Dobijamo:

Podelićemo i brojilac i imenilac sa  , tada:

Za svaki slučaj, da bismo se uverili da nismo napravili grešku, uradimo još jednu malu provjeru. Na koraku 2, za  utvrdili smo da
 . Tada, substitucijom vrijednosti
 u funkciju logističke povratne informacije, očekujemo da dobijemo
 . Substituišemo i dobijamo:

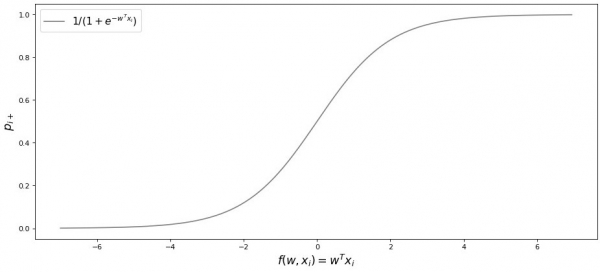
Čestitam vam, poštovani čitatelju, upravo smo razvili i testirali funkciju logističke regresije. Pogledajmo grafikon funkcije.
Grafikon 3 „Funkcija logističke regresije“
Kod za crtanje grafikona
import math

def logit (f):
    return 1/(1+math.exp(-f))

f = np.arange(-7,7,0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(f, p, color = 'grey', label = '$ 1 / (1+e^{-w^Tx_i})$')
plt.xlabel('$f(w,x_i) = w^Tx_i$', size = 16)
plt.ylabel('$p_{i+}$', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
U literaturi se takođe može naći naziv ove funkcije kao sigmoidna funkcija. Na grafikonu se dobro vidi da osnovna promena verovatnoće pripadnosti objekta klasi nastaje u relativno uskom opsegu  , otprilike od
 do
 .
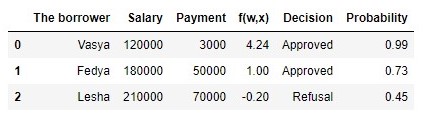
Predlažem da se vratimo našem kreditnom analitičaru i pomognemo mu da izračuna verovatnoću otplate kredita, inače bi mogao ostati bez premije 🙂
Tabela 2 „Potencijalni zajmoprimci“
Kod za formiranje tabele
proba = []
for i in df['f(w,x)']:
    proba.append(round(logit(i),2))

df['Verovatnoća'] = proba

df[['Zajmoprimac', 'Plata', 'Plaćanje', 'f(w,x)', 'Odluka', 'Verovatnoća']]
Dakle, verovatnoću povratka kredita smo utvrdili. U suštini, to je blizu istine.
Zaista, verovatnoća da Vasja sa platom od 120.000R može mesečno vraćati 3.000R banci bliska je 100%. Usput, treba da razumemo da banka može odobriti kredit i Leši ukoliko je politikom banke predviđeno, na primer, kreditiranje klijenata sa verovatnoćom povratka kredita većom od, recimo, 0.3. Samo u tom slučaju banka će formirati veće rezerve za moguće gubitke.
Takođe bi trebalo napomenuti da je odnos plate prema uplati ne manji od 3 i sa viškom od 5.000R uzet s neba. Zbog toga nismo mogli koristiti prvobitni oblik vektora težina  . Bilo je potrebno znatno smanjiti koeficijente i u tom slučaju smo svaki koeficijent podelili sa 25.000, što u suštini znači da smo prilagodili rezultat. Ali to je učinjeno namerno kako bi olakšalo razumevanje materijala u ranoj fazi. U stvarnosti, potrebno je ne izmišljati i prilagođavati koeficijente, već ih pronaći. U narednim delovima članka izvešćemo jednačine pomoću kojih se odabiraju parametri
 .
04. Metod najmanjih kvadrata u određivanju vektora težina u funkciji logističke regresije
 u funkciji logističke regresije
Već nam je poznat takav metod odabira vektora težina  , kao metod najmanjih kvadrata (MNK) A upravo, zašto ga ne bismo koristili u zadacima binarne klasifikacije? Zaista, ništa ne sprečava korišćenje MNL, samo što ova metoda daje manje tačne rezultate u klasifikacionim zadacima nego Logistic Loss. Ovo ima teoretsko objašnjenje. Hajde da prvo pogledamo jedan jednostavan primer.
Pretpostavimo da naše modele (koji koriste MSE i Logistic Loss) već počele sa odabirom vektora težina  i zaustavili smo proračun na nekom koraku. Nije važno da li je to sredina, kraj ili početak, bitno je da već imamo neke vrednosti vektora težina i pretpostavimo da u ovom koraku, vektori težina
 za oba modela nemaju razlika. Tada ćemo uzeti dobijene težine i uvrstiti ih u funkciju logističke reakcije (
 ) za neki objekat koji pripada klasi
 . Istražimo dva slučaja, kada se prema odabranom vektoru težina naš model mnogo greši i obrnuto — model je jako siguran da objekat pripada klasi
 . Pogledajmo koje kazne će biti „izrečene“ prilikom korišćenja MNL i Logistic Loss.
Kod za izračunavanje kazni u zavisnosti od korišćene funkcije gubitka
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
Slučaj sa ozbiljnom greškom — model pripisuje objekat klasi  sa verovatnoćom od 0,01
Kazna prilikom korišćenja MNL biće:

Kazna prilikom korišćenja Logistic Loss biće:

Slučaj sa velikom sigurnošću — model pripisuje objekat klasi  sa verovatnoćom od 0,99
Kazna prilikom korišćenja MNL biće:

Kazna prilikom korišćenja Logistic Loss biće:

Ovaj primer dobro ilustruje da prilikom ozbiljne greške funkcija gubitka Log Loss kazni model znatno jače nego MSE. Hajde da sada razjasnimo koje su teoretske pretpostavke korišćenja funkcije gubitka Log Loss u klasifikacionim zadacima.
05. Metod maksimalne verovatnoće i logistička regresija
Kao što je obećano na početku, članak obiluje jednostavnim primerima. U studiju imamo novi primer i stare goste — klijente banke: Vasilij, Fedya i Lyoša.
U svakom slučaju, pre nego što razvijemo primer, podsećam da u stvarnosti imamo posla sa obučavanjem koje uključuje hiljade ili milione objekata sa desetine ili stotine osobina. Međutim, ovde su brojevi uzeti tako da ih lako zapamti početnik u dataskajntingu.
Vraćamo se na primer. Zamislimo da je direktor banke odlučio da odobri kredit svima kojima je potreban, uprkos tome što je algoritam preporučivao da se ne odobri Aleksi. Prošlo je dovoljno vremena da saznamo ko od trojice junaka je vratio kredit, a ko nije. Kao što se i očekivalo: Vasja i Fedja su vratili kredit, a Alekse — nije. Sada zamislite da će ova situacija biti nova obuka za nas i, usput, kao da su nestali svi podaci o faktorima koji utiču na verovatnoću vraćanja kredita (plate zajmoprimca, iznos mesečne rate). Tada možemo intuitivno pretpostaviti da svaki treći zajmoprimac ne vraća banki kredit ili, drugim rečima, da je verovatnoća vraćanja kredita sledećem zajmoprimcu  . Ova intuitivna pretpostavka ima teoretsku potporu i zasniva se na metodi maksimalne verovatnoće, koja se u literaturi često naziva principom maksimalne verovatnoće.
Za početak, upoznajmo se sa pojmovnim aparatom.
Verovatnoća uzorka — to je verovatnoća dobijanja upravo takvog uzorka, dobijanja upravo ovakvih posmatranja / rezultata, t.j. proizvod verovatnoća dobijanja svakog od rezultata uzorka (na primer, da je kredit vraćen ili nije vraćen od strane Vasje, Fedje i Alekse istovremeno).
Funkcija verovatnoće povezuje verovatnoću uzorka sa vrednostima parametara raspodele.
U našem slučaju, uzorak za obuku predstavlja generalizovanu Bernulijevu shemu, u kojoj slučajna veličina može uzeti samo dve vrednosti:  ili
 . Shodno tome, verovatnoća uzorka može se zapisati kao funkcija verovatnoće od parametra
 na sljedeći način:


Gore navedeni zapis može se interpretirati na sledeći način. Zajednička verovatnoća da Vasja i Fedja vrate kredit jednaka je  , verovatnoća da Alekse NE vrati kredit jednaka je
 (budući da je u pitanju bila upravo NE vraćanje kredita), stoga je zajednička verovatnoća svih triju događaja jednaka
 .
Metoda maksimalne verovatnoće — to je metoda procene nepoznatog parametra putem maksimalizacije funkcije verovatnoće. U našem slučaju potrebno je pronaći takvu vrednost  , pri kojoj
 dostiže maksimum.
Odakle zapravo dolazi ideja – tražiti vrednost nepoznatog parametra pri kojoj funkcija verovatnoće dostiže maksimum? Izvori te ideje proističu iz predstave da je uzorak jedini dostupni izvor znanja o populaciji. Sve što znamo o populaciji predstavljeno je u uzorku. Stoga, sve što možemo reći je to da je uzorak najtačnije ogledalo populacije koje imamo. Shodno tome, potrebno je pronaći takav parametar pri kojem postojeći uzorak postaje najverovatniji.
Očigledno, imamo posla s optimizacijskim zadatkom, u kojem je potrebno pronaći tačku ekstrema funkcije. Da bismo odredili tačku ekstrema, potrebno je razmatrati uslov prvog reda, tj. izjednačiti derivaciju funkcije sa nulom i rešiti jednačinu u odnosu na traženi parametar. Međutim, pronalazak derivacije proizvoda velikog broja faktorâ može se ispostaviti kao dugotrajan posao, pa da bismo to izbegli, postoji poseban postupak – prelazak na logaritam. funkcije verovatnoće. Zašto je takav prelazak moguć? Obratimo pažnju na to da ne tražimo sam ekstrem funkcije , već tačku ekstrema, tj. tu vrednost nepoznatog parametra
 , pri kojoj
 koja dostiže maksimum. Prilikom prelaska na logaritam, tačka ekstrema se ne menja (iako će sam ekstrem biti drugačiji), jer je logaritamska funkcija monotona.
Hajde, u skladu sa gore navedenim, da nastavimo razvijati naš primer sa kreditima kod Vase, Fede i Leše. Za početak pređimo na logaritam funkcije verovatnoće:

Sada možemo lako diferencirati izraz po  :

I konačno, razmotrimo uslov prvog reda – izjednačimo derivaciju funkcije sa nulom:

Dakle, naša intuitivna procena verovatnoće otplate kredita  bila je teorijski obrazložena.
Odlično, ali šta sada da radimo s takvim informacijama? Ako pretpostavimo da svaki treći zajmoprimac neće vratiti novac banci, banka će neizbežno propasti. Tako je to, ali kada procenjujemo verovatnoću otplate kredita jednaku  Nismo uzeli u obzir faktore koji utiču na povrat kredita: plata zajmoprimca i iznos mesečne rate. Podsetimo se da smo ranije izračunali verovatnoću povrata kredita za svakog klijenta uzimajući u obzir te iste faktore. Logično je da su i verovatnoće dobijene različite od konstante jednakoj
 .
Definišimo verovatnoće uzoraka:
Kod za izračunavanje verovatnoće uzoraka
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'Verovatnoća uzorka pri konstantnoj vrednosti p=2/3:', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'Verovatnoća uzorka pri proračunatoj vrednosti p:', round(likelihood(y,p_log_response),3)
Verovatnoća uzorka pri konstantnoj vrednosti  :

Verovatnoća uzorka pri proračunu verovatnoće otplate kredita uzimajući u obzir faktore  :


Verovatnoća uzorka sa proračunatom verovatnoćom zavisno od faktora je bila viša od verovatnoće pri konstantnoj vrednosti verovatnoće. Šta to znači? To znači da su znanja o faktorima omogućila da se preciznije odredi verovatnoća otplate kredita za svakog klijenta. Stoga, pri odobravanju novog kredita, ispravnije bi bilo koristiti model procene verovatnoće otplate dugovanja koji je predstavljen na kraju trećeg odeljka članka.
Ali tada, ako nam je potrebno da maksimalizujemo funkciju verovatnoće uzorka, zašto ne bismo koristili neki algoritam koji bi davao verovatnoće za Vašu, Fedu i Lešu, na primer, jednake 0.99, 0.99 i 0.01, redom. Možda će takav algoritam dobro funkcionisati na obučenom uzorku, jer će približiti vrednost verovatnoće uzorka ka  , ali, prvo, takav algoritam će verovatno imati poteškoća sa generalizacijom, i drugo, ovaj algoritam sigurno neće biti linearan. A ako metode za borbu protiv prekomernog učenja (tj. slaba sposobnost generalizacije) očigledno nisu deo plana ovog članka, hajde da detaljnije razjasnimo drugi deo. Da bismo to uradili, dovoljno je odgovoriti na jednostavno pitanje. Može li verovatnoća otplate kredita Vase i Fede biti identična uzimajući u obzir poznate nam faktore? Sa stanovišta zdravog razuma, naravno da ne može. Tako da će Vasja otplaćivati 2.5% svoje plate mesečno za otplatu kredita, dok će Feda otplaćivati gotovo 27.8%. Takođe, na grafikonu 2 „Klasifikacija klijenata“ vidimo da je Vasja značajno dalje od linije koja deli klase od Fede. I konačno, znamo da funkcija
 za Vasju i Fedju ima različite vrednosti: 4.24 za Vasju i 1.0 za Fedju. E, da je Feda, na primer, zarađivao red veličine više ili tražio manji kredit, tada bi verovatnoće otplate kredita za Vasju i Fedju bile slične. Drugim rečima, linearnu zavisnost ne možete prevariti. I da smo zaista izračunali koeficijente
 , a ne uzeli ih s neba, mogli bismo smelo tvrditi da naše vrednosti
 najbolje omogućavaju procenu verovatnoće otplate kredita od strane svakog zajmoprimca, ali pošto smo se dogovorili da smatramo da je određivanje koeficijenata
 provireno prema svim pravilima, tako da ćemo smatrati - naši koeficijenti omogućavaju najbolju procenu verovatnoće 🙂
Međutim, skrenuli smo s teme. U ovom delu moramo razjasniti kako se definiše vektor težina  , koji je neophodan za procenu verovatnoće povraćaja kredita od strane svakog zajmoprimca.
Kratko rezimiramo, s kojim arsenalom izlazimo u potragu za koeficijentima  :
1. Pretpostavljamo da je zavisnost između ciljne promenljive (prognoziranih vrednosti) i faktora koji utiče na ishod - linearna. Iz tog razloga se primenjuje funkcija linearne regresije ovog oblika  , čija linija deli objekte (klijente) na klase
 i
 ili
 (klijenti sposobni za otplatu kredita i oni koji nisu sposobni). U našem slučaju, jednačina ima oblik
 .
2. Koristimo funkciju obrnutog logit-transformisanja ovog oblika  za određivanje verovatnoće pripadnosti objekta klasi
 .
3. Razmatramo našu obučenu uzorku kao realizaciju generalizovane Bernoulli sheme, meaning that for each object a random variable is generated, which with a probability  (its own for each object) takes the value of 1 and with a probability
 – 0.
4. We know that we need to maximize funkciju verovatnoće uzorka considering the accepted factors so that the existing sample becomes the most plausible. In other words, we need to choose parameters under which the sample will be the most plausible. In our case, the parameter we are choosing is the probability of loan repayment  , which, in turn, depends on unknown coefficients
 . Therefore, we need to find such a weight vector
 , under which the likelihood of the sample will be maximized.
5. We know that for maximizing the likelihood function of the sample možete koristiti metoda maksimalne verodostojnosti. And we know all the clever tricks for working with this method.
This is how the multi-step process looks 🙂
Now let's remember that at the very beginning of the article we wanted to derive two types of loss functions Logistic Loss depending on how the classes of objects are designated. It has been customary in classification tasks with two classes to denote the classes as  i
 ili
 . Depending on the designation, the corresponding loss function will be output.
Case 1. Classification of objects into i
 i

Earlier, when assessing the likelihood of the sample, in which the probability of loan repayment was calculated based on factors and given coefficients  , we applied the formula:

In fact  — this is the value of the logistic response function
 given a weight vector

Then nothing prevents us from writing the likelihood function of the sample as follows:

Sometimes it happens that for some beginner analysts it's challenging to immediately understand how this function works. Let's look at 4 short examples that will clarify everything:
1. Ako  (i.e., according to the training sample, the object belongs to class +1), and our algorithm
 determines the probability of attributing the object to class
 to be 0.9, then this piece of the sample's likelihood will be calculated as follows:

2. Ako  , dok
 , then the calculation will be as follows:

3. Ako  , dok
 , then the calculation will be as follows:

4. Ako  , dok
 , then the calculation will be as follows:

Clearly, the likelihood function will be maximized in cases 1 and 3 or, in general terms — when the probabilities of attributing the object to the class are correctly guessed  .
Due to the fact that when determining the probability of attributing an object to a class  ne znamo samo koeficijente
 , pa ćemo ih tražiti. Kao što je gore rečeno, ovo je optimizacijska zadatak, u kojem nam je potrebno prvo pronaći derivaciju funkcije verovatnoće po vektoru težina
 . Međutim, pre toga ima smisla pojednostaviti sebi zadatak: tražićemo derivaciju logaritma funkcije verovatnoće.

Zašto nakon logaritmovanja, u funkciji logističke greške, promenili smo znak sa  na
 . Sve je jednostavno, pošto je u zadacima procene kvaliteta modela uobičajeno minimizirati vrednost funkcije, pomnožili smo desnu stranu izraza sa
 i prema tome umesto maksimizacije, sada minimiziramo funkciju.
U suštini, upravo je pred vašim očima puno patnje izvedena funkcija gubitka — Logistic Loss za obučeni skup podataka sa dva razreda:  i
 .
Sada, za pronalaženje koeficijenata, biće nam potrebno samo da pronađemo derivaciju funkciji logističke greške i zatim, koristeći numeričke metode optimizacije, kao što su gradijentni spust ili stohastički gradijentni spust, da pronađemo najoptimalnije koeficijente  . No, uzimajući u obzir već prilično obiman članak, predlažemo da diferenciranje obavite sami ili, možda, će to biti tema sledećeg članka sa mnogo aritmetike bez toliko detaljnih primera.
Slučaj 2. Klasifikacija objekata na i
 i

Pristup će biti isti kao i sa razredima  i
 , ali sama staza do izvođenja funkcije gubitka Logistic Loss, će biti složenija. Počnimo. Za funkciju verovatnoće koristićemo operator „ako…, onda…“. Dakle, ako
 -ti objekat pripada klasi
 , onda za izračunavanje verovatnoće uzorka koristimo verovatnoću
 , ako objekat pripada klasi
 , onda u verovatnoću stavljamo
 . Ovako izgleda funkcija verovatnoće:

Na jednostavan način objasnićemo kako to funkcioniše. Razmotrite 4 slučaja:
1. Ako  i
 , tada će u verovatnoću uzorka „ići”

2. Ako  i
 , tada će u verovatnoću uzorka „ići”

3. Ako  i
 , tada će u verovatnoću uzorka „ići”

4. Ako  i
 , tada će u verovatnoću uzorka „ići”

Očigledno je da u 1 i 3 slučaju, kada su verovatnoće bile pravilno određene algoritmom, funkcija verovatnoće biće maksimizovana, dakle, upravo to smo želeli postići. Međutim, takav pristup je dovoljno glomazan i dalje ćemo razmotriti sažetiji zapis. No pre toga, logaritmovat ćemo funkciju verovatnoće sa promenom znaka, jer ćemo je sada minimizirati.

Zamenićemo umesto  izraz
 :

P pojednostavimo desni član ispod logaritma koristeći jednostavne aritmetičke tehnike i dobijamo:

A sada je vreme da se oslobodimo operatera „ako…, onda…“. Primetimo da kada objekat  pripada klasi
 , u izrazu ispod logaritma, u imeniocu,
 se podiže na stepen
 , ako objekat pripada klasi
 , tada se $e$ podiže na stepen
 . Stoga se zapis stepena može pojednostaviti - ujedinimo oba slučaja u jedan:
 . Tada funkcija logističke greške ima oblik:

U skladu sa pravilima logaritmizacije, obrnućemo razlomak i izvući znak " " (minus) ispred logaritma, dobijamo:

Ispred vas je funkcija gubitaka logistic Loss, koja se primenjuje u obučavajućem skupu u kojem su objekti pripisani klasama:  i
 .
Pa, u ovom trenutku se opraštam i završavamo članak.
Prethodni rad autora - „Dovodimo jednadžbu linearne regresije u matrični oblik”
Pomoćni materijali
1. Literatura
1) Primenjena regresiona analiza / N. Drejper, G. Smith - 2. izd. - M.: Finansije i statistika, 1986 (prevod sa engleskog)
2) Teorija verovatnoće i matematička statistika / V.E. Gmurman - 9. izd. - M.: Viša škola, 2003
3) Teorija verovatnoće / N.I. Černova - Novosibirsk: Novosibirjski državni univerzitet, 2007
4) Biznis-analitika: od podataka do znanja / Paklin N.B., Oreškov V.I. - 2. izd. - Sankt Petersburg: Piter, 2013
5) Data Science Nauka o podacima od nule / Džoel Gras - Sankt Petersburg: BHV Petersburg, 2017
6) Praktična statistika za stručnjake Data Science / P.Bruce, E.Bruce - Sankt Petersburg: BHV Petersburg, 2018
2. Predavanja, kursevi (video)
1)
2)
3)
4)
5)
3. Internet izvori
1)
2)
3)
4)
5)
6)
7)
8)
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish