

Bylo zveřejněno podrobné průvodce laděním prostředí Linux pro dosažení maximální výkonnosti zpracování HTTP požadavků. Navrhované metody umožnily zvýšit výkonnost JSON zpracovatele založeného na knihovně libreactor v prostředí Amazon EC2 (4 vCPU) z 224 tisíc API požadavků za sekundu při standardním nastavení Amazon Linux 2 s jádrem 4.14 na 1,2 milionu požadavků za sekundu po provedení optimalizace (nárůst o 436 %) a také vedly ke snížení latencí při zpracování požadavků o 79 %. Navrhované metody nejsou specifické pro libreactor a fungují při použití jiných http serverů, včetně nginx, Actix, Netty a Node.js (libreactor byl použit při testech, protože řešení na jeho základě vykázalo nejlepší výkon).
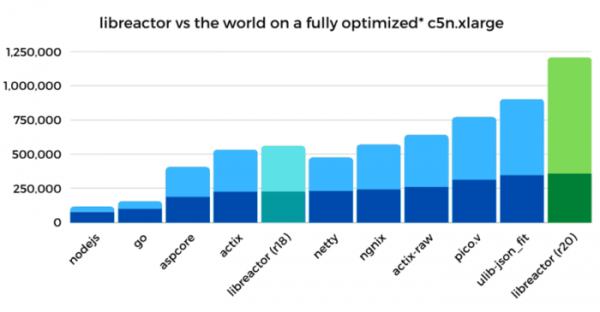
Hlavní optimalizace:
- Optimalizace kódu libreactor. Základem byl použit variant R18 z balíčku Techempower, který byl vylepšen odstraněním kódu omezujícího počet používaných CPU jader (optimalizace umožnila zrychlení o 25-27 %), kompilací v GCC s možnostmi „-O3“ (nárůst 5-10 %) a „-march-native“ (5-10 %), nahrazením volání read/write na recv/send (5-10 %) a snížením režijních nákladů při použití pthreads (2-3 %). Celkový nárůst výkonu po optimalizaci kódu činil 55 % a propustnost vzrostla ze 224k req/s na 347k req/s.
- Vypnutí ochrany před zranitelnostmi způsobenými spekulativním vykonáváním instrukcí. Použití parametrů při načítání jádra „nospectre_v1 nospectre_v2 pti=off mds=off tsx_async_abort=off“ umožnilo zvýšit výkon o 28 %, a propustnost vzrostla ze 347k req/s na 446k req/s. Samotný nárůst od parametru „nospectre_v1“ (ochrana před Spectre v1 + SWAPGS) činil 1-2 %, „nospectre_v2“ (ochrana před Spectre v2) — 15-20 %, „pti=off“ (Spectre v3/Meltdown) — 6 %, „mds=off tsx_async_abort=off“ (MDS/Zombieload a TSX Asynchronous Abort) — 6 %. Nastavení ochrany před útoky L1TF/Foreshadow (l1tf=flush), iTLB multihit, Speculative Store Bypass a SRBDS zůstaly beze změny, protože neměly vliv na výkon, jelikož se nepřekrývaly s testovanou konfigurací (například specifické pro KVM, vnořenou virtualizaci a další modely CPU).
- Vypnutí mechanismů auditu a blokování systémových volání pomocí příkazu „auditctl -a never,task“ a zadáním možnosti „—security-opt seccomp=unconfined“ při spuštění kontejneru docker. Celkový nárůst výkonu činil 11 % a propustnost vzrostla ze 446k req/s na 495k req/s.
- Vypnutí iptables/netfilter prostřednictvím načtení jejich souvisejících modulů jádra. K nápadu na vypnutí firewallu, který nebyl používán ve specifickém serverovém řešení, vedly výsledky profilování, podle nichž na provádění funkce nf_hook_slow padlo 18 % času. Upozorňuje se, že nftables funguje efektivněji než iptables, ale v Amazon Linuxu se stále používá iptables. Po vypnutí iptables se výkon zvýšil o 22 % a propustnost vzrostla z 495k req/s na 603k req/s.
- Snížení migrace zpracovatelů mezi různými jádry CPU za účelem zvýšení efektivity využití procesorové cache. Optimalizace byla provedena jak na úrovni vazby procesů libreactor na jádra CPU (CPU Pinning), tak prostřednictvím přiřazení síťových zpracovatelů jádra (Receive Side Scaling). Například bylo provedeno vypnutí irqbalance a explicitní nastavení vazeb front na CPU v /proc/irq/$IRQ/smp_affinity_list. Pro použití stejného jádra CPU k zpracování procesu libreactor a síťové fronty příchozích paketů byl použit vlastní BPF zpracovatel, připojený prostřednictvím nastavení parametru SO_ATTACH_REUSEPORT_CBPF při vytváření socketu. Pro přiřazení CPU front odchozích paketů byly změněny nastavení /sys/class/net/eth0/queues/tx-<n>/xps_cpus. Celkový nárůst výkonu činil 38 %, a propustnost vzrostla z 603k req/s na 834k req/s.
- Optimalizace zpracování přerušení a použití poling (polling). Aktivace režimu adaptive-rx v ovladači ENA a manipulace se sysctl net.core.busy_read umožnily zvýšit výkon o 28 % (propustnost vzrostla z 834k req/s na 1.06M req/s a latence se snížila z 361μs na 292μs).
- Vypnutí systémových služeb, které vedly k nadbytečným blokacím v síťovém zásobníku. Vypnutí dhclient a nastavení IP adres manuálně vedlo k zvýšení výkonu o 6 %, a propustnost vzrostla z 1.06M req/s na 1.12M req/s. Důvod ovlivnění dhclient na výkon je analyzován v analýze provozu pomocí raw socketu.
- Boj se Spin Lock. Přepnutí síťového zásobníku do režimu „noqueue“ prostřednictvím sysctl „net.core.default_qdisc=noqueue“ a „tc qdisc replace dev eth0 root mq“ vedlo k nárůstu výkonu o 2 %, a propustnost vzrostla z 1.12M req/s na 1.15M req/s.
- Finální drobné optimalizace, jako je deaktivace GRO (Generic Receive Offload) pomocí příkazu „ethtool -K eth0 gro off“ a změna algoritmu řízení přetížení z cubic na reno pomocí sysctl „net.ipv4.tcp_congestion_control=reno“. Celkový nárůst výkonu byl 4 %. Propustnost vzrostla z 1,15M req/s na 1,2M req/s.
Kromě provedených optimalizací článek také zkoumá metody, které nevedly k očekávanému nárůstu výkonu. Například se ukázaly jako neúčinné:
- Samostatné spuštění libreactor se výkonem nelišilo od spuštění v kontejneru. Neovlivnila ani náhrada writev za send, zvýšení maxevents v epoll_wait, experimenty s verzemi a flagy GCC (efekt byl patrný pouze pro flagy „-O3“ a „-march-native“).
- Na výkon neovlivnilo ani aktualizaci jádra Linux na verze 4.19 a 5.4, používání plánovačů SCHED_FIFO a SCHED_RR, manipulace s sysctl kernel.sched_min_granularity_ns, kernel.sched_wakeup_granularity_ns, transparent_hugepages=never, skew_tick=1 a clocksource=tsc.
- V ovladači ENA na výkon neovlivnilo zapnutí režimů Offload (segmentation, scatter-gather, rx/tx checksum), kompilace s flagem „-O3“ a aplikace parametrů ena.rx_queue_size a ena.force_large_llq_header.
- Změny v síťovém zásobníku nevedly ke zvýšení výkonu:
- Deaktivace IPv6: ipv6.disable=1
- Deaktivace VLAN: modprobe -rv 8021q
- Deaktivace kontroly zdroje paketu
- net.ipv4.conf.all.rp_filter=0
- net.ipv4.conf.eth0.rp_filter=0
- net.ipv4.conf.all.accept_local=1 (negativní efekt)
- net.ipv4.tcp_sack=0
- net.ipv4.tcp_dsack=0
- net.ipv4.tcp_mem/tcp_wmem/tcp_rmem
- net.core.netdev_budget
- net.core.dev_weight
- net.core.netdev_max_backlog
- net.ipv4.tcp_slow_start_after_idle=0
- net.ipv4.tcp_moderate_rcvbuf=0
- net.ipv4.tcp_timestamps=0
- net.ipv4.tcp_low_latency=1
- SO_PRIORITY
- TCP_NODELAY
Zdroj: opennet.ru
