

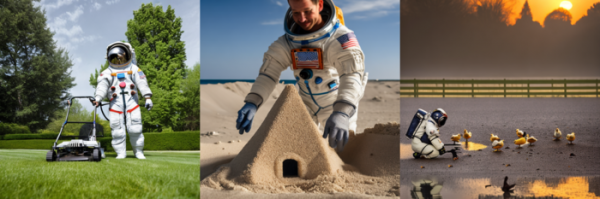
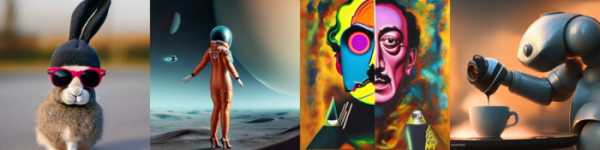
Společnost Stability AI zveřejnila druhou verzi systému strojového učení Stable Diffusion, schopného syntetizovat a měnit obrázky na základě navržené šablony nebo textového popisu v přirozeném jazyce. Kód nástrojů pro trénink neuronové sítě a generaci obrazů je napsán v Pythonu s použitím rámce PyTorch a je publikován pod licencí MIT. Již vytrénované modely jsou otevřeny pod permissivní licencí Creative ML OpenRAIL-M, která povoluje použití k obchodním účelům. Navíc je k dispozici demonstrační online generátor obrazů.
Klíčová vylepšení v nové verzi Stable Diffusion:
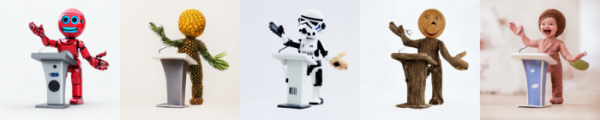
- Byl vytvořen nový model syntézy obrazů na základě textového popisu — SD2.0-v, podporující generaci obrazů s rozlišením 768×768. Nový model byl trénován s využitím sbírky LAION-5B, která zahrnuje 5,85 miliardy obrázků s textovými popisy. Model používá stejnou sadu parametrů jako model Stable Diffusion 1.5, ale liší se přechodem na použití zcela jiného kodéru OpenCLIP-ViT/H, což výrazně zvýšilo kvalitu výsledných obrazů.

- Byla připravena zjednodušená varianta SD2.0-base, trénovaná na obrazových datech 256×256 s použitím klasického modelu predikce šumu a podporující generaci obrazů s rozlišením 512×512.

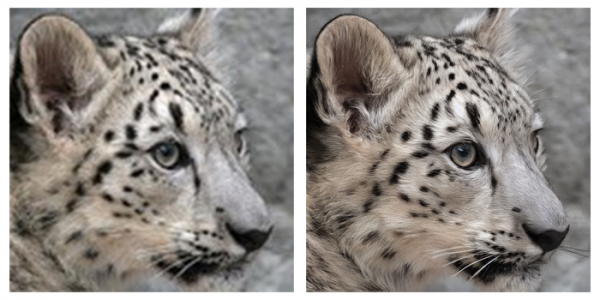
- Byla poskytnuta možnost použití technologie super-sampling (Super Resolution) pro zvýšení rozlišení původního obrázku bez ztráty kvality, s využitím algoritmů prostorového škálování a rekonstrukce detailů. Poskytovaný model zpracování obrazů (SD20-upscaler) podporuje čtyřnásobné zvětšení, což umožňuje vytvářet obrázky s rozlišením 2048×2048.

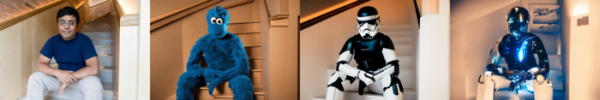
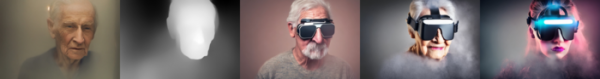
- Byl navržen model SD2.0-depth2img, který zohledňuje hloubku a prostorové umístění objektů. Pro monokulární odhad hloubky se používá systém MiDaS. Model umožňuje syntetizovat nové obrázky s použitím jiného obrázku jako šablony, které se mohou radikálně lišit od originálu, ale zachovávají celkovou kompozici a hloubku. Například je možné použít postoj člověka na fotografii k vytvoření jiného charakteru ve stejné pozici.


- Byla aktualizována model pro úpravu obrázků – SD 2.0-inpainting, který umožňuje pomocí textových pokynů nahrazovat a měnit části obrázku.
- Byla provedena optimalizace modelů pro využití na běžných systémech s jedním GPU.
Zdroj: opennet.ru
