

Největší společnosti zabývající se vývojem v oblasti strojového učení představily projekt OpenXLA, zaměřený na společný vývoj nástrojů pro kompilaci a optimalizaci modelů pro systémy strojového učení. Pod křídla projektu přešla také vývoj nástrojů, které umožňují unifikaci kompilace modelů připravených ve frameworku TensorFlow, PyTorch a JAX, pro efektivní učení a provádění na různých GPU a specializovaných akcelerátorech. Ke společné práci na projektu se připojily společnosti jako Google, NVIDIA, AMD, Intel, Meta, Apple, Arm, Alibaba a Amazon.
Očekává se, že díky spojení sil vedoucích výzkumných týmů a zástupců komunity se podaří podpořit rozvoj systémů strojového učení a vyřešit problém s fragmentací infrastruktury pro různé frameworky a hardware. OpenXLA umožňuje efektivní podporu různorodého hardware, nezávisle na tom, na jakém frameworku byl model strojového učení vytvořen. Očekává se, že díky OpenXLA se podaří zkrátit dobu učení modelů, zvýšit propustnost, snížit latenci, snížit náklady na výpočetní zdroje a zkrátit čas uvedení produktu na trh.
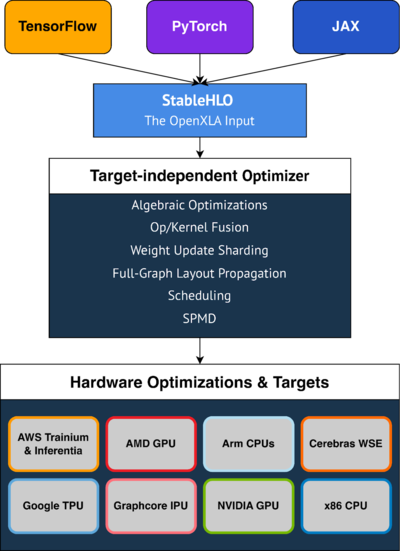
OpenXLA tvoří tři základní komponenty, jejichž kód je distribuován pod licencí Apache 2.0:
- XLA (Accelerated Linear Algebra) — kompilátor, který umožňuje optimalizaci modelů strojového učení pro vysoce výkonné provádění na různých hardwarových platformách, včetně GPU, CPU a specializovaných akcelerátorů od různých výrobců.
- StableHLO — specifikace a základní implementace sady vysoce úrovňových operací (HLO, High-Level Operations) pro použití v modelech systémů strojového učení. Působí jako vrstva mezi frameworky strojového učení a kompilátory, které převádějí model pro provádění na konkrétním hardware. Vrstva pro generaci modelů ve formátu StableHLO byla připravena pro frameworky PyTorch, TensorFlow a JAX. Jako základ pro StableHLO byl použit soubor MHLO, který byl rozšířen o podporu serializace a verzování.
- IREE (Intermediate Representation Execution Environment) — kompilátor a runtime, který převádí modely strojového učení na univerzální mezilehlé zastoupení založené na formátu MLIR (Multi-Level Intermediate Representation) z projektu LLVM. Mezi hlavními rysy je možné upozornit na předkompilaci (ahead-of-time), podporu řízení toku, použití dynamických prvků v modelech a optimalizaci pro různé CPU a GPU, jakož i nízké režijní náklady.
Hlavní výhody nástroje OpenXLA:
- Dosažení optimálního výkonu bez potřeby hlouběji se ponořit do psaní kódu specifického pro konkrétní zařízení. Poskytnutí hotových optimalizací, včetně zjednodušení algebraických výrazů, efektivního umístění v paměti a plánování vykonávání s ohledem na snížení špičkové paměťové spotřeby a přetížení.
- Zjednodušení škálování a paralelizace výpočtů. Vývojářovi stačí přidat anotace pro podmnožinu kritických tenzorů, na jejichž základě může kompilátor automaticky vygenerovat kód pro paralelní výpočty.
- Zajištění přenositelnosti díky podpoře různých hardwarových platforem, jako jsou GPU AMD a NVIDIA, CPU založené na architektuře x86 a ARM, ML akcelerátory TPU Google, IPU AWS Trainium Inferentia, Graphcore a Cerebras Wafer-Scale Engine.
- Podpora připojení rozšíření s realizací dodatečných funkcí, jako je podpora psaní primitivů hlubokého strojového učení s použitím CUDA, HIP, SYCL, Triton a dalších jazyků pro paralelní výpočty. Možnost ručního ladění úzkých míst v modelech.
Zdroj: opennet.ru
